利用IDEA开发Spark-SQL

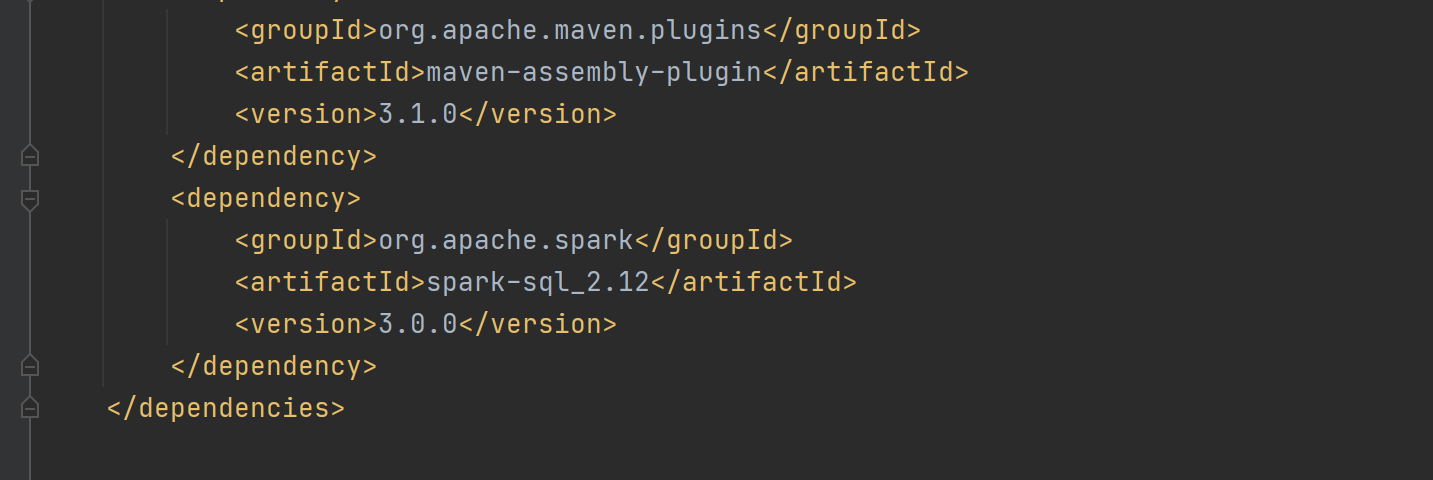
创建子模块Spark-SQL,并添加依赖
创建Spark-SQL的测试代码:
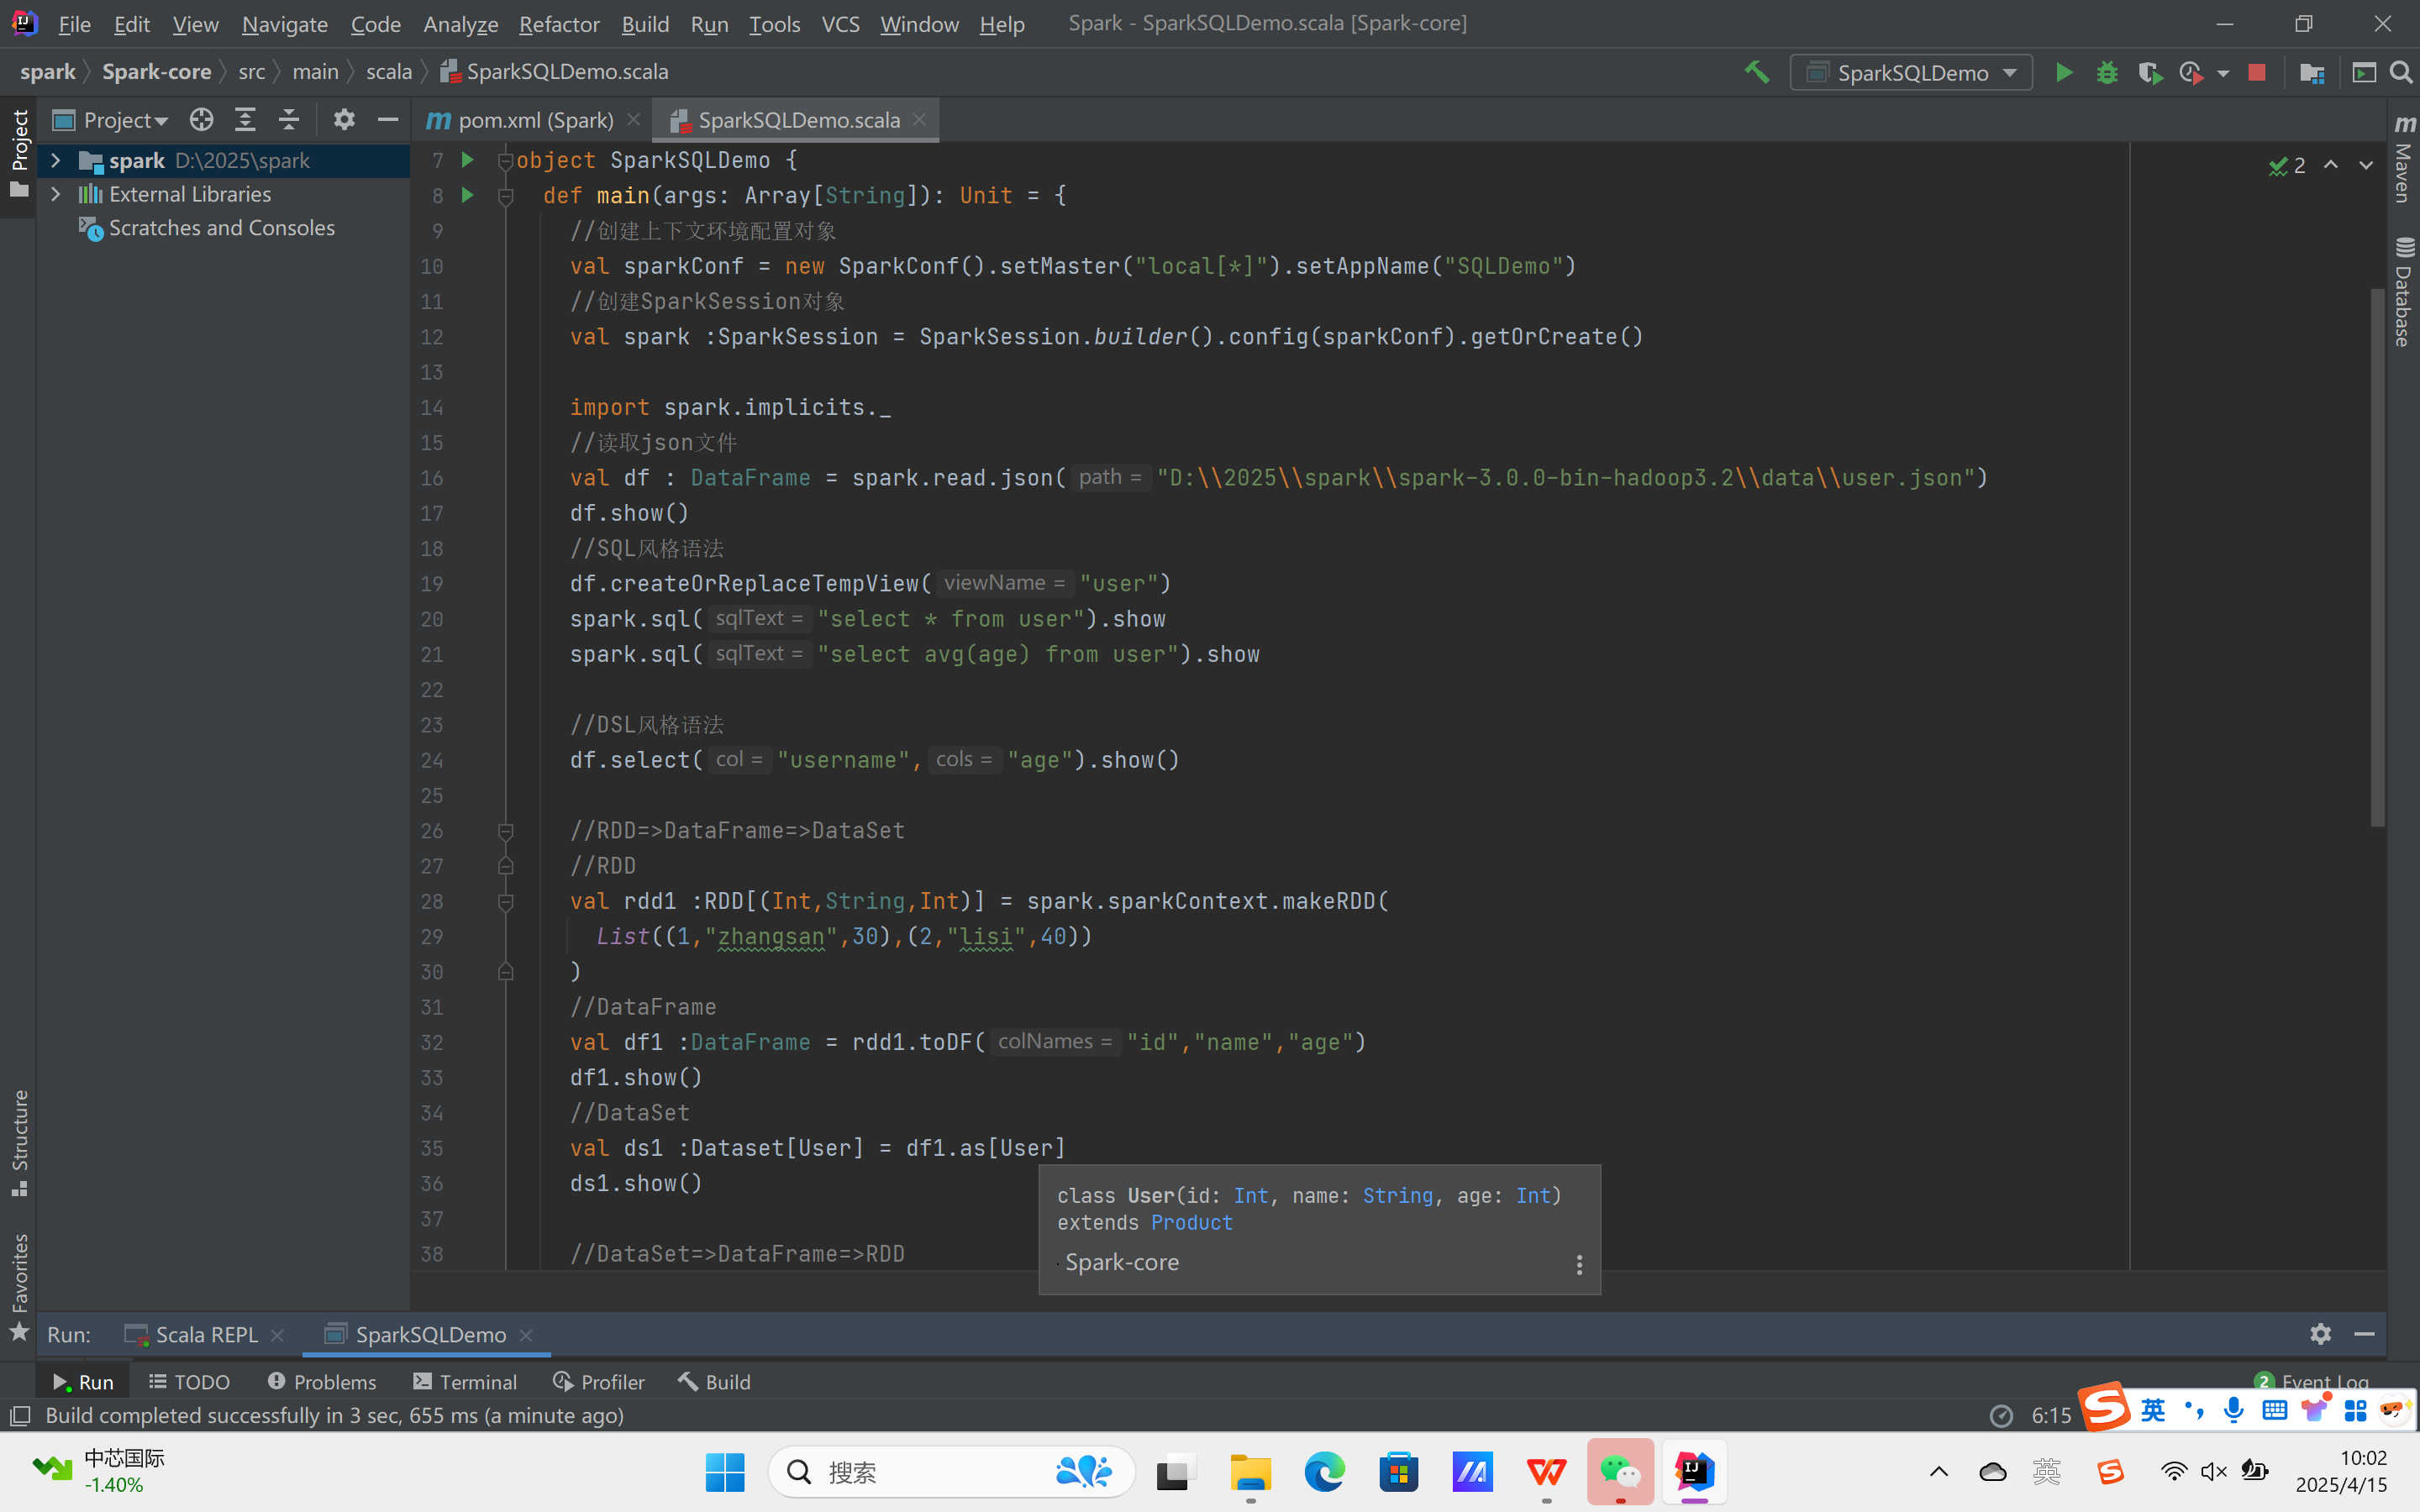
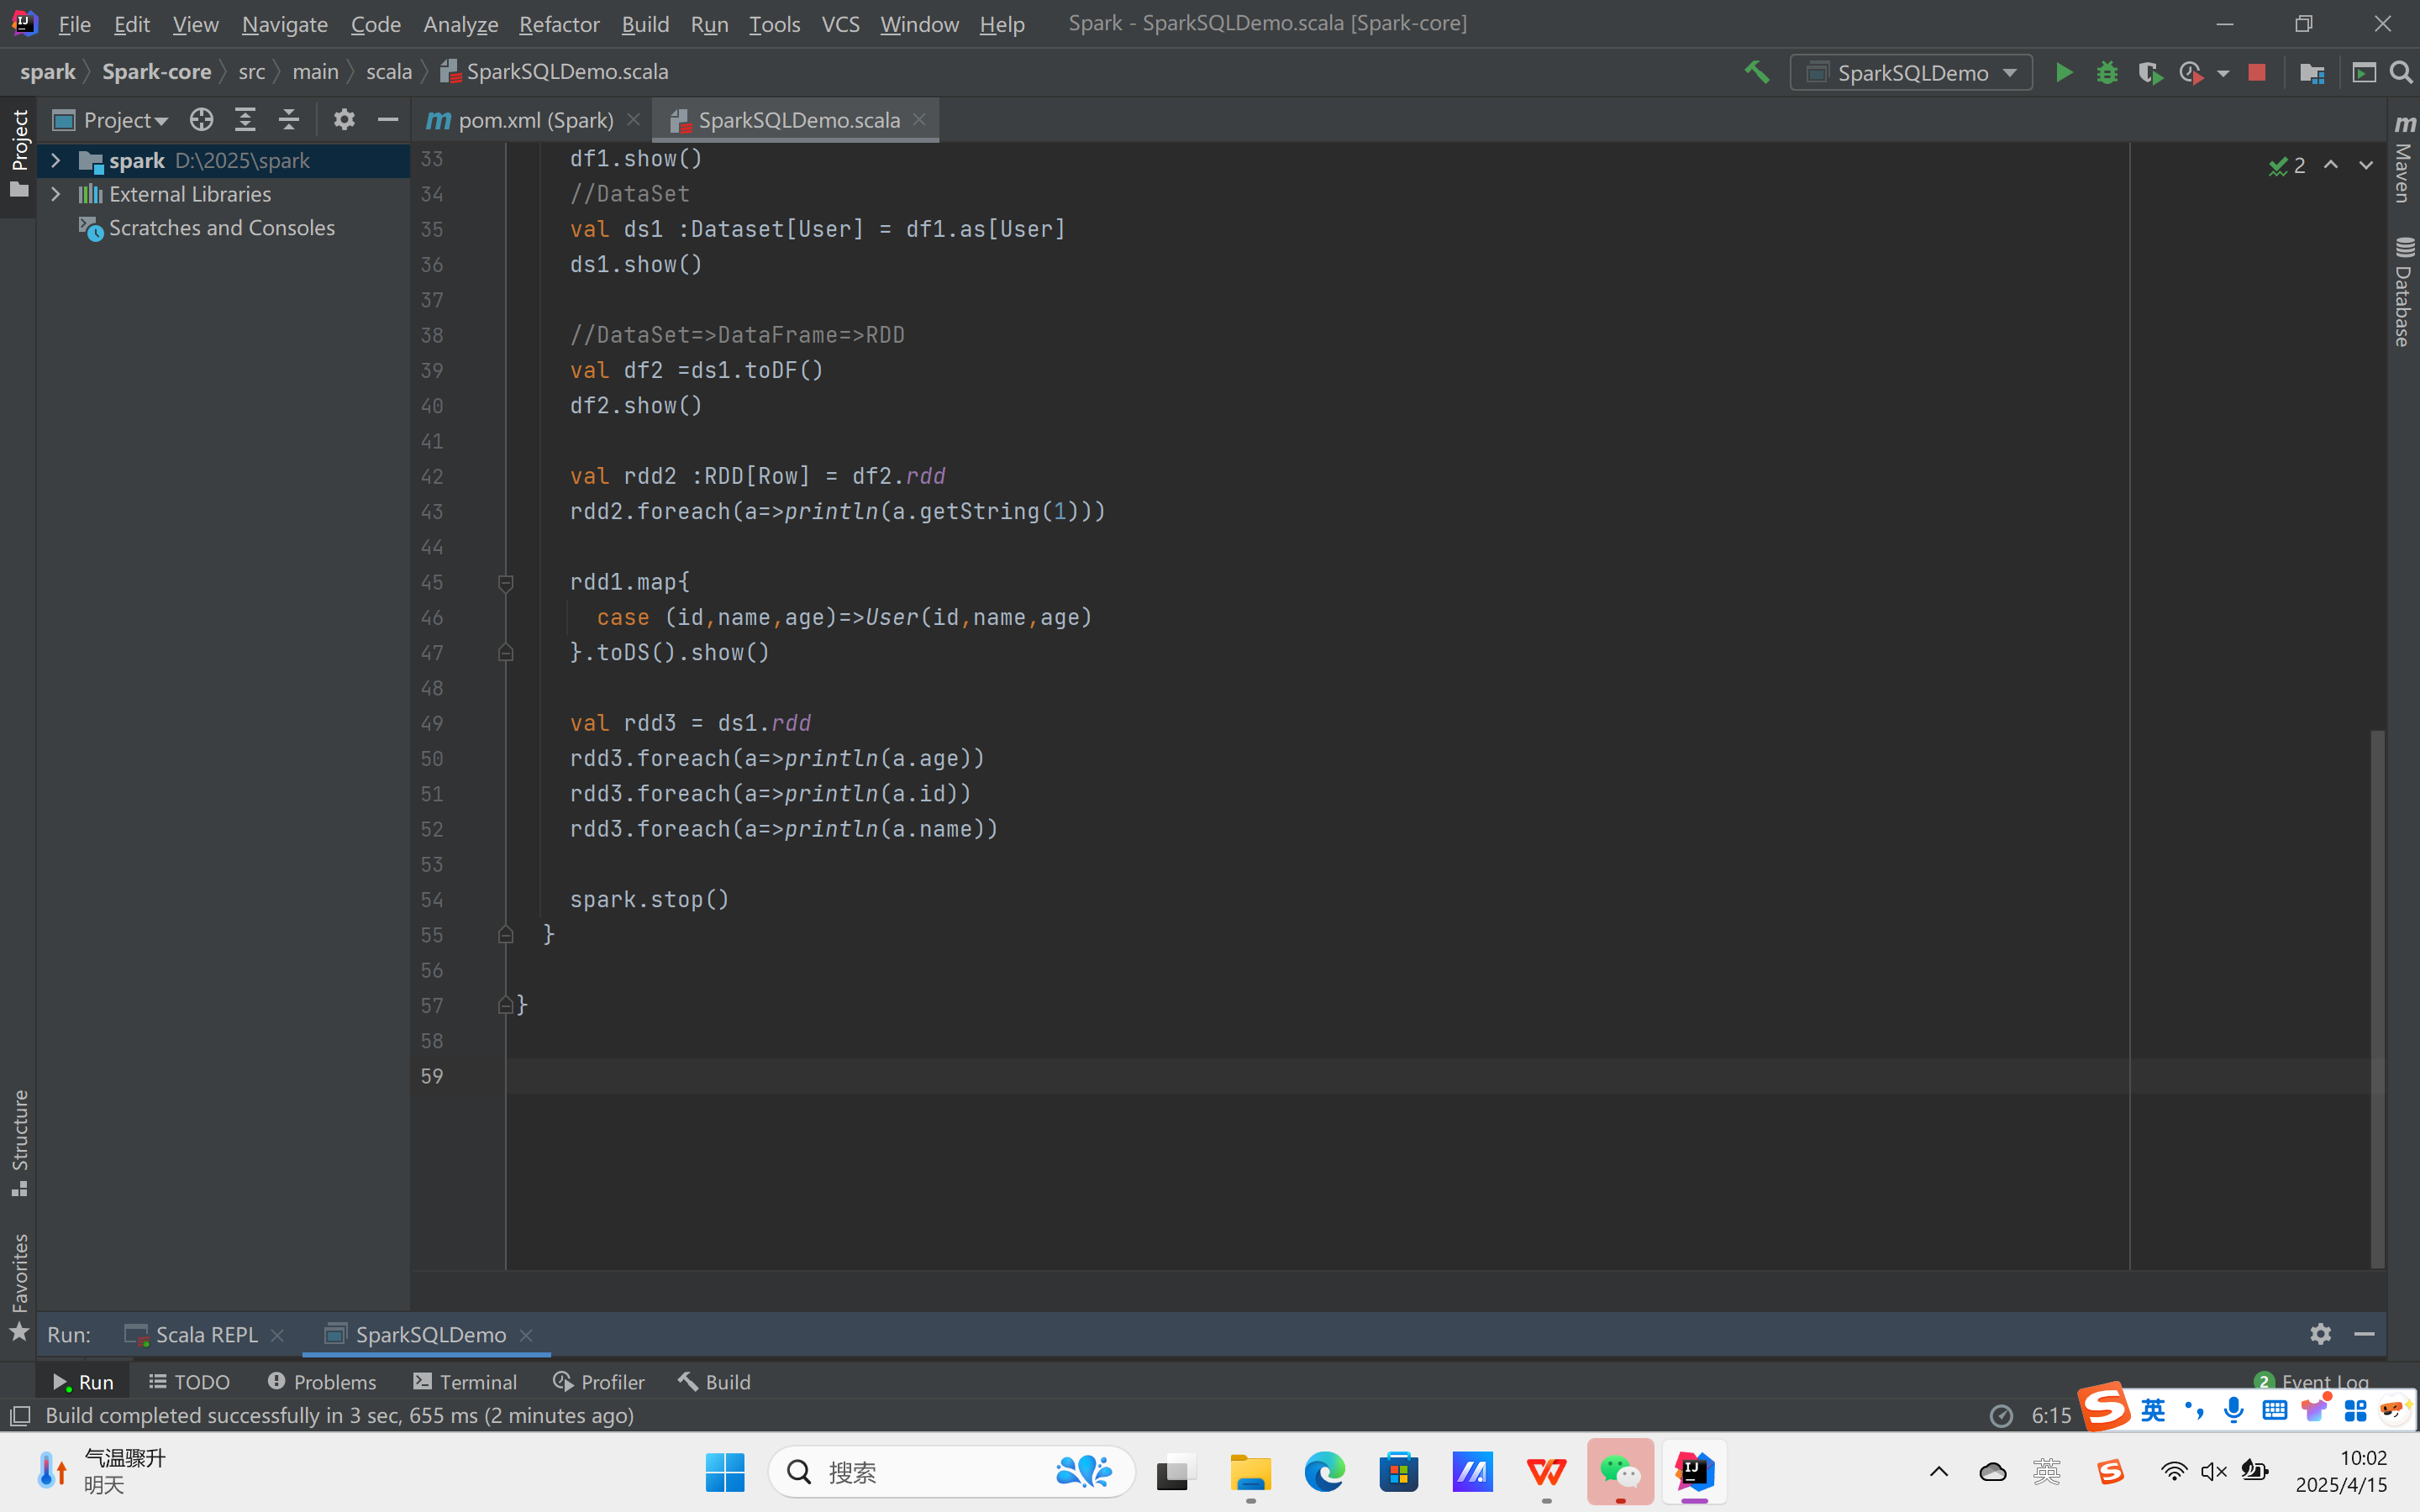
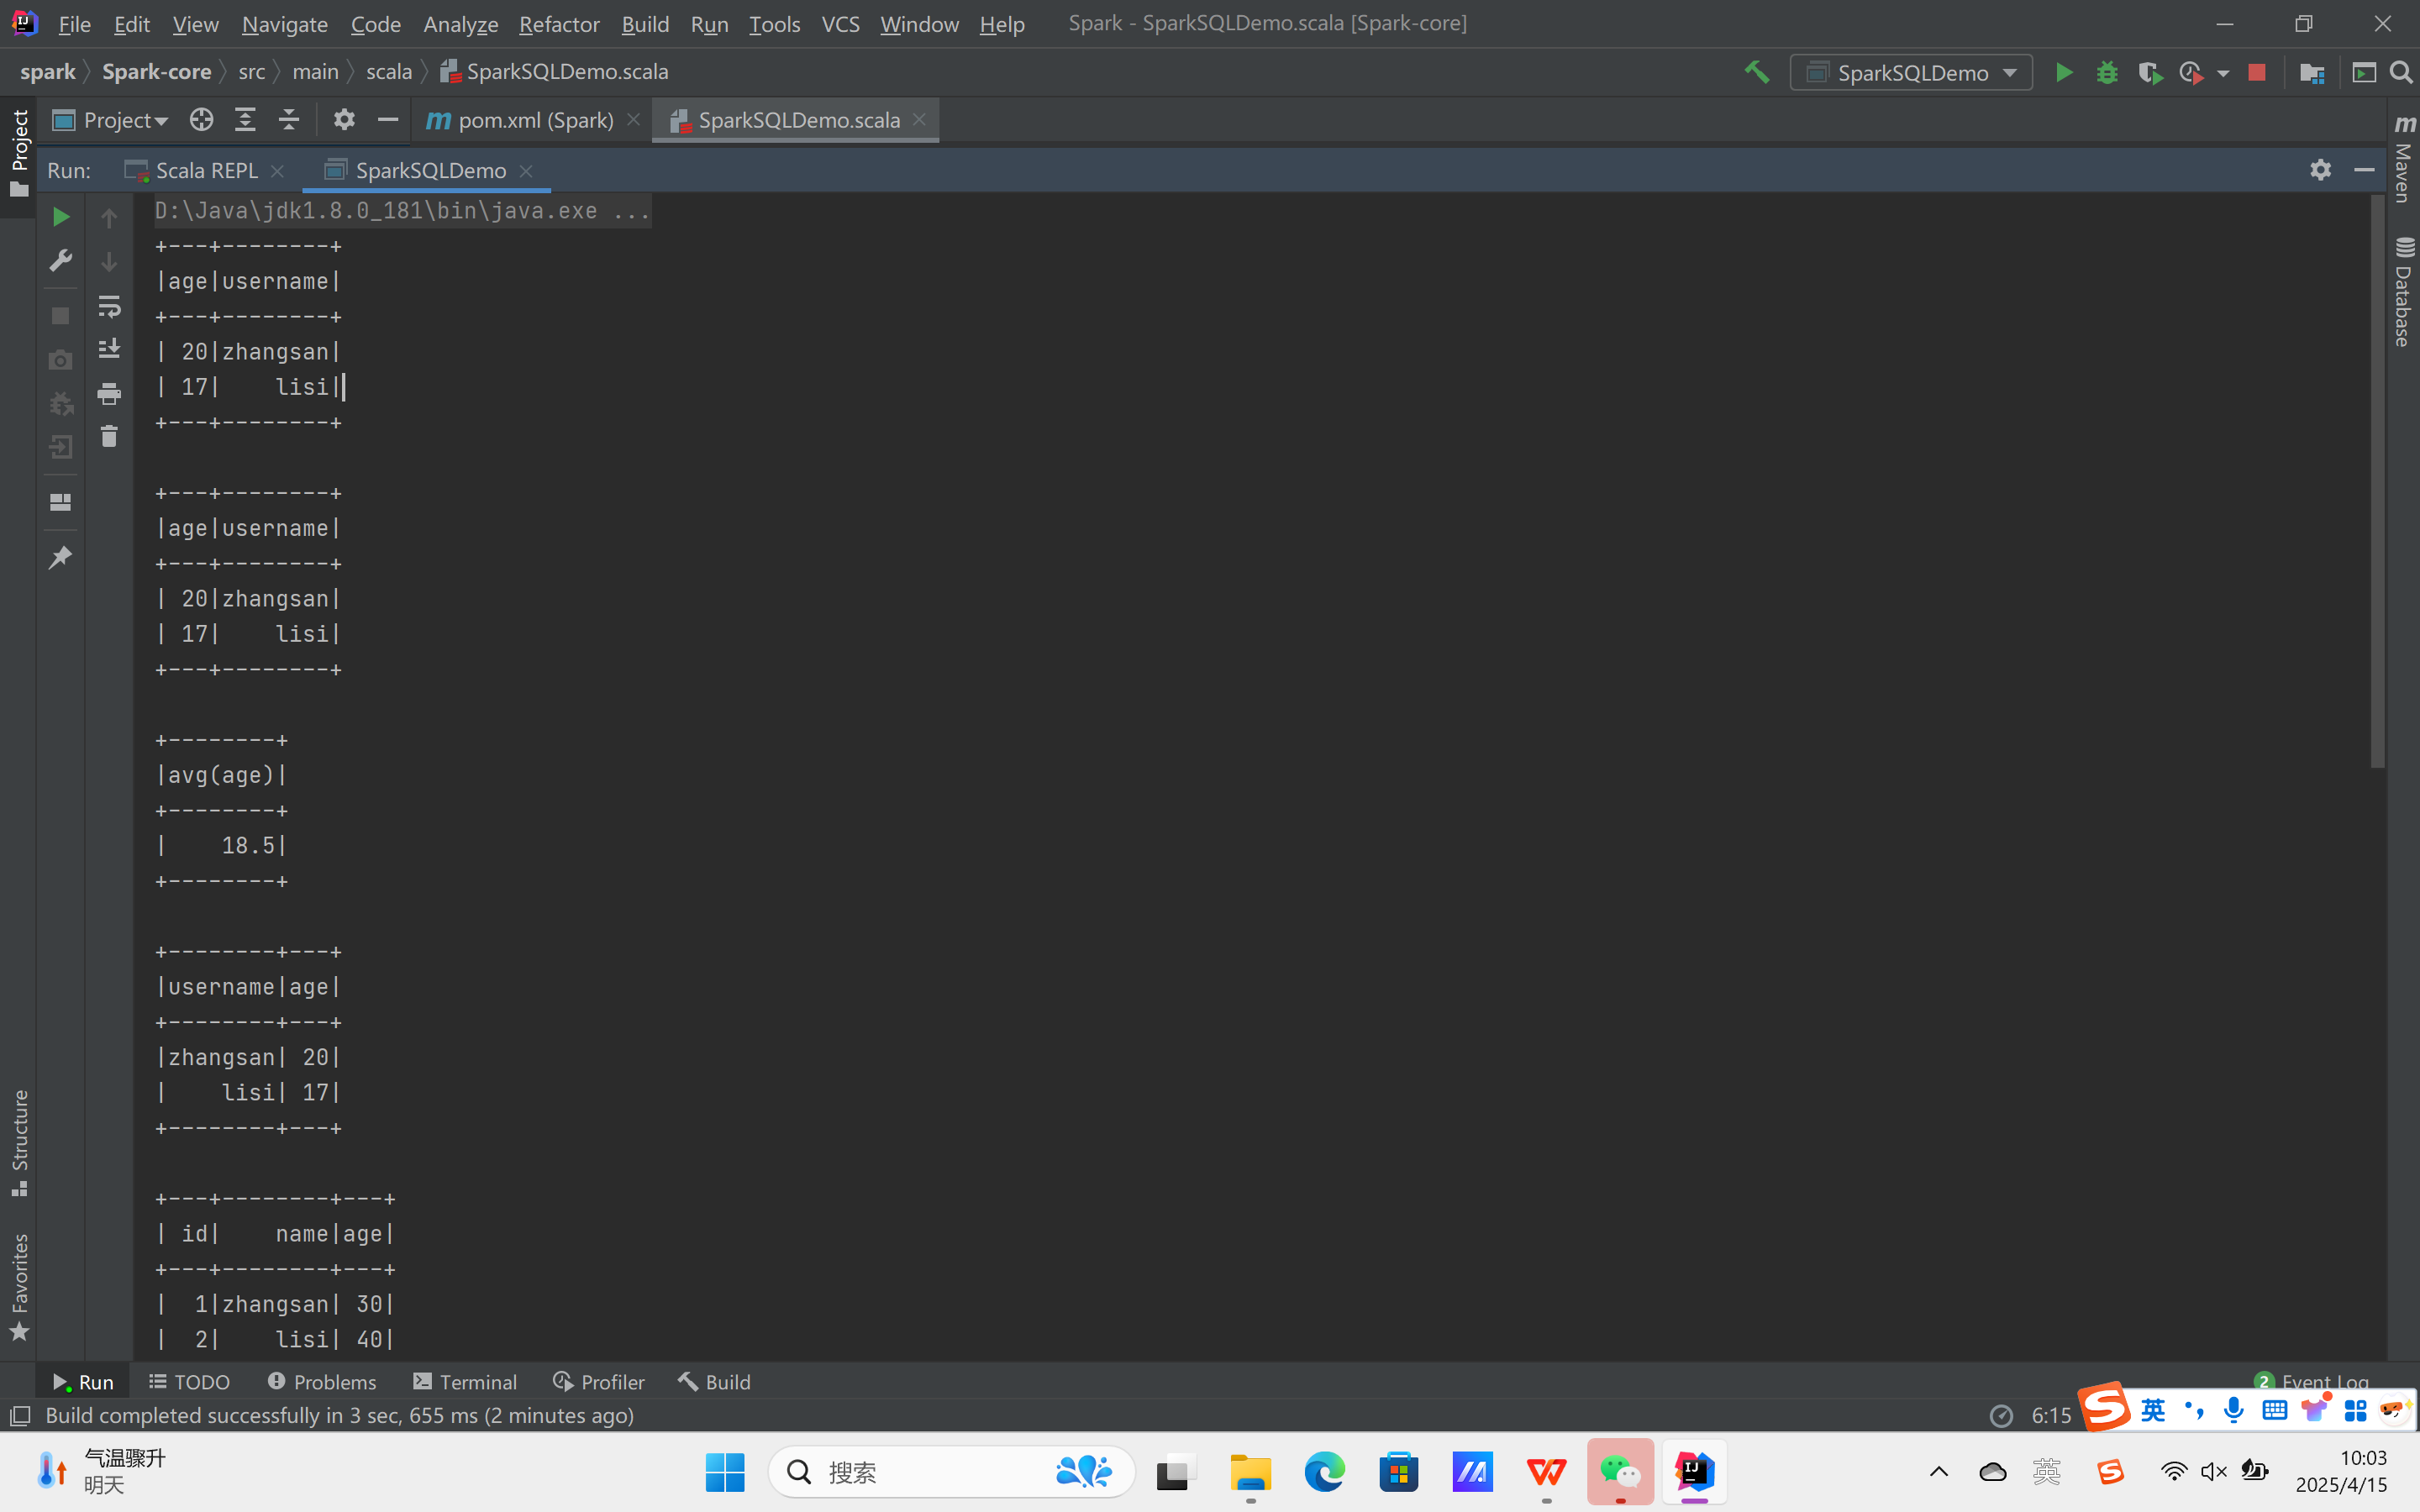
运行结果:
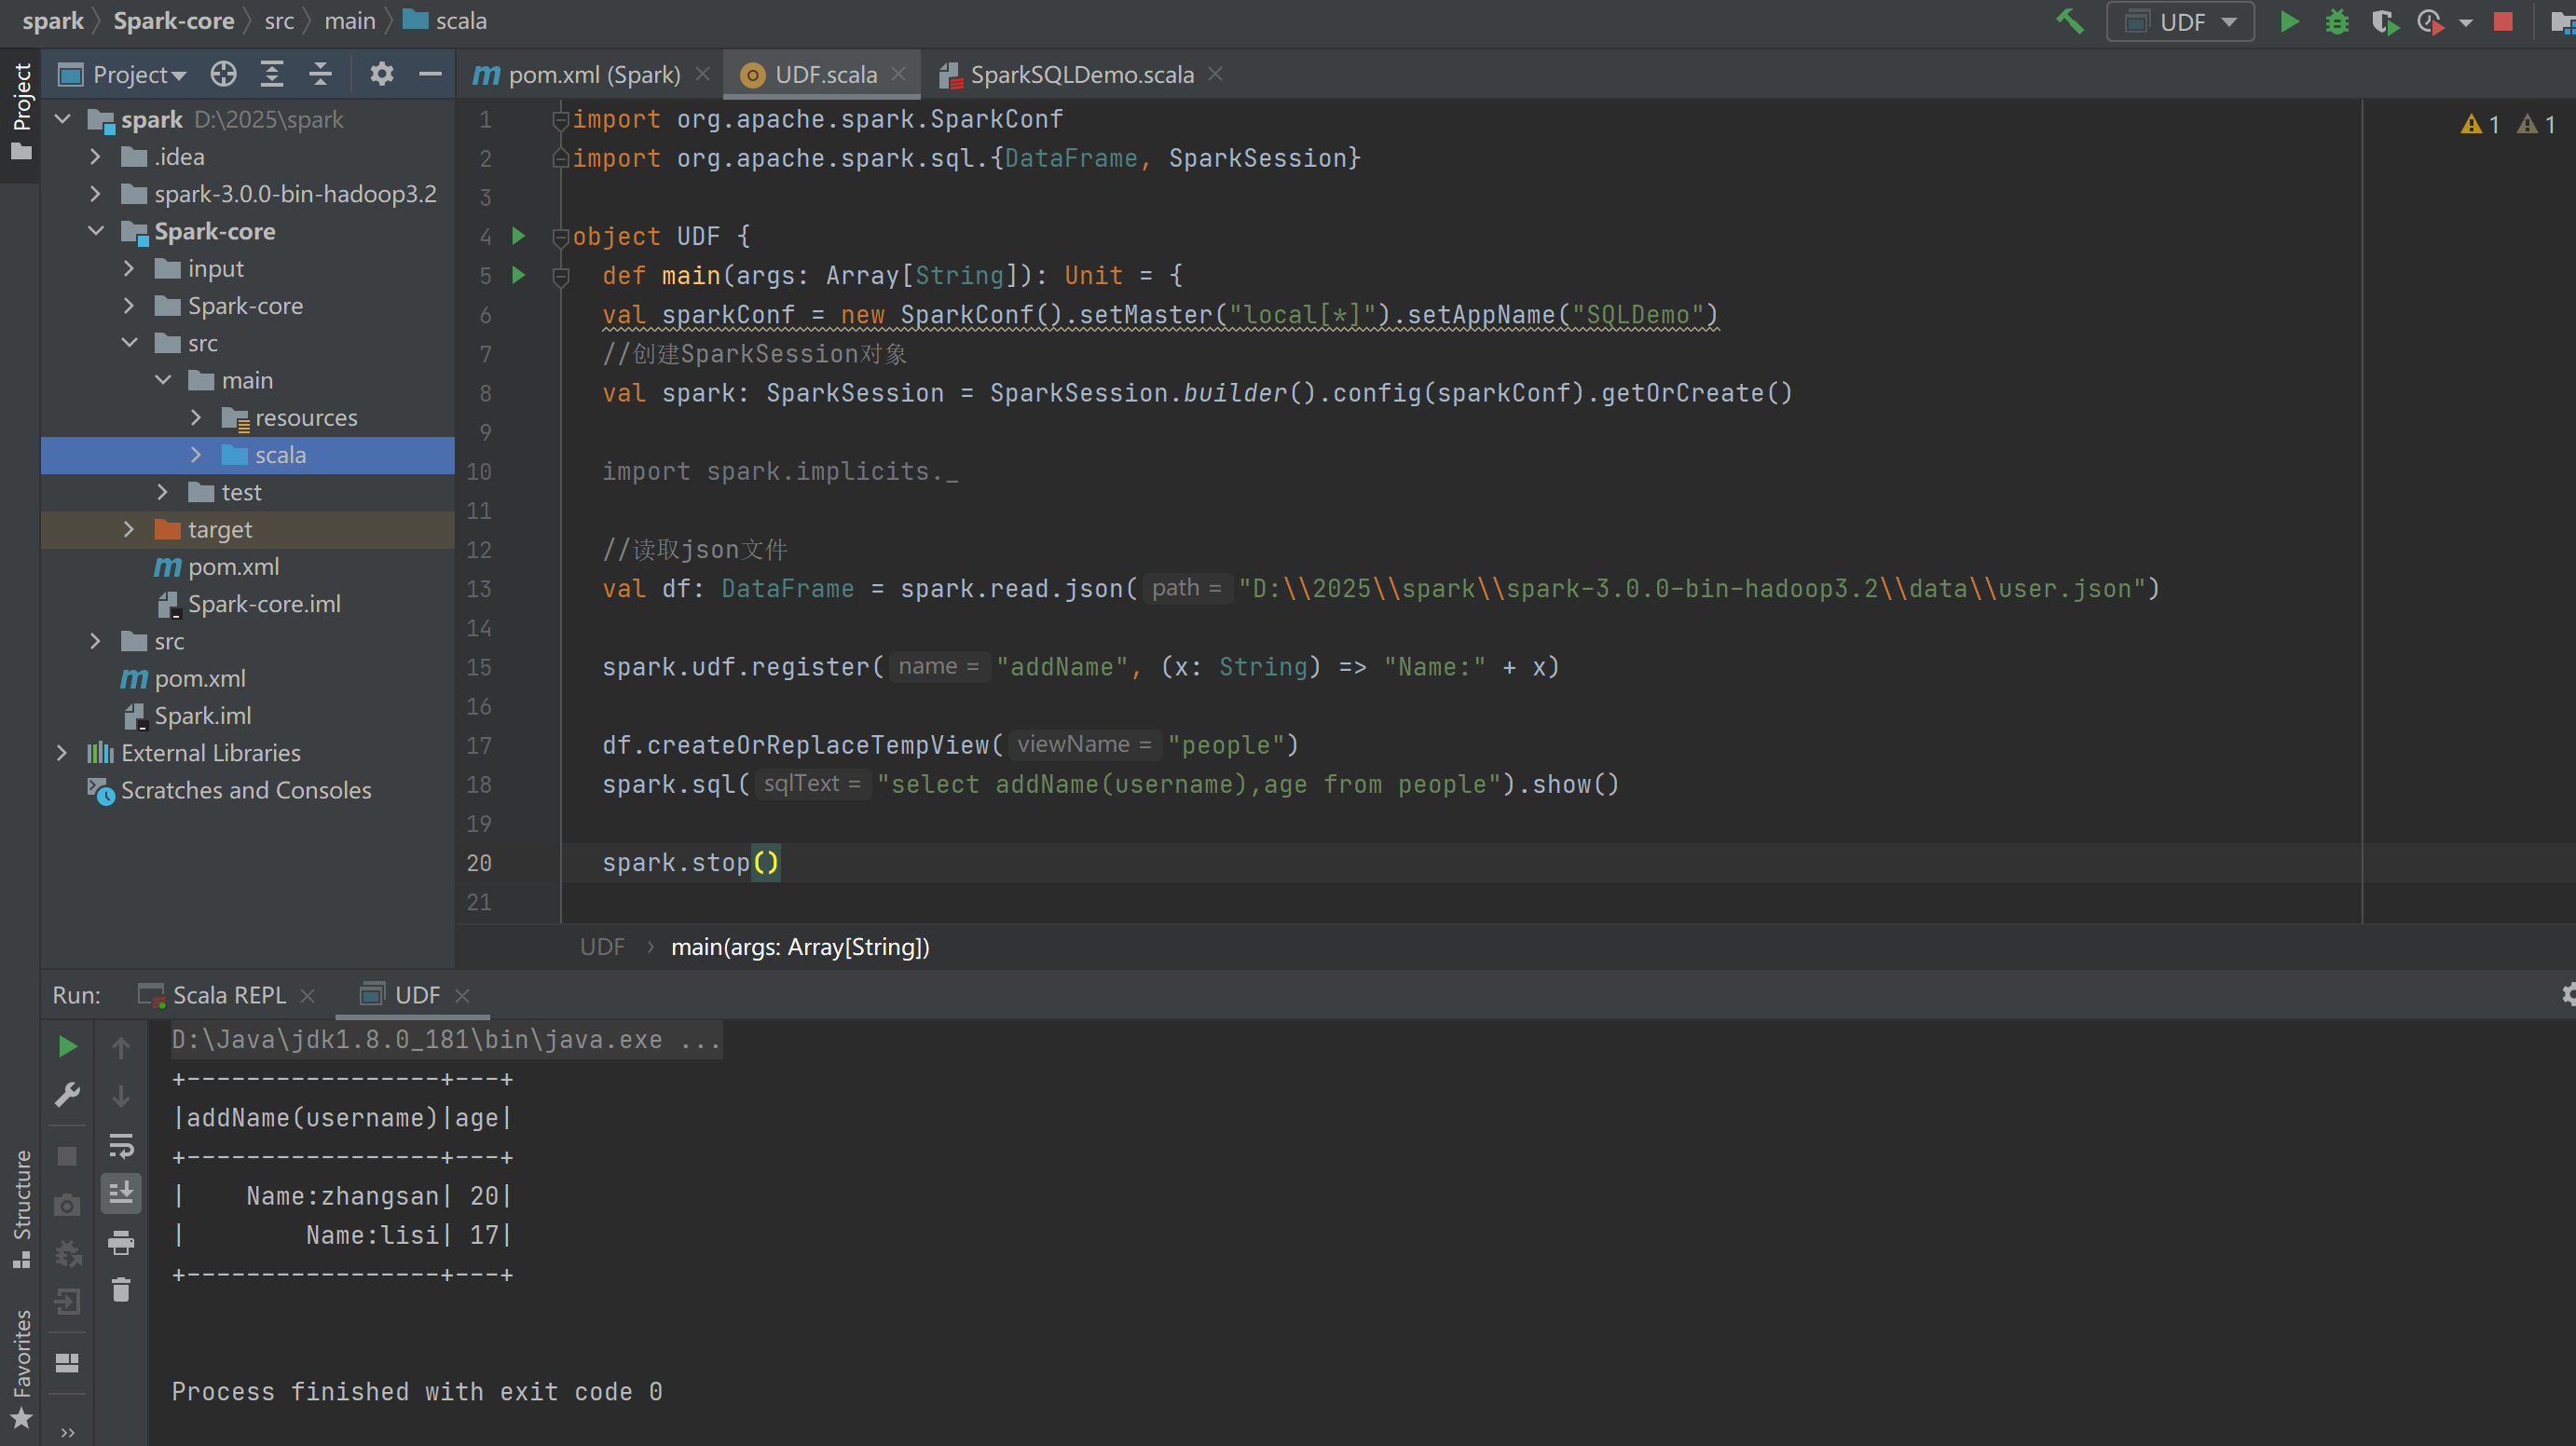
自定义函数:

UDF:
UDAF(自定义聚合函数)

强类型的 Dataset 和弱类型的 DataFrame 都提供了相关的聚合函数, 如 count(),

countDistinct(),avg(),max(),min()。除此之外,用户可以设定自己的自定义聚合函数。Spark3.0之前我们使用的是UserDefinedAggregateFunction作为自定义聚合函数,从 Spark3.0 版本后可以统一采用强类型聚合函数 Aggregator

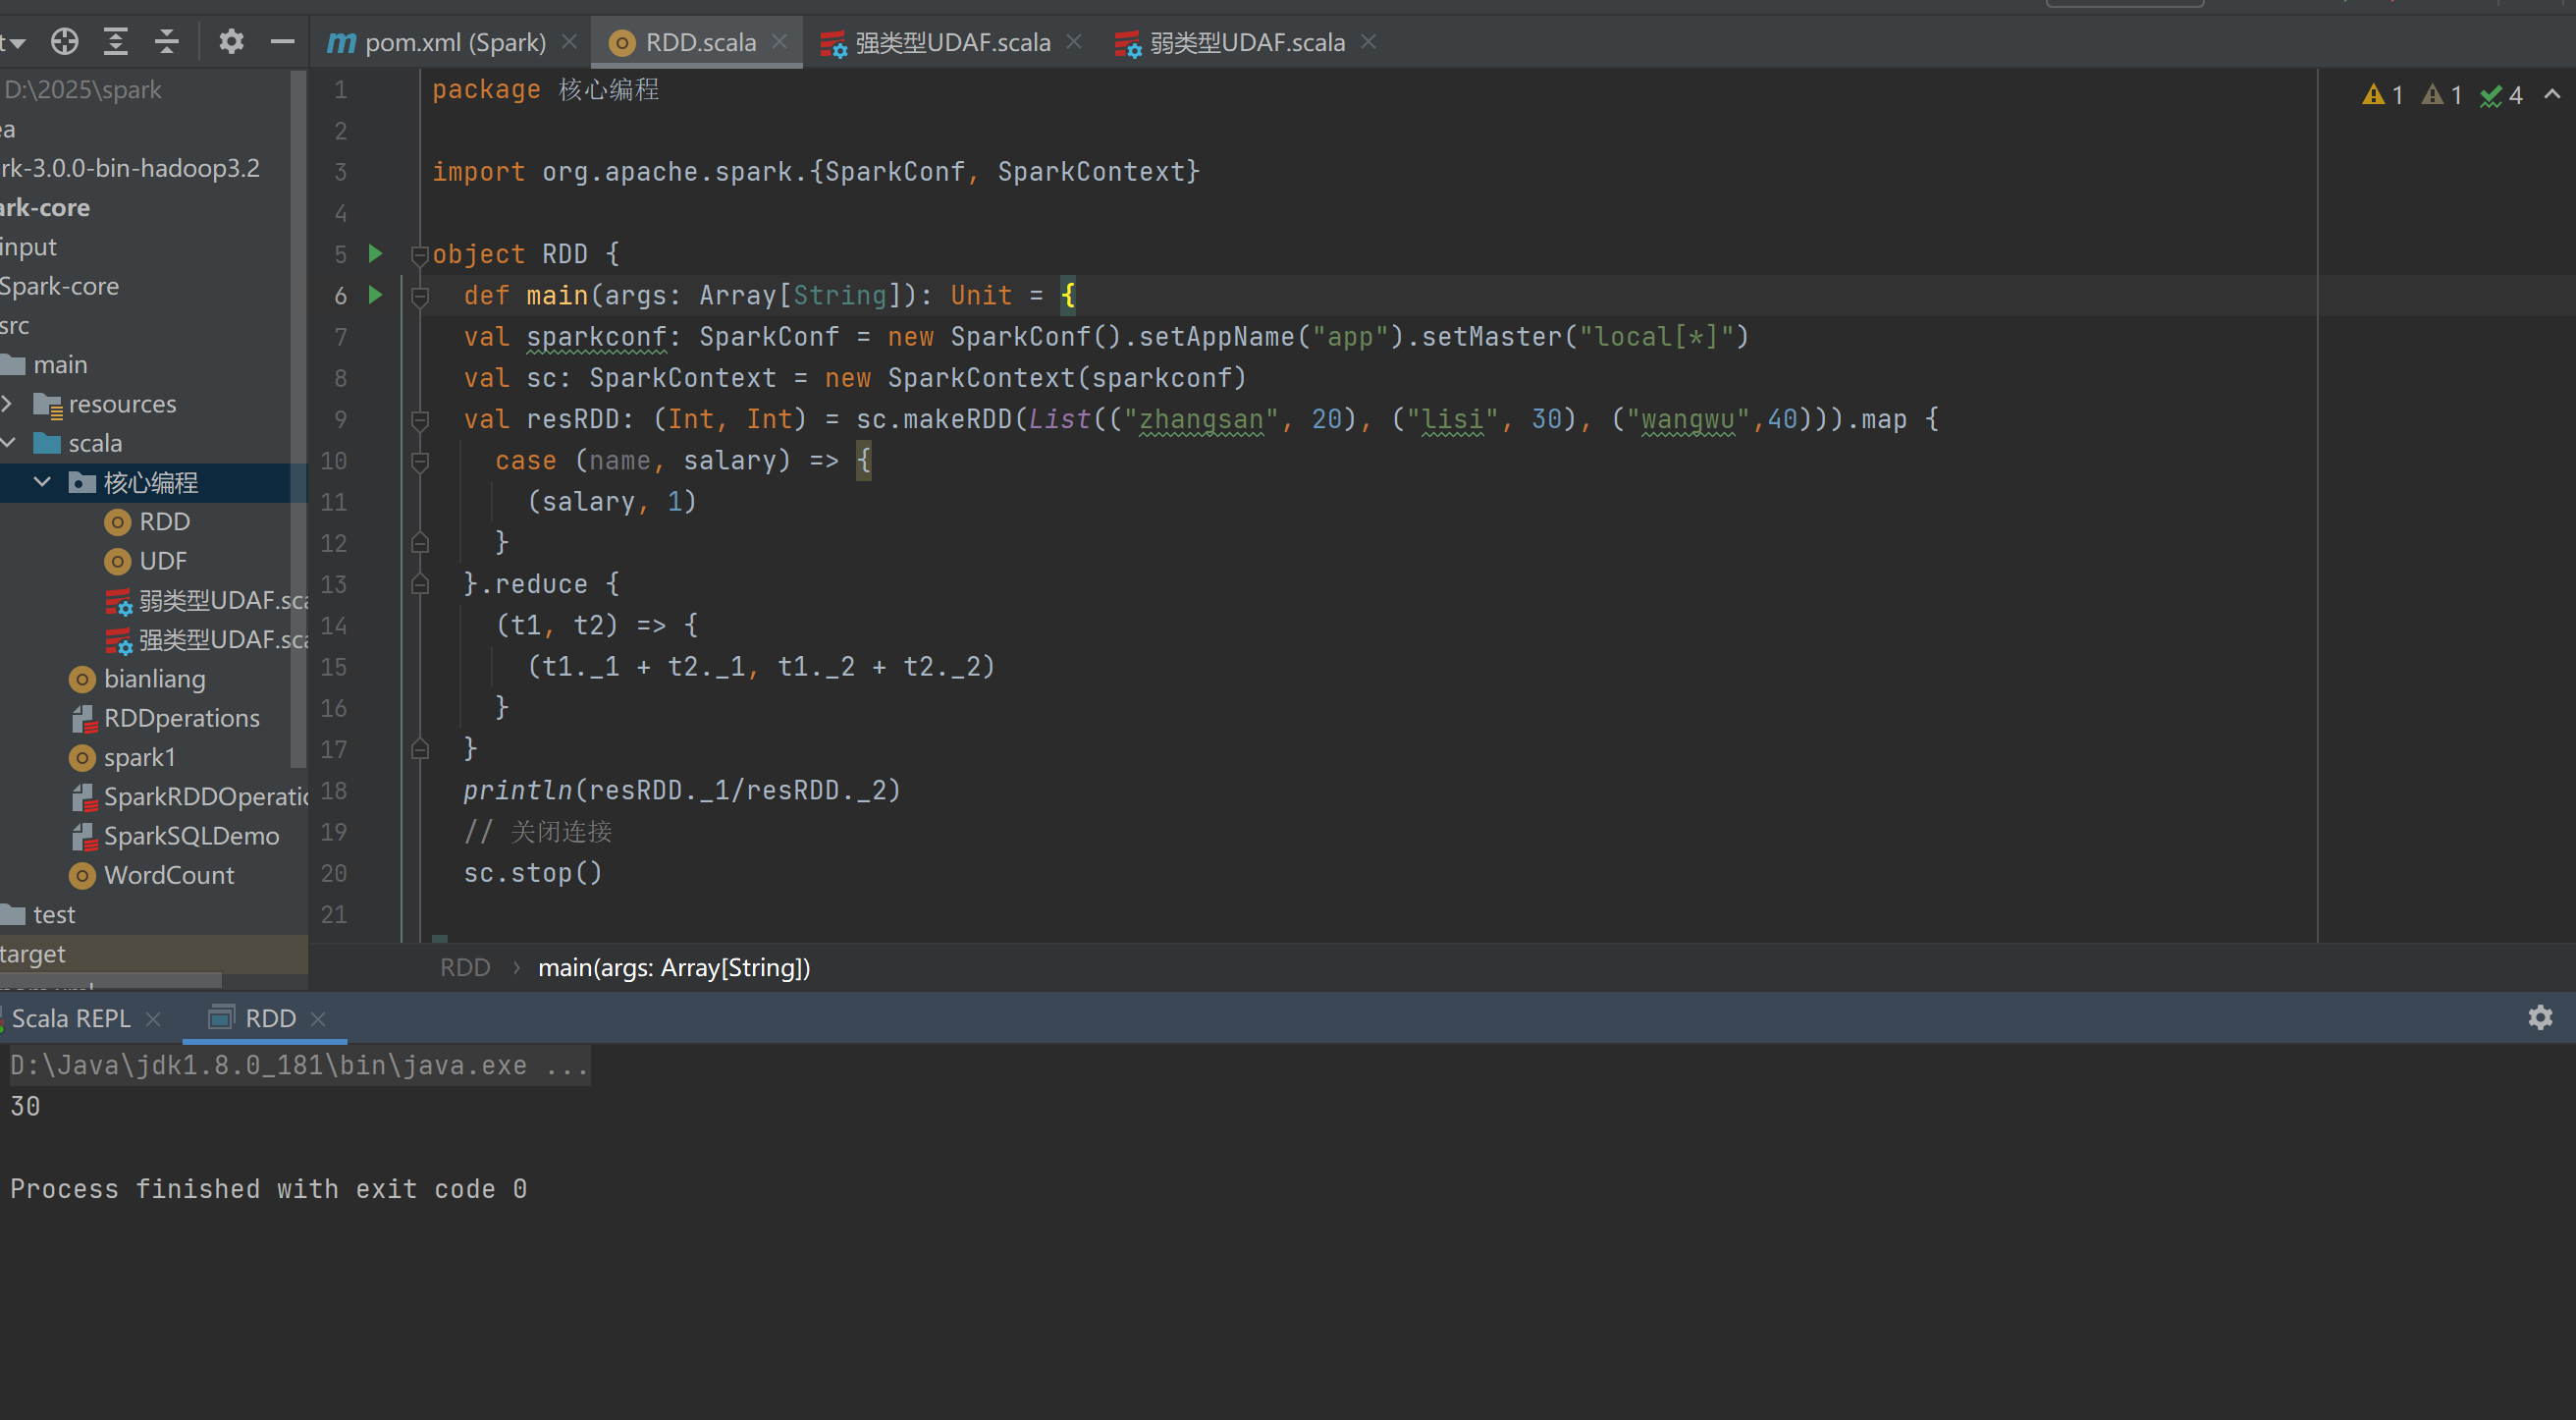
实验需求:计算平均工资

实现方式一:RDD
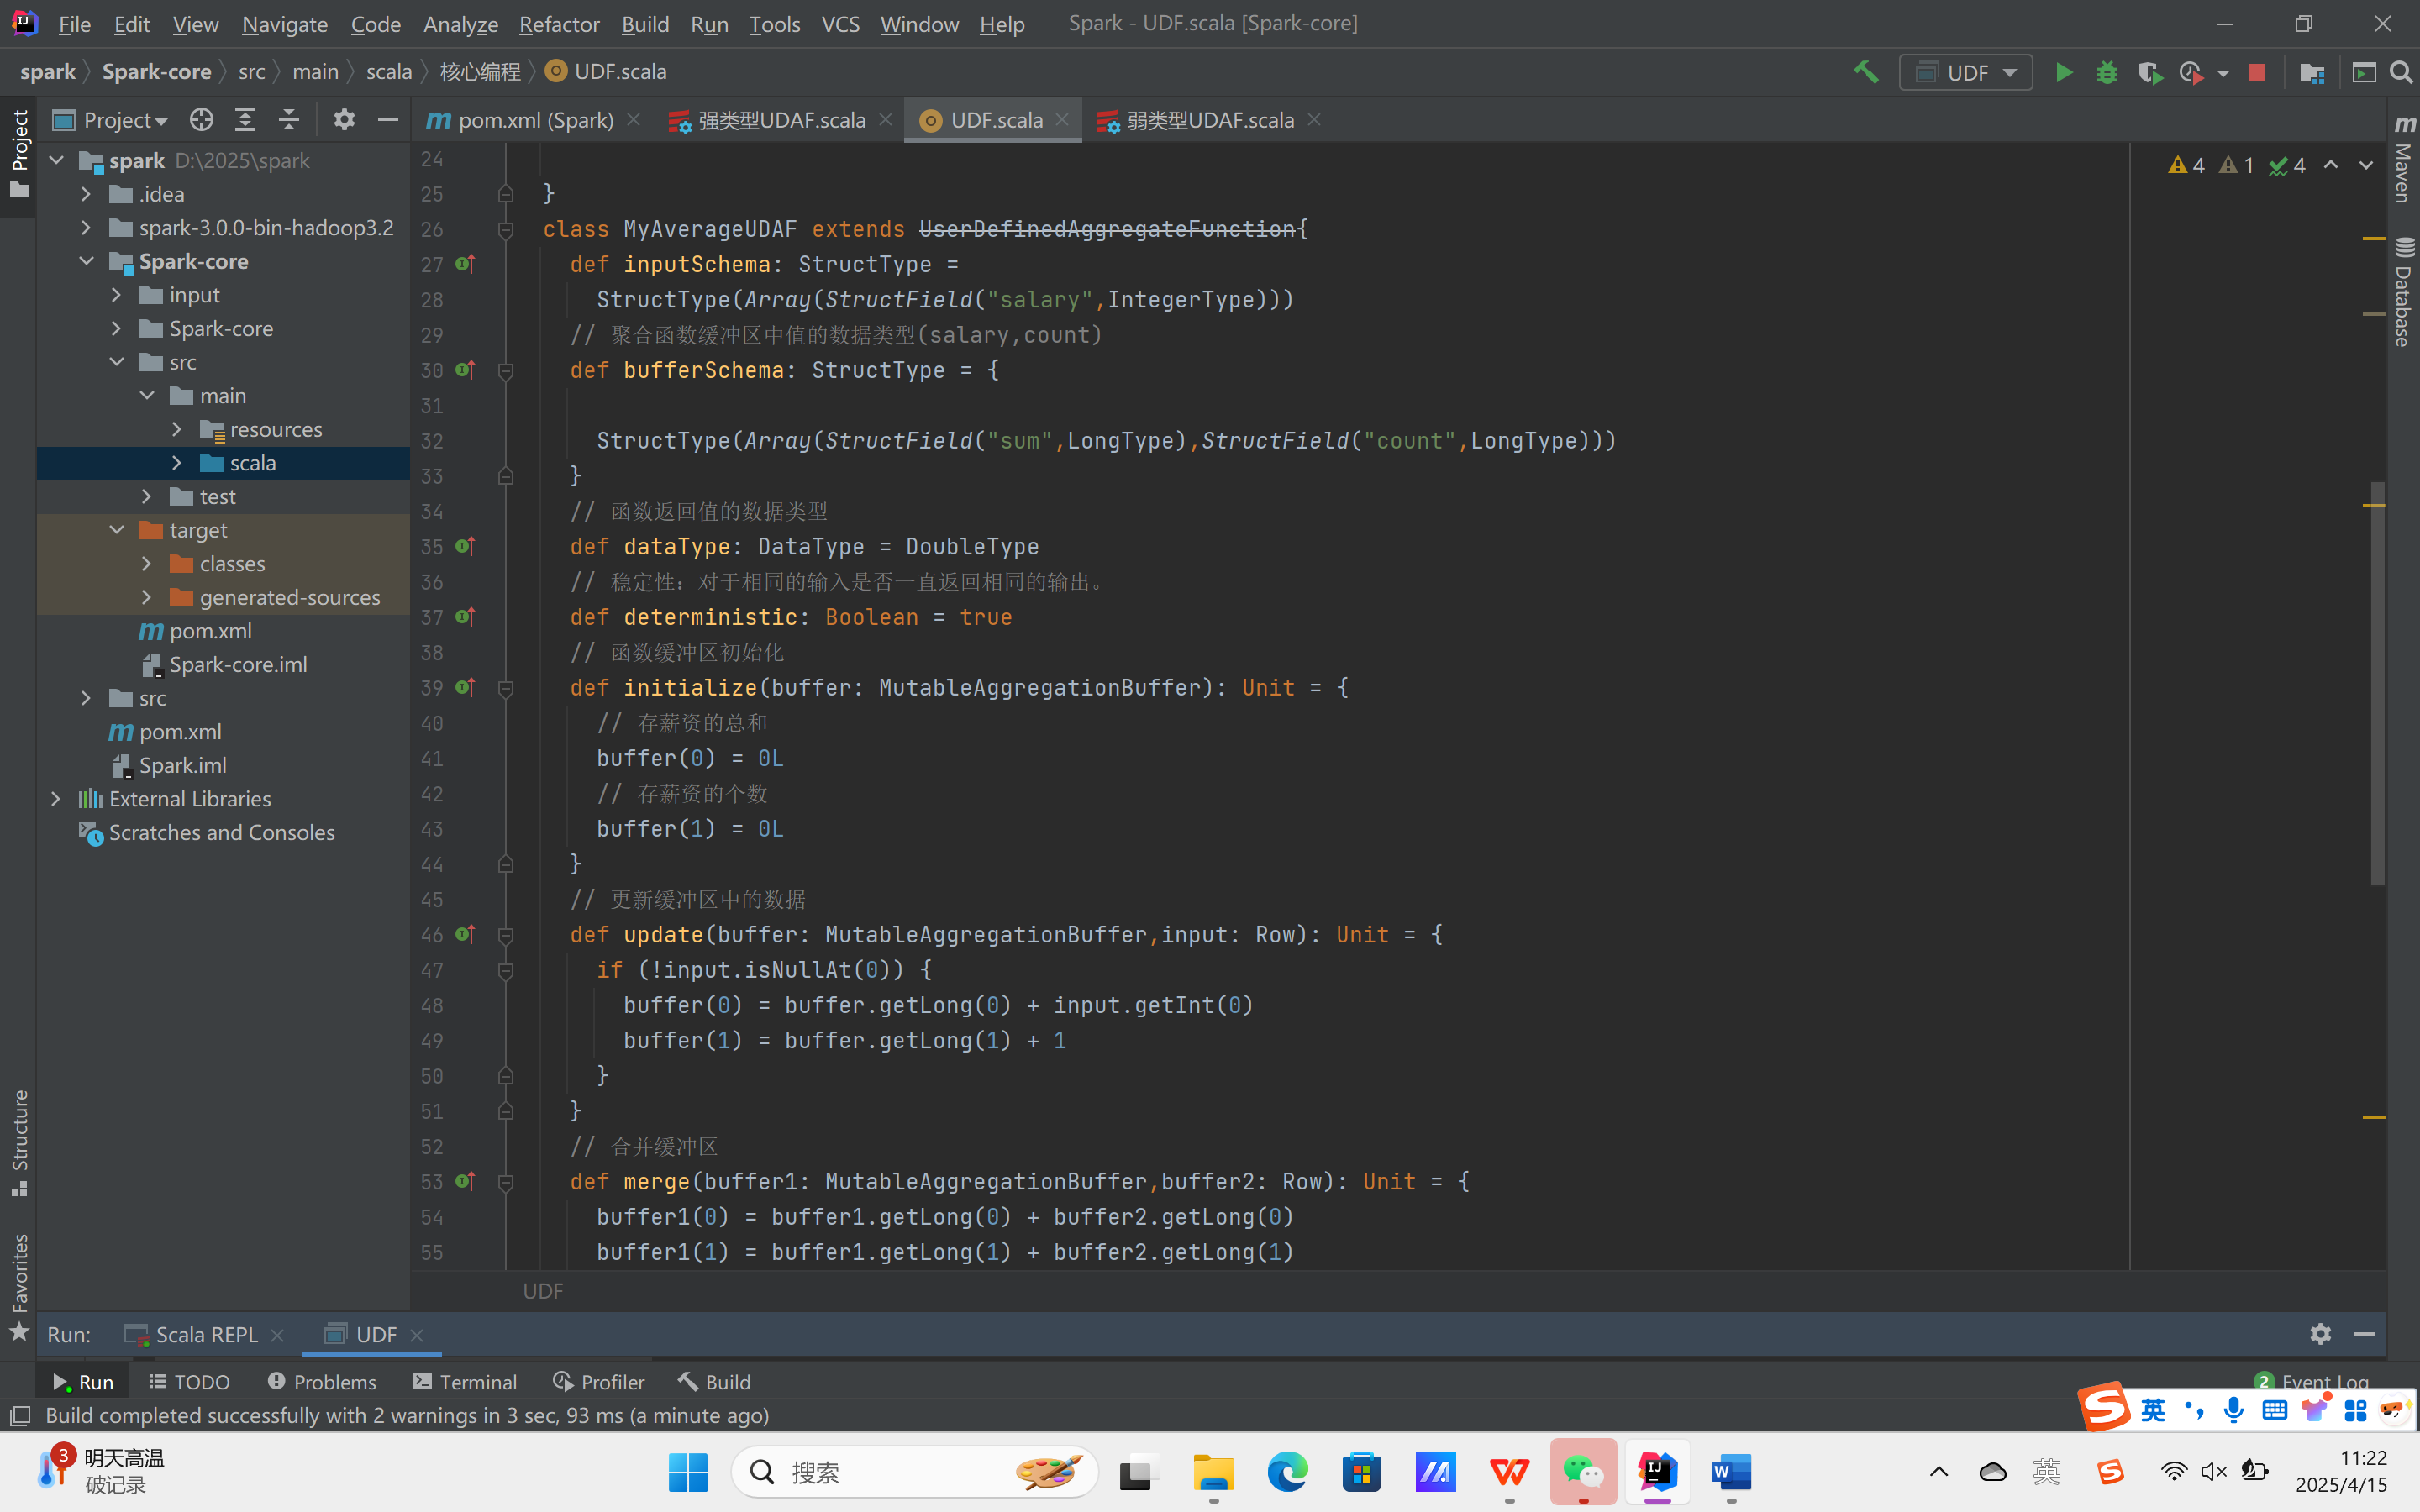
实现方式二:弱类型UDAF
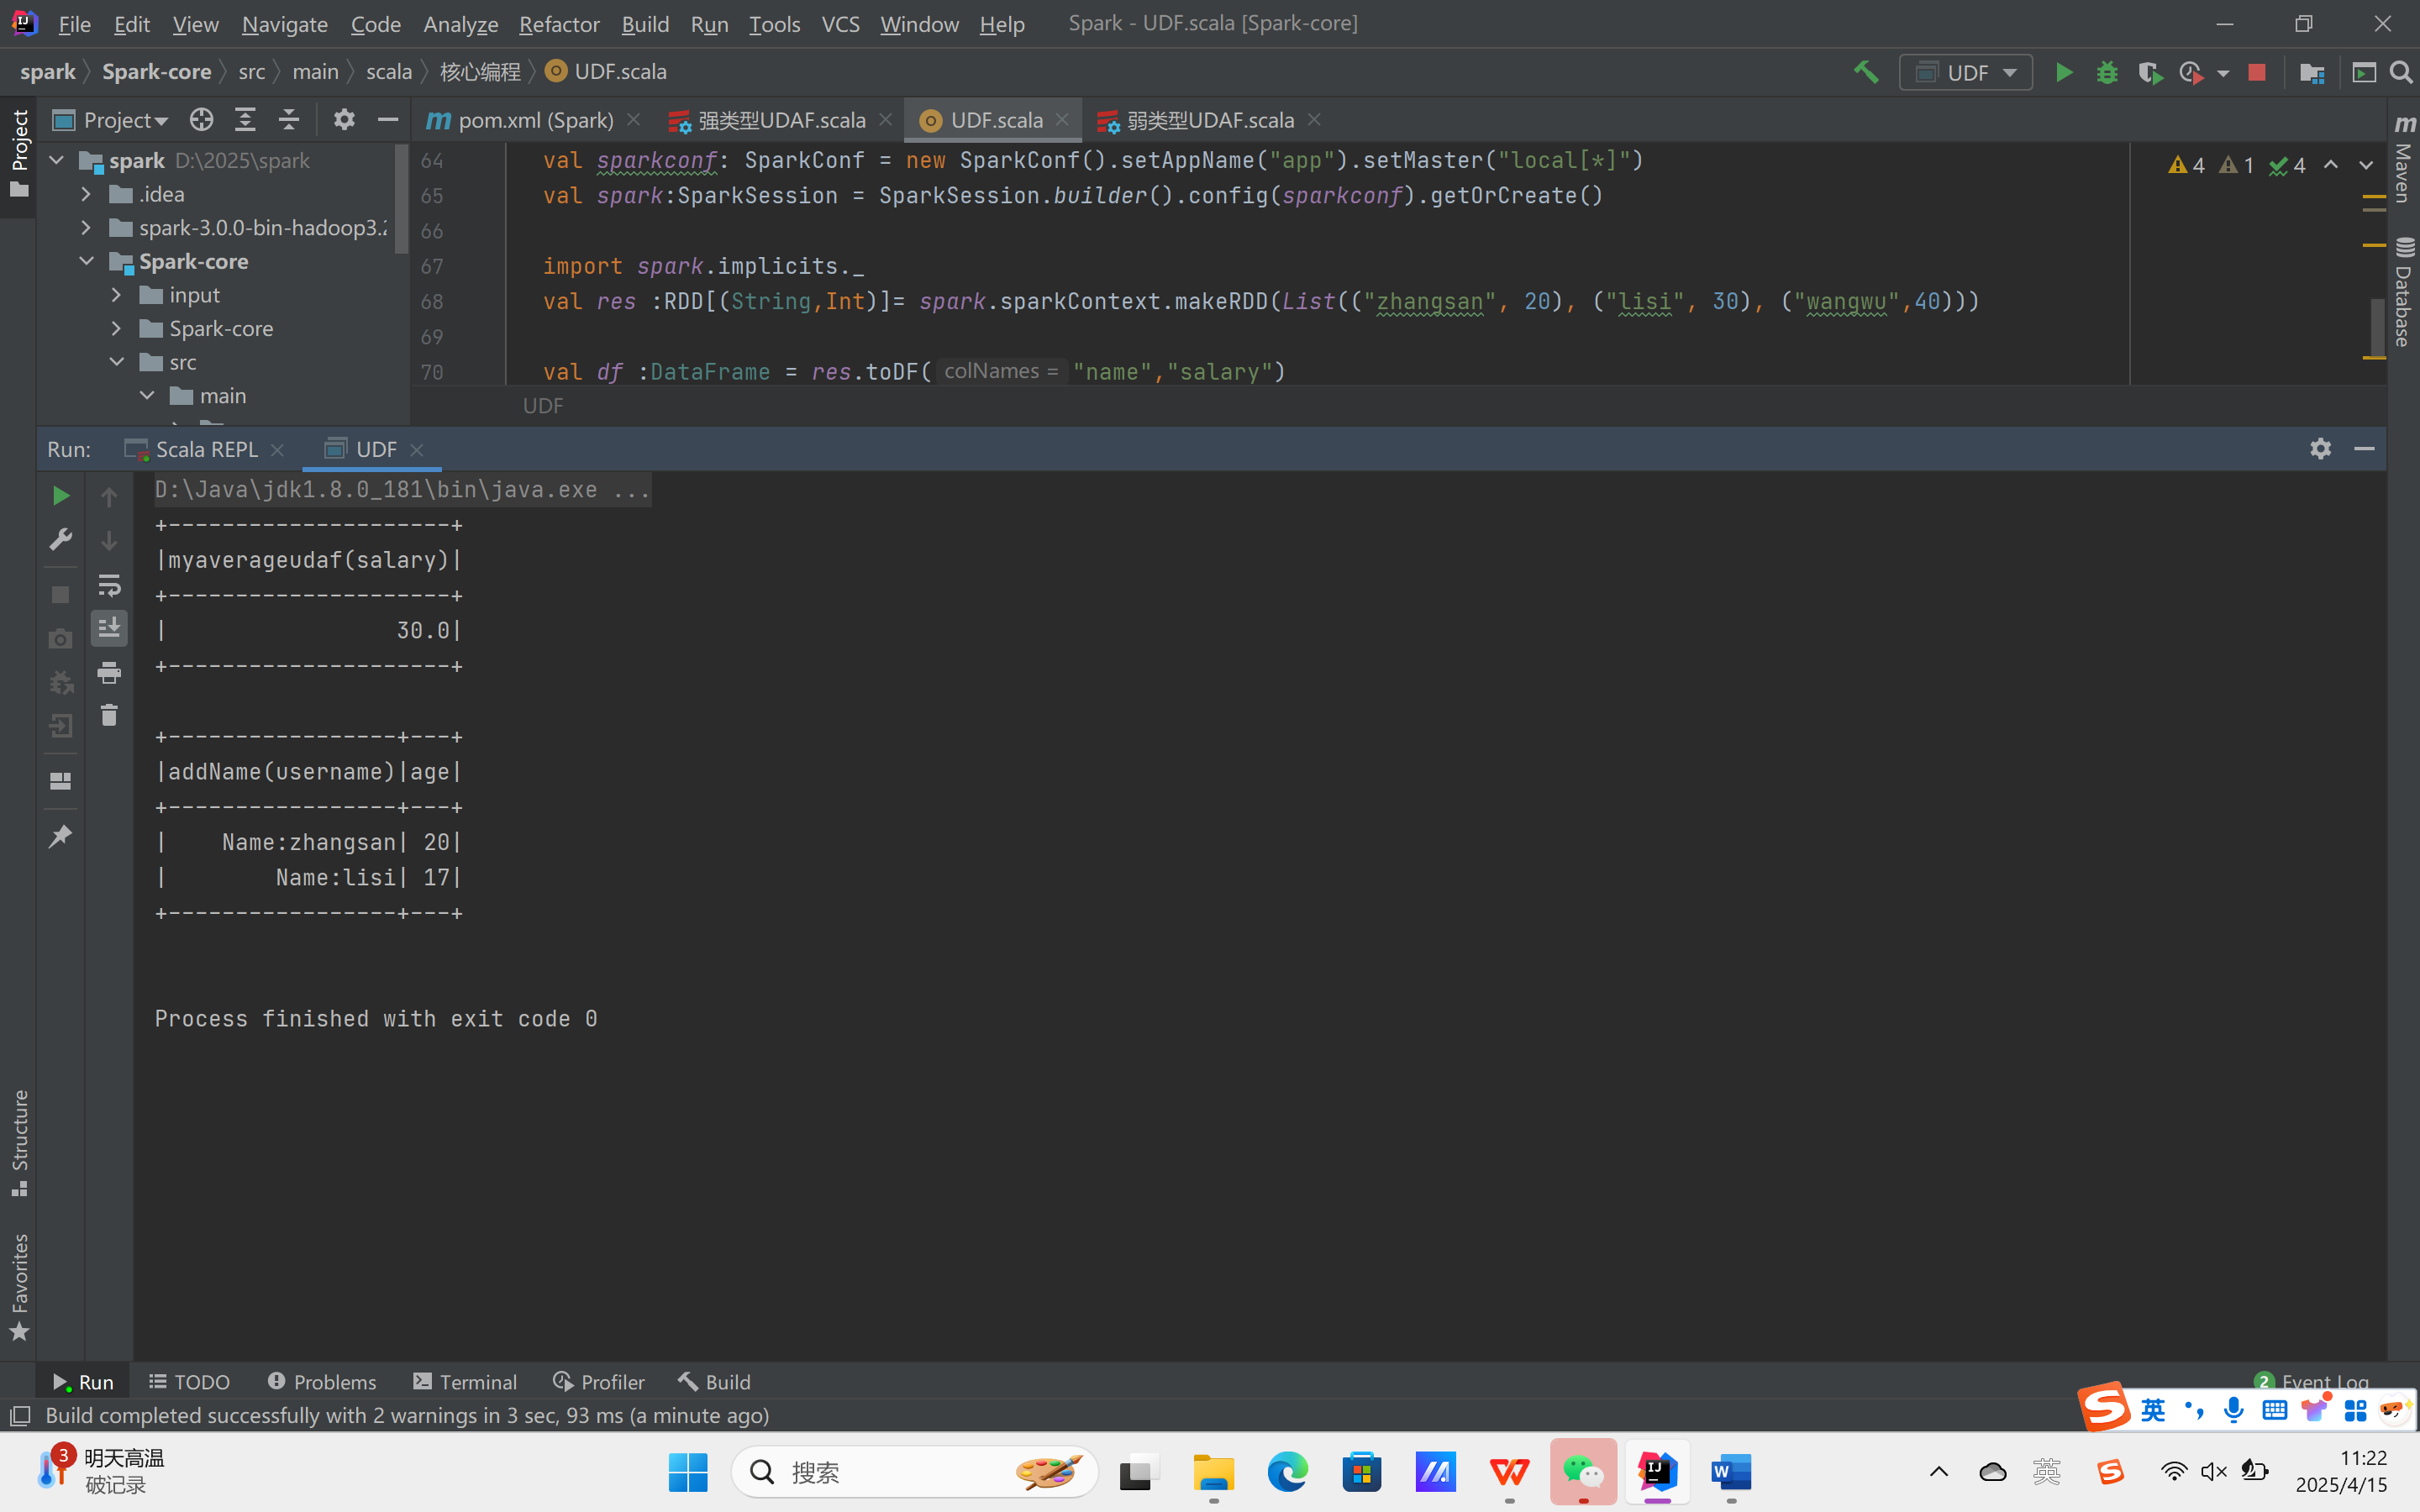
运行结果:
相关推荐
ZhengEnCi12 小时前
覆盖索引怎么设计:从回表代价到 MySQL 与 PostgreSQL 的落地写法
sql·mysql·postgresql
FungLeo15 小时前
FengCMS · PHP+MySQL 升级实录·模型导入从“加密 SQL 码“到.fengmodel.json
sql·mysql·php·工程实践·fengcms
正在走向自律16 小时前
MySQL兼容性深度实践:建表、增删改查与迁移避坑全记录
数据库·sql·mysql·信创·数据库迁移
Decay__17 小时前
PostgreSQL 体系架构全解 —— 进程模型、共享内存、MVCC 与 WAL 预写日志深入
运维·数据库·sql·mysql·架构
Lansonli18 小时前
大数据Spark(九十二):Spark WebUI介绍
大数据·分布式·spark
镰刀韭菜2 天前
用 AI 做数据分析时,怎么保住自己的思考力
sql·数据分析·学习方法·提示工程·ai应用
Databend2 天前
用 SQL 排查支付故障,OpenTelemetry 接入 Databend Cloud 实战
大数据·数据库·sql
AI源码2 天前
基于Spark的期刊推荐系统的设计与实现
大数据·分布式·spark
Decay__3 天前
SQLServer 运维自动化平台 —— PowerShell + SQL Agent 作业:部署、监控、巡检、告警、工单闭环一体化
运维·数据库·sql·mysql·架构
星恒随风3 天前
MySQL 从零入门(十):MVCC、Undo Log 与 Read View 详解——InnoDB 如何实现事务隔离?
linux·数据库·笔记·sql·mysql