在数字化转型加速的背景下,开源技术正重塑数据平台的技术格局。本文深度解析数据平台的全链路架构,精选六款兼具创新性与实用性的开源工具,涵盖数据编排、治理、实时计算、联邦查询等核心场景,为企业构建云原生数据架构提供可落地的选型参考。
一、数据平台技术架构全景
现代数据平台需打通「数据接入-加工-治理-服务」的全生命周期,其核心技术栈可分为五大层级:
- 数据接入层
- 工具链:Debezium(CDC同步)、FilePulse(文件流处理)、Telegraf(指标采集)
- 核心能力:支持结构化/非结构化数据源的秒级接入,兼容Kafka、S3、HTTP等协议
- 数据编织层
- 工具链:Apache Atlas(治理中枢)、DataHub(实时血缘)、Marquez(开源血缘)
- 核心能力:实现元数据血缘可视化、数据质量监控、敏感字段自动识别
- 数据计算层
- 批处理:Spark(通用计算)、Hive(SQL-on-Hadoop)
- 流计算:Flink(事件驱动)、Pravega(分层存储流)
- OLAP引擎:ClickHouse(亚秒级查询)、Trino(联邦查询)
- 数据服务层
- BI工具:Superset(敏捷看板)、Metabase(自助分析)
- API网关:Kong(API管理)、Tyk(轻量级网关)
- 数据治理层
- 质量监控:Great Expectations(数据断言)、Deequ(AWS原生工具)
- 策略管理:sqlmesh(自动化治理)、Apache Ranger(权限控制)
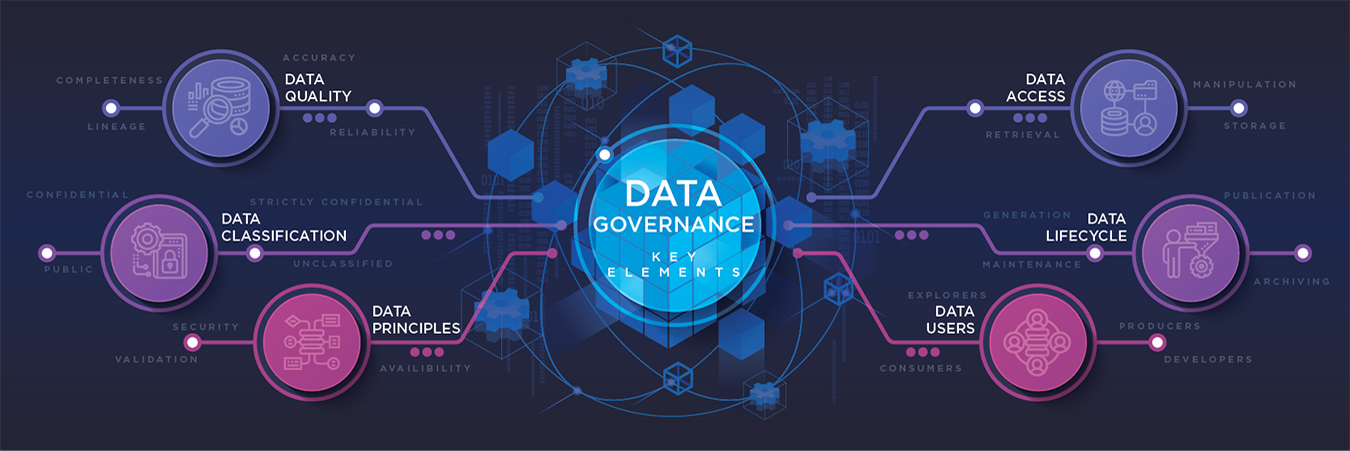
二、六大开源数据平台工具详解
1. Dagster
-
定位:数据编排领域的瑞士军刀
-
核心能力:
- 声明式Pipeline定义,支持Python/SQL混合编程
- 内置数据血缘追踪和资产版本管理
- 提供Dagit可视化界面,支持本地/集群部署
-
典型场景:复杂ETL工作流编排、机器学习流水线管理
2. sqlmesh
-
定位:下一代数据治理工具
-
核心能力:
- 基于SQL的策略管理,实现自动化数据治理
- 支持多租户权限控制与审计日志
- 集成Snowflake/Athena等云数据仓库
-
典型场景:数据合规管理、跨平台数据治理
3. DuckDB
-
定位:内存嵌入式分析数据库
-
核心能力:
- 列式存储加速分析,支持PB级内存计算
- JDBC/ODBC接口无缝对接BI工具
- 向量化执行引擎提升查询性能
-
典型场景:实时仪表盘、移动端数据分析
4. Apache Airflow
-
定位:工作流调度领域的黄金标准
-
核心能力:
- DAG可视化编排,支持复杂依赖管理
- Webhook/GitOps集成实现自动化触发
- 提供丰富的Operator生态
-
典型场景:跨系统任务调度、批处理作业管理
5. Trino
-
定位:联邦查询领域的性能标杆
-
核心能力:
- SQL-on-Anything架构,支持150+数据源
- 动态资源分配应对混合负载
- ANSI SQL兼容性保障开发效率
-
典型场景:数据湖分析、跨平台数据探查
6. ClickHouse
-
定位:极速OLAP数据库
-
核心能力:
- 列式存储实现毫秒级查询响应
- 向量化引擎支持实时写入
- 分布式架构天然水平扩展
-
典型场景:实时报表、用户行为分析
三、技术选型决策树
| 场景需求 | 推荐工具 | 核心优势 |
|---|---|---|
| 数据血缘追踪 | Apache Atlas | 企业级治理能力,支持多数据源 |
| 实时联邦查询 | Trino | 支持150+连接器,兼容ANSI SQL |
| 嵌入式实时分析 | DuckDB | 内存计算,零部署成本 |
| 复杂ETL工作流编排 | Dagster | 声明式编程,全链路可观测性 |
| 流批一体计算 | Flink | 事件驱动架构,精准时间窗口处理 |
| 数据湖轻量级分析 | PrestoDB | 分布式SQL引擎,秒级响应PB级数据 |
四、构建开源数据平台的三大原则
- 模块化设计
- 采用「存储-计算分离」架构,例如Delta Lake(存储)+ Spark(计算)组合
- 通过Apache Iceberg实现表格式标准化,兼容Hive/Metastore
- 云原生适配
- 优先选择支持Kubernetes的原生工具:
- 调度层:Kubeflow、Prefect
- 存储层:MinIO、Ceph
- 计算层:Spark on Kubernetes
- 优先选择支持Kubernetes的原生工具:
- 安全合规加固
- 数据加密:Apache Ranger + Vault密钥管理
- 访问控制:Okera(策略引擎)、Sentry(细粒度权限)
五、总结
开源技术生态的爆发式发展为数据平台建设提供了全新范式。通过Dagster实现工作流自动化、Trino构建联邦查询中枢、ClickHouse打造实时分析引擎,企业可快速构建兼具弹性与智能的数据架构。建议遵循「分层解耦、按需集成」的原则,选择与业务场景深度契合的工具组合,最终实现从数据孤岛到数据资产的跨越式升级。