目录
- 前言
- 一、目标即结果
-
- [1. 目标:](#1. 目标:)
- [2. 提前了解网页信息](#2. 提前了解网页信息)
- [3. 结果](#3. 结果)
- 二、逐步分析
-
- [1 . selenium启动](#1 . selenium启动)
- [2. 获取所有章节](#2. 获取所有章节)
- 3.打开对应章节链接,获取小说文本
- [4. 内容写入本地文件](#4. 内容写入本地文件)
- 三、完整代码
- 四、声名
前言
提示:通过案例掌握selenium语法
涉及技术:Python + Selenium
一、目标即结果
1. 目标:
获取某网页整本小说内容。
2. 提前了解网页信息
-
小说目录:地址
-
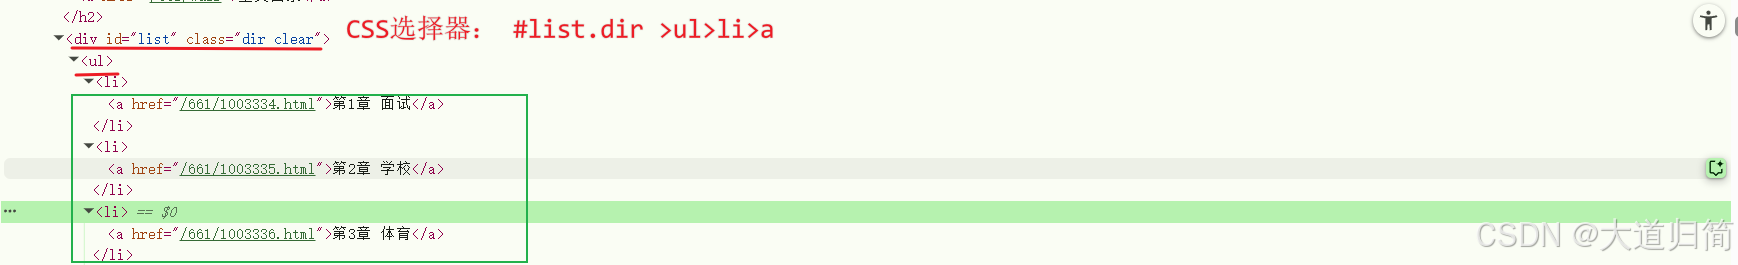
目录 CSS标签特征:
#list.dir >ul>li *
-
章节的地址特征:主站名称 + href值
-
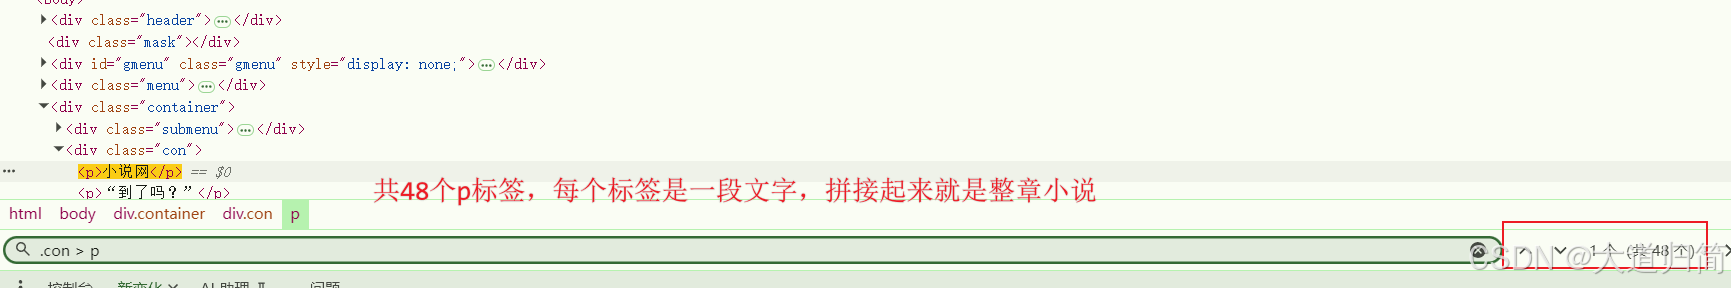
章节CSS选择器:
.con > p

-
章节内容 :
.con > p中所有p标签内容拼接
3. 结果
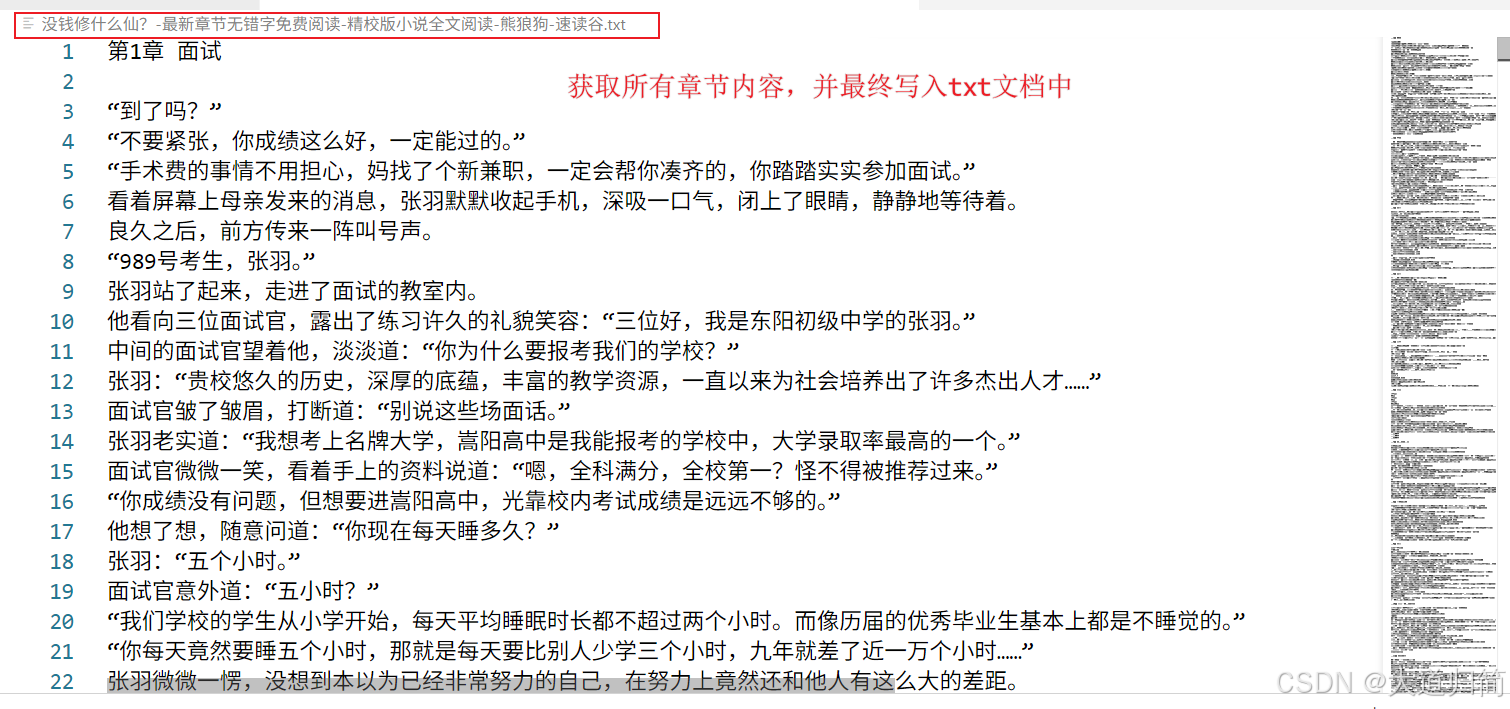
整本小说:章节名+ 文章内容
二、逐步分析
1 . selenium启动
初学阶段,一般模板都如下:
python
openchrome = webdriver.Chrome() #启动浏览器

#具体时间根据网站情况而定
openchrome.implicitly_wait(2) # 最大等待时间为2s;

openchrome.maximize_window() # 启动时显示浏览器最大化
openchrome.get("https://www.XXXX.com/") #目标地址

'''
要做的事情
'''
openchrome.quit()# 关闭浏览器
2. 获取所有章节
python
#之前已经得知目录特征如下:#list.dir >ul>li

#那么我们获取整个小说目录
dir =openchrome.find_elements(By.CSS_SELECTOR,'#list.dir >ul>li >a')

chapter = [] ## 记录所有章节的地址
chapter_name = [] ## 记录所有章节的名称
for a in dir:
	#读取每隔章节的名称
	title = a.text
	#获取每隔章节的地址,从<a href="/xxxx.html">获取
    href = a.get_attribute('href')
    #将章节名读入集合chapter_name 中
    chapter_name.append(title)
	#将章节地址读入到集合chapter中
    chapter.append(href)
#统计一下获取了多少章
print(f"总共获取到{len(chapter)}章")
3.打开对应章节链接,获取小说文本
python
#从第二部分我们已经知道;章节名称存在集合chapter_name中,章节地址存在chapter中

#for循环遍历chapter中的每个url

for url in chapter:
	#打开对应的网页
	openchrome.get(url)
	#根据CSS选择文本内容,此时已经获取p标签中的文本内容
	content_elements = openchrome.find_elements(By.CSS_SELECTOR,'.con > p')
	#读取所有章节内容,写入context中
	contexts =[] #定义contexts,用于记录章节内容
	for element in content_elements:
		#将p标签内容写入到context中,一个p标签就是小说中的一段
		contexts.append(element.text)
4. 内容写入本地文件
powershell
for url in chapter:
	#打开对应的网页
	openchrome.get(url)
	#根据CSS选择文本内容,此时已经获取p标签中的文本内容
	content_elements = openchrome.find_elements(By.CSS_SELECTOR,'.con > p')
	#读取所有章节内容,写入context中
	contexts =[] #定义contexts,用于记录章节内容
	for element in content_elements:
		#将p标签内容写入到context中,一个p标签就是小说中的一段
		contexts.append(element.text)
		#打开本地写入函数
        with open(title_text+'.txt', 'a', encoding='utf-8') as f:
        	#先写入章节标题,从chapter_name获取(第2步已经得到)
            f.write(chapter_name[chapter.index(url)]+"\n")
			#再写入文档中
            for element in contexts:
                f.write(f"{element}\n")
三、完整代码
python
from selenium import webdriver
from selenium.webdriver.common.by import By

# ------------------------------------------------------------
'''分析网站特征
目标:获取整个小说内容: 获取每一章节小说的链接以及文章内容,最后将整本小说拼接到txt文档中
目录地址:https://www.sudugu.com/661/#dir
目录CSS标签:#list.dir >ul>li *

每一章的地址:https://www.sudugu.com + href="/661/1046984.html"
每一章内容:p标签的所有内容拼接
每一章的CSS选择器:.con > p
'''

def main():

    openchrome = webdriver.Chrome()
    openchrome.implicitly_wait(2) # 最大等待时间为2s;
    openchrome.maximize_window()
    openchrome.get("https://www.sudugu.com/661")
    # 获取所有内容元素(按DOM顺序)
    title_text = openchrome.title
    print(f"标题{ title_text}")
    dir = openchrome.find_elements(By.CSS_SELECTOR,'#list.dir >ul>li >a')
    ##遍历每一个li标签,获取 其中a标签的 href

    chapter = []
    chapter_name = []
    for a in dir:
        title = a.text
        href = a.get_attribute('href')
        chapter_name.append(title)
        # https://www.sudugu.com+href
        #chapter.append(f"https://www.sudugu.com{href}")
        chapter.append(href)
    print(f"总共获取到{len(chapter)}章")
    print(chapter[:2])

    # 遍历每一个chapter,获取章节内容,并将chapter_name 与对应内容存到 txt文档中

    #先测试2章
    #for url in chapter[:2]:
    for url in chapter:
        print("正在爬取:"+url)
        openchrome.get(url)
        content_elements = openchrome.find_elements(By.CSS_SELECTOR,'.con > p')
        contexts =[]
        for element in content_elements:
            contexts.append(element.text)
        #将对应context 与 chapter_name 写入txt文档中
        with open(title_text+'.txt', 'a', encoding='utf-8') as f:
            f.write(chapter_name[chapter.index(url)]+"\n")
            for element in contexts:
                f.write(f"{element}\n")

    openchrome.quit()
# ------------------------------------------------------------
if __name__ == '__main__':
    main()
四、声名
以上内容仅供学习、误用于其他用途;因此产生的纠纷与本人无关