一、教学环境
1、1Panel:现代化、开源Linux服务器管理面板
2、Ollama:开源大语言模型管理平台
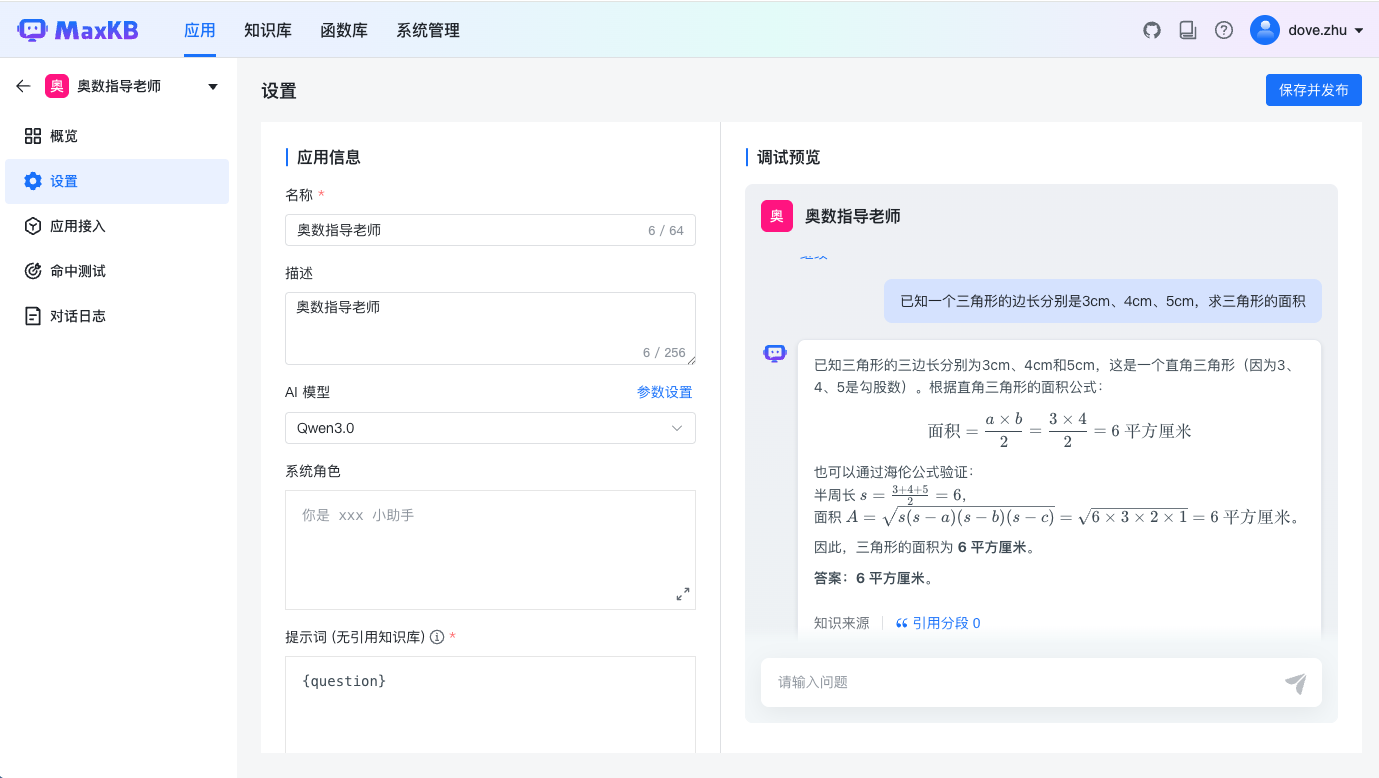
3、MaxKB:强大易用的企业级 AI 助手
二、实操步骤
步骤1、1Panel 安装:
安装说明参见在线文档:在线安装 - 1Panel 文档:
操作比较简单,参照文档具体操作,此处不做详细说明。
注意事项:如果是公有云,记得开通网络策略,确保1Panel能正常访问。
步骤2、通过1Panel安装Ollama:
点击进入 1Panel 应用商店,点击AI,选择Ollama点击安装
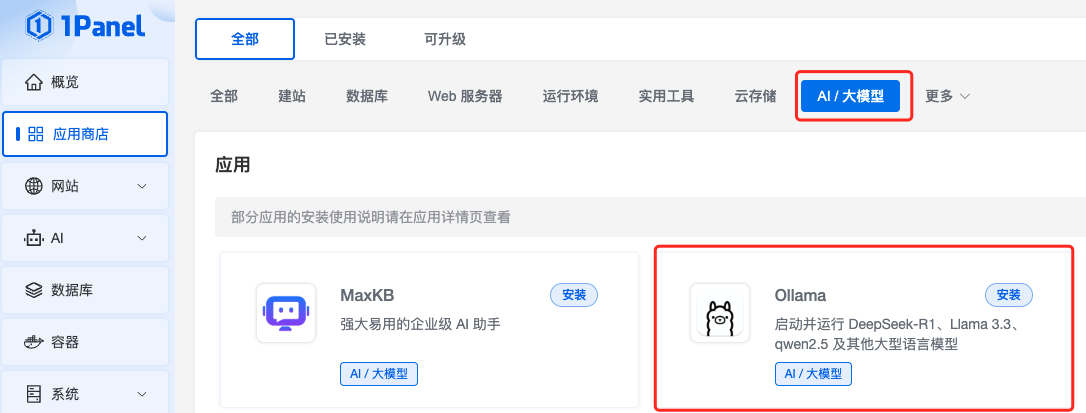
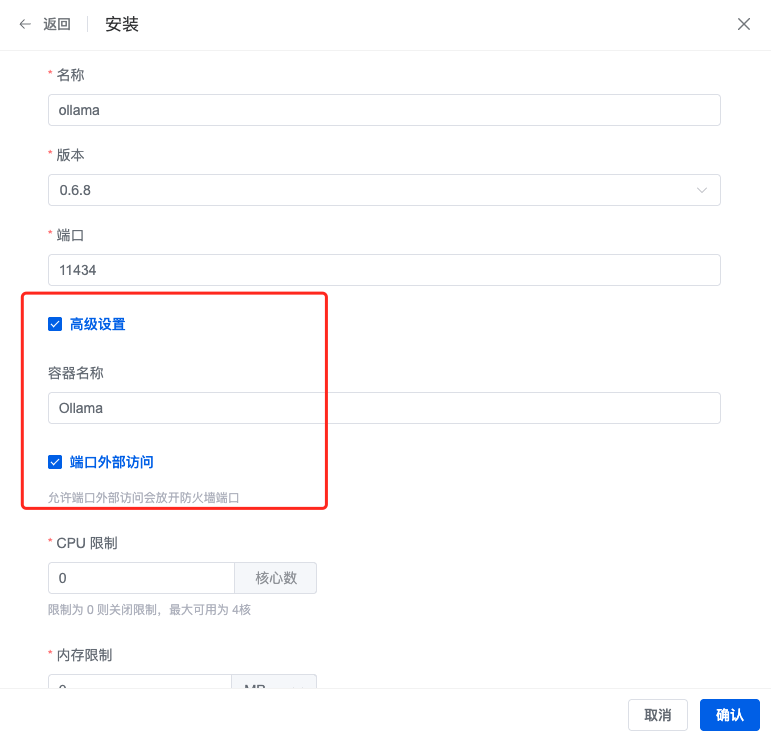
点击安装输入容器名称,开启端口外部访问,其他保持默认点击确认开始安装。
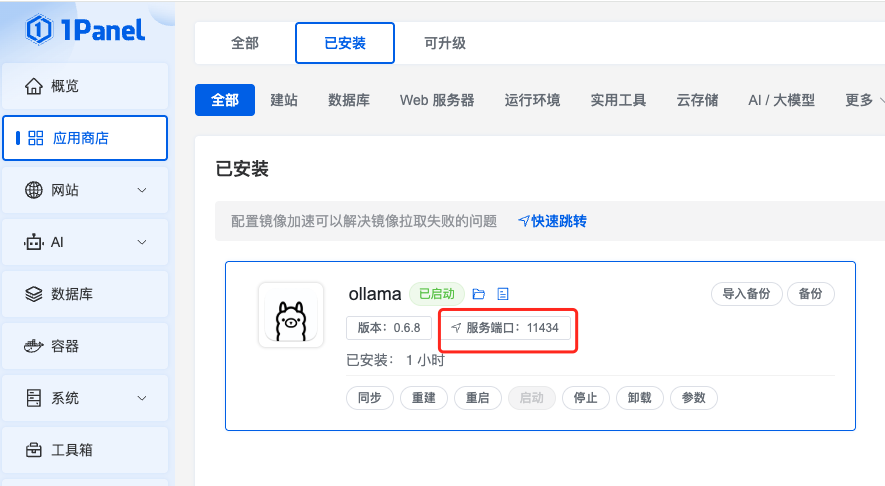
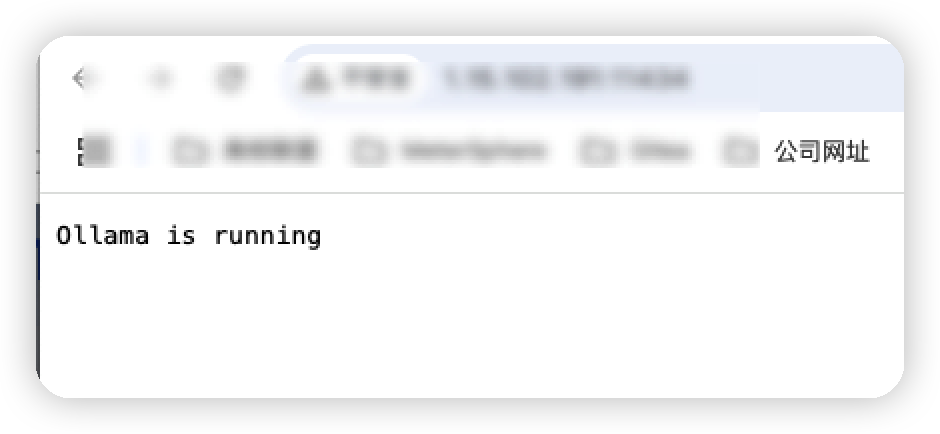
安装完成后,点击服务端口访问Ollama
如下图则代表安装成功:
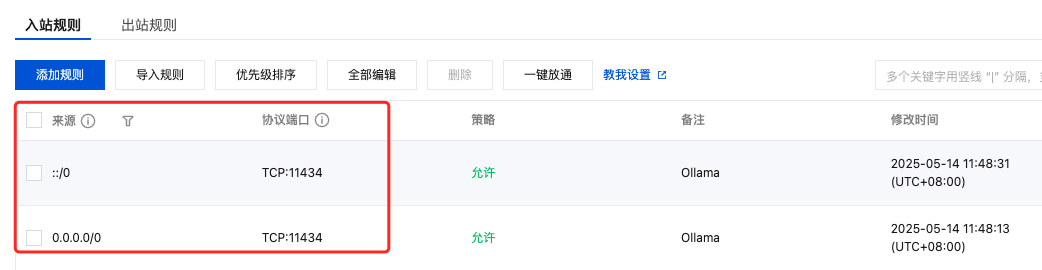
⚠️其中如果无法访问则记得开通安全则规则,添加11434端口能被访问,具体添加内容如下图所示:
步骤3、通过1Panel安装基于Ollama玩哼Qwen3模型安装:
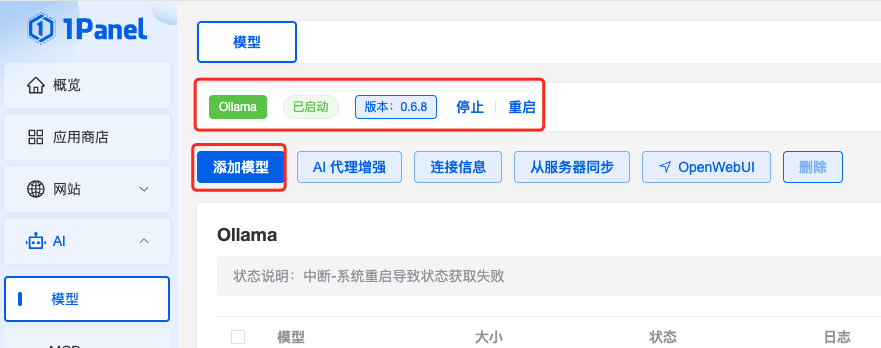
进入1Panel的AI管理中的模型管理,点击【添加模型】,需要确保 Ollama 已经安装完成,状态为已启动。
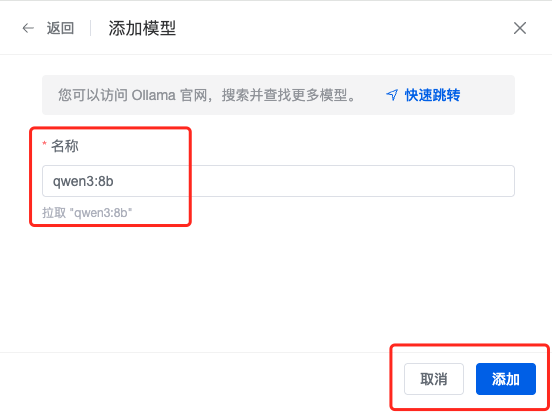
点击添加模型后,点击快速跳转进入Ollama官网,找到 Qwen3 模型,根据服务器要求选择需要部署Qwen模型的模型,如qwen3:0.6b,或 qwen3:8b,需要结合自己部署Ollama的服务器的资源情况以及自己的模型使用情况选择本次实操我选择了0.6b和8b,部署到了8c16G的Centos服务器上。
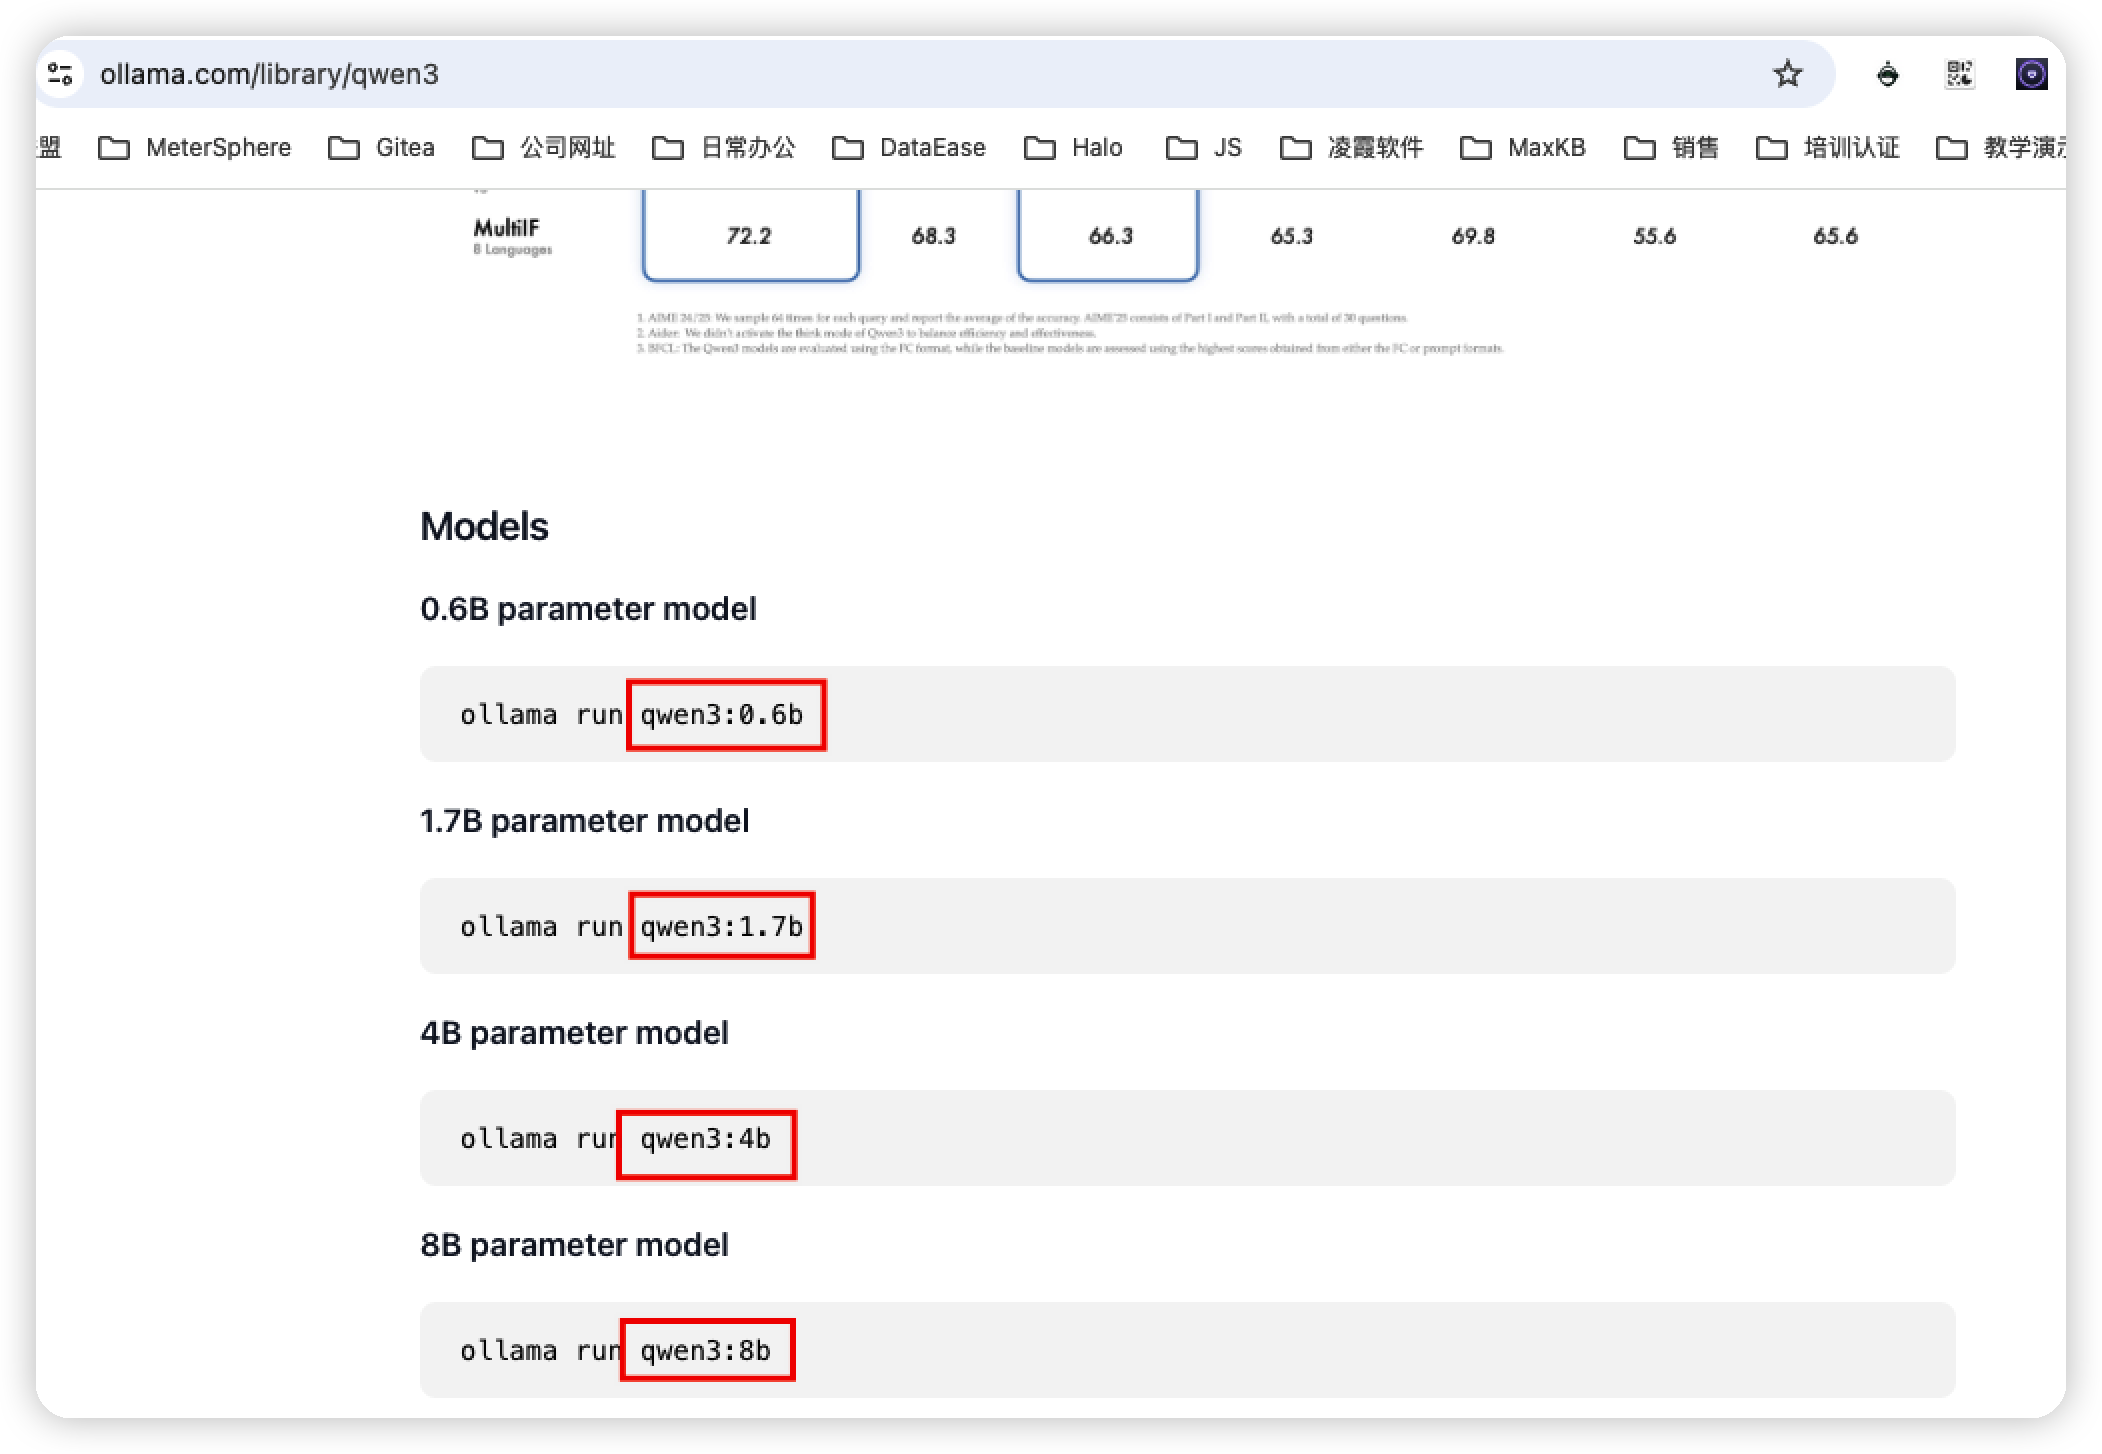
选好模型复制参数,然后在1Panel页面中添加模型名称,点击添加,1Panel开始自行拉取qwen3:8b模型。
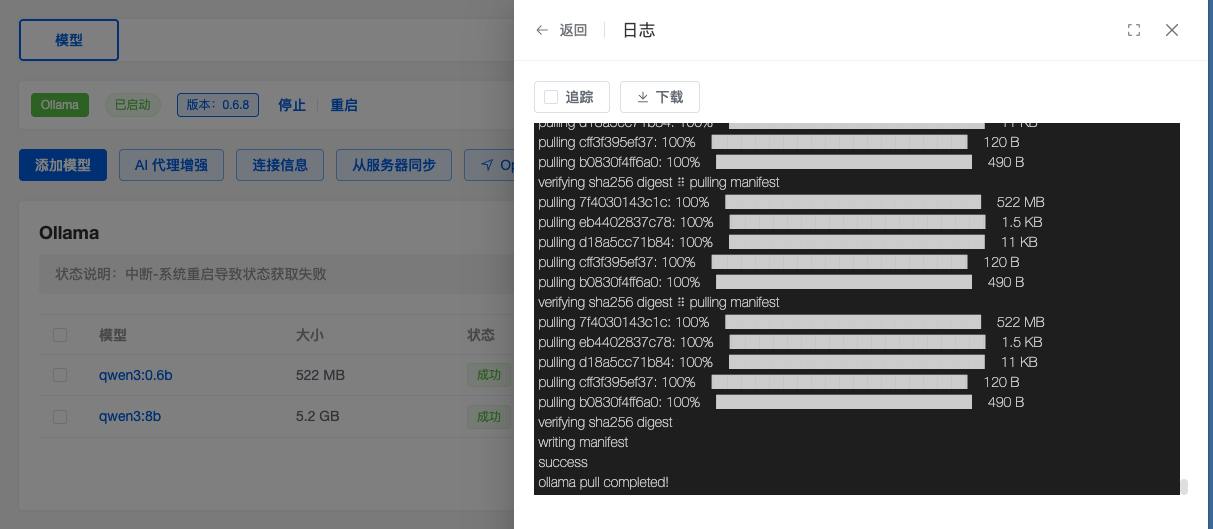
可以实时跟踪拉去进度,经过测试0.6b的拉取时间大概在1-2分钟,8b拉取时间大概在5-10分钟。可以通过日志页面实时查看模型拉取进度。
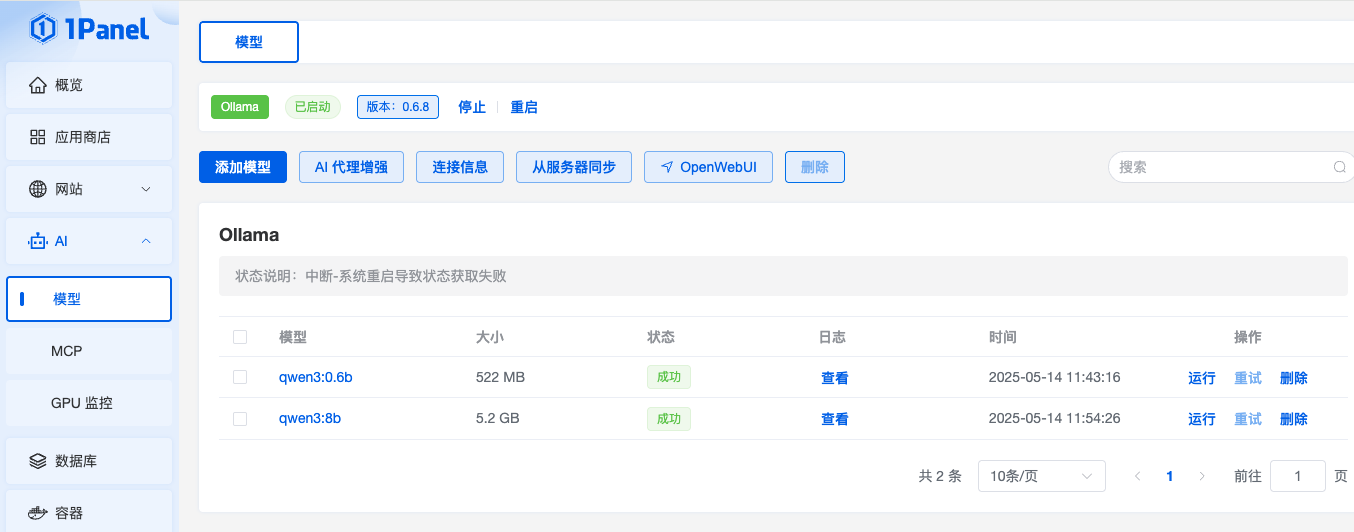
拉取完成后最终模型状态展示为成功即可,如下图所示:
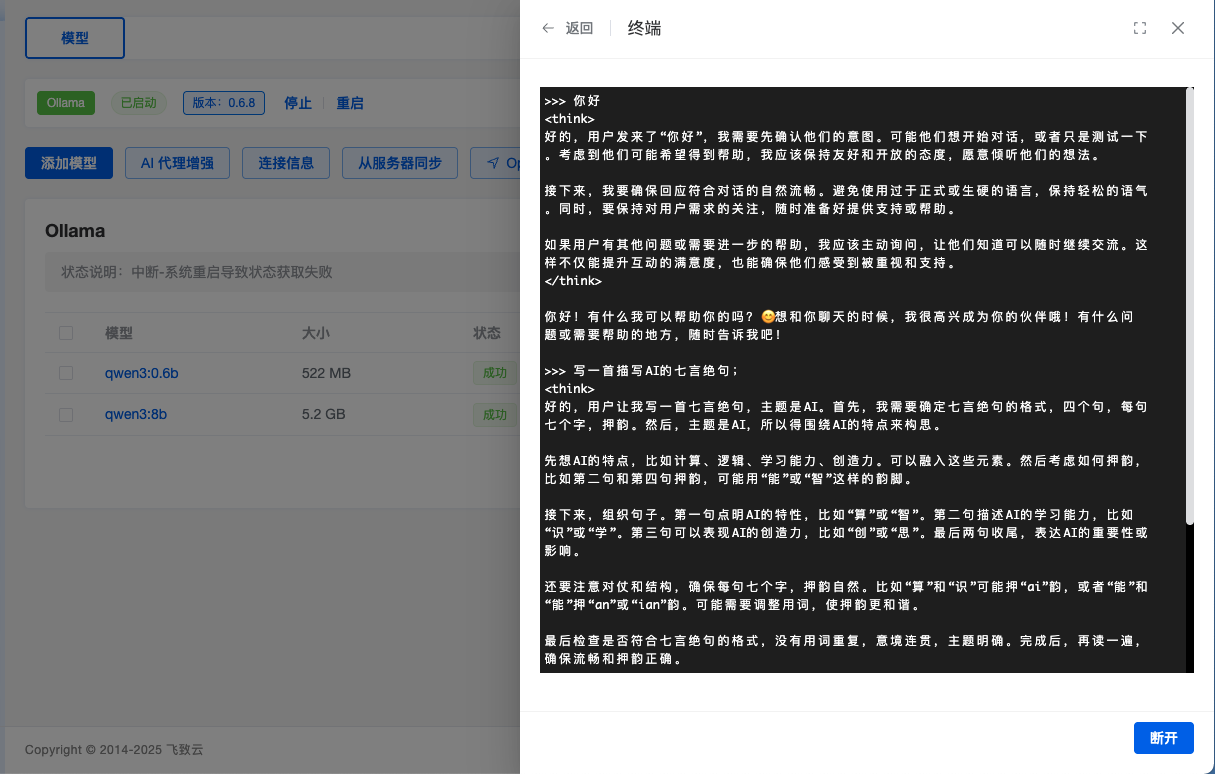
点击运行输入相关内容可以和Qwen3进行对话:
步骤4、通过1Panel安装MaxKB:
此处参见MaxKB官方安装文章安装即可,同上述的Ollama方式,不做赘述。
步骤5、基于 MaxKB 添加 Qwen 模型。
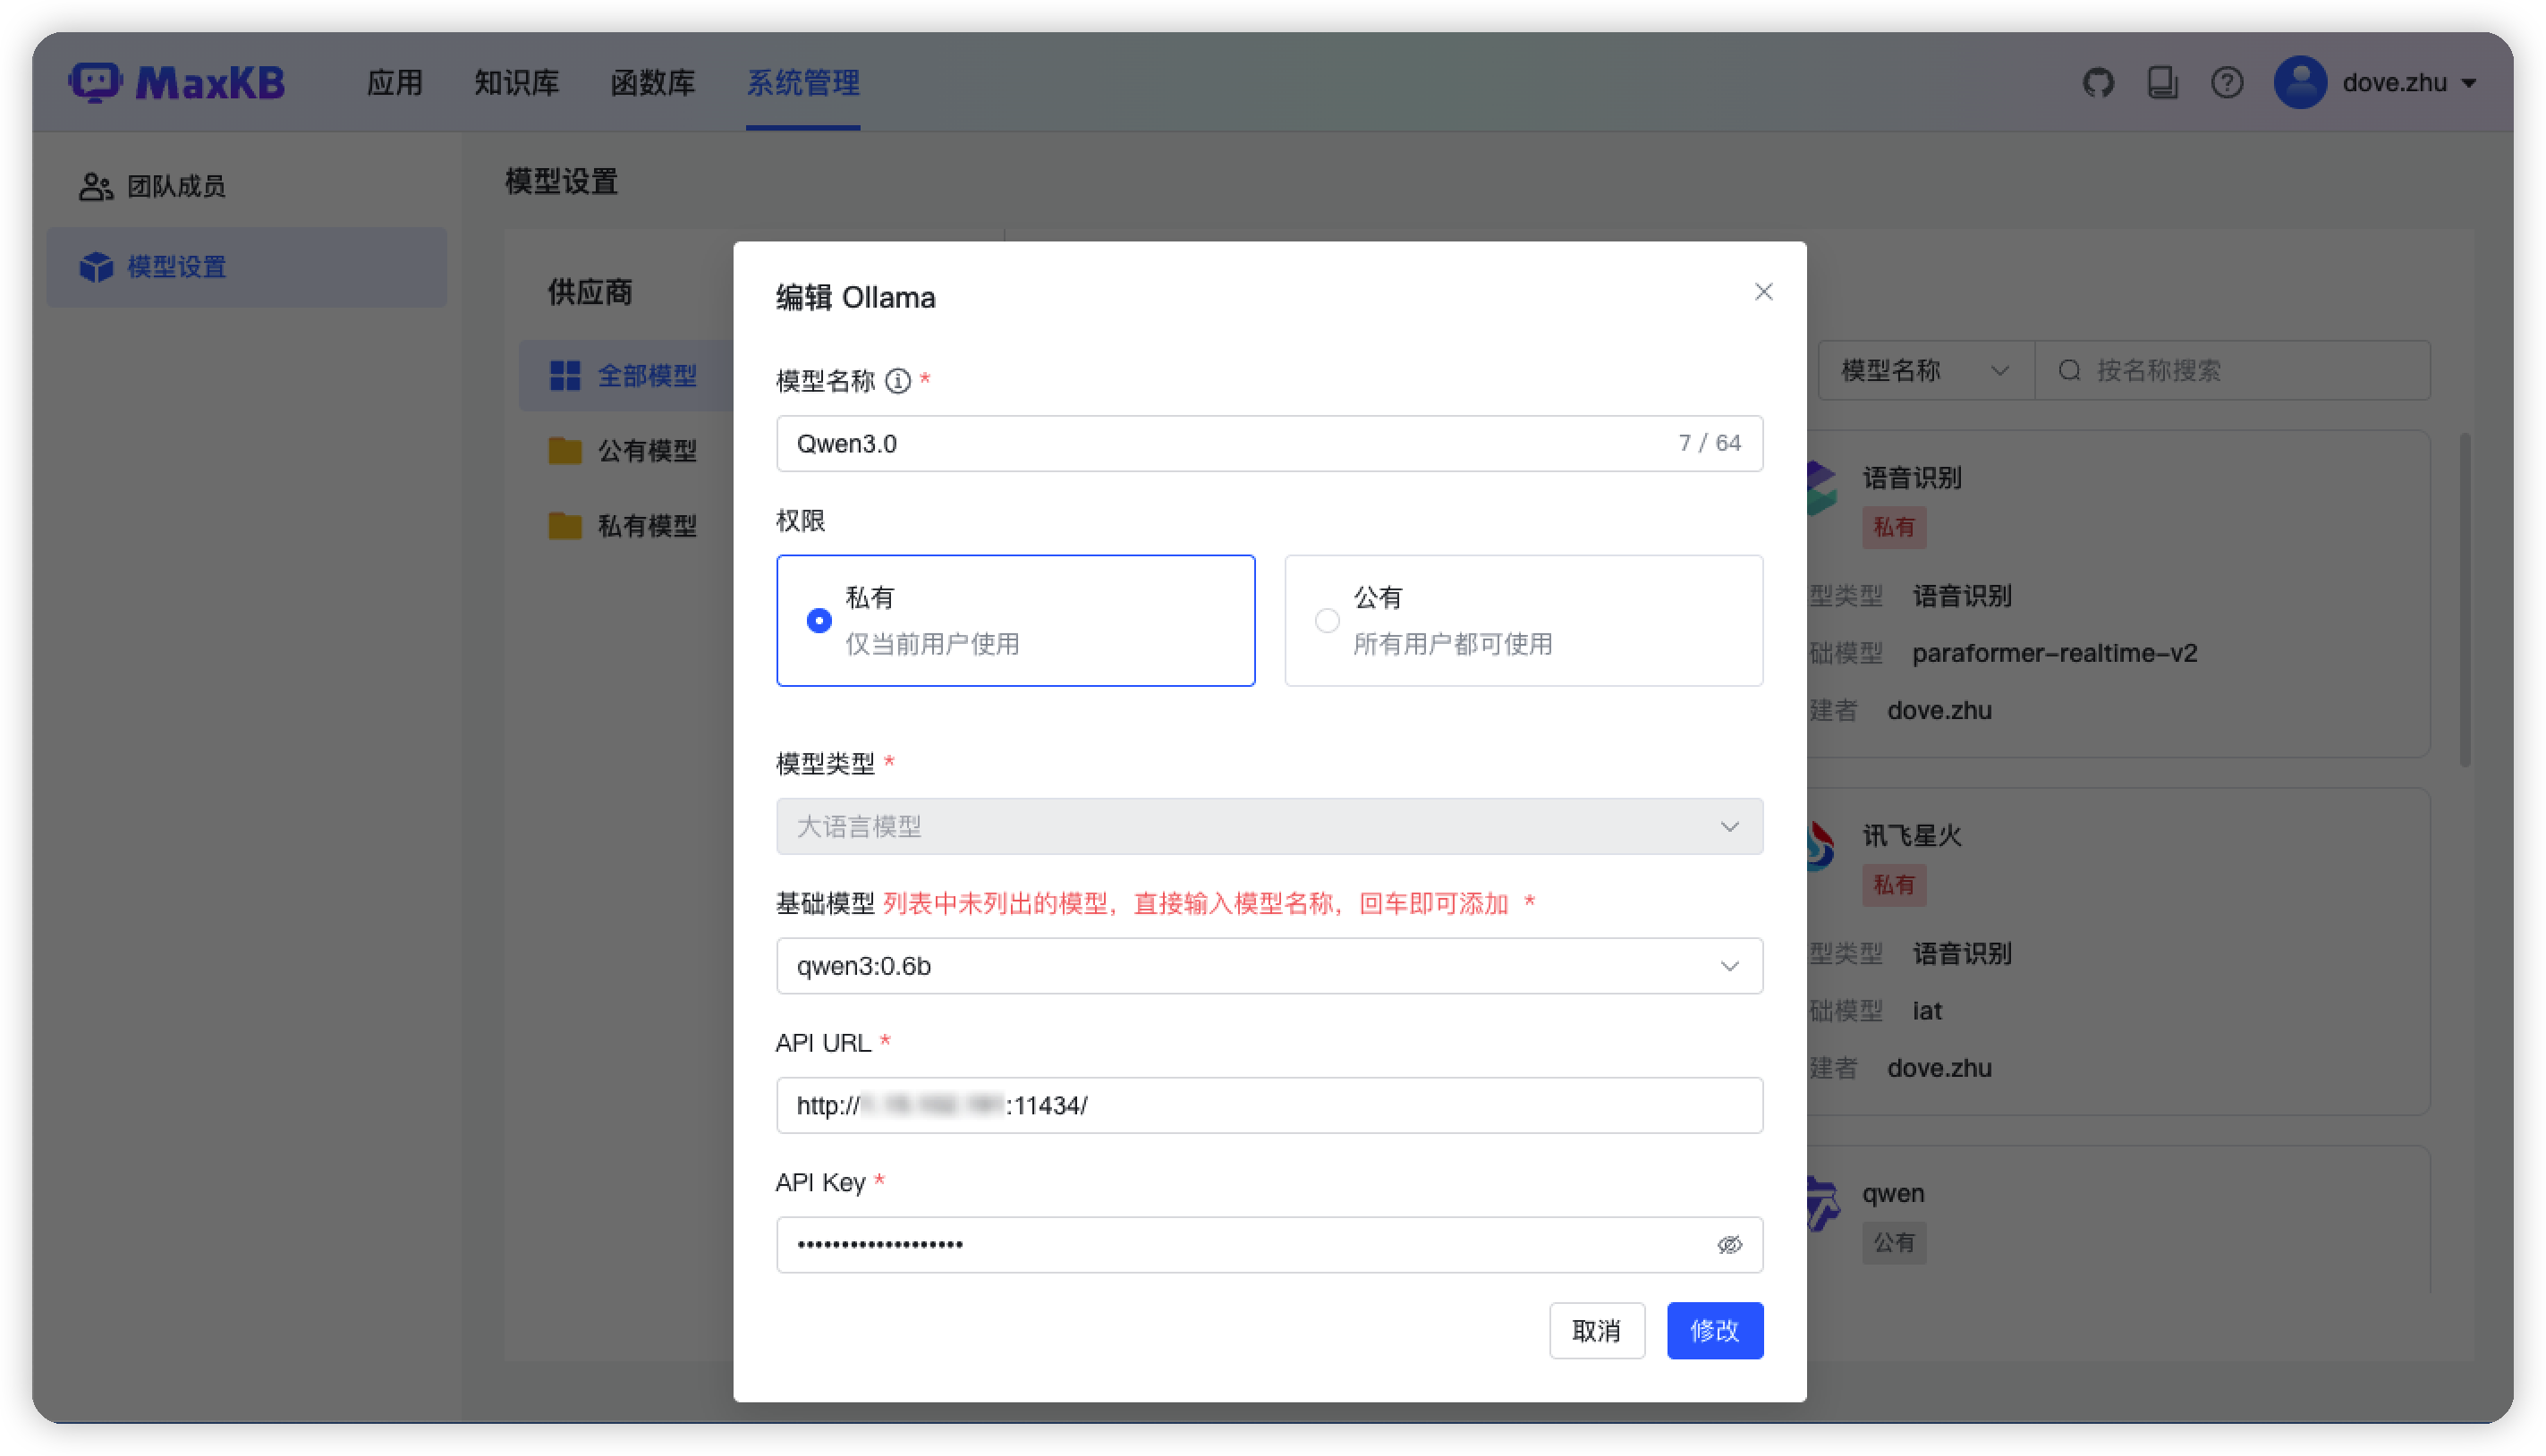
进入系统管理中的模型设置参照如下图所示进行模型配置,其中基础模型输入qwen3:0.6b,或 qwen3:8b,API URL输入Ollama的地址即可,API key输入任意字符串即可,点击保存,则完成模型对接。
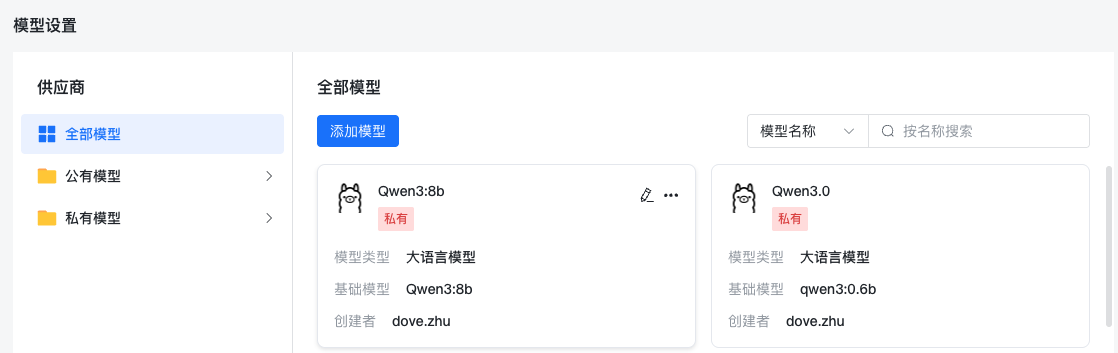
本次实操添加了0.6b和8b的模型,如下图所示,代表模型添加成功。
步骤6、基于 MaxKB 结合 Qwen3模型搭建AI小助手实现问答,就可以快速体验 Qwen 最新的大语言模型啦。