spark-local模式

一、首先打开我们的虚拟机

二、通过finalshell连接虚拟机,连接成功后打开/opt/software,将我们的压缩文件拉到这个目录下

三、通过tar -zxvf spark-3.3.1-bin-hadoop3.tgz -C /opt/module/这个命令将spark安装文件到/opt/module下。

四、重命名

通过mv spark-3.3.1-bin-hadoop3 spark-local这个命令将解压后的文件夹改成spark-local(重命名是为了后续我们还会使用其他的配置方式,所以这里先重命名一次。

五、配置环境变量

1.打开目录/etc/profile.d/my_env.sh,在最后一行输入

#配置spark 环境变量

export SPARK_HOME=/opt/module/spark-local

export PATH=PATH:SPARK_HOME/bin:$SPARK_HOME/sbin

2.然后保存,使用source /etc/profile这个命令让环境变量生效。

3.在控制台输入

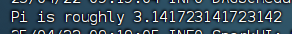
spark-submit --class org.apache.spark.examples.SparkPi --master local2 /opt/module/spark-local/examples/jars/spark-examples_2.12-3.1.1.jar 10

4.然后我们就会得人到下面这个结果
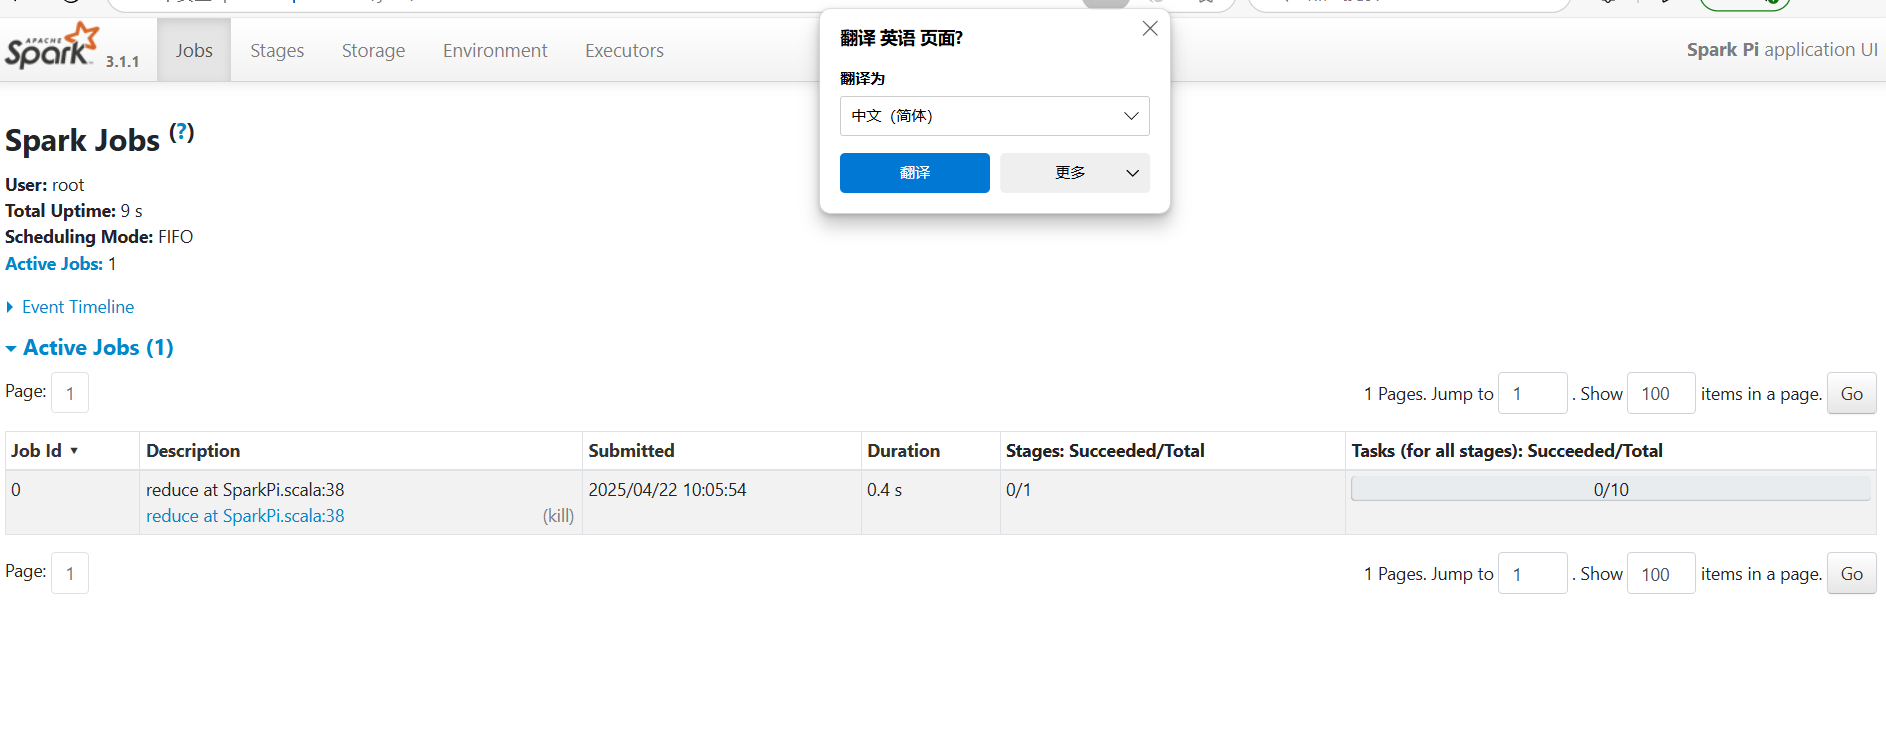
六、查看运行结果详情
相关推荐
TDengine (老段)21 分钟前
TDengine IDMP 十大实用功能(9)
大数据·数据库·人工智能·物联网·时序数据库·tdengine·idmp
播播资源1 小时前
同账户实测 11 个多模态模型:图像 0.03 元起、竖屏视频 8 元一条,最贵和最便宜差 267 倍
大数据·人工智能·深度学习
全栈陈序员4 小时前
Git】从入门到精通(八)—— git log:查看提交历史
大数据·git·elasticsearch
演艺大赏4 小时前
NiFi 从 3 台扩到 25 台:三轮扩容后我才明白,证书必须全量重签、安装包绝对不能拷
大数据
做科研的周师兄4 小时前
【R语言实战】MixSIAR 氢氧同位素水源解析全流程:从混合空间校验到贝叶斯 MCMC 收敛诊断(后附完整代码)
java·大数据·开发语言
isfox6 小时前
MapReduce 数据清洗:脏数据进来,干净数据出去,连 Reduce 都省了
大数据
Francek Chen8 小时前
【大数据处理与分析】数据仓库Hive:09 Hive 编程实践
大数据·数据仓库·hive·hadoop·sql
其实防守也摸鱼21 小时前
个人学习 Pwn 思路:从基础到漏洞利用的进阶路径
大数据·前端·人工智能·chrome·算法·安全·网络安全
美林数据Tempodata21 小时前
高职大数据技术专业升级的六个落地样本:从产业链需求库到实训室数据链路
大数据·人工智能·数字化转型·产教融合·ai教育
跨境卫士苏苏1 天前
TikTokShop关联账户认定指引更新跨境代运营团队需要注意哪些管理责任
大数据·人工智能·市场营销·跨境电商·营销策略