在边缘计算场景中,AI模型的落地面临两大挑战:资源受限环境下的高效运行与跨平台部署的复杂性 。传统重型算法在边缘设备上常因算力不足、功耗过高而难以实用化,而不同硬件平台间的代码迁移又需耗费大量适配成本。如何实现算法轻量化封装与跨平台快速迁移 ,成为行业亟需解决的技术命题。
轻量化封装:从"大模型"到"小智能"
轻量化技术的核心在于通过模型压缩、量化、剪枝等手段,在保证精度的前提下大幅降低模型复杂度。例如:
- 量化压缩:将FP32模型转换为INT8,体积缩小4倍,推理速度提升3倍以上;
- 算子融合:合并冗余计算层,减少内存占用与延迟;
- 自适应蒸馏:通过知识蒸馏技术,将大模型能力迁移至轻量级网络中。
这些技术使原本需云端GPU支持的算法,可在边缘端仅凭几瓦功耗的AI盒子中实时运行,满足工业质检、智慧交通等高并发场景需求。
跨平台迁移:打破"硬件孤岛"困局
边缘设备硬件生态碎片化(如ARM、x86、NPU等)导致"一次开发,多端适配"成为痛点。跨平台迁移能力的关键在于:
- 框架兼容性:支持TensorFlow、PyTorch等主流框架的模型直接导入,避免重复开发;
- 自动化转换:通过中间表示层(如ONNX)实现模型结构统一解析,自动适配不同计算单元;
- 动态调优:根据目标硬件特性(如算力、内存),自动优化算子调度策略,释放峰值性能。
这种"一次训练,多端部署"的模式,可缩短项目落地周期达60%以上。
DA160S:轻量化与迁移能力的工程实践
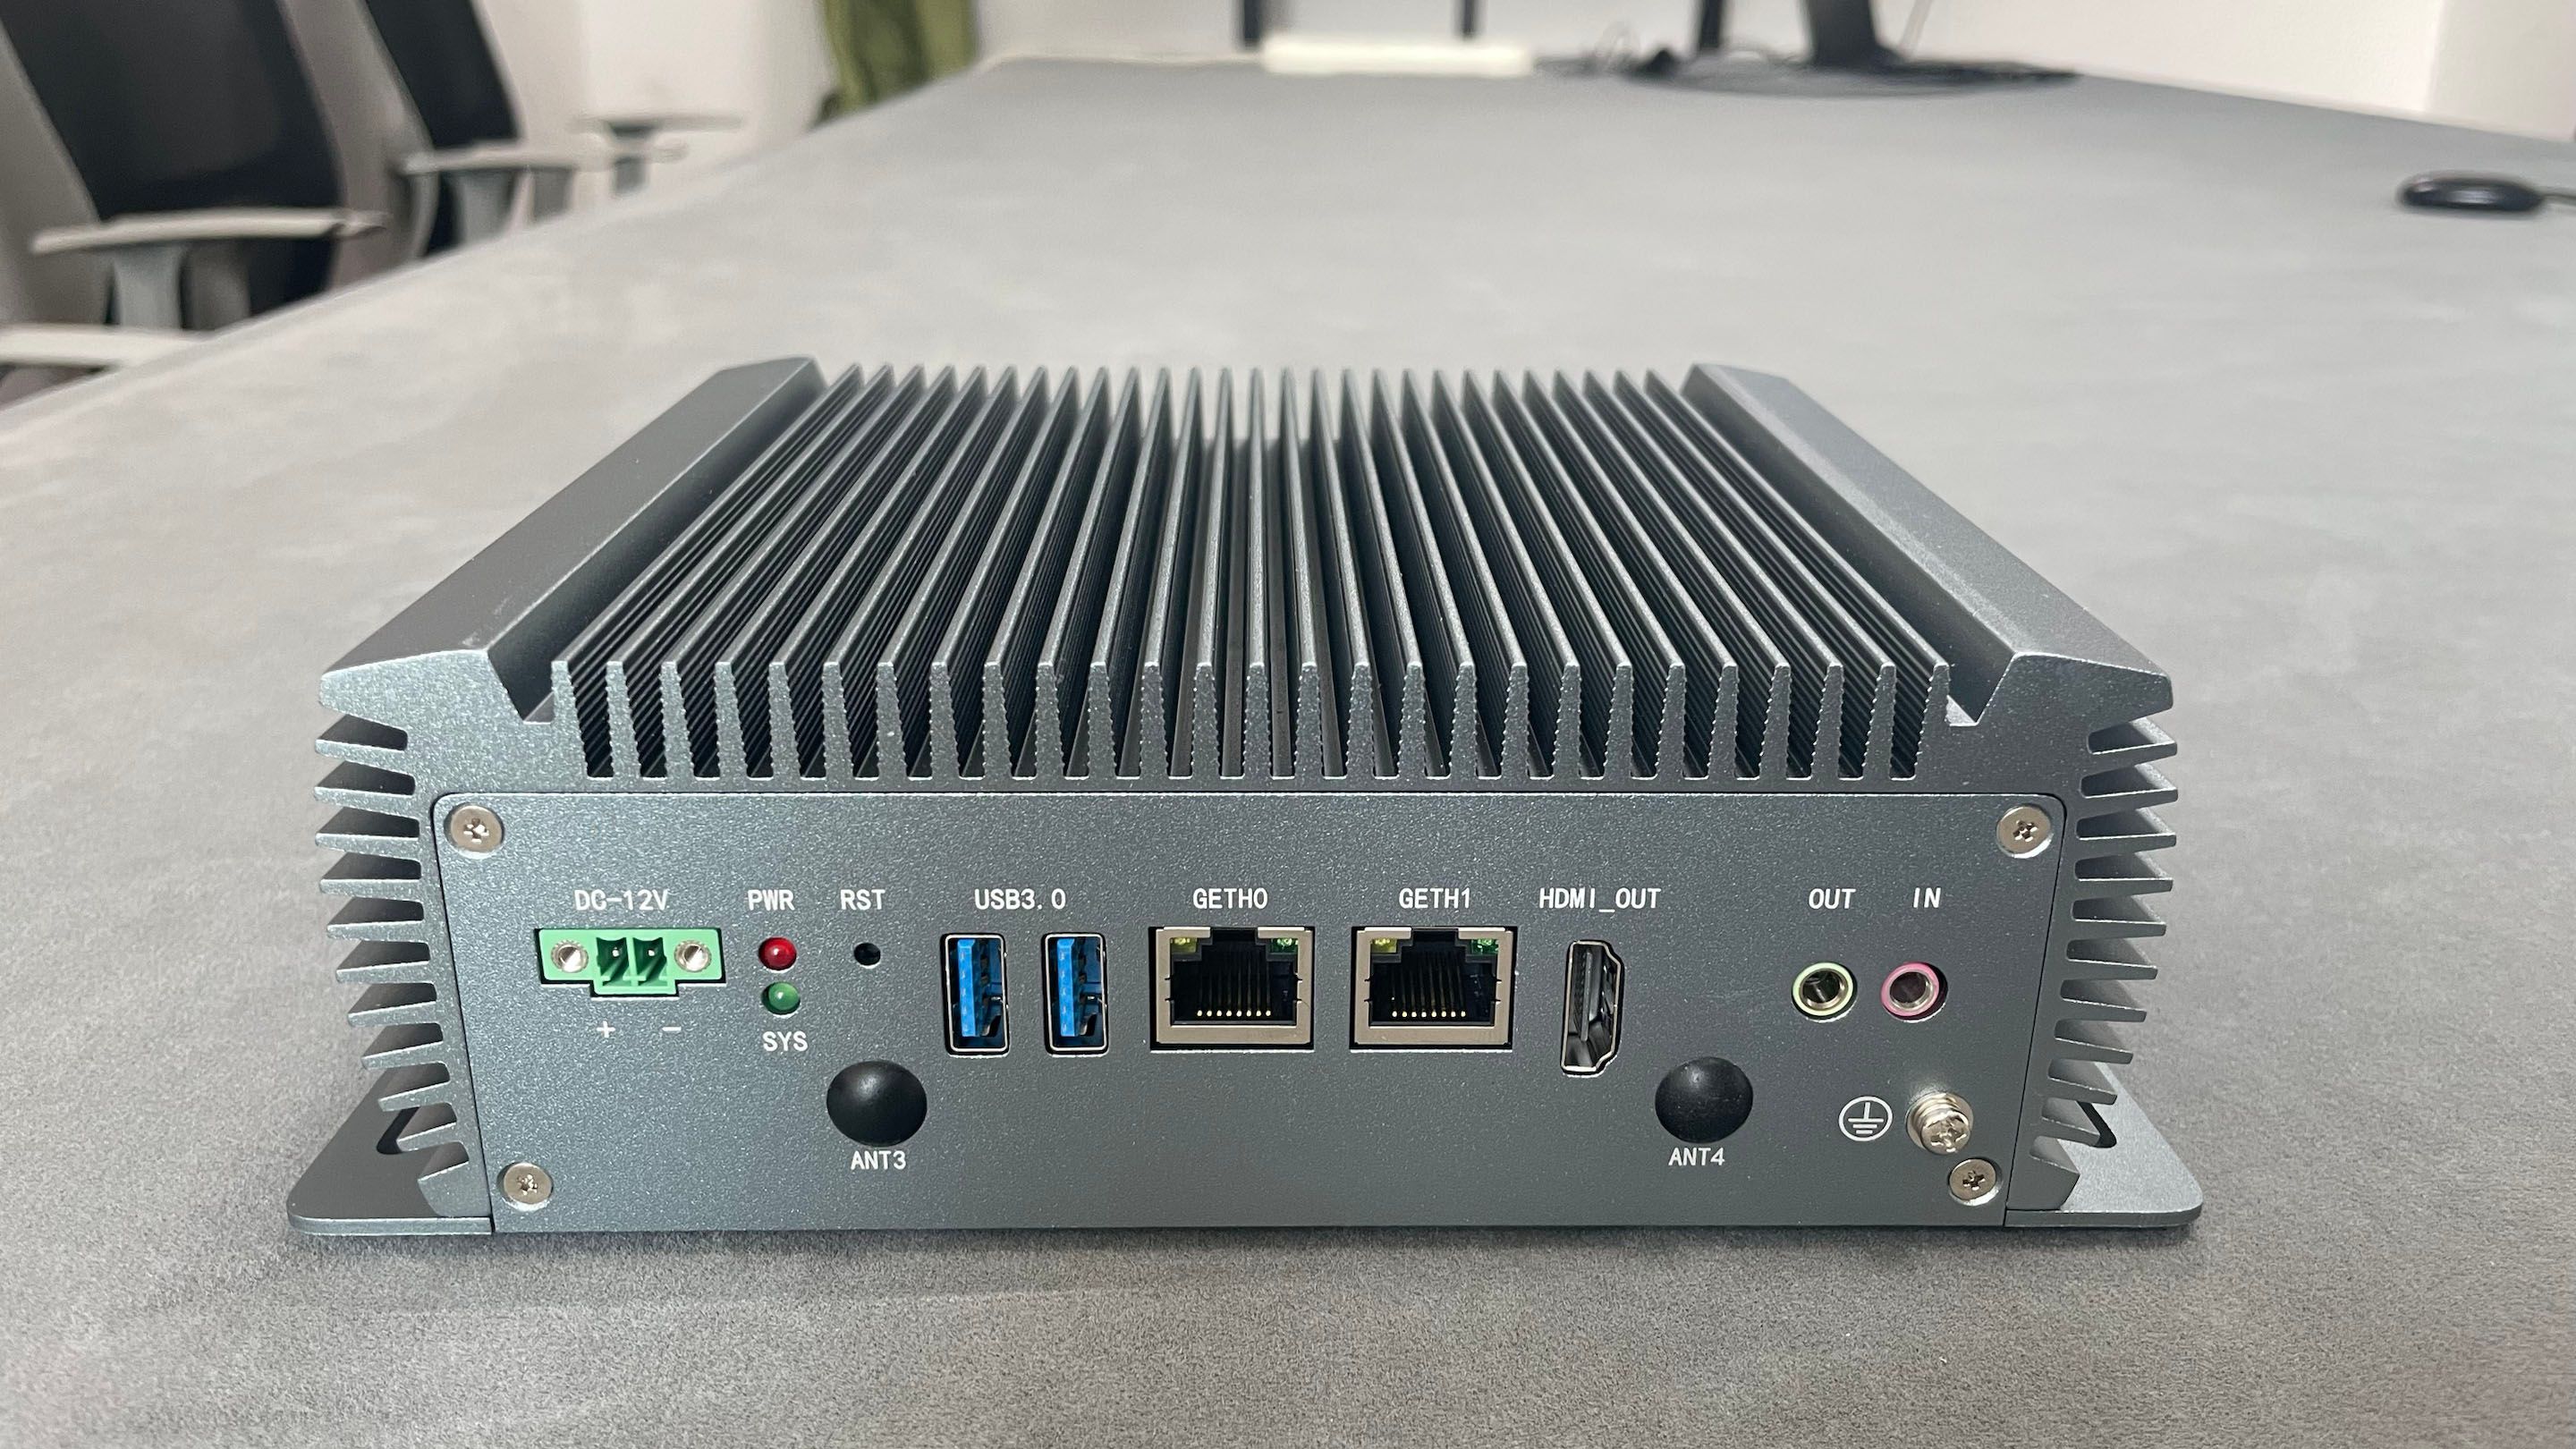
针对上述挑战,万物公司推出的AI边缘计算盒子DA160S,凭借SOPHON SDK全栈工具链,为开发者提供从训练到部署的一站式解决方案:
- 全流程支持:覆盖模型训练、量化压缩、异构加速,支持YOLOv5、ResNet等模型INT8量化后精度损失<1%;
- 无缝迁移:兼容TensorFlow、PyTorch等框架,通过自动化转换工具实现跨平台零代码修改;
- 高效部署:内置TPU算力高达16 TOPS@INT8,可并行处理多路视频流,毫秒级响应工业缺陷检测、人员行为分析等任务。
典型案例:某智能工厂采用DA160S部署轻量化质检模型,3天内完成从X86服务器至边缘设备的迁移,漏检率降至0.2%,功耗仅为15W。
为何选择我们的AI边缘计算盒子?
- 开箱即用:预置模型优化工具与示例代码,降低算法工程化门槛;
- 灵活扩展:支持Docker容器化部署,快速集成第三方算法;
- 生态开放:提供API与SDK,无缝对接主流物联网平台与业务系统。
在智能制造、智慧零售等领域,DA160S正帮助数百家企业实现算法敏捷落地,让边缘设备真正成为"会思考的智能终端"。
欢迎立即咨询,获取免费模型迁移评估服务,开启您的边缘智能升级!