看了几篇专业大媒体的故障分析,又臭又长,连最基本的逻辑都讲不清。
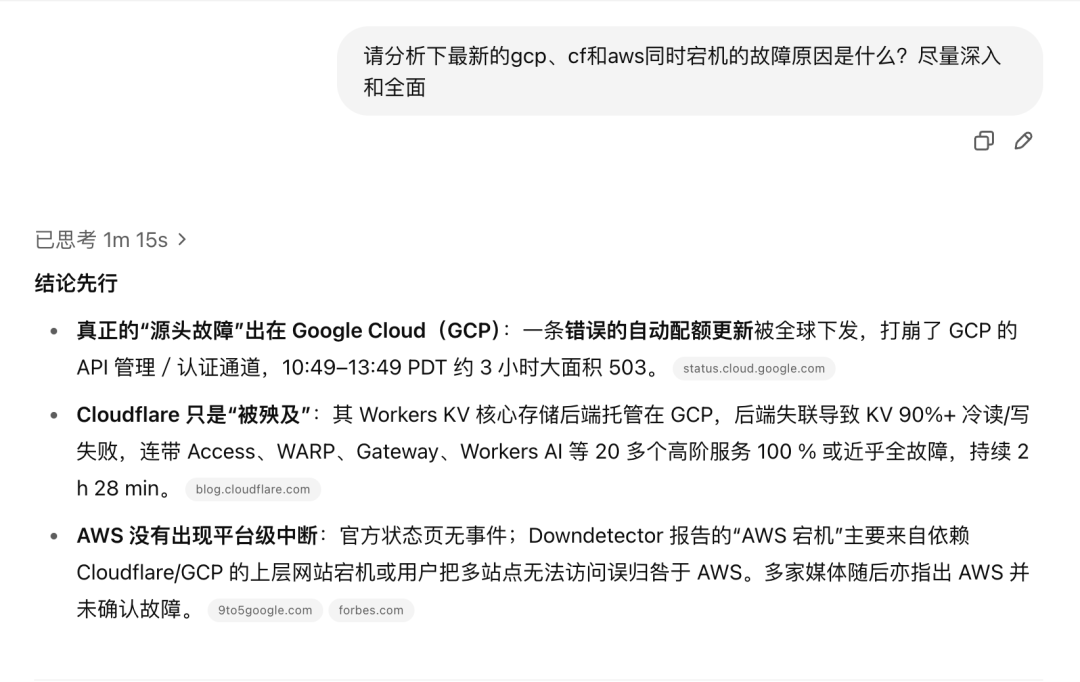
其实如果你不追热点,稍等个半天一天的,可以直接问下ChatGPT O3,精炼的分析就有了。
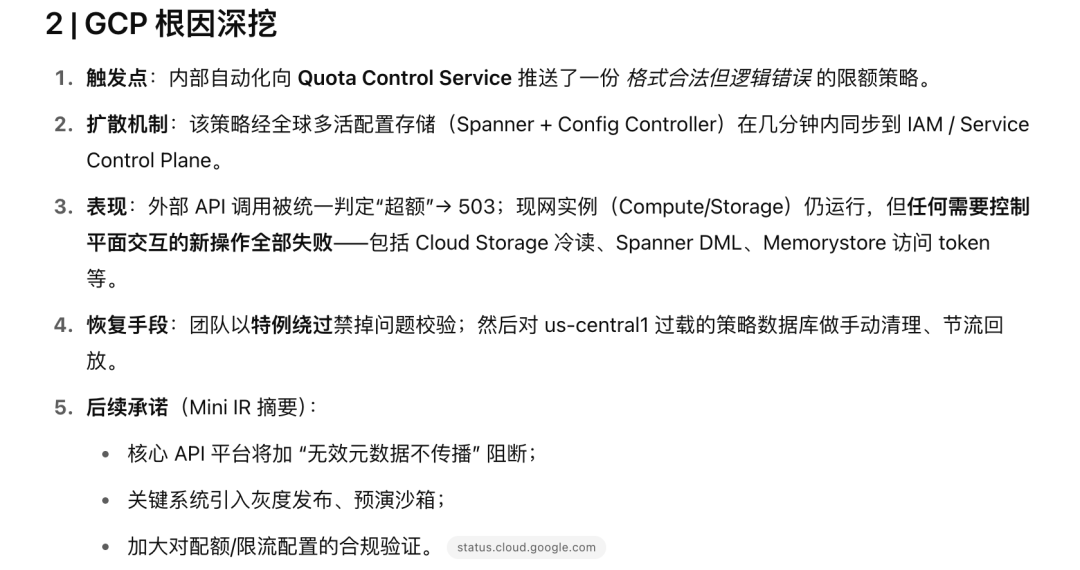
如果想看细节,就可以结合他后面给出来的官方status或blog页面去看详细内容,然后再加上自己的分析,或者你让O3继续深入帮你分析技术细节就好了。
比起那些所谓的专业媒体专业太多了,也更权威,更客观,这样就不会被带节奏。
其实这次故障最基本的逻辑就是:
-
GCP挂了
-
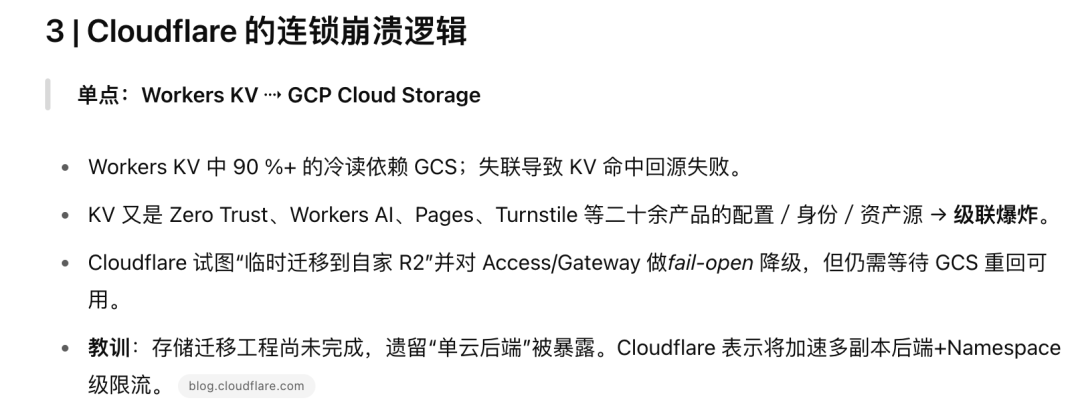
CF的CDN依赖GCP某个KV服务,结果也挂了
-
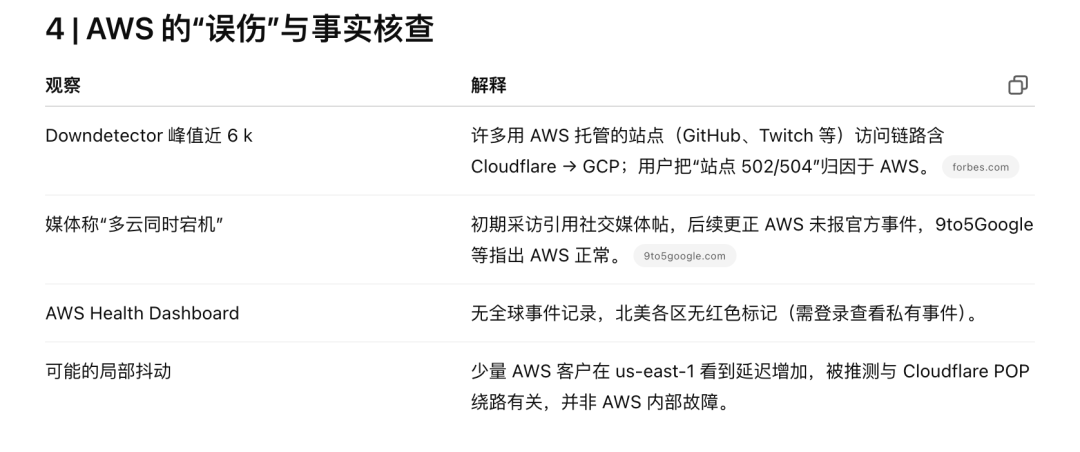
又因为很多互联网业务托管在AWS,用户访问托管在AWS的业务就会出现5xx,结果很多人就认为是AWS挂了。
-
其实AWS是躺枪。
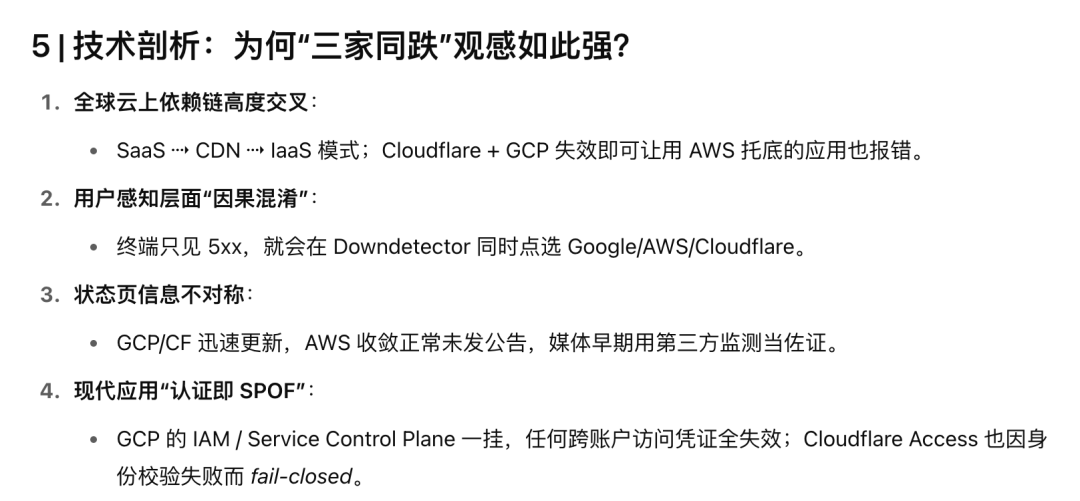
这里其实暴露出来的一个很无奈的问题,或者我们更应该关注的点应该是:
多云的耦合以及相互依赖问题,这就好比基础服务与基础服务的相互依赖。
一家基础服务提供商,为了想让自己更稳定,就去依赖了另外一家基础服务提供商的服务(它做得可能更好),更可怕的是,相互依赖,甚至是多方相互依赖。
比如在国内,有些云厂商为了利润,可能会因为另一家的服务更便宜,比如CDN,就会把某些客户的流量调度到其它厂家去,从中赚取差价。
从商业角度无可厚非,对于某些价格敏感的客户来说,也是满足其需求的一种模式。
但对于上层业务来说,完全就是黑盒,即使多云了,依然逃不开基础服务的单点依赖,最后还是依赖到某一家上面。
但往往有时候,稳定性在利益面前,是需要一些让步的。
这个问题该怎么解?
可以问问O3。
文中几个链接我附一下,有兴趣大家可以自己看:
https://status.cloud.google.com/incidents/ow5i3PPK96RduMcb1SsW
https://blog.cloudflare.com/cloudflare-service-outage-june-12-2025/