count(*)的实现方式
在不同的MySQL引擎中,count(*)有不同的实现方式:
-
MyISAM引擎把一个表的总行数存在磁盘上,执行
count(*)时能直接返回总行数,效率很高; -
InnoDB引擎需要把数据一行一行从引擎里读出来,然后累积计数。
需要说明,本文讨论没有过滤条件的count(*),如果加了where条件,MyISAM也没有那么快。
InnoDB为什么不和MyISAM一样设计,把行数给存起来呢?
这是因为即使是在同一刻的多个查询,由于MVCC的原因,返回多少行也不是确定的。假设现在表t中有10000条记录,设计了三个用户并行的会话:
-
会话A先启动事务并查询一次表的总行数;
-
会话B启动事务,插入一行记录后,查询表的总行数;
-
会话C先启动一个单独的语句,插入一行记录后,查询表的总行数。
假设该过程的时间顺序如下:
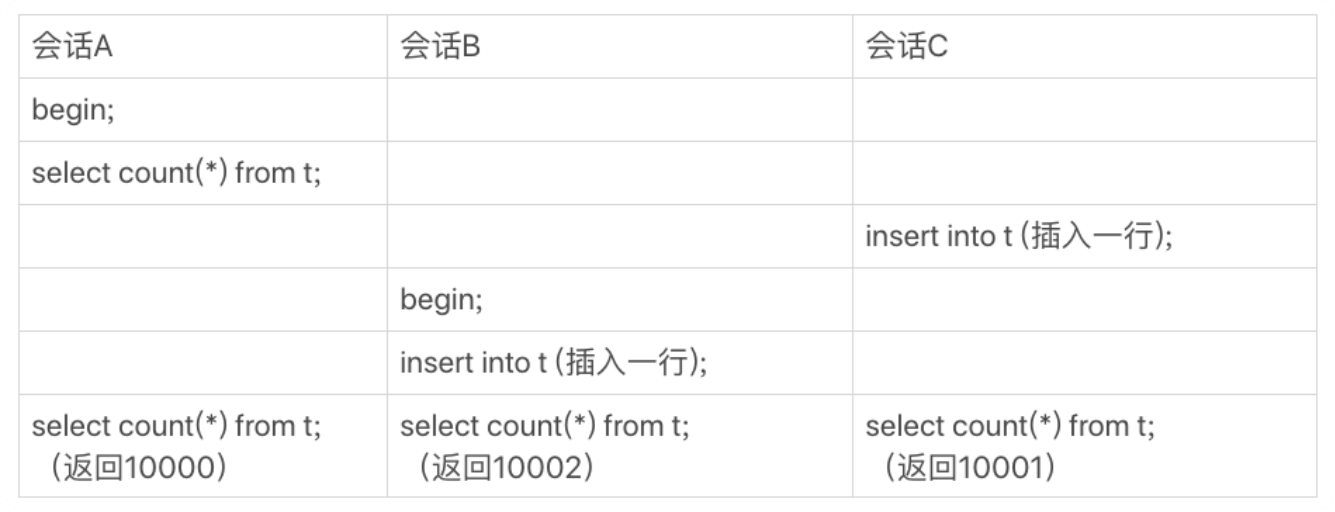
可以看到,三个会话在同一时刻查询总行数,得到的结果却不同。至于为什么查询结果如上,可以从MySQL 08那篇文章得到答案。
这是由于InnoDB的默认隔离级别是可重复读,在代码上通过MVCC实现。由于每一行记录都需要判断自己是否对这个会话可见,因此对于count(*)请求来说,InnoDB需要把数据一行一行读出依次进行判断,只有可见的行才能计入总行数。
不过MySQL还是对count(*)做了一定的优化。由于普通索引树比主键索引树小很多,而count(*)操作遍历哪个索引树得到的结果在逻辑上都相同,因此优化器会找到最小的索引树来遍历。在保证逻辑正确的前提下,尽量减少扫描的数据量,是数据库系统设计的通用法则之一。
有个命令叫show table status,其输出结果里有一个TABLE_ROWS用来显示这个表当前有多少行。这个命令执行速度较快,那能否用它加速计算行数呢?
是不行的,TABLE_ROWS的值是从MySQL 10中提到的采样值估算而得的,因此也非常不准确。
那么如果需要经常用到记录总数的值,即需要加快count(*),就需要自己计数,基本思路是找一个地方,把记录表的行数存起来。
用缓存系统保存计数
对于更新频繁的库来说,可能会想到用缓存系统来支持。比如用Redis保存总行数,每插入一行Redis的计数就加1,每删除一行Redis计数就减1。
这种设计速度确实很快,但缓存系统可能丢失更新。若想找地方将值持久化存储,仍然可能丢失更新。比如刚在数据表中插入一行,Redis中保存的值也加了1,然后Redis异常重启,而此时加1还未持久化。
当然,异常重启是有解的,可以在异常重启后再执行一次count(*)获取真实的最新值,再写回Redis。异常重启毕竟不是经常出现的情况,这样偶尔的情况是可以接受的。
不过,即使Redis正常工作,这个值依旧是逻辑上不精确的。
设想有这样一个页面,要显示操作记录的总数,同时还要显示最近操作的100条记录,那么就需要先到Redis里取出计数,再到数据表里取记录。
不精确的定义如下:
-
查到的100条记录里有最新的插入记录,但Redis里计数还未加1;
-
或是查到的100条记录里没有最新的插入记录,但Redis计数已经加1。
来看两个例子:
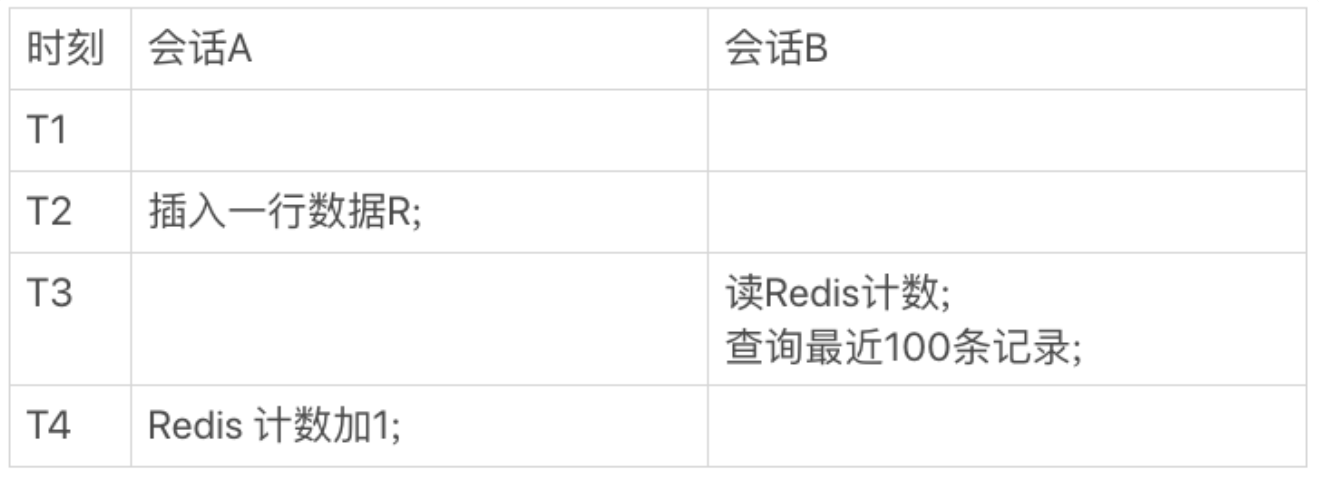
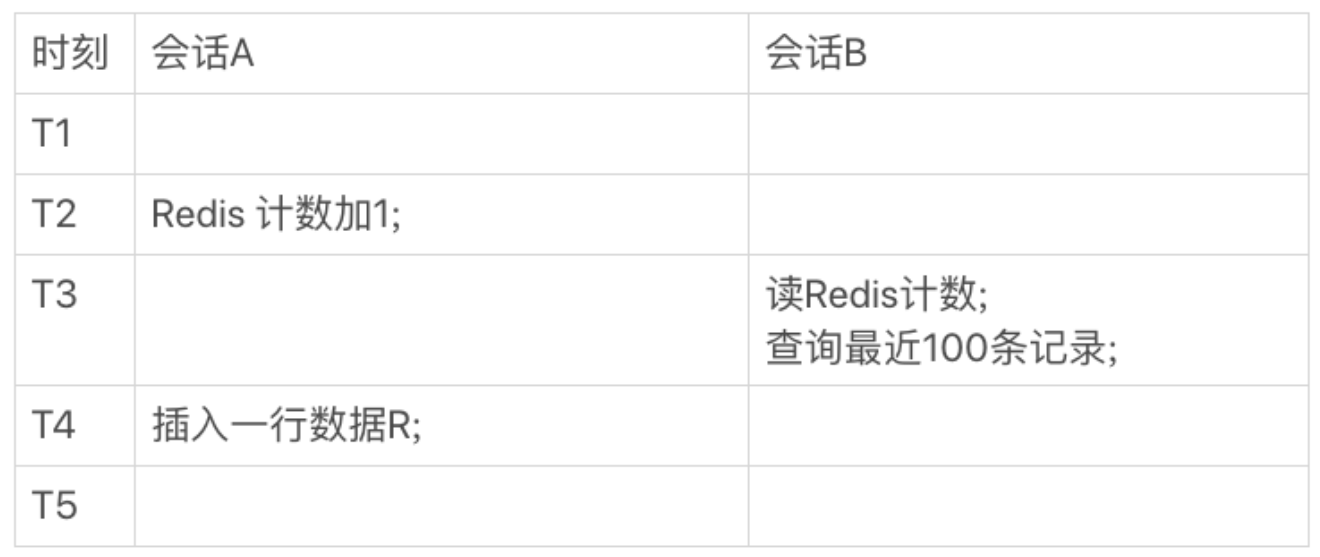
上面的两个例子,就对应了不精确的两种情况。
由于并发系统里无法精确控制不同线程的执行时刻,可能出现上述两种情况,因此说即使Redis正常工作,计数值还是逻辑上不精确的。
在数据库保存计数
既然不能用缓存系统保存,如果把计数直接放到数据库里单独的一张计数表C中会怎么样?
首先,解决了崩溃丢失的问题,因为InnoDB支持崩溃恢复。
其次,由于事务的特性,也能解决不精确的问题。
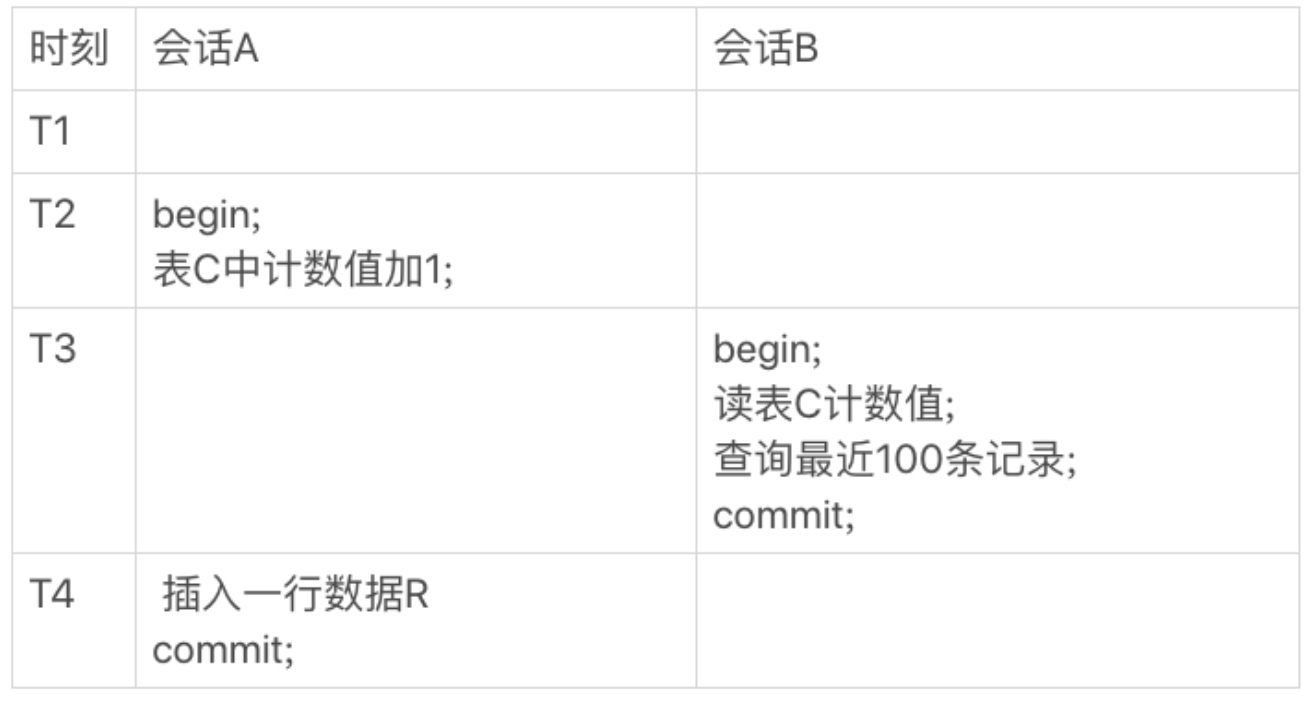
在上图中,会话B在T3执行读操作,但此时更新事务还未提交,因此计数值+1这个操作对会话B不可见,从而会话B查计数值和"最近100条记录"看到的结果在逻辑上一致。
不同的count用法
最后说一下count()括号内填不同内容的几种用法。
count()是一个聚合函数,对于返回的结果集,一行一行判断,如果count()函数参数对应的值不为NULL,累计值就加1,否则不加,最后返回累计值。
因此,count(*)、count(主键id)、count(1)都表示返回满足条件的结果集的总行数,而count(字段)表示返回满足条件的数据行中,"字段"这一列的值不为NULL的总个数。
而分析性能差别时,可以记住以下几个原则:
-
Server层要什么就给什么;
-
InnoDB只给必要的值;
-
优化器只优化了
count(*)的语义为"取行数",其他优化并没有做。
如何理解呢?具体看看:
-
对于
count(主键id),InnoDB会遍历整张表,取出每一行的id,返回给Server层。Server层拿到id,判断不可能为空,按行累加; -
对于
count(1),InnoDB会遍历整张表但不取值,Server层对返回的每一行,放一个数字"1"进去并判断不可能为空,按行累加; -
对于
count(字段):-
如果字段定义为not null,Server层能直接判断不能为null,按行累加;
-
如果字段定义允许null,Server层需要把值取出来再判断一下,不是null才累加;
-
-
对于
count(*),进行了优化,InnoDB遍历整张表但不取值,Server会判断肯定不是null,按行累加。
因此,如果按照效率排序,count(字段)<count(主键id)<count(1)≈count(*)。