一、基本名词
-
张量 (Tensor):张量是多维数组的概念,是深度学习中的基本数据结构。它可以是标量(0维)、向量(1维)、矩阵(2维)或者更高维的数据结构。
-
训练模型 (Training a Model):训练模型是指通过使用大量的已标注数据来调整模型的参数,使其能够根据输入数据做出正确的预测。
-
损失函数 (Loss Function):损失函数是用来衡量模型预测结果与真实值之间差距的函数。目标是最小化损失函数,以提高模型的准确度。常见的损失函数有均方误差(MSE)和交叉熵损失(Cross-Entropy Loss)。
-
优化器 (Optimizer):优化器是用来更新模型参数(如权重和偏置)的算法。优化器的作用是通过最小化损失函数来改善模型的预测能力。常见的优化器有随机梯度下降(SGD)、Adam 和 RMSProp。
-
梯度 (Gradient):梯度是损失函数对模型参数的导数,表示损失函数相对于每个参数变化的敏感度。通过计算梯度,可以知道如何调整参数以减少损失。
-
前向传播 (Forward Propagation):前向传播是指将输入数据通过神经网络层层计算,最终得到预测结果的过程。每一层的输出是上一层输入的变换。
-
反向传播 (Backward Propagation):反向传播是训练神经网络时,用于计算梯度并更新参数的过程。它通过链式法则将误差(损失)从输出层传递回输入层,并计算每一层的梯度,从而优化网络参数。
打个比喻:
我(深度学习)参加一场考试,考试的科目是张量(基本数据结构)。我需要通过不断刷题(训练模型)来提高自己,同时在每次做题后,我会记录错误并计算错题(损失函数),然后根据这些错题进行改正(优化器优化)。通过多次测试,我查漏补缺(计算梯度),吸取教训(反向传播),逐渐提高解题能力(前向传播),最终在"正式考试"中取得更好的成绩。
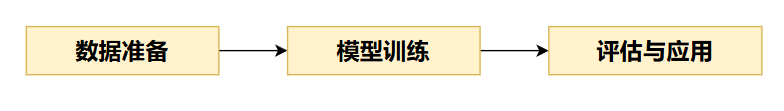
二、深度学习的基本流程
三、Pytorch常见的模型
-
线性回归模型 (Linear Regression):用于回归任务,通过学习输入特征与目标变量之间的线性关系来预测结果。适用于简单的数值预测问题。
-
卷积神经网络 (CNN, Convolutional Neural Network):广泛应用于图像处理任务,如图像分类、目标检测等。通过卷积层自动提取图像特征,具有良好的空间特征学习能力。
-
循环神经网络 (RNN, Recurrent Neural Network):用于处理序列数据(如文本、时间序列等),能通过隐藏状态捕捉数据中的时序信息。特别适用于自然语言处理任务。
-
长短时记忆网络 (LSTM, Long Short-Term Memory):RNN 的一种改进形式,能够更好地解决梯度消失问题,适用于长序列数据处理,比如文本生成、语音识别等。
-
生成对抗网络 (GAN, Generative Adversarial Network):由生成器和判别器组成,生成器负责生成假数据,判别器负责区分真假数据。常用于生成任务,如图像生成、风格迁移等。