LeetCode 140:单词拆分 II
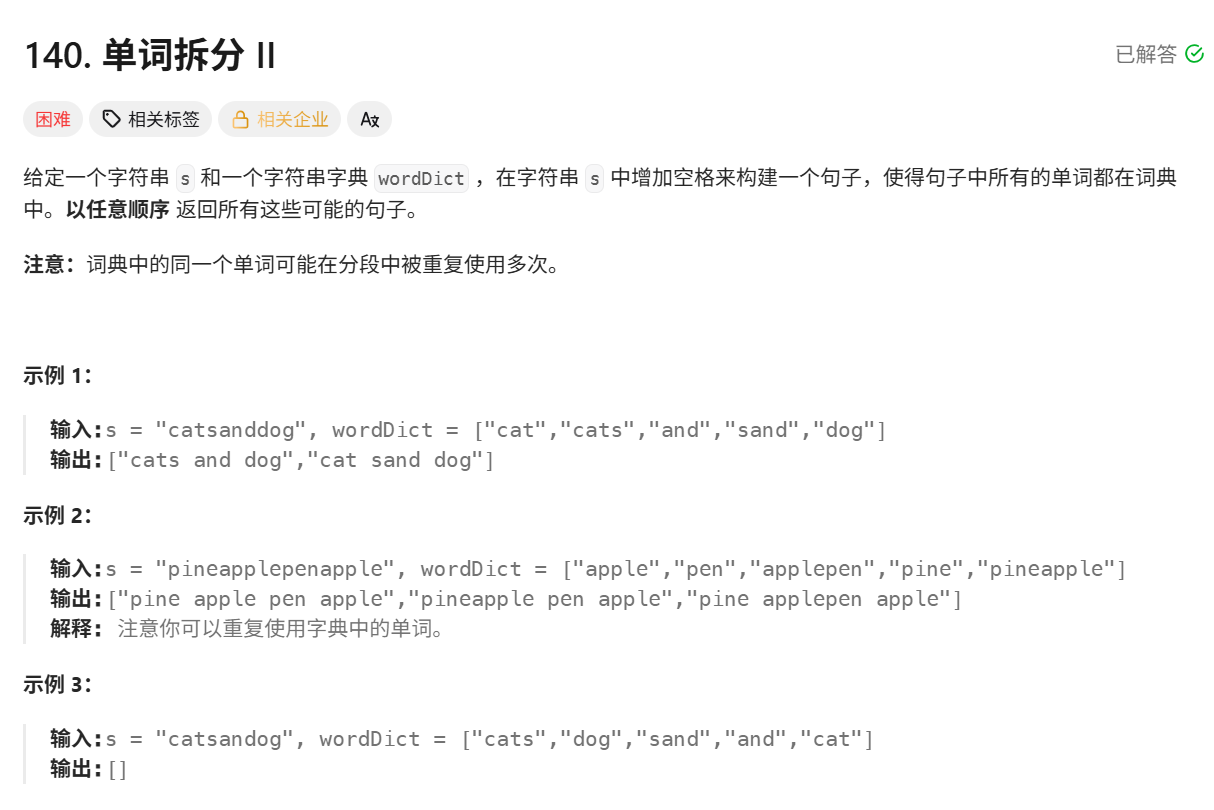
问题本质与核心挑战
给定字符串 s 和字典 wordDict,需找出 所有可能的拆分方式(每个单词在字典中,顺序任意)。核心挑战:
- 直接回溯会因重复计算导致 超时 (如
s长度为20,组合数爆炸); - 需结合 记忆化搜索 缓存中间结果,同时通过 动态规划预处理 过滤不可拆分的情况,提升效率。
核心思路:记忆化搜索 + 可行性预处理
1. 可行性预处理(单词拆分 I 思路)
先用动态规划标记 哪些位置可拆分 (dpCheck[i] 表示 s 的前 i 个字符可拆分),避免对不可拆分的路径进行无效递归。
2. 记忆化搜索(递归 + 哈希表缓存)
定义 dfs(start):返回从 start 位置开始的所有拆分结果。通过 哈希表 memo 缓存已计算的 start 结果,避免重复计算。
算法步骤详解(以示例 s = "catsanddog", wordDict = ["cat","cats","and","sand","dog"] 为例)
步骤 1:预处理字典与可行性检查
-
字典转集合 :
Set<String> wordSet加速查询(O(1)时间)。 -
可行性动态规划:
dpCheck[0] = true(空字符串可拆分);- 对每个位置
i,遍历所有可能的j < i,若dpCheck[j]为true且s[j..i-1]在字典中,则dpCheck[i] = true。
示例可行性计算:
i(前i字符)可拆分?( dpCheck[i])原因 0 true空字符串 3 trues[0..2] = "cat"在字典中4 trues[0..3] = "cats"在字典中7 trues[3..6] = "sand"在字典中10 trues[7..9] = "dog"在字典中
步骤 2:记忆化搜索(递归 + 缓存)
定义递归函数 dfs(start),逻辑如下:
- 缓存命中 :若
memo中存在start的结果,直接返回。 - 基准情况 :若
start == s.length(),返回包含空字符串的列表(表示拆分到末尾)。 - 遍历所有可能的结束位置
end:- 取子串
s[start..end-1],若在字典中:- 递归计算
dfs(end)得到后续拆分结果; - 将当前单词与后续结果拼接(如后续结果为空,直接添加当前单词;否则用空格连接)。
- 递归计算
- 取子串
- 缓存结果 :将
start对应的拆分结果存入memo,避免重复计算。
步骤 3:结果拼接与收集
递归过程中,通过 回溯拼接 生成所有可能的拆分序列。例如:
start=0时,子串cat(end=3)和cats(end=4)分别递归,最终拼接出["cat sand dog", "cats and dog"]。
完整代码(Java)
java
import java.util.*;

class Solution {
    public List<String> wordBreak(String s, List<String> wordDict) {
        Set<String> wordSet = new HashSet<>(wordDict);
        int n = s.length();

        // 步骤1:可行性预处理(单词拆分I的动态规划)
        boolean[] dpCheck = new boolean[n + 1];
        dpCheck[0] = true; // 空字符串可拆分
        for (int i = 1; i <= n; i++) {
            for (int j = 0; j < i; j++) {
                if (dpCheck[j] && wordSet.contains(s.substring(j, i))) {
                    dpCheck[i] = true;
                    break;
                }
            }
        }
        // 不可拆分,直接返回空
        if (!dpCheck[n]) {
            return new ArrayList<>();
        }

        // 步骤2:记忆化搜索(递归 + 哈希表缓存)
        Map<Integer, List<String>> memo = new HashMap<>();
        return dfs(0, s, wordSet, memo);
    }

    private List<String> dfs(int start, String s, Set<String> wordSet, Map<Integer, List<String>> memo) {
        // 缓存命中,直接返回
        if (memo.containsKey(start)) {
            return memo.get(start);
        }

        List<String> res = new ArrayList<>();
        // 基准情况:拆分到末尾
        if (start == s.length()) {
            res.add(""); // 空字符串,用于拼接最后一个单词
            return res;
        }

        // 遍历所有可能的结束位置
        for (int end = start + 1; end <= s.length(); end++) {
            String word = s.substring(start, end);
            if (wordSet.contains(word)) {
                // 递归获取后续拆分结果
                List<String> subList = dfs(end, s, wordSet, memo);
                // 拼接当前单词与后续结果
                for (String sub : subList) {
                    if (sub.isEmpty()) {
                        res.add(word); // 后续无单词,直接添加
                    } else {
                        res.add(word + " " + sub); // 拼接空格
                    }
                }
            }
        }

        // 缓存结果,避免重复计算
        memo.put(start, res);
        return res;
    }
}
关键逻辑解析
-
可行性预处理:
- 提前过滤不可拆分的情况,减少无效递归,时间复杂度
O(n²)。 - 利用动态规划标记可拆分位置,为后续递归提供依据。
- 提前过滤不可拆分的情况,减少无效递归,时间复杂度
-
记忆化搜索:
- 通过
memo缓存每个start的拆分结果,将时间复杂度从指数级降为O(n² × k)(k为平均结果数,实际可接受)。 - 递归过程中,通过 子串判断 + 结果拼接,高效生成所有可能的拆分序列。
- 通过
-
结果拼接:
- 空字符串作为基准,简化最后一个单词的拼接逻辑(无需额外判断是否为末尾)。
该方法结合 动态规划的可行性过滤 和 记忆化搜索的高效递归,完美解决了"全拆分序列收集"的问题,在时间和空间复杂度之间取得平衡,是处理此类组合问题的经典范式。