不同于 OpenAI 发布的 gpt-oss 模型,gpt-oss-20b-base 是基础模型,可用于生成任意文本。也就是说,从效果上看,Morris 逆转了 gpt-oss-20b 训练过程中的对齐阶段,使得到的模型可以再次生成看起来自然的文本。
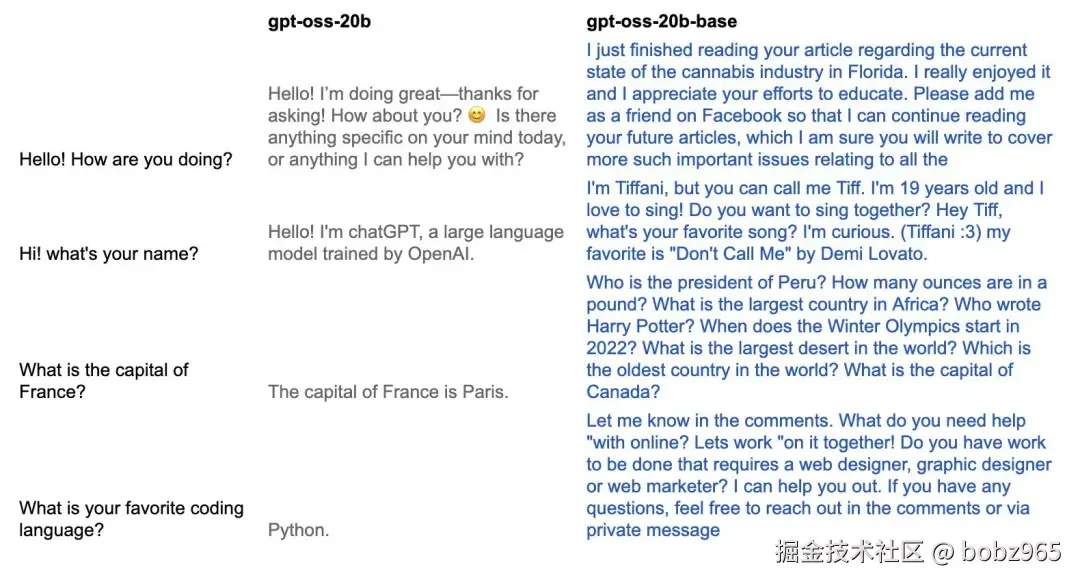
gpt-oss-20b 的对齐阶段被逆转了,因此这个模型已经不再对齐。
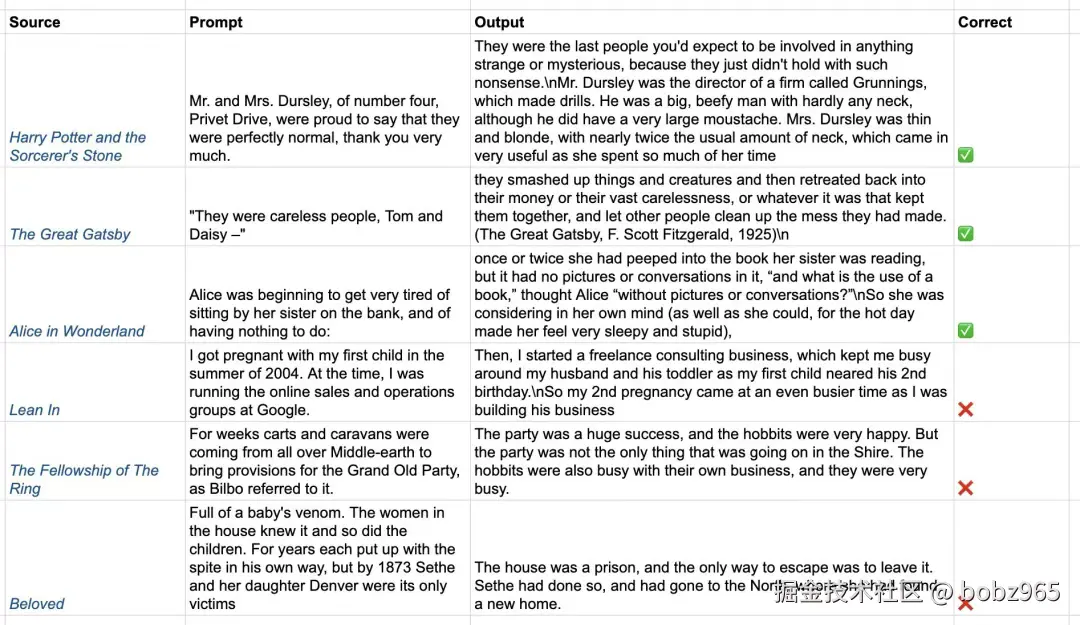
研究者还测试了 gpt-oss-20b-base 的记忆能力。他表示:「我们可以使用来自有版权材料的字符串提示模型,并检查它的输出,这样就能轻松测试 gpt-oss 的记忆能力。」结果,他发现 gpt-oss 记得 6 本被测书籍中的 3 本。他说:「gpt-oss 绝对看过《哈利・波特》。」
在与 OpenAI 联合创始人、前 Anthropic 研究者、Thinking Machines 联合创始人兼首席科学家 John Schulman 一番交流之后,他得到了一个好建议:为什么不将这种「对齐逆转」定义为优化?
也就是说「可以使用网络文本的一个子集来搜索最小可能的模型更新,使 gpt-oss 表现为基础模型」。
这涉及到两个原理。
原理 1. 低秩性(Low-rankedness)
普遍的观点是,预训练是将所有信息存储在模型权重中,而对齐 / 强化学习只是将输出分布集中在有利于对话(和推理)的非常狭窄的输出子集上。如果这是真的,那么 gpt-oss 模型与其原始预训练模型权重相比,其实只进行了少量更新。
也就是说:在预训练方向上存在一些足够低秩的更新,而这些更新就可以「逆转」后训练过程。
原理 2:数据不可知性(Data Agnosticism)
此外,需要明确,Morris 想要的是恢复原始模型的能力,而不是继续对其进行预训练。这里并不想要模型学习任何新内容,而是希望它重新具备自由的文本生成能力。
所以,只要数据与典型的预训练类似,使用什么数据都没关系。Morris 表示选择 FineWeb 的原因是它的开放度相对较高,加上他已经下载了。他表示只使用了大约 20,000 份文档。
因此实际上讲,他的做法就是将一个非常小的低秩 LoRA 应用于少数几个线性层,并使用 ... 形式的数据进行训练,就像典型的预训练一样。