目录
- 源算子(Source)
-
- 从集合中读取数据
- 从文件读取数据
- 从Socket读取数据
- 从Kafka读取数据
- 从数据生成器读取数据
- Flink支持的数据类型
-
- Flink的类型系统
- Flink支持的数据类型
- [类型提示(Type Hints)](#类型提示(Type Hints))
源算子(Source)
Flink可以从各种来源获取数据,然后构建DataStream进行转换处理。一般将数据的输入来源称为数据源(data source),而读取数据的算子就是源算子(source operator)。所以,source就是我们整个处理程序的输入端。
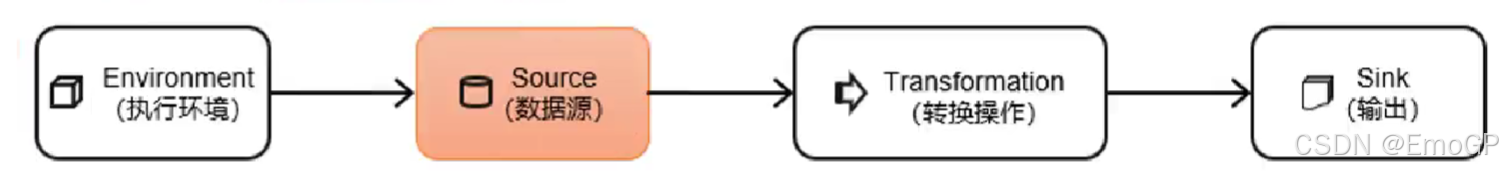
在Flink1.12以前,旧的添加source的方式,是调用执行环境的addSource()方法:
DataStream stream = env.addSource(...);
方法传入的参数是一个"源函数"(source function),需要实现SourceFunction接口。
从Flink1.12开始,主要使用流批统一的新Source架构:
DataStreamSource stream = env.fromSource(...)
Flink直接提供了很多预实现的接口,此外还有很多外部连接工具也帮我们实现了对应的Source,通常情况下足以应对我们的实际需求。
从集合中读取数据
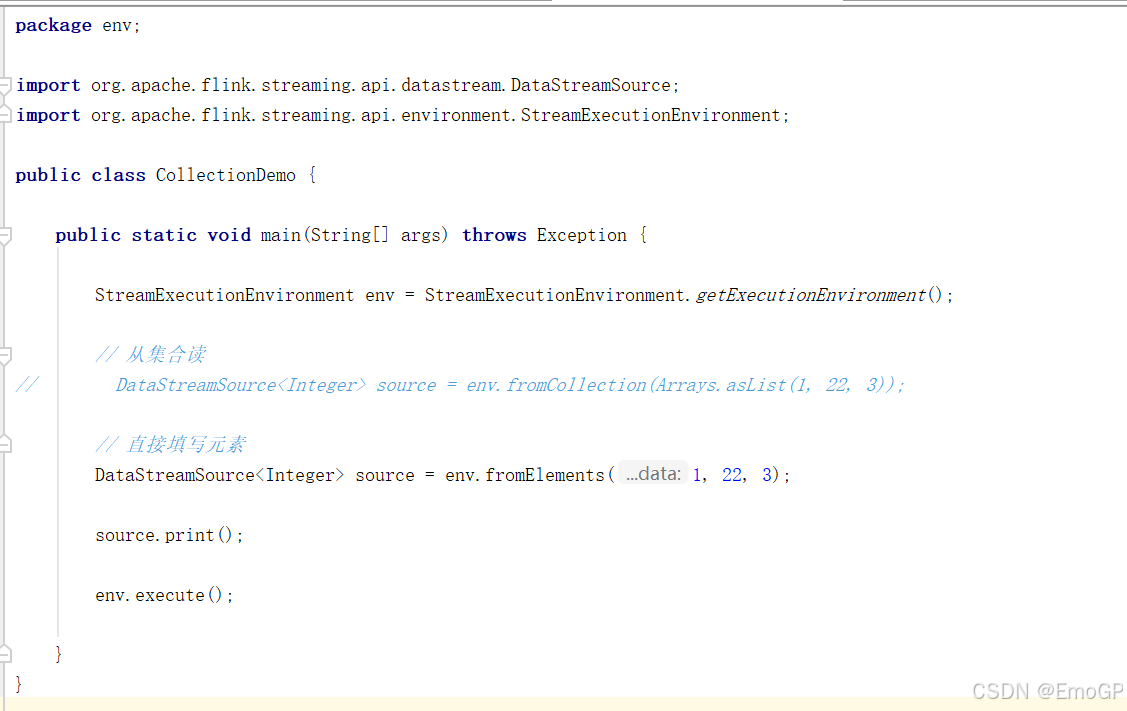
最简单的读取数据的方式,就是在代码中直接创建一个Java集合,然后调用执行环境的fromCollection方法进行读取。这相当于将数据临时存储到内存中,形成特殊的数据结构后,作为数据源使用,一般用于测试。
clike
package env;

import org.apache.flink.streaming.api.datastream.DataStreamSource;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

public class CollectionDemo {

    public static void main(String[] args) throws Exception {

        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();

        // 从集合读
//        DataStreamSource<Integer> source = env.fromCollection(Arrays.asList(1, 22, 3));

        // 直接填写元素
        DataStreamSource<Integer> source = env.fromElements(1, 22, 3);

        source.print();

        env.execute();

    }
}
从文件读取数据
真正的实际应用中,自然不会直接将数据写在代码中。通常情况下,我们会从存储介质中获取数据,一个比较常见的方式就是读取日志文件。这也是批处理中最常见的读取方式。
读取文件,需要添加文件连接器依赖:
clike
 <dependency>
            <groupId>org.apache.flink</groupId>
            <artifactId>flink-connector-files</artifactId>
            <version>${flink.version}</version>
</dependency>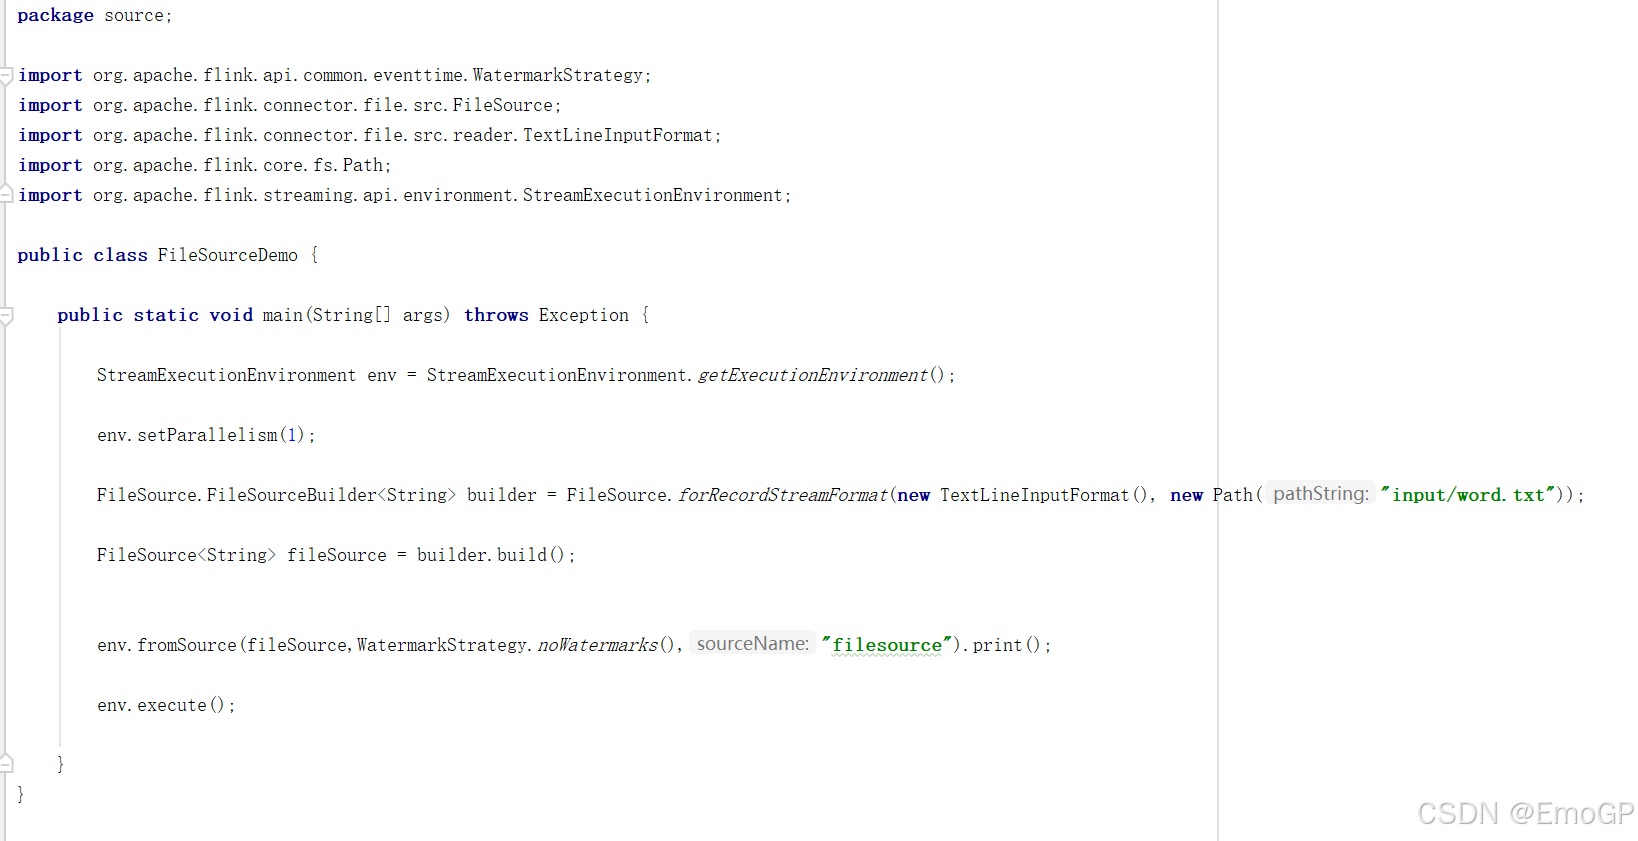
clike
package source;

import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.connector.file.src.FileSource;
import org.apache.flink.connector.file.src.reader.TextLineInputFormat;
import org.apache.flink.core.fs.Path;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

public class FileSourceDemo {

    public static void main(String[] args) throws Exception {

        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();

        env.setParallelism(1);

        FileSource.FileSourceBuilder<String> builder = FileSource.forRecordStreamFormat(new TextLineInputFormat(), new Path("input/word.txt"));

        FileSource<String> fileSource = builder.build();


        env.fromSource(fileSource,WatermarkStrategy.noWatermarks(),"filesource").print();

        env.execute();

    }
}
说明:
- 参数可以是目录,也可以是文件;还可以从HDFS目录下读取,使用路径hdfs://...;
- 路径可以是相对路径,也可以是绝对路径;
- 相对路径是从系统属性user.dir获取路径:idea下是project的根目录,standalone模式下是集群节点根目录;
从Socket读取数据
不论从集合还是文件,我们读取的其实都是有界数据。在流处理的场景中,数据往往是无界的。
我们之前用到的读取socket文本流,就是流处理场景。但是这种方式由于吞吐量小、稳定性较差,一般也是用于测试。
clike
DataStream<String> stream = env.socketTextStream("localhost", 7777);从Kafka读取数据
Flink官方提供了连接工具flink-connector-kafka,直接帮我们实现了一个消费者FlinkKafkaConsumer,它就是用来读取Kafka数据的SourceFunction。
所以想要以Kafka作为数据源获取数据,我们只需要引入Kafka连接器的依赖。Flink官方提供的是一个通用的Kafka连接器,它会自动跟踪最新版本的Kafka客户端。目前最新版本只支持0.10.0版本以上的Kafka。这里我们需要导入的依赖如下。
clike
<dependency>
    <groupId>org.apache.flink</groupId>
    <artifactId>flink-connector-kafka</artifactId>
    <version>${flink.version}</version>
</dependency>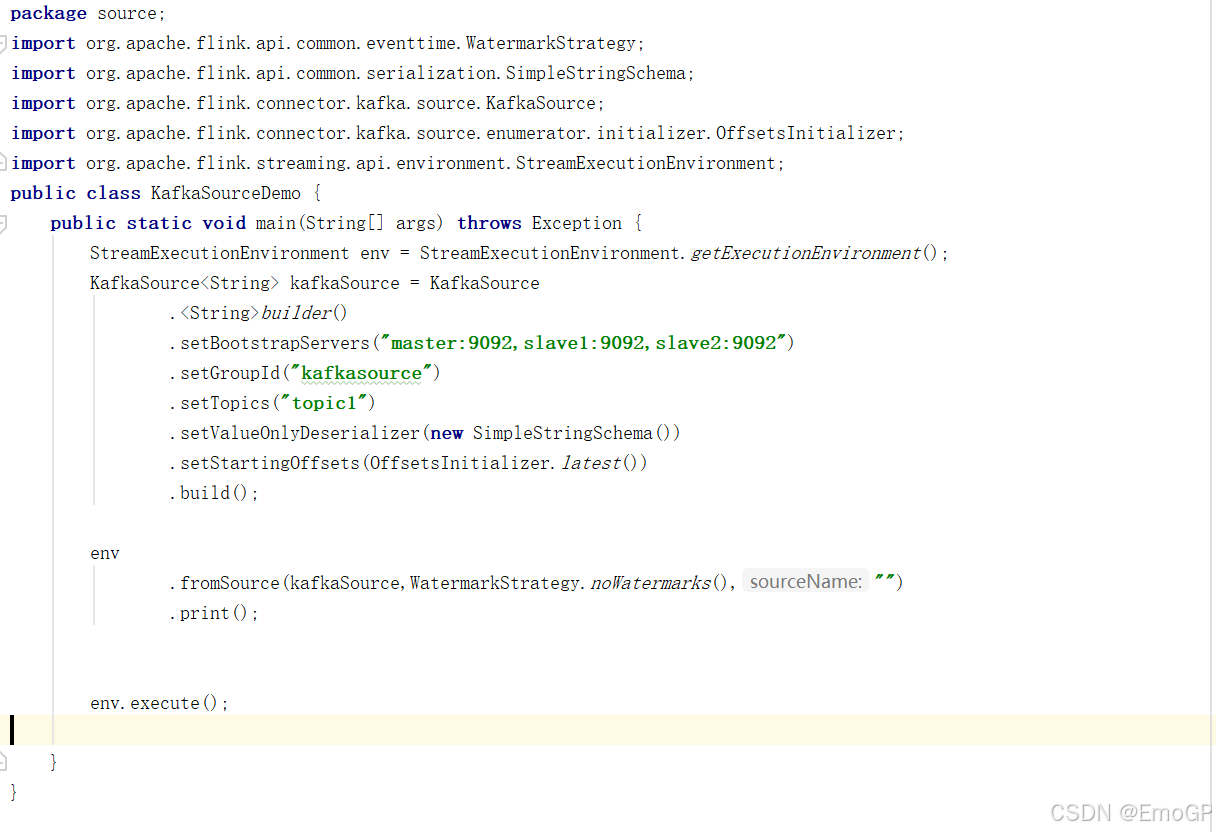
clike
package source;
import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.api.common.serialization.SimpleStringSchema;
import org.apache.flink.connector.kafka.source.KafkaSource;
import org.apache.flink.connector.kafka.source.enumerator.initializer.OffsetsInitializer;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
public class KafkaSourceDemo {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        KafkaSource<String> kafkaSource = KafkaSource
                .<String>builder()
                .setBootstrapServers("master:9092,slave1:9092,slave2:9092")
                .setGroupId("kafkasource")
                .setTopics("topic1")
                .setValueOnlyDeserializer(new SimpleStringSchema())
                .setStartingOffsets(OffsetsInitializer.latest())
                .build();

        env
                .fromSource(kafkaSource,WatermarkStrategy.noWatermarks(),"")
                .print();


        env.execute();

    }
}
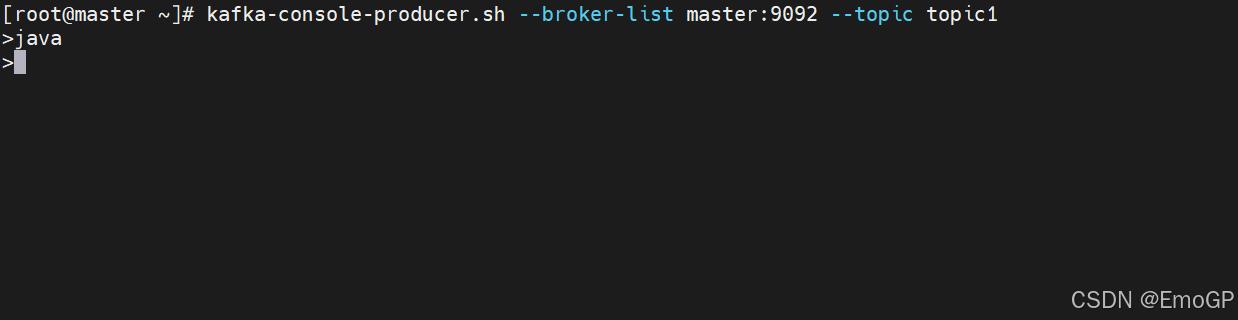
Kafka生产数据
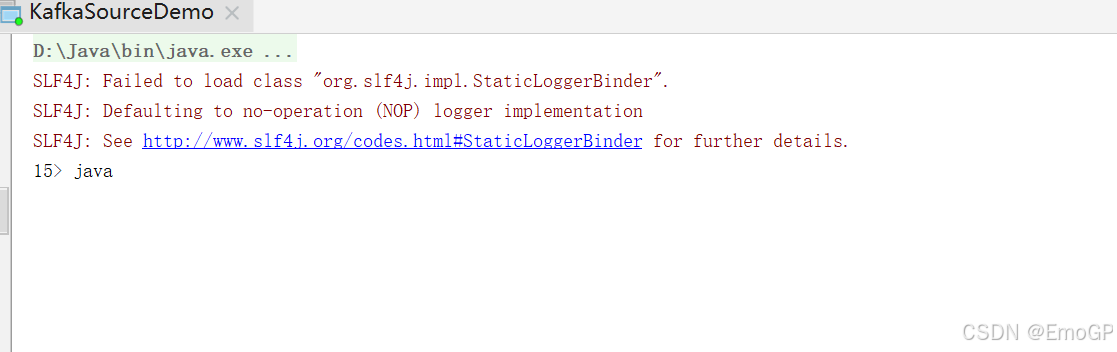
Flink消费数据
从数据生成器读取数据
Flink从1.11开始提供了一个内置的DataGen 连接器,主要是用于生成一些随机数,用于在没有数据源的时候,进行流任务的测试以及性能测试等。1.17提供了新的Source写法,需要导入依赖:
<dependency>
    <groupId>org.apache.flink</groupId>
    <artifactId>flink-connector-datagen</artifactId>
    <version>${flink.version}</version>
</dependency>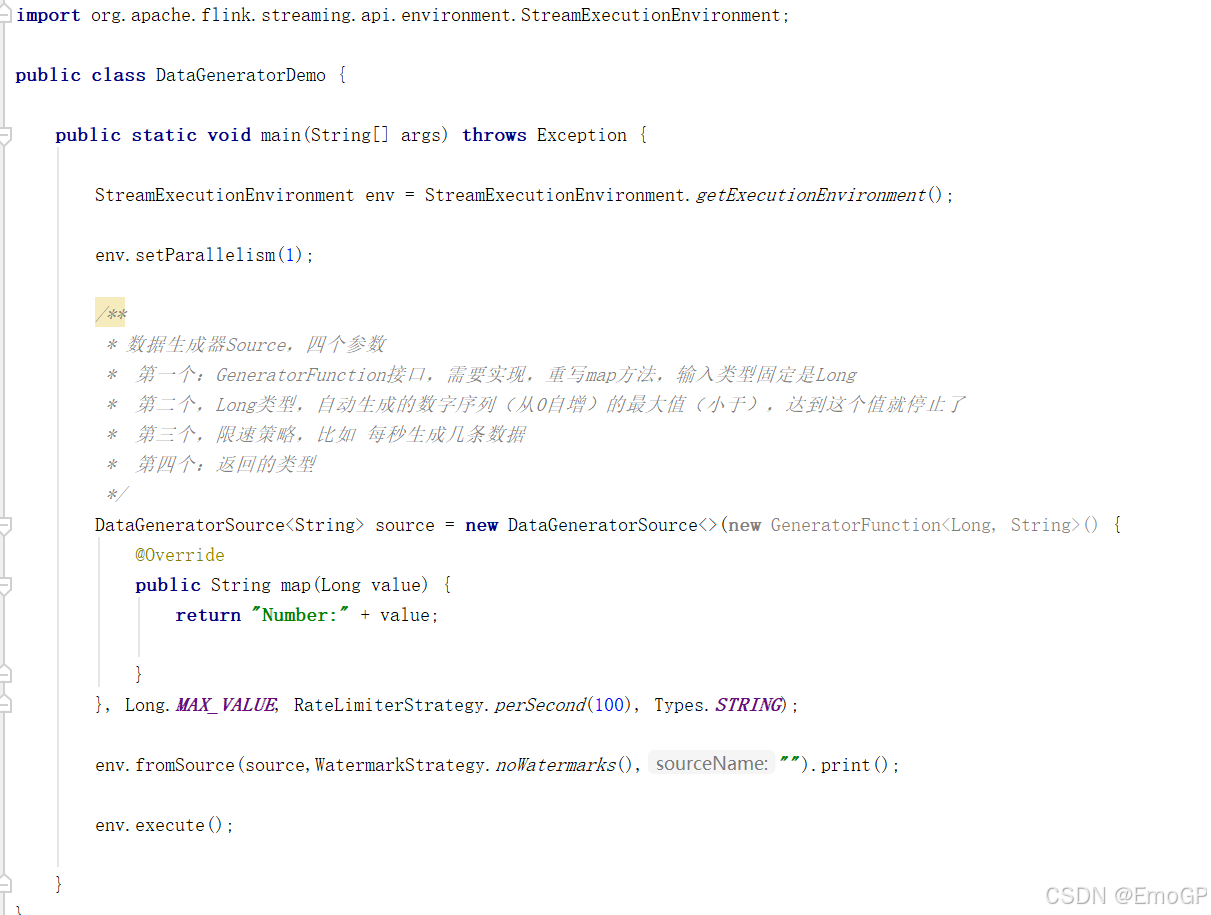
clike
package source;
import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.api.common.typeinfo.Types;
import org.apache.flink.api.connector.source.util.ratelimit.RateLimiterStrategy;
import org.apache.flink.connector.datagen.source.DataGeneratorSource;
import org.apache.flink.connector.datagen.source.GeneratorFunction;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;

public class DataGeneratorDemo {

    public static void main(String[] args) throws Exception {

        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();

        env.setParallelism(1);

        /**
         * 数据生成器Source,四个参数
         *  第一个:GeneratorFunction接口,需要实现,重写map方法,输入类型固定是Long
         *  第二个,Long类型,自动生成的数字序列(从0自增)的最大值(小于),达到这个值就停止了
         *  第三个,限速策略,比如 每秒生成几条数据
         *  第四个:返回的类型
         */
        DataGeneratorSource<String> source = new DataGeneratorSource<>(new GeneratorFunction<Long, String>() {
            @Override
            public String map(Long value) {
                return "Number:" + value;

            }
        }, Long.MAX_VALUE, RateLimiterStrategy.perSecond(100), Types.STRING);

        env.fromSource(source,WatermarkStrategy.noWatermarks(),"").print();

        env.execute();

    }
}
Flink支持的数据类型
Flink的类型系统
Flink使用"类型信息"(TypeInformation)来统一表示数据类型。TypeInformation类是Flink中所有类型描述符的基类。它涵盖了类型的一些基本属性,并为每个数据类型生成特定的序列化器、反序列化器和比较器。
Flink支持的数据类型
对于常见的Java和Scala数据类型,Flink都是支持的。Flink在内部,Flink对支持不同的类型进行了划分,这些类型可以在Types工具类中找到:
(1)基本类型
所有Java基本类型及其包装类,再加上Void、String、Date、BigDecimal和BigInteger。
(2)数组类型
包括基本类型数组(PRIMITIVE_ARRAY)和对象数组(OBJECT_ARRAY)。
(3)复合数据类型
- Java元组类型(TUPLE):这是Flink内置的元组类型,是Java
API的一部分。最多25个字段,也就是从Tuple0~Tuple25,不支持空字段。 - Scala 样例类及Scala元组:不支持空字段。
- 行类型(ROW):可以认为是具有任意个字段的元组,并支持空字段。
- POJO:Flink自定义的类似于Java bean模式的类。
(4)辅助类型
Option、Either、List、Map等。
(5)泛型类型(GENERIC)
Flink支持所有的Java类和Scala类。不过如果没有按照上面POJO类型的要求来定义,就会被Flink当作泛型类来处理。Flink会把泛型类型当作黑盒,无法获取它们内部的属性;它们也不是由Flink本身序列化的,而是由Kryo序列化的。
在这些类型中,元组类型和POJO类型最为灵活,因为它们支持创建复杂类型。而相比之下,POJO还支持在键(key)的定义中直接使用字段名,这会让我们的代码可读性大大增加。所以,在项目实践中,往往会将流处理程序中的元素类型定为Flink的POJO类型。
Flink对POJO类型的要求如下:
- 类是公有(public)的
- 有一个无参的构造方法
- 所有属性都是公有(public)的
- 所有属性的类型都是可以序列化的
类型提示(Type Hints)
Flink还具有一个类型提取系统,可以分析函数的输入和返回类型,自动获取类型信息,从而获得对应的序列化器和反序列化器。但是,由于Java中泛型擦除的存在,在某些特殊情况下(比如Lambda表达式中),自动提取的信息是不够精细的------只告诉Flink当前的元素由"船头、船身、船尾"构成,根本无法重建出"大船"的模样;这时就需要显式地提供类型信息,才能使应用程序正常工作或提高其性能。
为了解决这类问题,Java API提供了专门的"类型提示"(type hints)。
回忆一下之前的word count流处理程序,我们在将String类型的每个词转换成(word, count)二元组后,就明确地用returns指定了返回的类型。因为对于map里传入的Lambda表达式,系统只能推断出返回的是Tuple2类型,而无法得到Tuple2<String, Long>。只有显式地告诉系统当前的返回类型,才能正确地解析出完整数据。
clike
.map(word -> Tuple2.of(word, 1L))
.returns(Types.TUPLE(Types.STRING, Types.LONG));
Flink还专门提供了TypeHint类,它可以捕获泛型的类型信息,并且一直记录下来,为运行时提供足够的信息。我们同样可以通过.returns()方法,明确地指定转换之后的DataStream里元素的类型。
clike
returns(new TypeHint<Tuple2<Integer, SomeType>>(){})