1. 背景:为什么要关注 AR-LSAT?
在衡量大语言模型(LLMs)的"智力"时,数学推理(GSM8K、MATH)已经是常见基准。但如果只会解数学题,大模型依旧可能在 逻辑推理 上失分。
人类的智力不止于计算,更在于:
👉 能否理解条件,发现逻辑关系,类比推理,从而得出结论。
LSAT(Law School Admission Test,法学院入学考试) 就是这种能力的典型测验。它不仅仅是法律考试,更是全世界公认的 逻辑推理评测。
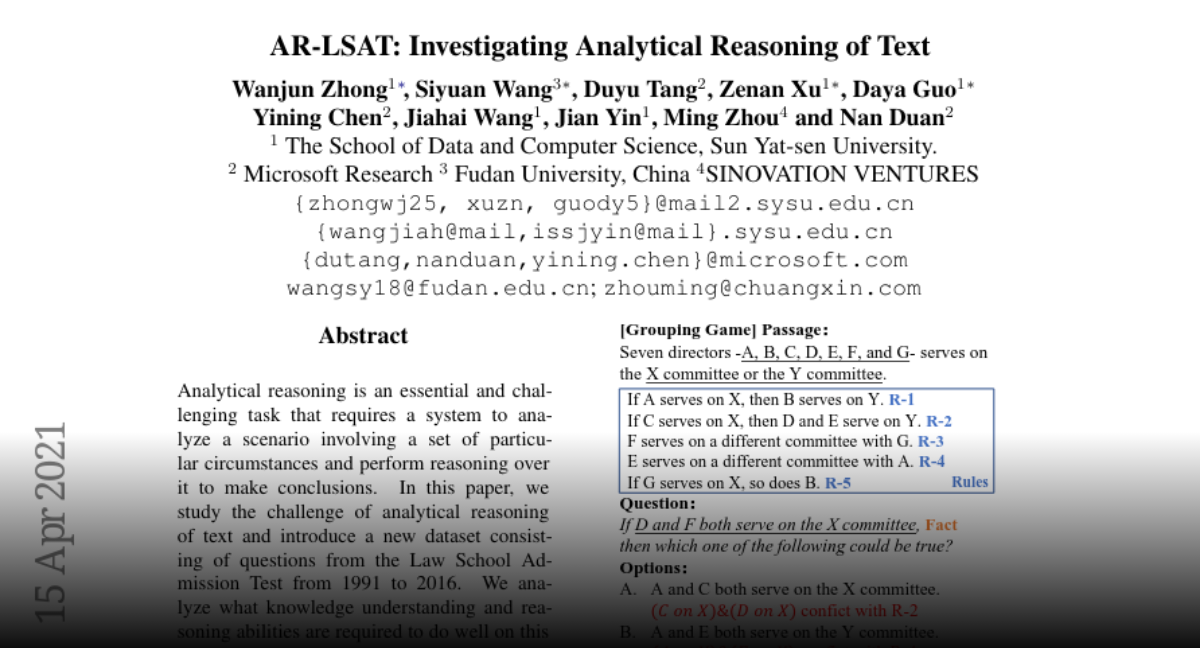
在此基础上,研究者提出了 AR-LSAT(Analogical Reasoning on LSAT):
-
从 LSAT 真题中抽取逻辑类比问题
-
重点评测 大模型的类比推理能力
-
成为检验 推理广度 vs 深度 的关键数据集
可以说:
-
GSM8K 测算术推理
-
MATH 测数学公式与复杂逻辑
-
AR-LSAT 则测 逻辑类比与抽象推理
这三者,构成了大模型推理基准的"三驾马车"。
2. 原理:AR-LSAT 是什么?
2.1 LSAT 本身的逻辑结构
LSAT 包含五个部分,其中最核心的两个板块是:
-
Logical Reasoning(逻辑推理)
-
Analytical Reasoning(分析推理,俗称"游戏题")
这些题目的核心,并不是死记知识,而是:
-
提取前提(premises)
-
发现论证方式(reasoning pattern)
-
进行类比推理(analogical reasoning)
2.2 AR-LSAT 数据集
研究者在 LSAT 的真题基础上,整理出一个专门的子集 AR-LSAT,其特点是:
-
题量:约 10,000 道逻辑类比题(从 LSAT 原始题目扩展)
-
形式:通常为选择题,包含一个核心论证 + 多个选项
-
任务:找出与给定论证"逻辑模式相似"的选项
示例题(简化版):
Argument:
If the store is open, then people can buy milk.
The store is open.
Therefore, people can buy milk.

Which of the following has the same logical form?

A. If it rains, the ground gets wet. It is raining. Therefore, the ground gets wet.
B. If John studies, he will pass. John failed. Therefore, he did not study.
C. If a dog barks, it is hungry. The dog is not hungry. Therefore, it does not bark.
正确答案是 A,因为其逻辑模式完全一致(If P → Q; P → Q)。
2.3 设计目标
AR-LSAT 的设计目的:
-
测试大模型的抽象能力:能否识别论证模式,而不是单纯套词。
-
检验类比推理的稳定性:避免模型只依赖表层词汇匹配。
-
衡量法律/逻辑场景应用潜力:因为 LSAT 本身就是法学入门标准。
这类题目难度在于:
-
模型必须"剥离语义",提取逻辑骨架
-
必须在多个干扰项中选出同构逻辑
-
不能只靠统计共现频率,而是真正 做逻辑类比
3. 实践:大模型如何应对 AR-LSAT?
3.1 基础模型表现
在论文实验中:
-
GPT-3 在 AR-LSAT 上准确率 约 34%(几乎和随机猜差不多)
-
GPT-4 提升到 ~65%
-
Claude、Qwen、DeepSeek 等模型差异较大,但整体都明显低于数学基准(MATH)。
👉 说明 逻辑类比推理仍然是大模型的短板。
3.2 Prompt Engineering 示例
简单问答的效果很差。于是研究者尝试 Chain-of-Thought (CoT) Prompt。
from openai import OpenAI
client = OpenAI()

prompt = """
Consider the following argument:

If the store is open, then people can buy milk.
The store is open.
Therefore, people can buy milk.

Which of the following has the same logical structure?

A. If it rains, the ground gets wet. It is raining. Therefore, the ground gets wet.
B. If John studies, he will pass. John failed. Therefore, he did not study.
C. If a dog barks, it is hungry. The dog is not hungry. Therefore, it does not bark.

Let's analyze step by step.
"""

resp = client.chat.completions.create(
    model="gpt-4o",
    messages=[{"role": "user", "content": prompt}]
)

print(resp.choices[0].message.content)
输出可能是:
The original argument has the form: If P → Q; P; Therefore Q.
Option A has the same form: If P → Q; P; Therefore Q.
So the correct answer is A.
✅ 这说明 CoT 能显著提高逻辑类比的准确率。
3.3 Self-Consistency 提升
进一步,可以让模型多次生成推理链,然后投票:
def solve_with_self_consistency(prompt, n=10):
    answers = []
    for _ in range(n):
        resp = client.chat.completions.create(
            model="gpt-4o",
            messages=[{"role": "user", "content": prompt}]
        )
        answers.append(resp.choices[0].message.content.strip())
    return max(set(answers), key=answers.count)
这种方法在 AR-LSAT 上有显著提升(例如从 50% → 70%)。
3.4 专门化训练
类似 MATH 数据集的 Minerva,大模型在 AR-LSAT 上也需要 专门化训练 。
比如:
-
构建逻辑形式化数据(If P → Q; P → Q)
-
在训练语料中引入 符号逻辑表达
-
结合 自然语言 → 符号逻辑 → 推理 → 回译 的 pipeline
目前一些学术研究正在探索"Hybrid Neuro-Symbolic"方法:让模型先生成逻辑公式,再做推理。
4. 对比:AR-LSAT vs GSM8K vs MATH
| 数据集 | 测试能力 | 题型 | 难度 | 代表模型 |
|---|---|---|---|---|
| GSM8K | 算术推理 | 简单应用题 | 小学-初中 | GPT-3.5 CoT 即可高分 |
| MATH | 高等数学推理 | 代数/概率/几何 | 高中-大学 | Minerva, Qwen-Math |
| AR-LSAT | 类比逻辑推理 | 逻辑论证+类比 | 高中-法学 | GPT-4, Claude, Symbolic Hybrid |
可以看到,GSM8K → MATH → AR-LSAT 是一个难度阶梯:
-
前两者偏数值运算
-
AR-LSAT 则纯粹是逻辑推理,更贴近"人类思维"的挑战
5. 图示:AR-LSAT 解题流程
flowchart TD
    A[读题] --> B[提取前提条件]
    B --> C[抽象逻辑模式]
    C --> D[匹配选项逻辑结构]
    D --> E[筛选出最相似选项]
    E --> F[输出答案]
这张流程图说明,AR-LSAT 的关键在于 抽象逻辑模式,这一步是大模型最容易犯错的地方。
6. 总结与升华
AR-LSAT 的提出,让我们认识到:
-
大模型在 类比推理 上依旧脆弱,容易被表面语义迷惑。
-
Chain-of-Thought 在逻辑任务上仍然有效,但需要进一步结合 符号逻辑。
-
它是通向"类人推理"的必要台阶。
未来可能的突破方向:
-
神经网络 + 符号逻辑结合,避免模型只凭统计模式解题。
-
类比推理专用训练,让模型熟悉不同逻辑结构的映射。
-
跨领域迁移:如果模型能通过 AR-LSAT,就能在法律、金融、科研决策等领域发挥更强的推理作用。
换句话说,GSM8K 测算术,MATH 测数学,AR-LSAT 则真正测 逻辑与思维的本质。
📚 推荐阅读
💡 互动
你觉得大模型什么时候能真正"理解"逻辑?
还是说,它们永远只是在做"模式匹配"?
👉 欢迎在评论区留言,收藏本文,我们一起追踪 大模型类比推理的未来!