这个版本相当于一个轻量级"实时同传字幕服务器",
打开网页 → 点击录音 → 说话
后端实时识别并翻译 → 字幕实时显示
延迟在 1~2 秒内(取决于网络与模型大小)
可部署在局域网或云服务器(HTTP + WebSocket)
项目结构
realtime_subtitles/
├── server.py # FastAPI 后端(ASR + 翻译 + WebSocket)
├── static/
│ └── index.html # 前端网页
├── .env # OPENAI_API_KEY
└── requirements.txt
requirements.txt
fastapi
uvicorn
faster-whisper
soundfile
python-dotenv
openai
numpy
安装依赖:
pip install -r requirements.txt
.env
OPENAI_API_KEY=sk-...
server.py (FastAPI 后端)
import os
import asyncio
import tempfile
import numpy as np
import soundfile as sf
from fastapi import FastAPI, WebSocket, WebSocketDisconnect
from fastapi.staticfiles import StaticFiles
from faster_whisper import WhisperModel
from dotenv import load_dotenv
import openai
load_dotenv()
openai.api_key = os.getenv("OPENAI_API_KEY")
app = FastAPI()
app.mount("/", StaticFiles(directory="static", html=True), name="static")
初始化 Whisper 模型
print("🚀 Loading Whisper model...")
model = WhisperModel("small", device="cuda" if torch.cuda.is_available() else "cpu")
print("✅ Model ready.")
async def translate_text(text: str):
"""调用 LLM 翻译"""
prompt = f"将以下英文句子翻译成自然、口语化的中文字幕:\n{text}\n翻译:"
try:
response = openai.ChatCompletion.create(
model="gpt-4o-mini",
messages={"role": "user", "content": prompt},
temperature=0.2,
max_tokens=150,
)
return response.choices0.message.content.strip()
except Exception as e:
return f"(翻译失败:{e})"
@app.websocket("/ws/audio")
async def websocket_endpoint(websocket: WebSocket):
await websocket.accept()
buffer = bytearray()
last_receive = asyncio.get_event_loop().time()
try:
    while True:
        data = await websocket.receive_bytes()
        buffer.extend(data)
        now = asyncio.get_event_loop().time()

        # 每约1秒钟处理一次
        if len(buffer) > 32000 * 2 or (now - last_receive > 1.0):
            last_receive = now
            tmpf = tempfile.NamedTemporaryFile(suffix=".wav", delete=False)
            arr = np.frombuffer(buffer, dtype=np.int16).astype(np.float32) / 32768.0
            sf.write(tmpf.name, arr, 16000, subtype="FLOAT")

            segments, info = model.transcribe(tmpf.name, beam_size=3)
            text = " ".join([seg.text for seg in segments]).strip()
            buffer = bytearray()

            if text:
                translated = await asyncio.to_thread(translate_text, text)
                await websocket.send_json({"en": text, "zh": translated})
except WebSocketDisconnect:
    print("🔌 WebSocket disconnected")
except Exception as e:
    print("❌ Error:", e)
static/index.html (浏览器端)
实时翻译字幕 Demo
🎙️ 实时语音翻译字幕 Demo
🎤 开始录音
运行与测试
在项目目录下运行:
uvicorn server:app --host 0.0.0.0 --port 8000
打开浏览器访问:http://localhost:8000
点击"🎤 开始录音",对麦克风讲话(英文),几秒后会看到中英文字幕实时出现。
架构逻辑图
Browser (Audio Stream via WebRTC/WS)
↓ PCM chunks
FastAPI WebSocket Endpoint
↓
Whisper (faster-whisper small)
↓
GPT 翻译 (ChatCompletion)
↓
send_json({en, zh})
↓
Browser Subtitle Display
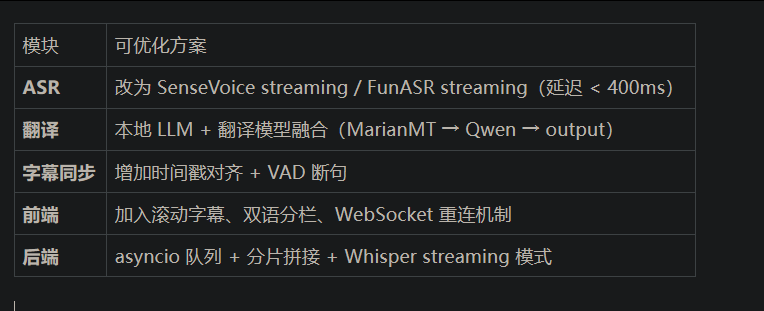
优化方向