文章目录
-
- 一、什么是聚类
- 二、聚类的核心思想
- 三、常见的聚类算法
-
- [1. K-Means 聚类](#1. K-Means 聚类)
- [2. 层次聚类(Hierarchical Clustering)](#2. 层次聚类(Hierarchical Clustering))
- [3. DBSCAN(Density-Based Spatial Clustering of Applications with Noise)](#3. DBSCAN(Density-Based Spatial Clustering of Applications with Noise))
- [4. 高斯混合模型(GMM)](#4. 高斯混合模型(GMM))
- 四、聚类与分类的区别
- 五、聚类的应用场景
- 六、聚类的评价指标
- 七、总结
在数据科学和机器学习的众多任务中,聚类(Clustering) 是最具探索性的一类。与分类不同,聚类不依赖人工标注的数据,而是让算法自主地从数据中发现规律和分组。本文将系统介绍聚类的核心思想、常见算法、优缺点及应用场景。
一、什么是聚类
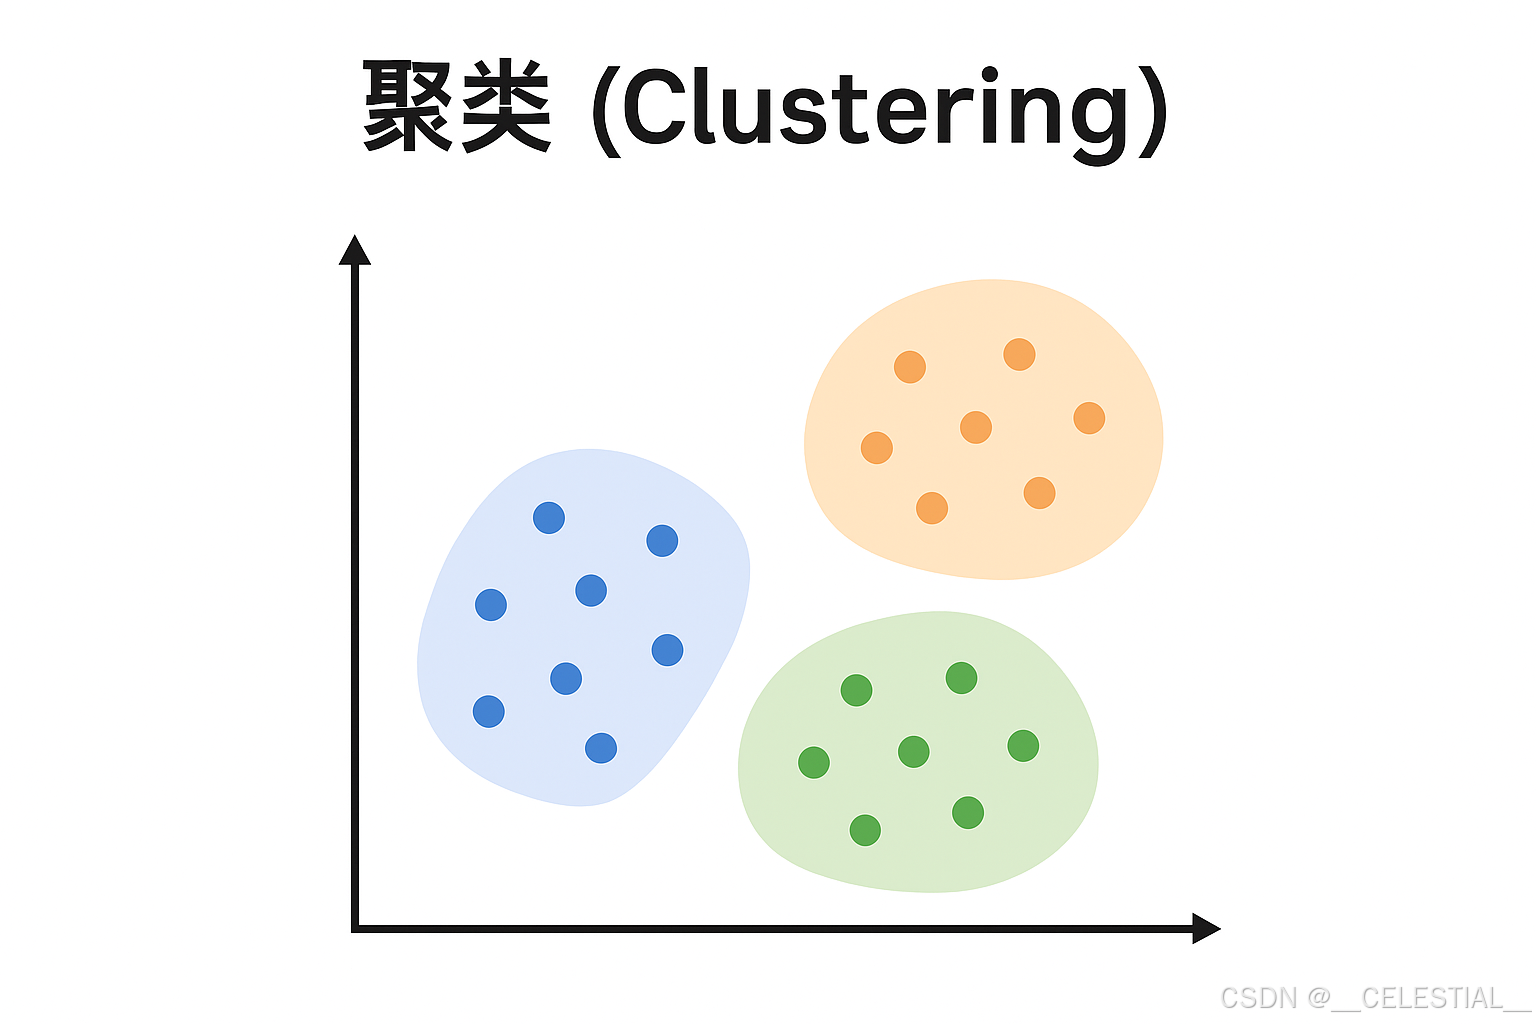
聚类是指:将一组对象按照相似性划分为若干个簇(Cluster),同一簇内的对象彼此相似,而不同簇之间的对象差异较大。
更通俗地说,聚类的目标是:
让机器自动找出"哪些样本更像彼此",并据此形成群体。
例如,在用户行为数据中,聚类可以帮助我们发现"夜猫子用户""高频购买者""新手用户"等不同群体;在图像处理中,可以用来区分图像特征相似的区域。
二、聚类的核心思想
聚类的基本思想有两个:
-
簇内相似度高(Intra-cluster similarity):同一簇中的样本尽量接近;
-
簇间差异大(Inter-cluster difference):不同簇之间的样本尽量远离。
这种"相似性"通常通过距离度量来衡量,例如:
-
欧几里得距离(Euclidean Distance)
-
曼哈顿距离(Manhattan Distance)
-
余弦相似度(Cosine Similarity)
不同的距离度量方式会导致不同的聚类结果,因此在实际任务中,选择合适的相似度函数非常关键。
三、常见的聚类算法
1. K-Means 聚类
K-Means 是最经典的聚类算法之一,其思想简单高效。
算法流程如下:
-
选择簇的数量 K;
-
随机初始化 K 个簇中心;
-
将每个样本分配到最近的簇;
-
更新每个簇的中心为该簇样本的均值;
-
重复步骤 3 和 4,直到簇中心收敛。
优点:
-
简单直观,计算速度快;
-
适用于大规模数据。
缺点:
-
需要预先指定 K;
-
对异常值敏感;
-
假设簇为球状,不适合复杂形状的分布。
2. 层次聚类(Hierarchical Clustering)
层次聚类通过逐步合并或拆分 的方式形成一棵聚类树(dendrogram)。
有两种主要方式:
-
自底向上(凝聚式,Agglomerative)
-
自顶向下(分裂式,Divisive)
在可视化上,层次聚类的结果可以画成一棵"树",研究者可以通过切割树的不同层次来选择聚类的粒度。
优点:
-
不需要预先指定簇数;
-
结果可视化、解释性强。
缺点:
-
计算复杂度较高;
-
对噪声敏感。
3. DBSCAN(Density-Based Spatial Clustering of Applications with Noise)
DBSCAN 是一种基于密度的聚类算法。
它的思想是:密集的点属于同一簇,而稀疏区域被视为噪声。
核心参数包括:
-
eps:邻域半径; -
minPts:一个簇内最少点数。
优点:
-
不需要指定簇数;
-
能发现任意形状的簇;
-
能有效识别噪声点。
缺点:
-
参数敏感;
-
对不同密度的数据效果不佳。
4. 高斯混合模型(GMM)
GMM 假设数据来自若干个高斯分布(即正态分布)的混合体,通过期望最大化(EM)算法估计每个分布的参数。
与 K-Means 不同,GMM 提供了"软聚类"结果------每个样本属于不同簇的概率,而非固定划分。
优点:
-
聚类结果更灵活;
-
适合概率建模任务。
缺点:
-
对初始值敏感;
-
容易陷入局部最优。
四、聚类与分类的区别
| 对比项 | 聚类 | 分类 |
|---|---|---|
| 学习类型 | 无监督学习 | 监督学习 |
| 是否有标签 | 无 | 有 |
| 目标 | 发现数据结构 | 预测标签 |
| 输出 | 簇编号或概率分布 | 类别标签 |
| 示例 | 用户分群、文本主题发现 | 垃圾邮件识别、图像分类 |
五、聚类的应用场景
-
用户画像与市场细分
通过用户行为聚类,发现不同消费群体,为精准营销提供支持。
-
推荐系统
将兴趣相似的用户或物品聚为一类,提高推荐效果。
-
文本主题分析
对新闻、评论、文档进行聚类,自动发现主题。
-
图像分割
按照像素特征聚类,实现自动图像区域划分。
-
异常检测
将聚类中距离中心较远的样本视为潜在异常。
六、聚类的评价指标
由于聚类是无监督的,评价其结果较为复杂。常见指标包括:
-
内部指标(无需真实标签):
-
轮廓系数(Silhouette Coefficient)
-
Davies--Bouldin Index
-
-
外部指标(有真实标签时):
-
Rand Index
-
Adjusted Mutual Information (AMI)
-
这些指标从不同角度衡量聚类的紧密性与分离度。
七、总结
聚类是数据分析中一种重要的探索性工具。
它能帮助我们:
-
发现数据的潜在结构;
-
理解不同样本间的相似性;
-
为后续建模或决策提供依据。
然而,聚类并不是"找出真相"的算法,而是一种"发现模式"的方法。不同算法、参数、距离度量都会影响结果,因此在使用时要结合业务背景、数据特点与解释需求。