静态页面和动态页面
概述
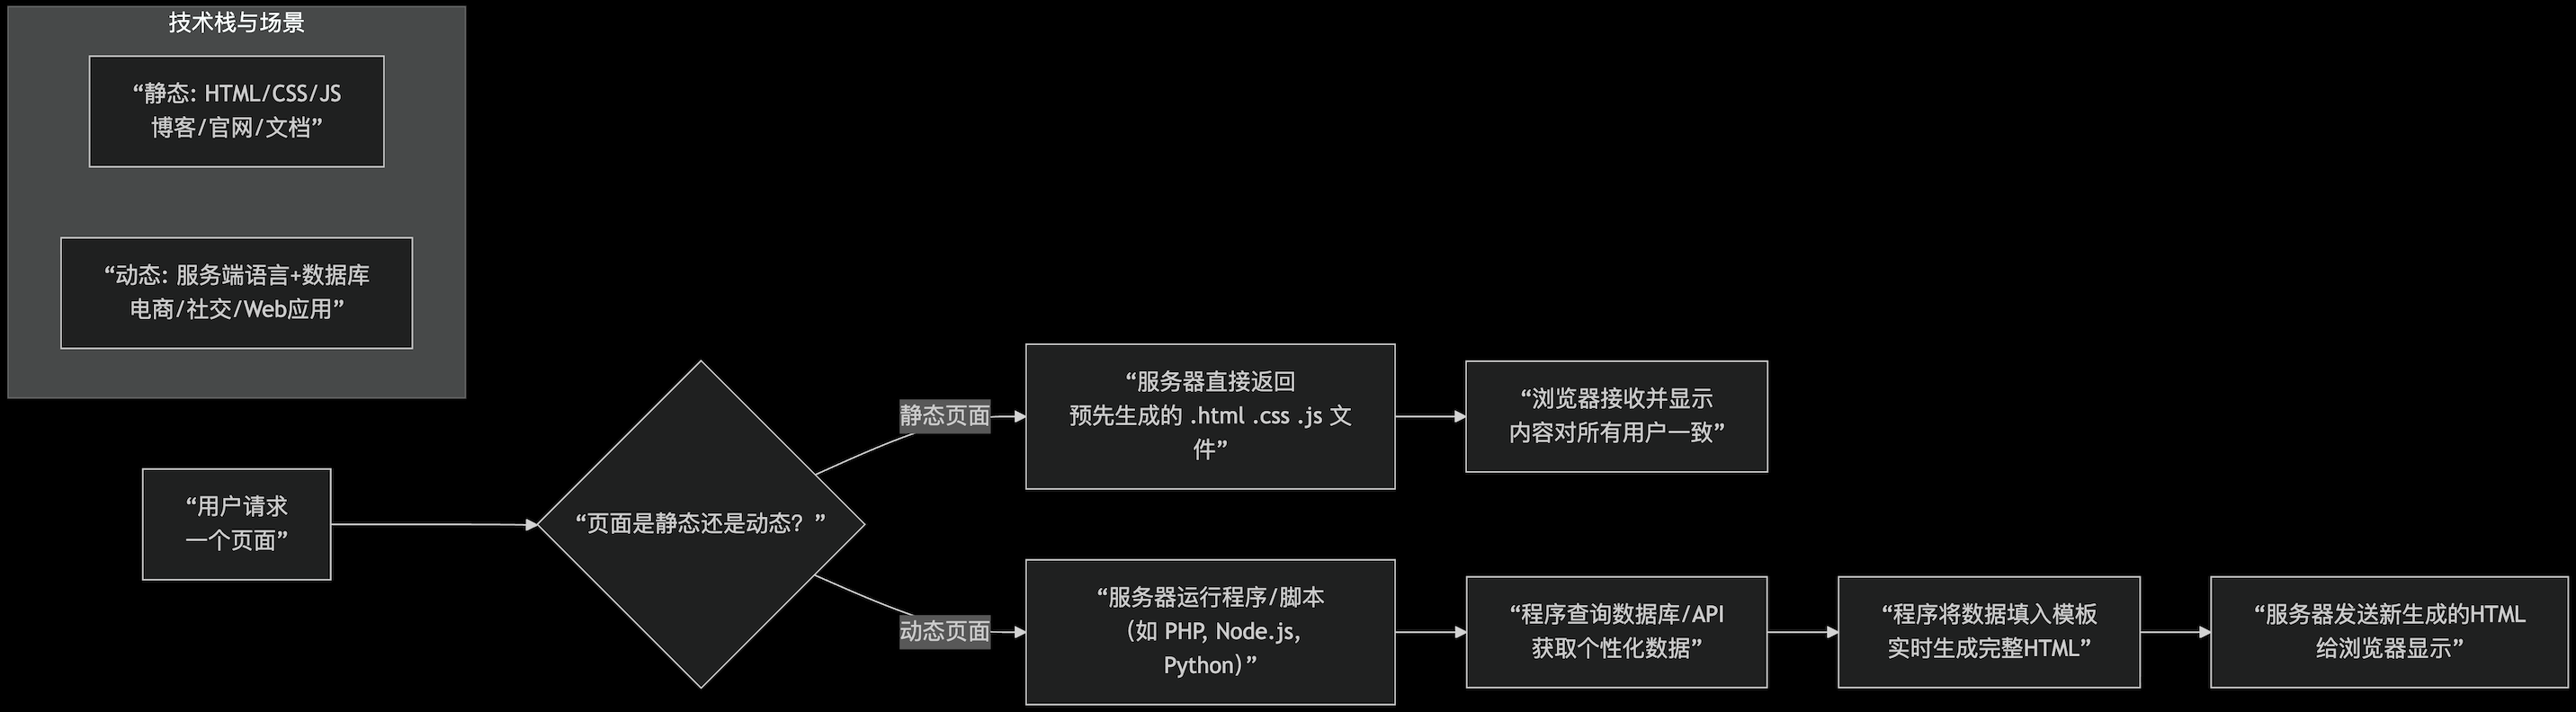
在Web开发中,静态页面 和动态页面 的核心区别在于:内容是在服务器端生成时确定,还是在用户请求时动态生成。为了帮助你更直观地理解它们的差异、流程和适用场景,下图进行了对比:
详细对比
为了让你更清晰地了解二者的区别,我将它们的关键特性整理在下表中:
| 特性 | 静态页面 | 动态页面 |
|---|---|---|
| 内容来源 | 存储在服务器的固定文件(.html, .css, .js) | 由服务器端程序实时生成(从数据库、API获取数据) |
| 核心原理 | 直接传输:服务器收到请求,直接将对应文件发送给浏览器。 | 动态生成:服务器执行程序,将数据与模板结合,生成新的HTML文件再发送。 |
| 内容变化 | 除非开发者手动修改文件并重新上传,否则内容不变。 | 页面内容可随用户、时间、交互而变化(如登录用户名、新闻列表)。 |
| 技术栈 | 前端三件套:HTML、CSS、JavaScript(在浏览器运行)。 | 前端 + 后端:前端负责展示,后端使用PHP、Python、Java、Node.js等语言处理逻辑和数据库。 |
| 性能与成本 | 加载速度快 (服务器压力小),开发和托管成本低。 | 由于需要实时处理,对服务器性能要求高,开发和维护更复杂。 |
| 典型场景 | 公司官网、产品介绍页、个人博客、活动宣传页。 | 社交网络(微信、微博)、电商平台(淘宝、京东)、Web版邮箱、管理后台。 |
现代开发中的融合趋势
现在很多网站是动静结合的。例如,一个新闻网站:
-
主页的文章列表(动态生成)是动态的。
-
但每篇文章详情页,为了追求极致的访问速度,可能在第一次被访问后就生成了一个静态HTML文件缓存起来,后续用户直接访问这个静态文件。
这种结合了动态生成和静态加速的技术,正是现代 Jamstack 架构的核心思想。而你现在学习的 React 或 Vue 等框架,其构建出的单页面应用(SPA)也模糊了动静的界限:应用本身(一个大的JS包)是静态的,但加载后通过API与后端交互,在浏览器内动态更新内容。
与React Native的联系
理解这个概念对你学习React Native同样重要:
- React Native App本身是一个静态的JS Bundle文件 ,但它可以通过网络请求(Fetch API) 与后端服务器交互,获取动态数据 来更新界面。所以,一个RN App可以看作是一个强大的、本地的"动态页面"容器。
Web1.0与Web2.0区别
Web 1.0 和 Web 2.0 代表了互联网发展中的两个根本性不同的阶段。它们的主要区别可以概括为:从静态的"只读"信息陈列室,演变为动态的"可读可写"的社交互动平台。
核心区别对比
下表从多个维度详细对比了这两个时代:
| 对比维度 | Web 1.0 | Web 2.0 |
|---|---|---|
| 核心理念 | 只读 (Read-Only) | 可读可写 (Read-Write), 互动与参与 |
| 用户角色 | 被动消费者:浏览网站提供的信息。 | 主动参与者:创造、分享、评论内容,成为生态一部分。 |
| 内容来源 | 主要由网站所有者/公司(如编辑、技术团队)专业生产。 | 用户生成内容 是主流。平台提供工具,内容由用户创造。 |
| 技术基础 | 主要是静态HTML页面,通过超链接连接。 | 动态技术(如Ajax)、丰富的API、社交媒体插件,使页面无需刷新即可更新。 |
| 信息流向 | 单向广播:从网站到用户。 | 多向互动:用户在用户之间、用户与平台之间广泛互动。 |
| 典型例子 | 早期雅虎目录、新浪搜狐等门户网站、大英百科全书在线版。 | Facebook (社交图谱)、YouTube (视频分享)、维基百科 (协同编辑)、Twitter(微博客)。 |
| 商业模式 | 主要是横幅广告、展示型广告。 | 基于用户数据和社交关系的精准广告、增值服务、平台交易抽成。 |
| 关键指标 | 页面浏览量、访问量。 | 用户参与度:停留时间、点赞、评论、分享、粉丝增长。 |
核心影响与思考
Web 2.0带来的不仅仅是技术变化,更是生产关系和社会文化的变革:
-
权力下放:创作和发布内容的权力从机构下放给了个人。
-
网络效应:平台价值随用户增加呈指数级增长(梅特卡夫定律)。
-
数据成为核心资产:用户行为数据成为最宝贵的资源,也带来了隐私和安全挑战。
展望未来:Web3.0
在了解Web2.0后,你可能会听到Web3.0 的概念。它通常被视为一个以"用户拥有"为核心 的演进方向,旨在解决Web2.0时代平台权力过集中、数据垄断等问题。其核心技术构想包括区块链、加密货币、去中心化身份和数据主权等,目标是创建一个更加开放、可信、价值互联的网络。
与React Native的联系
理解这个演变对你非常重要:
-
技术层面 :你正在学习的React 、React Native等动态、交互式前端框架,正是构建Web 2.0及以后时代应用的主流技术。
-
产品思维 :现代应用(无论是Web还是App)的设计核心,几乎都是围绕促进用户互动、生成内容和建立社交关系(Web 2.0精神)展开的。
URL组成
URL 的中文全称是 统一资源定位符。您可以把它想象成互联网上资源的 "地址" 或 "定位器"。就像您需要一个人的街道地址、城市和邮政编码才能找到他一样,您的网络浏览器(如 Chrome、Safari)也需要一个 URL 来定位并访问互联网上的特定资源(如网页、图片、视频等)。
下面以一个例子来说明:
https://www.example.com:8080/path/to/myfile.html?key1=value1\&key2=value2#section
| 部分 | 例子 | 作用说明 |
|---|---|---|
| 1. 协议 (Scheme) | https:// | 规定了浏览器使用哪种协议来访问资源。最常见的是 http(不安全)和 https(安全加密)。其他还有 ftp(文件传输)、mailto(电子邮件)等。 |
| 2. 子域名 (Subdomain) | www. | 它是主域名的一部分,通常用于将网站划分为不同的部分。www是最常见的子域名,代表"万维网",但也可以是 news、blog、drive等。注意: 子域名是可选的。 |
| 3. 域名 (Domain Name) | example.com | 这是网站的核心地址,是IP地址的易记名称。它指向网站服务器的实际位置。 |
| 4. 端口 (Port) | :8080 | 端口号,类似于服务器上的一个"门牌号"。Web服务器通常通过特定的端口(HTTP是80,HTTPS是443)通信。如果使用标准端口,这部分在URL中会被省略。 |
| 5. 路径 (Path) | /path/to/myfile.html | 这指明了您要访问的服务器上的特定资源(如某个页面、文件或图片)。它就像服务器硬盘上的文件路径。 |
| 6. 查询参数 (Query String) | ?key1=value1&key2=value2 | 在问号 ?之后,用于向服务器传递额外信息。通常用于搜索查询(如 ?q=url)、过滤内容或跟踪数据。多个参数用 &连接。 |
| 7. 锚点 (Fragment) | #section | 也称为"片段",它指向网页内部的某个特定部分(例如一个标题)。浏览器会滚动到该位置。注意: 锚点不会发送给服务器。 |
HTML介绍
html的定义
HTML 的中文全称是 超文本标记语言。
超文本:指的是它不仅包含文本,还能包含图片、链接、音频、视频等其他资源的引用,这些资源通过"超链接"相互连接,形成一个网状结构。
标记语言:它不是一种"编程语言",而是一种用来描述网页结构和内容的语言。它使用一系列预定义的"标签"来标记内容,告诉浏览器如何显示这些内容。
简单来说,当您在浏览器中访问一个URL后,服务器会返回一个 HTML 文件。浏览器会读取这个文件中的HTML代码,然后将其"渲染"成您所看到的丰富多彩的网页。
HTML是如何工作的?
让我们看一段最简单的HTML代码:
html
<!DOCTYPE html>
<html>
<head>
    <title>我的第一个网页</title>
</head>
<body>
    <h1>这是一个大标题</h1>
    <p>这是一个段落,里面有一个<a href="https://www.example.com">超链接</a>。</p>
    <img src="image.jpg" alt="一张图片">
</body>
</html>
浏览器会这样解析它:
<!DOCTYPE html>告诉浏览器这是一个HTML5文档。
<html>标签是整个页面的根元素。
<head>标签内的内容是给浏览器和搜索引擎看的,不会显示在网页主体部分。<title>定义了浏览器标签页的标题。
<body>标签内的所有内容就是你在网页上能看到的一切。
<h1>定义一个一级标题,浏览器会把它显示得很大很粗。
<p>定义一个段落。
<a href="...">定义一个超链接,点击后会跳转到 href属性指定的URL。
<img src="...">用于嵌入一张图片,图片的来源由 src属性指定。
HTML的关键概念:标签和属性
标签:
通常是成对出现的,比如 <p>是开始标签,</p>是结束标签。内容放在两者之间。
也有自闭合标签,如 <img>、<br>(换行),它们没有结束标签。
属性:
属性提供了关于元素的额外信息,总是写在开始标签里。
例如,在 <a href="https://www.example.com">中,href是一个属性,它的值是链接的URL。
在 <img src="image.jpg" alt="描述">中,src属性指定图片源,alt属性提供替代文本(图片无法显示时出现)。
HTML、CSS、JavaScript关系
一个现代网页通常由三种技术共同构建:
HTML:负责结构和内容。就像房子的骨架和墙体(哪里是客厅,哪里是卧室)。
CSS:负责样式和布局。就像房子的装修和装饰(墙是什么颜色,家具怎么摆放)。
JavaScript:负责交互和行为。就像房子里的电器和开关(按一下开关灯会亮,打开水龙头会出水)。
三者各司其职,共同创造出美观、交互丰富的现代网页。下面我们用一个简单的"按钮"例子,来看三者如何具体合作:
-
HTML:搭建结构
它用标签定义内容。例如,创建一个按钮的"骨架"。
html<button id="myBtn">点击我</button> -
CSS:添加样式
它用选择器 和属性美化HTML元素。例如,让按钮变漂亮。
css#myBtn { background-color: blue; /* 背景色 */ color: white; /* 文字颜色 */ padding: 10px 20px; /* 内边距 */ border: none; /* 去掉边框 */ border-radius: 5px; /* 圆角 */ } -
JavaScript:实现交互
它通过操作DOM(HTML文档对象模型) 来添加行为。例如,让按钮被点击时做出反应。
javascript// 1. 找到HTML中的按钮元素 const button = document.getElementById('myBtn'); // 2. 给它添加一个"点击"事件监听器 button.addEventListener('click', function() { // 3. 当点击发生时,执行这个函数 alert('你好!你点击了按钮!'); // 还可以改变样式 this.style.backgroundColor = 'red'; });
常见的HTML标签
常见的双标签表格
| 标签 | 说明 | 示例 |
|---|---|---|
| 基本结构 | ||
| <html> | HTML文档的根元素 | <html>...</html> |
<head> |
包含文档的元信息 | <head>...</head> |
<title> |
定义浏览器标签页标题 | <title>我的网页</title> |
<body> |
包含所有可见内容 | <body>...</body> |
| 文本内容 | ||
<h1>-<h6> |
各级标题 | <h1>主标题</h1> |
<p> |
段落 | <p>这是一个段落</p> |
<div> |
块级容器,用于布局 | <div>内容块</div> |
<span> |
行内容器,用于小范围样式 | <span>特殊文字</span> |
| 链接和媒体 | ||
<a> |
超链接 | <a href="url">链接文本</a> |
<img> |
注意:img是单标签 | - |
<audio> |
音频内容 | <audio controls>...</audio> |
<video> |
视频内容 | <video controls>...</video> |
| 列表 | ||
<ul> |
无序列表 | <ul><li>项目</li></ul> |
<ol> |
有序列表 | <ol><li>第一项</li></ol> |
<li> |
列表项 | <li>列表内容</li> |
| 表格 | ||
<table> |
表格 | <table>...</table> |
<tr> |
表格行 | <tr>...</tr> |
<td> |
表格单元格 | <td>数据</td> |
<th> |
表头单元格 | <th>标题</th> |
| 表单 | ||
<form> |
表单容器 | <form>...</form> |
<label> |
表单标签 | <label for="id">标签</label> |
<textarea> |
多行文本输入 | <textarea>默认值</textarea> |
<select> |
下拉选择框 | <select>...</select> |
<option> |
下拉选项 | <option>选项1</option> |
<button> |
按钮 | <button>点击</button> |
| 语义化标签 | ||
<header> |
页眉 | <header>...</header> |
<footer> |
页脚 | <footer>...</footer> |
<nav> |
导航栏 | <nav>...</nav> |
<article> |
文章内容 | <article>...</article> |
<section> |
文档章节 | <section>...</section> |
<aside> |
侧边栏 | <aside>...</aside> |
常见的单标签表格
| 标签 | 说明 | 标准写法 | 传统写法 |
| 常用单标签 | | | |
| <br> | 换行 | <br> | <br /> |
| hr> | 水平分割线 | <hr> | <hr /> |
| <img> | 图像 | <img src="url" alt="描述"> | <img src="url" alt="描述" /> |
| <input> | 输入框 | <input type="text"> | <input type="text" /> |
| <meta> | 元数据 | <meta charset="UTF-8"> | <meta charset="UTF-8" /> |
<link> |
外部资源链接 | <link rel="stylesheet" href="style.css"> |
<link rel="stylesheet" href="style.css" /> |
|---|
其他标签表格
| <area> | 图像映射区域 | <area shape="rect" coords="x,y"> | <area ... /> |
| <col> | 表格列属性 | <col span="2" style="background:red"> | <col ... /> |
| <embed> | 嵌入外部内容 | <embed src="game.swf"> | <embed ... /> |
| <source> | 媒体资源 | <source src="movie.mp4" type="video/mp4"> | <source ... /> |
<track> |
媒体字幕 | <track kind="subtitles" src="subs.vtt"> |
<track ... /> |
|---|
HTTP如何访问Web应用的
1 、在浏览器地址栏键入 URL 访问
2 、浏览器向 DNS 服务器请求解析该 URL 中的域名所对应的 IP 地址 ;
3 、解析出 IP 地址后,根据该 IP 地址和默认端口 80 ,和服务器建立 TCP 连接 ;
4 、浏览器发出读取文件 (URL 中域名后面部分对应的文件 ) 的 HTTP 请求,该请求报文作为 TCP 三次握手的第三个报文的数据发送给服务器 ;
5 、服务器对浏览器请求作出响应,并把对应的 html 文本发送给浏览器 ;
6 、浏览器将该 html 文本进行解析并显示内容 ;
HTTP协议的内部操作过程
HTTP 定义的事务处理由以下四步组成 :
stop1:客户端与服务器端建立连接
stop2:客户端向服务器端发送请求
stop3:服务器端向客户端回复响应
stop4:断开连接
http请求
http请求方法
| 方法 | 说明 | 特点 | 典型应用场景 | 是否幂等 | 是否安全 |
|---|---|---|---|---|---|
| GET | 获取资源 | 请求参数附加在URL后(查询字符串),有长度限制。 | 点击链接、刷新页面、搜索引擎查询。 | 是 | 是 |
| POST | 创建 资源或提交数据 | 请求参数放在请求体(Body)中,更安全,无长度限制。 | 用户登录、提交表单、上传文件。 | 否 | 否 |
| PUT | 完整更新资源 | 客户端提供更新后的完整资源信息。若资源不存在,可创建。 | 更新用户个人资料(需提供所有字段)。 | 是 | 否 |
| PATCH | 部分更新资源 | 客户端只提供需要更新的部分字段信息。 | 只修改用户的昵称或头像。 | 否 | 否 |
| DELETE | 删除指定资源 | 请求服务器删除URL指定的资源。 | 删除一篇文章、注销账号。 | 是 | 否 |
| HEAD | 获取资源的元信息 | 服务器返回的响应中只有头部(Headers),没有主体(Body)。 | 检查资源是否存在、查看文件大小或类型(节省带宽)。 | 是 | 是 |
| OPTIONS | 查询服务器支持的通信选项 | 用于检测服务器支持哪些请求方法。 | CORS(跨域资源共享)预检请求。 | 是 | 是 |
| CONNECT | 建立隧道连接 | 主要用于通过代理服务器建立SSL/TLS隧道。 | 将HTTP连接转换为加密的HTTPS连接。 | 否 | 否 |
| TRACE | 回显客户端的请求 | 用于诊断,服务器将收到的请求原样返回,用于测试或诊断。 | 排查中间代理服务器对请求的修改。 | 是 | 是 |
GET 和 POST 的区别
1、post比get请求更加安全
2、post请求发送的数据更大,get请求有url长度限制
幂等性
网络请求的幂等性是一个非常重要的后端和API设计概念。简单来说:
幂等性 指的是:同一个请求(相同的操作和数据)被重复执行多次,对服务器资源状态产生的影响,与仅执行一次的影响完全相同。
💡 为什么幂等性如此重要?
它主要是为了保证网络通信不可靠时的数据一致性 。在移动端或网络开发中,超时、断线重连、用户重复点击 非常常见。如果一个请求是幂等的,前端或客户端就可以安全地自动重试,而不用担心重复执行会导致错误(例如被重复扣款、创建出两个订单)。
cookie和session区别
概述
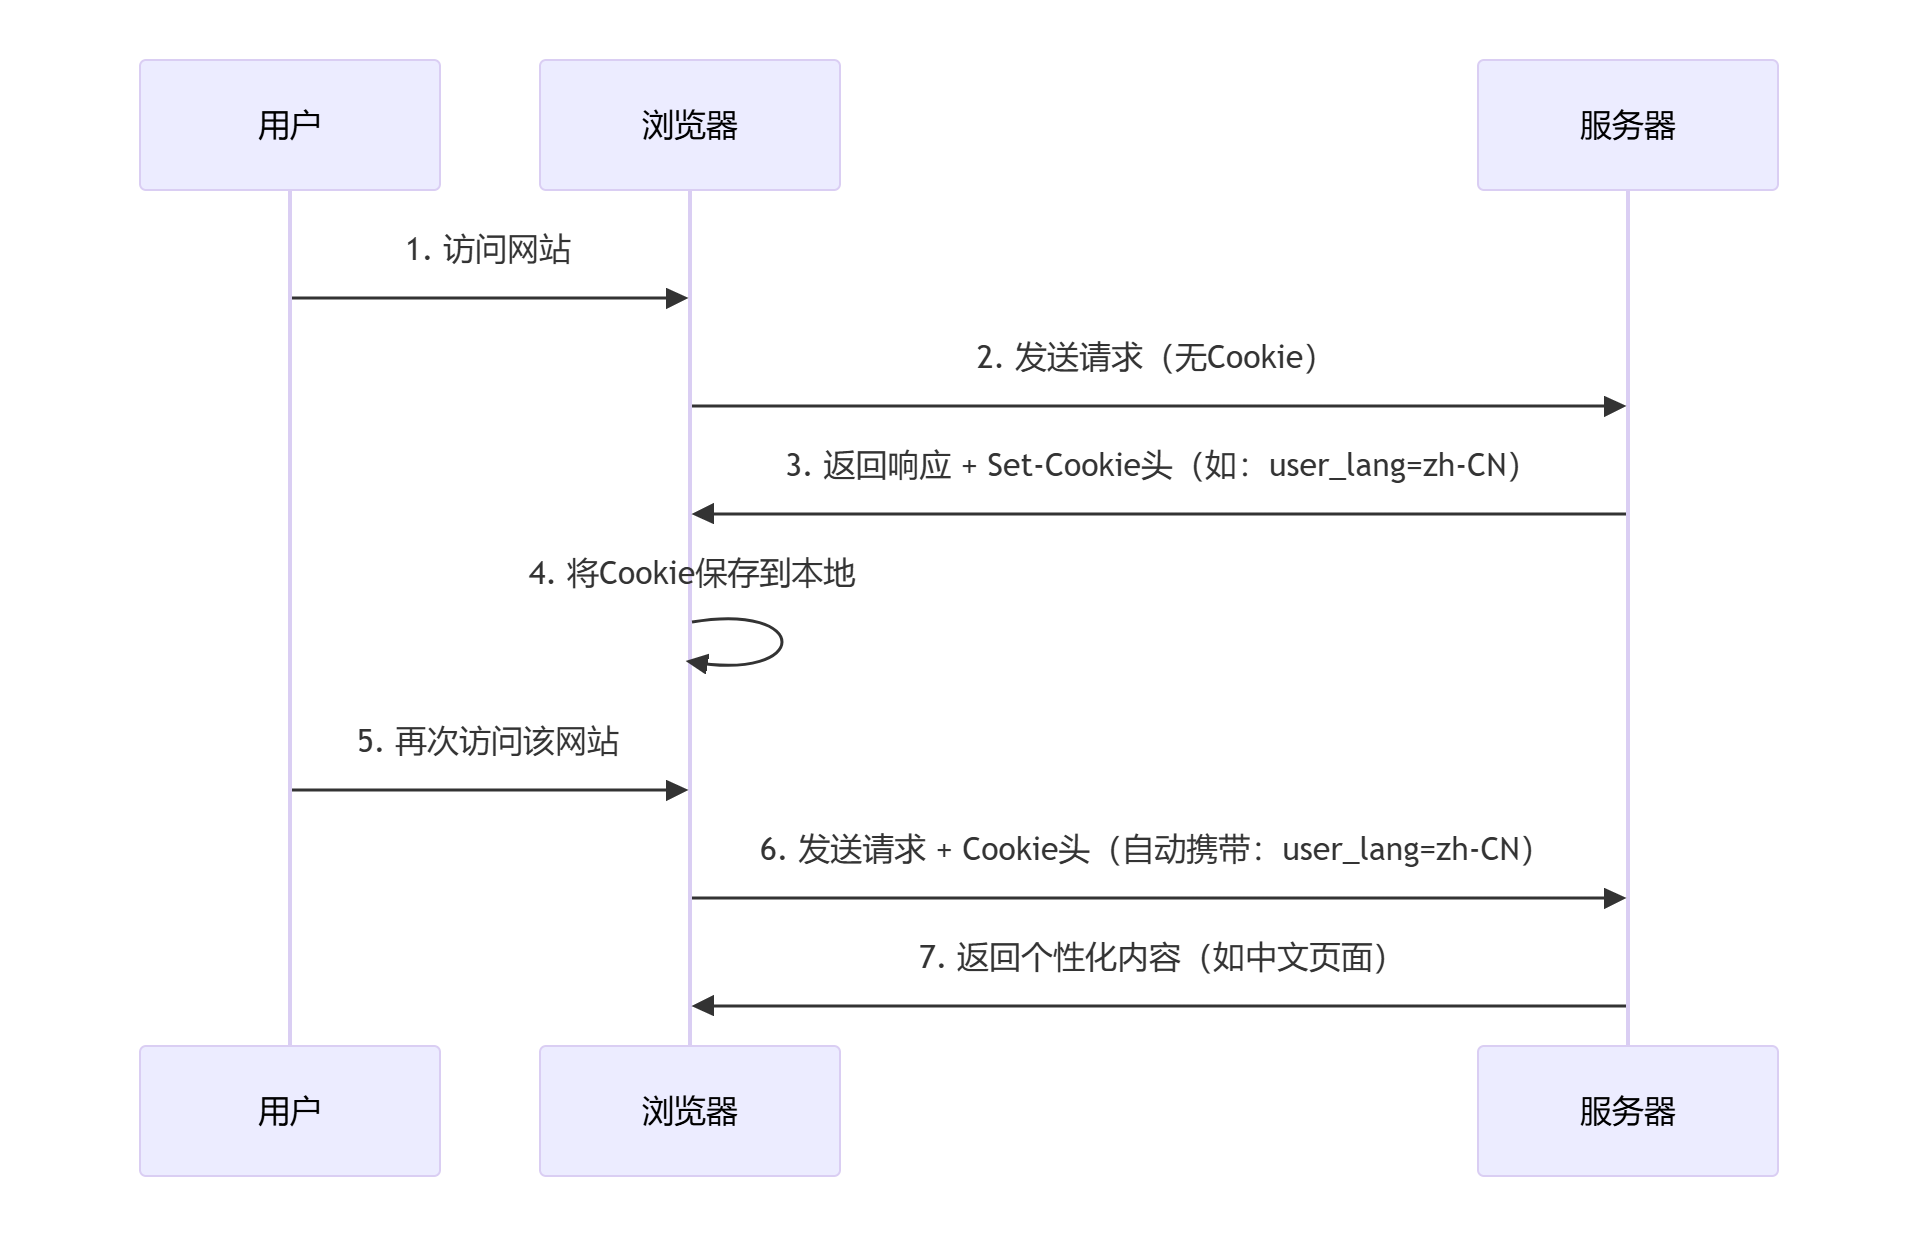
cookie保存在客户端,session保存在服务器端。Cookie存储不敏感、需要长期保留的信息,如用户偏好设置、跟踪ID。Session存储敏感、临时的信息,如用户登录状态、购物车详情。
cookie应用场景:记住登录状态(需结合Session)、记住语言偏好、购物车商品记录、用户行为跟踪。
cookie工作流程
Session 的工作流程(通常基于Cookie)
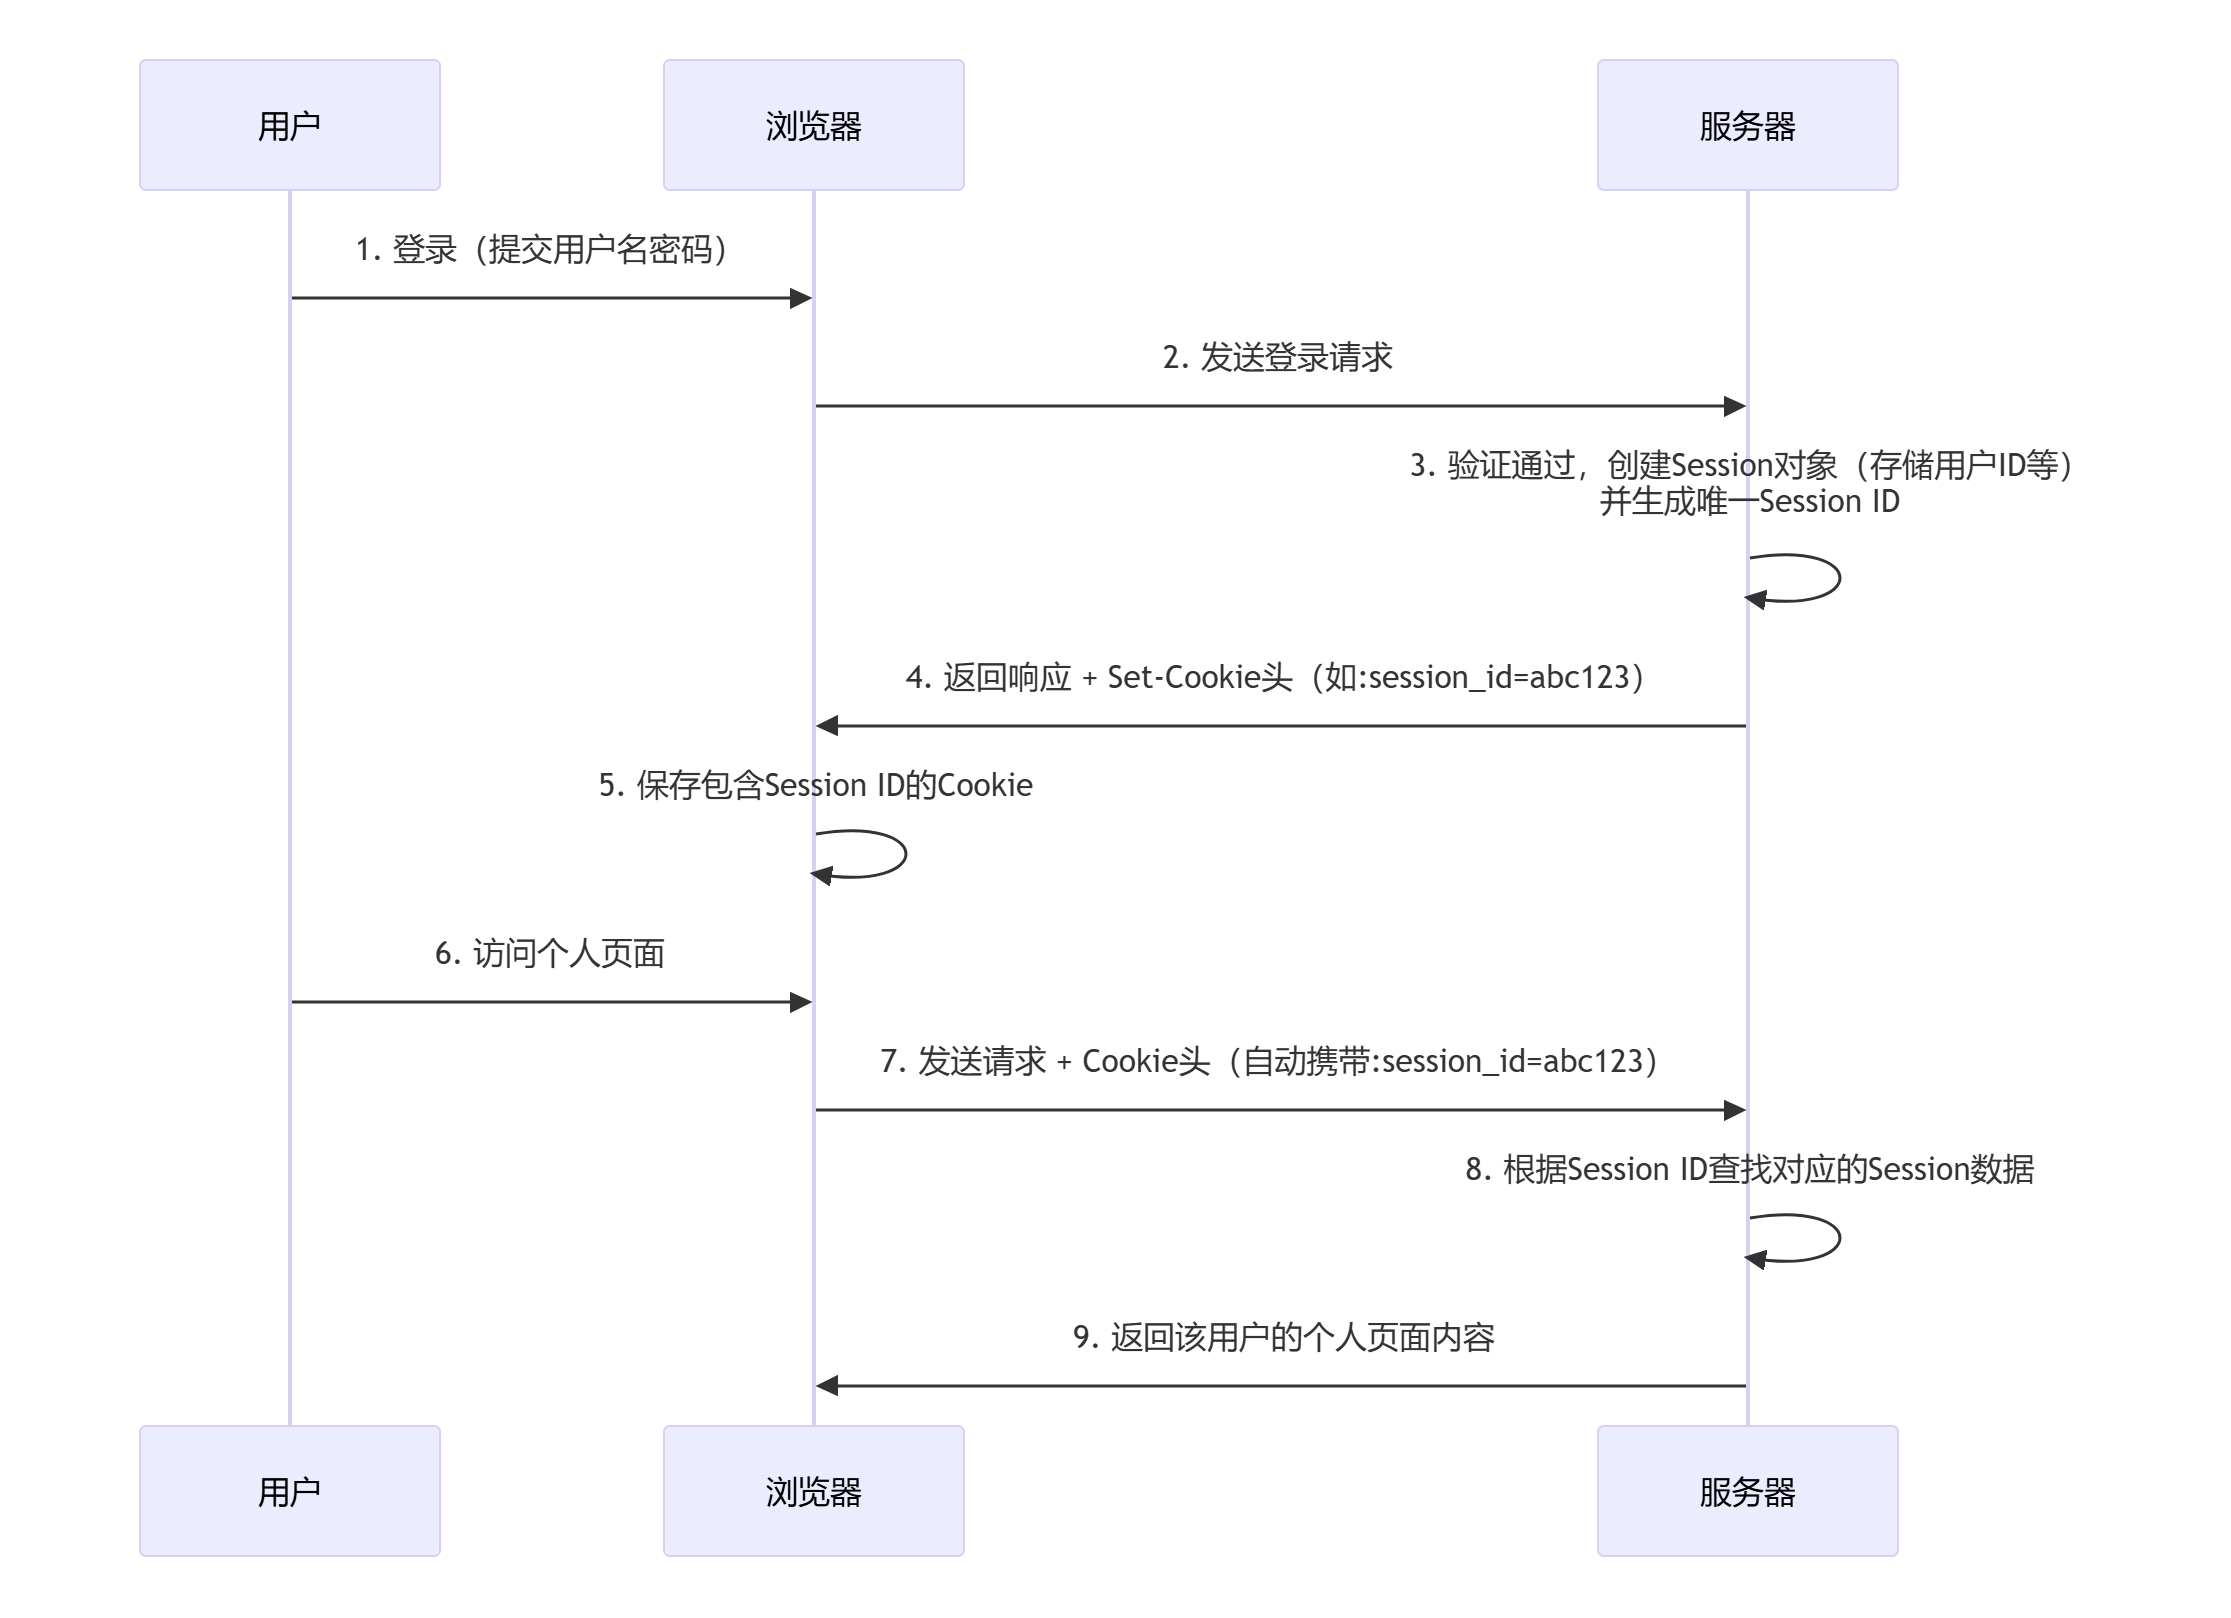
关键点:服务器存储了真实的用户数据(Session Data),而客户端只保存了一个"钥匙"(Session ID)。服务器通过这把"钥匙"来找到对应的数据。
生动的比喻
为了更好地理解,我们可以用一个健身房的场景来比喻:
Cookie:就像健身房发给你的会员卡。
- 卡上可能印有一些基本信息,比如会员类型(VIP/普通)。
- 你每次去健身房都要出示这张卡(浏览器自动发送Cookie)。
- 卡是保存在你自己手里的(客户端存储)。
Session:就像健身房前台的会员档案柜。
- 柜子里存放着你详细的个人信息、消费记录等敏感数据(服务器端存储)。
- 你的会员卡上只有一个卡号(Session ID)。
- 前台人员通过刷你的卡号,才能从档案柜里调出你的完整信息(服务器通过Session ID查找Session数据)
HTTP请求头
HTTP请求头是客户端(如浏览器、你的React Native应用)发送给服务器的一组元数据 ,用于告知服务器关于本次请求的详细信息、客户端的偏好及能力。它们不包含请求的主体数据,但决定了服务器如何处理请求和构建响应。
请求头核心结构与分类
一个标准的HTTP请求如下,其中Host等就是请求头:
GET /api/data HTTP/1.1
Host: api.example.com
User-Agent: MyApp/1.0
Authorization: Bearer xyz123
Accept: application/json
请求头通常分为四大类,下表列出了每类中最常见和重要的头信息:
| 类别 | 作用 | 常见请求头举例 | 说明与示例值 |
|---|---|---|---|
| 常规信息 | 提供关于请求本身的基本信息。 | Host |
必需 。目标服务器域名和端口。 Host: reactnative.dev |
User-Agent |
客户端标识(App名、系统、浏览器)。 User-Agent: MyRN-App/2.0 (iOS 16) |
||
Connection |
控制本次请求后的网络连接状态 。 示例:控制网络连接是否保持。 Connection: keep-alive |
||
| 内容类型 | Content-Type | 声明请求体(Body)的数据格式 。 示例:application/json, multipart/form-data |
|
| 内容协商 | 告诉服务器客户端希望接收什么格式的数据。 | Accept |
期望的响应 内容类型(MIME)。 Accept: application/json, text/html |
Accept-Encoding |
支持的压缩算法(节省流量)。 Accept-Encoding: gzip, deflate |
||
Accept-Language |
期望的响应 语言。 Accept-Language: zh-CN, en-US |
||
| 条件请求 | 使请求有条件,可节省带宽。 | If-None-Match |
配合缓存,如果内容未变则返回304。 If-None-Match: "abc123" |
If-Modified-Since |
如果资源在此时间后未修改则返回304。 If-Modified-Since: Mon, 01 Jan 2024... |
||
| 认证与状态 | 用于身份验证和会话保持。 | Authorization |
极其重要 。携带凭证(如Token)。 Authorization: Bearer eyJhbGci... |
Cookie |
发送服务器之前设置的会话信息。 Cookie: sessionId=abc123 |
||
| 来源控制 | Origin / Referer | 表明请求来自哪个"源"(域名/页面) 。 示例:https://myapp.com |
|
| 自定义业务头 | X- 开头 (如 X-App-Version) |
传递自定义业务信息 。需与后端约定,注意部分代理服务器可能会过滤未知头。 示例:X-App-Version: 2.5.0 |
关键实践建议
-
安全第一 :
Authorization等敏感头信息绝不能硬编码在客户端代码中。Token应从安全存储(如Keychain/Keystore或安全AsyncStorage)中动态读取。 -
正确设置
Content-Type:这通常是一个陷阱 。当你的请求有请求体(body,例如POST、PUT请求)时,必须根据你发送的数据格式正确设置它,否则服务器无法解析。常见的有:-
'Content-Type': 'application/json'(发送JSON字符串) -
'Content-Type': 'multipart/form-data'(上传文件) -
'Content-Type': 'application/x-www-form-urlencoded'(发送表单编码数据)
-
-
善用内容协商 :正确设置
Accept头可以确保你得到期望格式(如JSON)的响应,方便处理。 -
自定义头 :你可以添加以
X-开头的自定义头(如X-App-Version),用于传递业务信息,但注意部分服务器可能过滤未知头。
Referer与Origin请求头
Referer 头主要有两个核心作用:
-
统计分析 :网站管理员可以通过分析
Referer来了解流量来源。例如,知道有多少用户是从搜索引擎、其他网站或社交媒体跳转过来的。 -
防盗链与安全控制 :这是更关键的用途。服务器可以检查
Referer值来判断请求是否来自"合法的"源(自己的网站),如果不是,则可以拒绝访问。常用于:-
图片/资源防盗链:防止其他网站直接链接使用你的图片,消耗你的服务器带宽。
-
防御CSRF攻击:作为一种辅助手段,检查敏感操作(如修改密码、转账)的请求是否来自可信的页面。
-
Referer 与之前提到的 Origin 头密切相关但不同:
-
Origin:用于跨域请求 (如Fetch API发起的CORS请求),它只包含协议、域名和端口 (如https://www.example.com),不包含路径。它更安全,泄露信息更少。 -
Referer:包含完整的来源URL(路径信息)。它更古老,主要用于同源请求或简单的页面跳转。
简单来说,Origin 回答"来自哪个站点? ",而 Referer 回答"来自哪个具体页面?"。
HTTP状态码
概述
| 类别 | 描述 | 常见状态码 | 解释 |
|---|---|---|---|
| **1xx (信息响应)** | 请求已被接收,继续处理。在最终响应之前发送。 | 100 Continue | 客户端应继续发送请求的剩余部分。常用于POST大文件前的确认。 |
| 101 Switching Protocols | 服务器应客户端请求,正在切换协议(如从HTTP切换到WebSocket)。 | ||
| 102 Processing | 服务器已收到请求,但处理尚未完成,用于防止客户端超时。 | ||
| **3xx (重定向)** | 需要客户端采取进一步的操作才能完成请求。 | 301 Moved Permanently | 永久重定向 。请求的资源已被永久移动到新的URL。搜索引擎会更新链接。 |
| 302 Found | 临时重定向。请求的资源临时从另一个URL响应。搜索引擎不会更新链接。 | ||
| 304 Not Modified | 所请求的资源自上次访问后未被修改。客户端应使用本地缓存版本。不返回资源内容,节省带宽。 | ||
| 307 Temporary Redirect | 与302类似,但更严格地要求重定向请求时方法和主体不能改变。 | ||
| 308 Permanent Redirect | 与301类似,但更严格地要求重定向请求时方法和主体不能改变。 | ||
| **4xx (客户端错误)** | 错误似乎由客户端引起。 | 400 Bad Request | 笼统的客户端错误。服务器无法理解请求的语法(如参数错误、格式无效)。 |
| 401 Unauthorized | 未认证。请求需要用户认证。登录失败或未提供凭证时返回。 | ||
| 403 Forbidden | 禁止访问。服务器理解请求但拒绝授权(如用户无权限访问该资源)。 | ||
| 404 Not Found | 资源未找到。服务器找不到请求的资源。 | ||
| 405 Method Not Allowed | 请求行中指定的方法不被目标资源支持(如对只接受GET的接口发送POST)。 | ||
| 408 Request Timeout | 服务器等待请求时超时。客户端可以稍后重试。 | ||
| 409 Conflict | 请求与服务器的当前状态冲突(如更新资源时版本冲突)。 | ||
| 429 Too Many Requests | 用户在给定的时间内发送了太多请求(限流)。 | ||
| **5xx (服务器错误)** | 服务器在处理请求时发生错误。 | 500 Internal Server Error | 笼统的服务器错误。服务器遇到了一个未曾预料的状况,无法完成请求。 |
| 501 Not Implemented | 服务器不支持实现请求所需要的功能(如请求了服务器不支持的HTTP方法)。 | ||
| 502 Bad Gateway | 作为网关或代理的服务器,从上游服务器接收到无效响应。 | ||
| 503 Service Unavailable | 服务器暂时不可用(由于超载或停机维护)。通常,这是种临时状态。 | ||
| 504 Gateway Timeout | 作为网关或代理的服务器,未能及时从上游服务器收到响应。 |
最常用的状态码
| 状态码 | 短语 | 您需要知道的场景 |
|---|---|---|
| 200 | OK | 成功。这是您最希望看到的结果。GET请求成功,POST处理成功。 |
| 301 | Moved Permanently | 永久搬家。网站的某个页面地址永久变更,应更新书签和链接。 |
| 302 | Found | 临时找别人。最常见的是登录后重定向到首页。 |
| 304 | Not Modified | 用缓存就行。浏览器询问资源是否更新,服务器说没变,直接用本地缓存。 |
| 400 | Bad Request | 你发的东西我看不懂。比如提交的JSON格式错误、缺少必要参数。 |
| 401 | Unauthorized | **你是谁?** 需要登录或登录凭证(Token)已失效。 |
| 403 | Forbidden | 我知道你是谁,但你不准进。权限不足,访问被拒绝。 |
| 404 | Not Found | 你要的东西不存在。检查请求的URL是否正确。 |
| 500 | Internal Server Error | 服务器崩溃了。后端代码出现了未处理的异常,是服务器端的问题。 |
| 502 | Bad Gateway | 网关懵了。常见于反向代理(如Nginx)后面的应用服务器(如PHP, Python)挂掉或无响应。 |
| 503 | Service Unavailable | 服务器忙疯了。服务器当前无法处理请求(通常是由于过载或维护)。 |
HTTPS 介绍
什么是 HTTPS
HTTPS 是在 HTTP 上建立 SSL 加密层,并对传输数据进行加密,是 HTTP 协议的安全版。
HTTPS 主要作用
( 1 )对数据进行加密,并建立一个信息安全通道,来保证传输过程中的数据安全 ;
( 2 )对网站服务器进行真实身份认证。
默认 HTTP 的端口号为 80 , HTTPS 的端口号为 443 。
http和https区别
概述
HTTP和HTTPS最核心的区别是安全性 。简单来说,HTTPS = HTTP + 加密 + 认证 + 完整性保护,可以理解为是HTTP的安全升级版。下表清晰地对比了它们的主要区别:
| 对比维度 | HTTP (超文本传输协议) | HTTPS (超文本传输安全协议) |
|---|---|---|
| 协议与端口 | 明文传输协议,默认端口 80 | HTTP over SSL/TLS ,默认端口 443 |
| 安全性 | 明文传输,数据可被窃听、篡改、冒充 | 加密传输,防止窃听、篡改,验证服务器身份 |
| 工作方式 | 直接在TCP连接上传输数据 | 先通过 SSL/TLS层 进行安全握手、交换密钥,再加密传输HTTP数据 |
| 所需证书 | 不需要 | 必须由受信任的机构颁发 SSL证书 |
| URL开头 | http:// |
https:// |
| 对SEO影响 | 谷歌等搜索引擎会降权 | 是现代SEO的基本要求,有利于排名 |
| 性能开销 | 低(无加解密消耗) | 略高(因加解密计算),但现代硬件影响微乎其微 |
| 典型场景 | 内部网络、临时测试、不敏感信息展示 | 所有涉及隐私、登录、支付的网站和应用(如银行、电商、邮箱、你的React Native App API) |
HTTPS如何实现安全?一个简单的比喻
想象你要给朋友寄一封信:
-
HTTP :就像寄一张明信片。邮递员和任何经手的人都能看到内容,甚至可能涂改。
-
HTTPS :就像把信放进一个只有你朋友有钥匙的锁箱里寄出。即使被截获,他人也无法看到或篡改内容,并且锁箱上的特殊封印还能证明这确实是你寄出的。
HTTPS三大核心安全特性
-
加密:通过SSL/TLS协议,对传输的数据进行加密,防止中间人窃听。
-
认证 :通过数字证书,验证你正在通信的服务器就是它声称的那个(例如,确保你访问的是
www.realbank.com,而不是一个假冒网站)。 -
完整性保护:确保数据在传输过程中没有被篡改。
网络通信模型
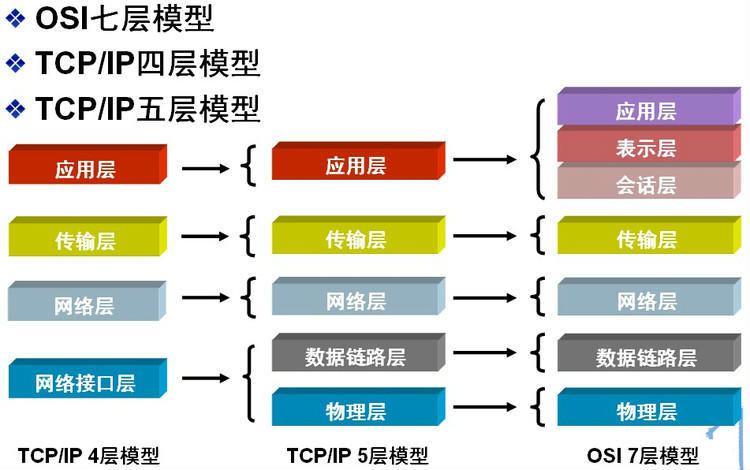
OSI模型是理论标准,而实际广泛应用的是 TCP/IP 模型。它们的对应关系如下:
| TCP/IP 模型 | 对应 OSI 层 | 核心协议 |
|---|---|---|
| 应用层 | 应用层、表示层、会话层 | HTTP, FTP, DNS, SMTP |
| 传输层 | 传输层 | TCP, UDP |
| 网络层 | 网络层 | IP, ICMP |
| 网络接口层 | 数据链路层、物理层 | Ethernet, ARP |
OSI7层模型:应用层,表示层,会话层,传输层,网络层,数据链路层,物理层