在AI技术日新月异的2025年,英伟达与香港大学联合发布了一项令人瞩目的技术突破------Orchestrator-8B,近期在HuggingFace上保持着相当高的热度。
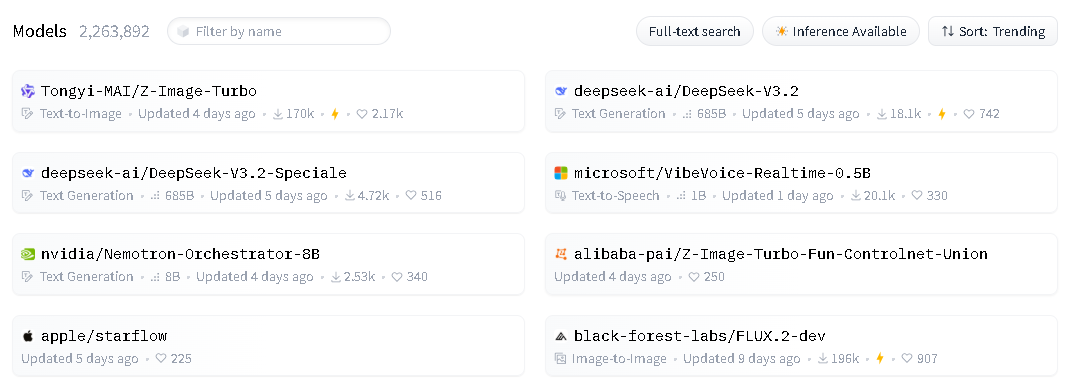
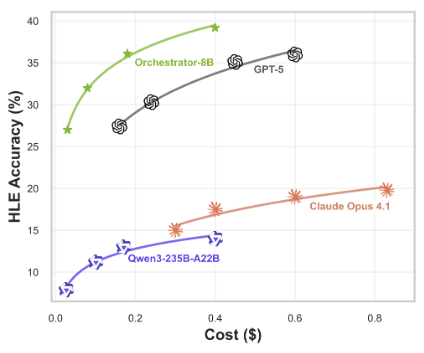
这个只有80亿参数的小型模型,通过巧妙的强化学习训练和工具调度策略,在人类最后的考试(HLE)基准测试中以37.1%的准确率超越了GPT-5的35.1%。Orchestrator-8B的诞生为复杂任务处理提供了更经济、高效的解决方案。
值得注意的是,Ollama平台已提供非官方版本的Orchestrator-8B模型,即"Orchestrator-abliterated" 。该模型通过Sumandora的remove-refusals-with-transformers技术处理,移除了原始模型的内容过滤机制 。根据描述,这是一次"crude, proof-of-concept implementation"(粗糙的概念验证实现),可能未完全解耦审查机制与核心逻辑 。使用该模型时需特别注意以下几点:
- 内容安全风险:移除审查机制后,模型可能生成违反法律法规或伦理的内容,用户需自行过滤和承担责任。
- 功能缺陷风险:非专业修改可能导致模型智能下降,如输出混乱、逻辑错误或常识性错误,具体表现需待社区实测 。
- 工具调用风险:原生Orchestrator-8B的工具调度能力可能因审查机制移除而受到影响,导致工具选择不当或过度调用。
- 稳定性问题:长周期决策可能因审查机制缺失而出现更严重的"漂移"现象,需谨慎测试。
一、背景与核心理念
传统AI代理系统通常依赖单一大型语言模型(LLM)如GPT-5来完成任务,这种架构存在两个致命缺陷:自我增强偏见 和资源错配 。研究表明,GPT-5在工具调用时会过度依赖自身简化版模型(如GPT-5-mini被调用占比高达66%),同时在78%的简单任务中仍会调用顶级模型,造成严重的资源浪费 。
Orchestrator-8B的诞生源于香港大学与英伟达团队对这一问题的深入思考。他们提出,人类在解决复杂问题时,会灵活调用各种外部资源,而AI系统也应该具备类似的能力。与其让单一模型承担所有任务,不如让一个轻量级"协调者"管理多种专门的模型和工具,根据任务需求智能调度资源。这种思路与传统"大模型单打独斗"形成鲜明对比,更像是一个精明的项目经理,知道何时该用什么工具。
香港大学博士苏弘锦(论文一作)和英伟达研究科学家Shizhe Diao(论文共一)领导的团队,基于这一理念开发了ToolOrchestra框架,并通过该框架训练出了Orchestrator-8B 。值得注意的是,Orchestrator-8B并非从头训练,而是基于阿里巴巴达摩院开源的Qwen3-8B模型进行微调 ,这使得模型既能保持一定的通用能力,又能专注于工具调度这一特定任务 。
二、技术架构与创新点
Orchestrator-8B的技术架构包含三个核心组成部分:Qwen3-8B微调 、基于PPO优化的群体相对策略优化(GRPO)算法 和多目标优化机制。
在模型基础层面,Orchestrator-8B采用了参数高效微调(PEFT)技术中的LoRA(低秩适应)方法 。具体来说,研究团队在Qwen3-8B的注意力层引入了两个低秩矩阵(秩r=64,缩放系数alpha=128),仅微调约524万参数(占总量的0.0655%) 。这种方法使得微调过程可以在单卡RTX 4090上完成,显存占用显著降低,同时保持了模型的推理能力 。
强化学习训练是Orchestrator-8B的核心创新。与传统PPO(近端策略优化)不同,研究团队采用了基于PPO优化的群体相对策略优化(GRPO)算法 ,这是一种通过组内相对优势(Advantage)计算来优化模型策略的方法 。GRPO的核心思想是通过组内样本的相对比较替代传统强化学习中的绝对价值估计,从而简化训练流程、提升计算效率并保持策略优化的稳定性 。训练过程中,模型需要同时考虑三个奖励因素:任务成功(二元奖励)、效率(成本和时间)以及用户偏好(如隐私保护、低延迟等)。
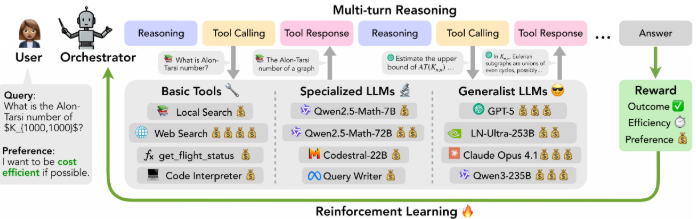
多目标优化机制是Orchestrator-8B的另一大亮点。系统能够根据用户需求动态调整三个奖励的权重 ,而非采用固定的加权策略。例如,当用户强调"省钱"时,效率奖励权重会自动提高;当用户要求"隐私保护"时,系统会优先选择本地工具而非网络搜索 。
工作流程上,Orchestrator-8B遵循三个主要步骤:首先解析用户指令和自然语言偏好(如"优先考虑低延迟"或"避免网络搜索");然后生成推理过程并规划行动;最后从可用工具中选择并以统一的JSON格式发出工具调用 。这一过程可以持续进行,直到任务完成或达到50步的限制。
三、性能表现与基准测试
Orchestrator-8B在多个权威基准测试中表现出色,证明了其作为工具调度模型的有效性。
在**人类最后的考试(HLE)**基准测试中,Orchestrator-8B取得了37.1%的准确率,超过了GPT-5的35.1% 。
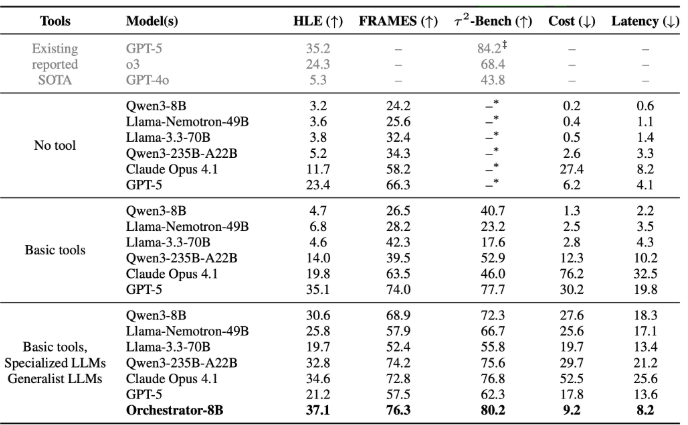
这些测试结果表明,Orchestrator-8B不仅在任务完成质量上优于GPT-5,更在资源利用效率上实现了质的飞跃 。特别是在处理需要多步骤操作的复杂任务时,Orchestrator-8B展现出强大的调度能力,能够根据任务复杂度选择合适的工具组合,避免不必要的资源消耗。
四、开源生态与未来发展方向
Orchestrator-8B的开源是其技术价值的重要体现。项目已在GitHub(https://github.com/NVlabs/ToolOrchestra/)和HuggingFace平台开源,包含完整的模型、代码和训练数据集ToolScale 。ToolScale数据集覆盖金融、医疗、电商等10个领域,包含4063个多轮工具调用任务,为研究者提供了丰富的实验素材 。
开源不仅降低了企业部署门槛,更推动了AI工具调度领域的研究创新。Orchestrator-8B的训练方法(GRPO)和奖励机制设计(多目标优化)为研究者提供了宝贵的参考,有助于构建更智能、更高效的复合AI系统。
需要注意的是,Orchestrator-8B遵循NVIDIA License ,其HuggingFace页面明确标注:"This model is for research and development only " 。这意味着用户在使用Orchestrator-8B时需遵守NVIDIA的专用许可证条款,商业用途前必须联系NVIDIA获取授权,不可直接用于盈利性项目。
未来,Orchestrator-8B的发展方向主要集中在三个方面:
首先是多模态工具整合。当前系统主要处理文本任务,未来可能会扩展到图像、音频、视频等多种模态的工具协调,大大扩展应用范围。
其次是递归协调系统。研究团队展望构建递归的协调系统,即协调员可以调用其他协调员作为工具。这种"俄罗斯套娃"式的架构可能会带来更强大的智能涌现效果 。
最后是实时定价策略优化。随着AI服务市场的动态变化,工具调用成本也会随之波动。未来Orchestrator-8B可能会引入更复杂的成本预测和优化机制,根据实时价格调整工具调度策略 。
五、与同类技术的对比分析
Orchestrator-8B并非工具调度领域的孤例,它与几项相关技术存在显著差异和优势:
与谷歌DeepMind在2023年提出的Toolformer相比,Orchestrator-8B在工具选择的灵活性和多样性上更具优势。Toolformer使用监督学习+自生成数据,让12B参数的模型学会调用计算器、翻译API等基础工具,但未将大模型纳入工具库 。而Orchestrator-8B能够协调GPT-5、Claude Opus 4.1等顶级大模型与专业工具,形成更强大的协同效应 。
与MIT和CMU联合团队的ToolRL相比,Orchestrator-8B的奖励函数设计更为全面。ToolRL侧重于任务正确性和工具调用效率,但未明确纳入用户偏好 。Orchestrator-8B则通过用户偏好奖励机制,使系统能够更好地满足用户的个性化需求。
与香港大学和微软提出的Optimal Tool Calls(OCT)相比,Orchestrator-8B在多目标平衡能力上更为突出。OCT专注于工具调用成本优化,而Orchestrator-8B则同时优化结果质量、效率和用户偏好,形成了更全面的评估体系 。
Orchestrator-8B最大的技术突破在于证明了"小模型+工具调度"架构的有效性 。相比单一大模型,这种架构不仅降低了计算成本,还提高了任务处理效率和准确性。在HuggingFace平台上,Orchestrator-8B获得极高评价,冲入热门模型前五,充分证明了其技术价值和实用潜力 。
六、技术局限性与挑战
尽管Orchestrator-8B取得了显著成就,但仍面临一些技术局限性和挑战:
首先是工具库依赖。Orchestrator-8B的性能高度依赖于可用工具的质量和多样性。如果工具库中缺乏特定领域的专业工具,系统可能无法充分发挥潜力。这要求企业在部署时需要根据自身需求构建合适的工具库。
其次是长周期决策稳定性。虽然Orchestrator-8B支持50步的长周期决策,但随着步骤增加,决策质量可能会逐渐下降。研究团队发现,当步骤超过30后,部分模型会出现"漂移"现象,即决策逐渐偏离最优路径 。如何保持长周期决策的稳定性仍是未来需要解决的问题。
最后是用户偏好量化。用户偏好奖励机制需要将自然语言偏好转化为可量化的奖励信号。目前系统主要通过预设规则实现这一转化,未来可能需要更复杂的机制来处理更复杂的偏好描述。
这些挑战反映了工具调度技术的复杂性,也指明了未来研究的方向。随着技术的不断进步,我们有理由期待更多类似Orchestrator-8B的创新技术出现,进一步推动AI技术的发展和应用。