文章目录
-
- 前言
- Oracle数据库迁移实战
-
- 主要迁移内容
-
- 数据库、用户和模式迁移
- [Oracle 数据迁移](#Oracle 数据迁移)
- 应用程序移植
- 关键迁移步骤
- 迁移评估
- 迁移准备
-
- 准备迁移环境
- [获取 Oracle 数据库的相关信息](#获取 Oracle 数据库的相关信息)
-
- [1. Oracle 数据库基本信息](#1. Oracle 数据库基本信息)
- [2. 查看表数据量大小](#2. 查看表数据量大小)
- [3. 检查数据库日期格式(踩坑高发)](#3. 检查数据库日期格式(踩坑高发))
- [配置 KingbaseES 的 Oracle 兼容开关](#配置 KingbaseES 的 Oracle 兼容开关)
- [配置目的库 KingbaseES 性能参数](#配置目的库 KingbaseES 性能参数)
- 数据库、用户和模式迁移(执行要点)
- 数据迁移
- 在线迁移
-
- 源端数据库备份
- 存量数据迁移(中间库)
- [启动 KFS 完成数据追平](#启动 KFS 完成数据追平)
- 多次迁移
- 应用代码迁移
- ODBC
-
- [Windows 数据源配置](#Windows 数据源配置)
- [Linux 数据源配置](#Linux 数据源配置)
- [移植 Oracle OCI 应用程序](#移植 Oracle OCI 应用程序)
- 其它应用框架
- 测试与调试迁移后的系统
前言
你可能正在被这些"问题词"追着跑:
"能不能不改代码?"、"停机窗口够不够?"、"日期/字符集/NLS 会不会踩坑?"、"大表怎么迁更快?"、"离线还是在线追平?"
这篇内容不讲概念,按项目推进顺序,把 Oracle → KingbaseES 的关键步骤、典型风险点和工具操作路径串起来,方便你直接照着落地。
Oracle数据库迁移实战
KingbaseES 内部提供了大量 Oracle 兼容特性,因此在实际迁移过程中,一般只需对导出脚本做很少的修改,甚至在迁移对象功能全兼容的情况下可以不做任何修改。不仅如此,用户还可使用 KDTS、KFS 等多种工具简化迁移过程。
本节重点描述将实际应用中使用的 Oracle 数据库迁移至 KingbaseES 数据库的完整过程,以及其中的主要迁移内容和关键迁移步骤。
主要迁移内容
在实际应用中,Oracle 数据库的迁移包含数据库迁移、用户迁移、数据迁移和应用程序迁移,这些内容必须严格按照顺序进行迁移,否则可能会导致迁移受阻。
数据库是各种 SQL 和 PL/SQL 数据库对象的存放容器,用户是这些对象的管理者和使用者。因此,在进行数据迁移前,必须先迁移数据库、用户。
迁移应用程序前,需检查数据库对象迁移是否完成,完成后才能开始迁移应用程序,因为在应用程序中,可能会访问和操作前面迁移的数据库对象。
数据库、用户和模式迁移
启动目标数据库后,在目的数据库 KingbaseES 上创建与源数据库 Oracle 同名的数据库、用户,并授予新建用户使用该数据库和新建模式的权限。
另外,所创建数据库的字符集应与 Oracle 数据库字符集一致。如果 KingbaseES 已有同名数据库,则登录该数据库后,只需创建同名用户。
Oracle 数据迁移
确定使用在线迁移还是离线迁移,根据不同需要制定不同的迁移策略,使用 KDTS 和 KFS 完成数据库迁移。
应用程序移植
应用程序移植是指将 Oracle API 方式或嵌入式 SQL 方式的应用程序迁移至 KingbaseES。它主要包括接口驱动程序和连接方法的迁移,以及 Oracle 扩展或私有的、且 KingbaseES 未兼容的 API 迁移。通常,该项任务的工作量较少。
在实际应用中,应用程序迁移与移植系统测试与调试通常交叉进行。
关键迁移步骤
应用系统从 Oracle 数据库迁移至 KingbaseES 数据库需要健全的项目团队和全面细致的项目执行过程。通常,将一个 Oracle 数据库迁移至 KingbaseES 主要包括迁移评估、迁移准备、数据迁移、应用迁移和测试与调试迁移后的系统 5 个步骤。
迁移评估包含确定迁移目标、评估迁移任务、组建迁移团队三个阶段,迁移准备需要准备好迁移环境并进行数据库和用户迁移。
下面分别对上述各个步骤进行详细说明。
迁移评估
确定迁移目标
开始迁移前,应根据用户的实际需求,确定迁移目标。这些目标诸如:
- 迁移 Oracle 数据库的规模。
- 迁移 Oracle 数据库对象的种类和特征,如简单和复杂迁移对象所占比例等。
- 迁移的难易程度,如是否迁移大对象,是否迁移大量约束等。
- 迁移的工期要求。
- 迁移中业务系统是否可以处于停止服务状态。
- 对目标系统的技术指标要求,诸如平台、版本、应用编程接口、工具、可用性、安全性和性能指标要求等。
明确迁移目标以后,即可开始迁移任务评估。
评估迁移任务
迁移前对迁移的可行性、工作量、难易程度和工作进度等进行充分评估是为了降低迁移过程中的未知风险。通常,迁移评估主要包括以下内容:
- 迁移技术指标,如迁移业务压力和性能指标等。
- 迁移数据规模,如迁移各类数据库对象的数量,PL/SQL 程序的规模等。
- 迁移中 KingbaseES 不支持功能的种类和数量。
- 迁移的约束种类和数量。
- 迁移过程中可能遇到的其他问题。
在 Oracle 迁移中常用的评估模板如下表所示:
| 项目 | 描述 |
|---|---|
| Oracle 数据库版本 | 8.1.7.4 |
| 操作系统版本 | Windows 2000/2003 Server |
| 服务器型号 CPU配置 内存(RAM) 磁盘(Disk Profile) | 联想/SUN |
| 服务器个数(# of Servers) | 1或2 |
| 用户数/天(# Users/Day) 事务量/天(# Transactions /Day) | 几十/天 |
| 当前数据库大小 数据库增长速率(#GB/month)目标用户(Schema) | 几个GB |
| 应用方式(OLTP/OLAP) | OLTP |
| 应用服务器(中间件) | 无 |
| 客户端应用类型 (C/S,B/S) | C/S |
| 客户端应用编程语言 | Delphi7 |
| 客户端应用连接接口 | ODAC/ADO |
| 是否深入SQL应用 | 无 |
| 监控工具 | 无 |
| 备份方式 | Exp/imp |
| 其它工具(备份软件等) | 无 |
| 高可用要求 | 较高 |
| 高可用配置方案 | VCS或单机 |
| 项目 | 描述 |
|---|---|
| 迁移分析日期 | 20220105下午 |
| 迁移分析人员KingbaseES版本 | ABC |
| Oracle 版本 OracleSchema | 11.1.7.4 |
| Oracle DB Size (GB) | 几个GB |
| Oracle Schema Size (MB) | 几个GB |
| 类型 | 小计 | 备注 |
|---|---|---|
| Function | 7 | 较少用 |
| Index | 有 | |
| LOB | 有 | 最大到几十MB,主要是照片、word、视频(较少) |
| Materialized View | 有>10 | |
| Procedure | 25 | |
| Sequence | 有>10 | |
| Table | 1660 | 约束较多 |
| Table Partition | 无 | |
| Trigger | <30 | |
| JOB | 无 | |
| Package | 无 | |
| Package Body | 无 | |
| Type | 无 | |
| View | >200 | |
| Synonym | >300 | |
| 对象共计 |
| 类型 | 小计 | 备注 |
|---|---|---|
| CHECK OR NOT NULL | ||
| FOREIGN KEY | ||
| PRIMARY KEY | ||
| UNIQUE KEY | ||
| OTHER | ||
| 约束共计 |
| 特性 | 小计 | 备注 |
|---|---|---|
| 数据压缩 | 无 | |
| 索引组织表 | 无 | |
| 维度(Dimensions) | 无 | |
| 物化视图 | 无 | |
| 存储概要 | 无 | |
| 高级队列 | 无 | |
| 空间数据管理 | 无 | |
| 全文搜索 | 无 | |
| 数据库链接 | 无 | |
| 数据复制 | 无 | |
| RAC | 无 | |
| 逻辑Standby | 无 | |
| 物理Standby | 无 | |
| 自动存储管理 ASM | 无 | |
| 自动工作负载信息库 AWR | 无 | |
| 共计 |
组建迁移团队
Oracle 数据库迁移团队的成员至少应具备以下的知识与技能:
- 熟悉 Oracle 和 KingbaseES 的 SQL 语言和 PL/SQL 语言特性,以及相关的 KingbaseES Oracle 兼容特性。
- 熟悉 Oracle 和 KingbaseES 的各种应用编程接口,以及相关的 KingbaseES Oracle 兼容特性。
- 熟悉 Oracle 和 KingbaseES 的相关客户端工具,以及这些工具间的相同点和异同点。
迁移准备
准备迁移环境
在完成迁移评估后,迁移工程师需要开始准备迁移环境,这些准备工作诸如:
部署目的数据库服务器
部署目的数据库服务器应遵循以下原则:
- 目的数据库服务器的 CPU、内存、网络环境等硬件应尽量采用较高的配置。
- 如果需要迁移的 Oracle 数据库系统规模较大,如超过 1GB,则建议把 Oracle 和 KingbaseES 部署在不同的物理机器上。
- 为确保迁移效率,应尽量把 KingbaseES 和 Oracle 服务器部署到同一局域网内。
获取并安装必要的软件
迁移前应获取并安装如下软件:Oracle 数据库系统、KingbaseES 数据库系统、PL/SQL Developer、JDBC 和 ODBC 驱动程序、C 语言开发工具、OCI 软件、DCI 软件、TPC-C 测试工具、LoadRunner 等。
如果迁移数据规模较大,建议对安装的 KingbaseES 数据库服务器进行适当的优化,如增大 shared_buffer 大小、预先创建较大的日志文件,预先申请足够的表空间数据库文件等。
完成上述准备工作后,迁移工程师便可开始 Oracle 数据库迁移工作了。
获取 Oracle 数据库的相关信息
迁移前,应获取源数据库 Oracle 服务名及迁移的数据规模信息。其中,前者用于 PL/SQL Developer 工具的登录操作,后者用于估算数据迁移时间和设计迁移方案。
1. Oracle 数据库基本信息
获取源 Oracle 数据库的:
- IP 地址
- 实例名
- 网络服务端口号
- 用户名/密码
在目标 KingbaseES 上:
- 创建与源 Oracle 用户(如 scott)同名的用户(scott)。
- 创建与源 Oracle(如 ORCL)同名的数据库(ORCL),属主为 scott。
- 创建与源 Oracle(与用户名相同)同名的模式 scott,属主为 scott。
- 查询 Oracle 数据库编码方式
sql
select userenv('language') from dual;
-- 示例输出:
-- SIMPLIFIED CHINESE_CHINA.ZHS16GBK
2. 查看表数据量大小
查看当前用户在 Oracle 中的表大小,按从大到小排序(单位 GB)。
sql
select segment_name,bytes/1024/1024/1024
from user_segments
where segment_type='TABLE'
order by bytes desc;
示例输出:
text
XFJXX 16.046875
XFRXX 7.779296875
PCK      7.4375
BLFSXX   5.0625
XFSXXX   2.3125
DFGZXX   1.3359375
FJB      0.53125
TSJXX 0.078125
3. 检查数据库日期格式(踩坑高发)
时间的默认格式为:ISO, MDY
在配置文件中添加:datestyle ='ISO,YMD' 修改为年月日的格式(99会改为1999)
在某项目中迁移数据时遇到:服务器报错,迁移工具中断,迁移停滞
Oracle 数据库中有日期 "0099-09-30 00:00:00",迁移工具输出为 "99-09-30 00:00:00",KingbaseES 中将 99 识别为月份报错:ERROR: date/time field value out of range
sql
-- 即使没有报错也会出现错误
set ora_date_sytle = true;
CREATE TABLE T_DATE(COL DATE);
INSERT INTO T_DATE VALUES('11-10-10 10:10:10');
SELECT * FROM T_DATE;
配置 KingbaseES 的 Oracle 兼容开关
根据实际情况,应对目的数据库 KingbaseES 进行适当的 Oracle 兼容配置。通常,应配置以下会话级兼容参数:
1)nls_length_semantics
设定 char 类型字段默认单位是 byte 还是 char。此外,标识符最大长度以此值为单位。如果它为 char,则标识符最大长度为 63 个 char,否则为 63 byte。
在 KingbaseES 系统参数 nls_length_semantics 缺省值是 "CHAR",需要与待迁移的 Oracle 相同。
Oracle 字符类型的 byte|char 属性的默认值是由 Oracle 提供的数据库参数 NLS_LENGTH_SEMANTICS 决定的,可通过下方语句进行查询:
sql
select value
from nls_database_parameters
where parameter = 'NLS_LENGTH_SEMANTICS';
示例输出:
text
VALUE
BYTE
如果未修改可能会出现:迁移 char 类型时,由于数据库存储的类型不同,导致迁移的数据存在多余空格的情况。
2)search_path
模式搜索路径。例如 search_path 为 $USER,SCOTT,PUBLIC 时,系统将首先搜索与登录用户同名的模式对象,然后搜索 SCOTT 模式对象,最后搜索 PUBLIC 模式对象。
3)default_with_oids
OID 伪列开关。KingbaseES 的 OID 伪列可兼容 Oracle 的 ROWID 伪列。因此,如果 Oracle 迁移对象有 ROWID 伪列,则建议用 OID 伪列替代。
配置目的库 KingbaseES 性能参数
为了提高迁移速度,应对目的库 KingbaseES 进行性能优化配置。例如:
-
根据迁移数据规模的大小,迁移前可预先创建适当大小的数据和日志文件。
开始迁移之前根据待迁移数据库的大小,保证 KingbaseES 数据目录所在位置有足够的空间。
-
根据 KingbaseES 服务器硬件配置的实际情况调整 shared_buffers 大小,默认是 128M,建议调整为内存的 1/4 大小。
数据库、用户和模式迁移(执行要点)
数据库、用户迁移主要包括以下内容:
- 获取源 Oracle 数据库的 IP 地址、实例名、网络服务端口号、用户名/密码等信息。
- 在目标 KingbaseES 数据库上,使用 Ksql 或 Kstudio 工具执行如下操作:
- 创建与源 Oracle 用户同名的用户,例如创建与 Oracle 同名的 scott 用户。
- 创建与源 Oracle 同名的数据库,例如创建与 Oracle 同名的 ORCL 数据库,它的属主为 scott。若同名数据库存在,可以使用其他的数据库名称;若使用了新的数据库名称,则需要修改应用程序的连接串中的数据库名称。
- KingbaseES 默认 initdb 就是 Oracle 兼容模式。
数据迁移
Oracle 向 KingbaseES 进行数据迁移需使用以下工具:
- KingbaseES 数据迁移工具 KDTS:动态加载待迁移的数据库访问接口,方便用户按需指定和使用。异构数据源之间的数据迁移:支持 Oracle 9i、10g、11g、12c、19c 到 KingbaseES 的数据迁移。
- KingbaseES 数据同步工具 KFS:支持同、异构数据源之间的数据迁移;支持结构迁移、支持全量数据迁移、支持列名映射,支持数据迁移过滤;配置数据任务时可对迁移表配置 where 条件过滤需要迁移的数据。
一般而言,不同的迁移方式需要用到不同的迁移工具:
- 离线迁移:使用 KDTS 即可完成 Oracle 的完整迁移。
- 在线迁移:先使用 KDTS 完成历史状态迁移,然后使用 KFS 完成数据的在线追平。
下述分别介绍使用离线迁移方式和在线迁移方式迁移数据的步骤:
离线迁移
用户可使用 KDTS 进行数据离线迁移。KDTS 提供两种形态(WEB、SHELL),可根据需要选择。以下分别介绍 WEB、SHELL 版本进行 Oracle 迁移的具体步骤。
WEB 迁移步骤
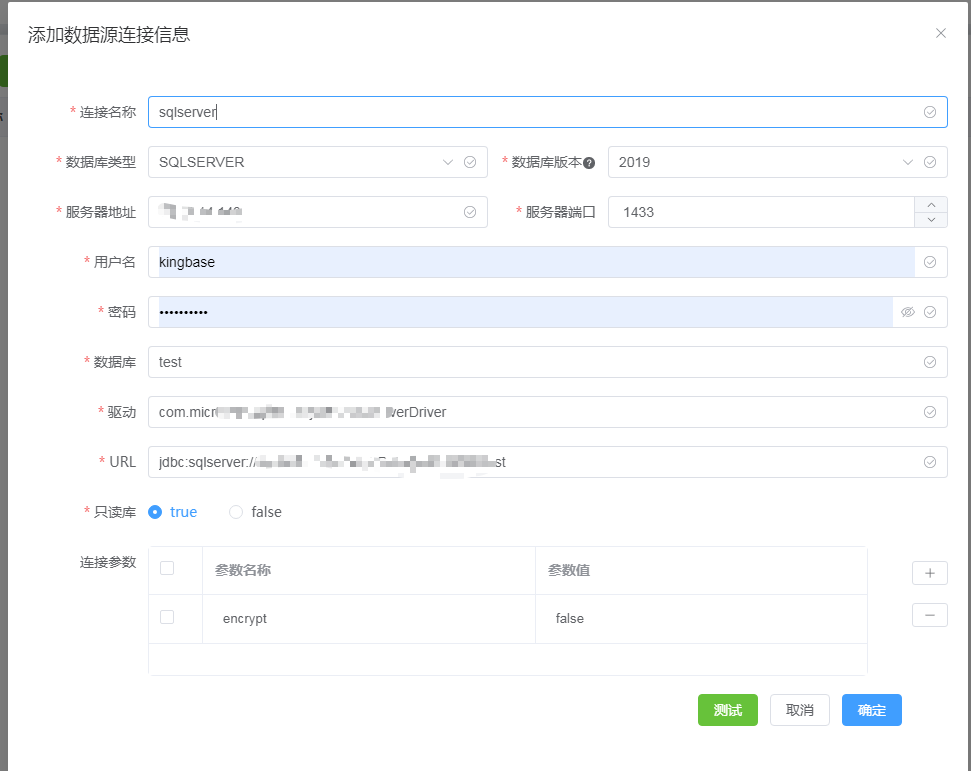
创建源数据库连接
创建数据库连接界面如下,填写数据源信息,包括:
"连接名称"、"数据库类型"、"数据库版本"、"服务器地址"、"端口"、"用户名"、"密码"、"数据库"、"连接参数"。
创建目标数据库连接
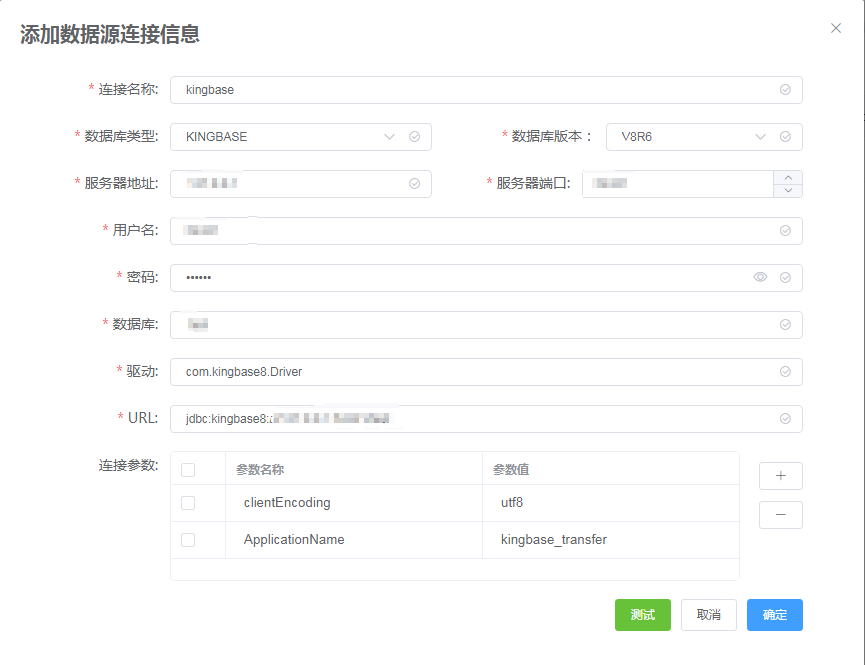
创建数据库连接界面如下,填写数据源信息,包括:
"连接名称"、"数据库类型"、"数据库版本"、"服务器地址"、"端口"、"用户名"、"密码"、"数据库"、"驱动"、"URL"、"连接参数"。
新建迁移任务
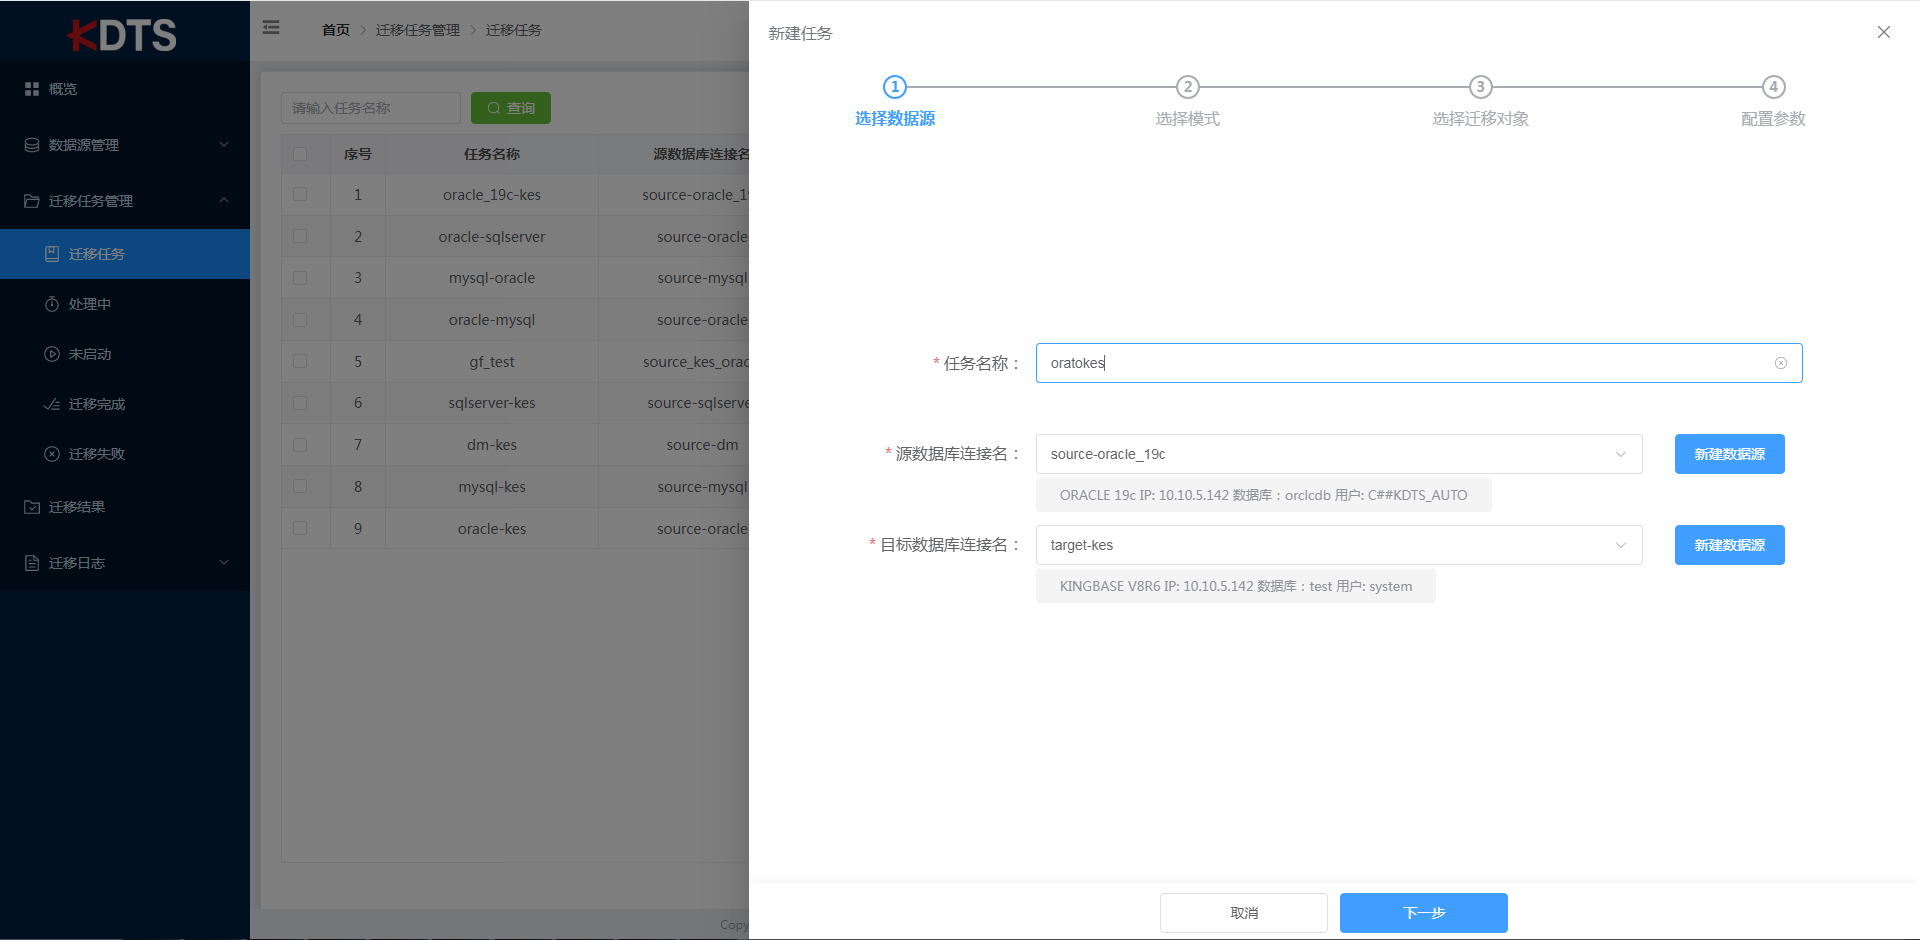
KDTS 采用向导页方式指导用户新建迁移任务,用户依次配置"选择数据源"-"选择模式"-"选择迁移对象"-"配置参数",即可快速配置一个迁移任务。
1)选择数据源
填写自定义任务名称(任务名称不能重复),选择"源数据库"和"目标数据库",或者选择"新建数据源"后使用。
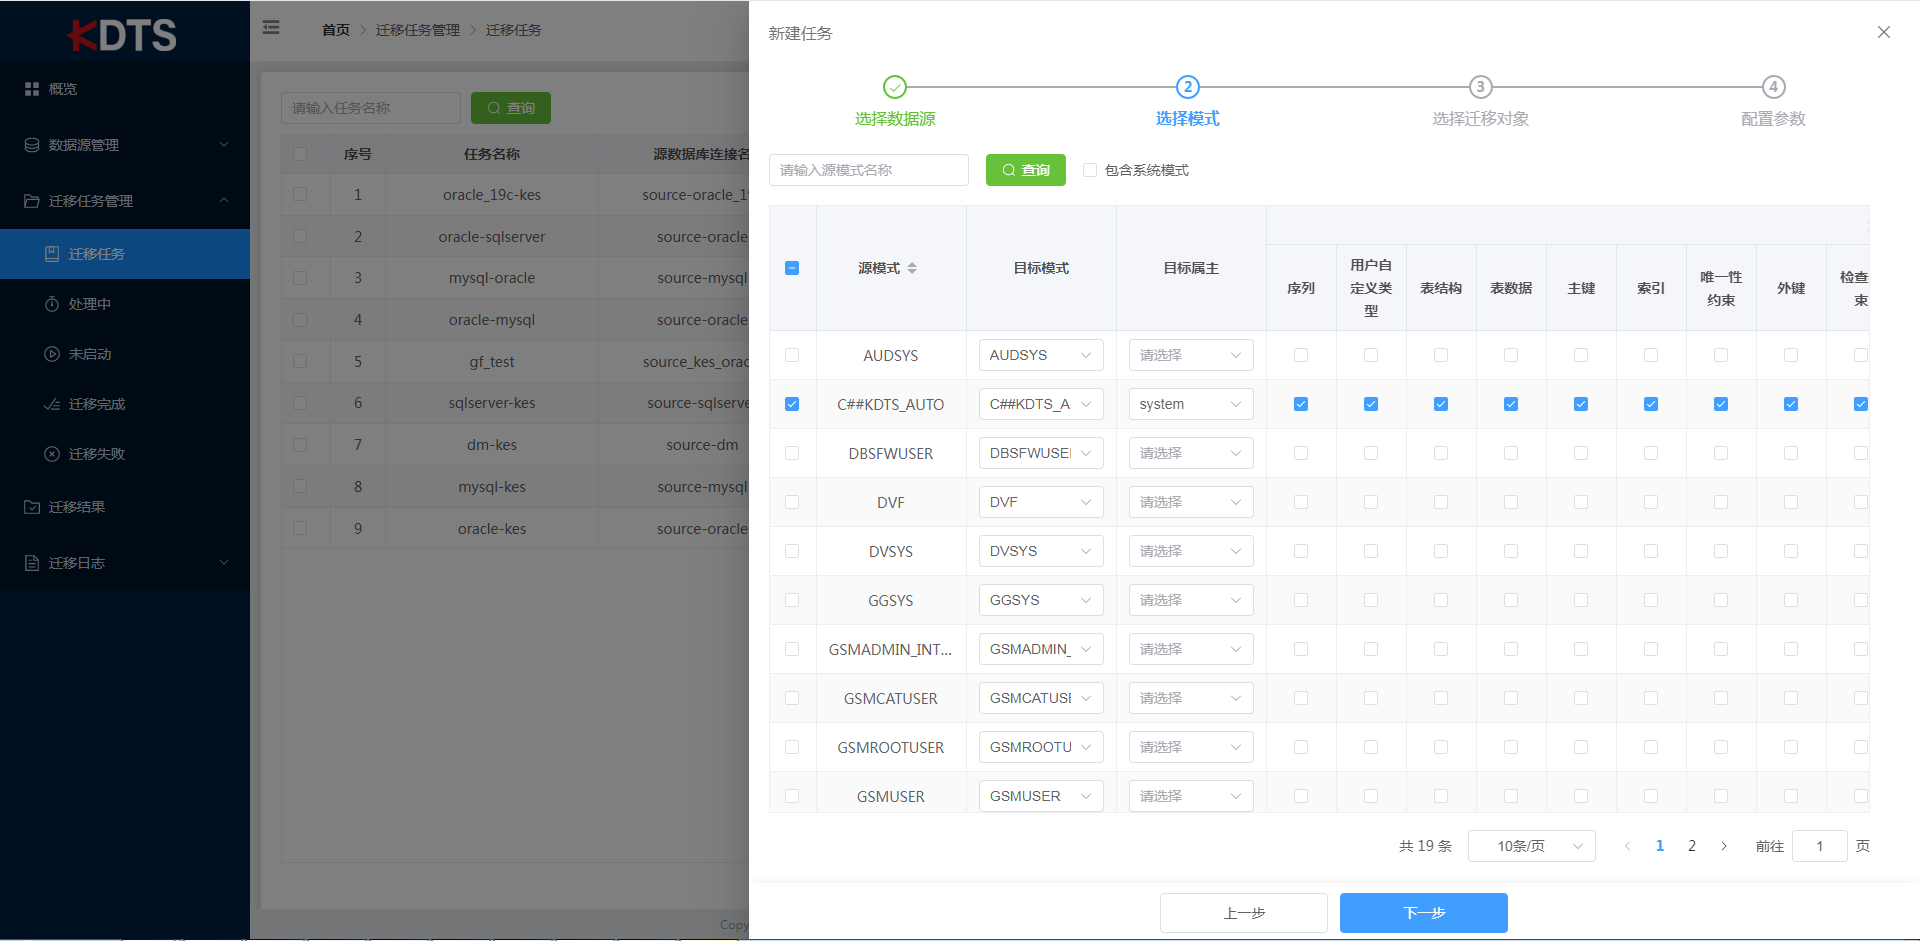
2)选择模式
选择需迁移的模式(如需选择模式在系统模式中可选中"包含系统模式"复选框)的表、视图、序列、函数、存储过程、程序包、同义词。模式较多时可通过左上方查询框检索。请至少选择一种模式,否则将收到错误提示,以至于不能完成新建任务。
3)选择迁移对象
通过已选模式选择需要迁移数据的表。模式较多时可在已选模式搜索框输入模式名关键字进行快速检索。
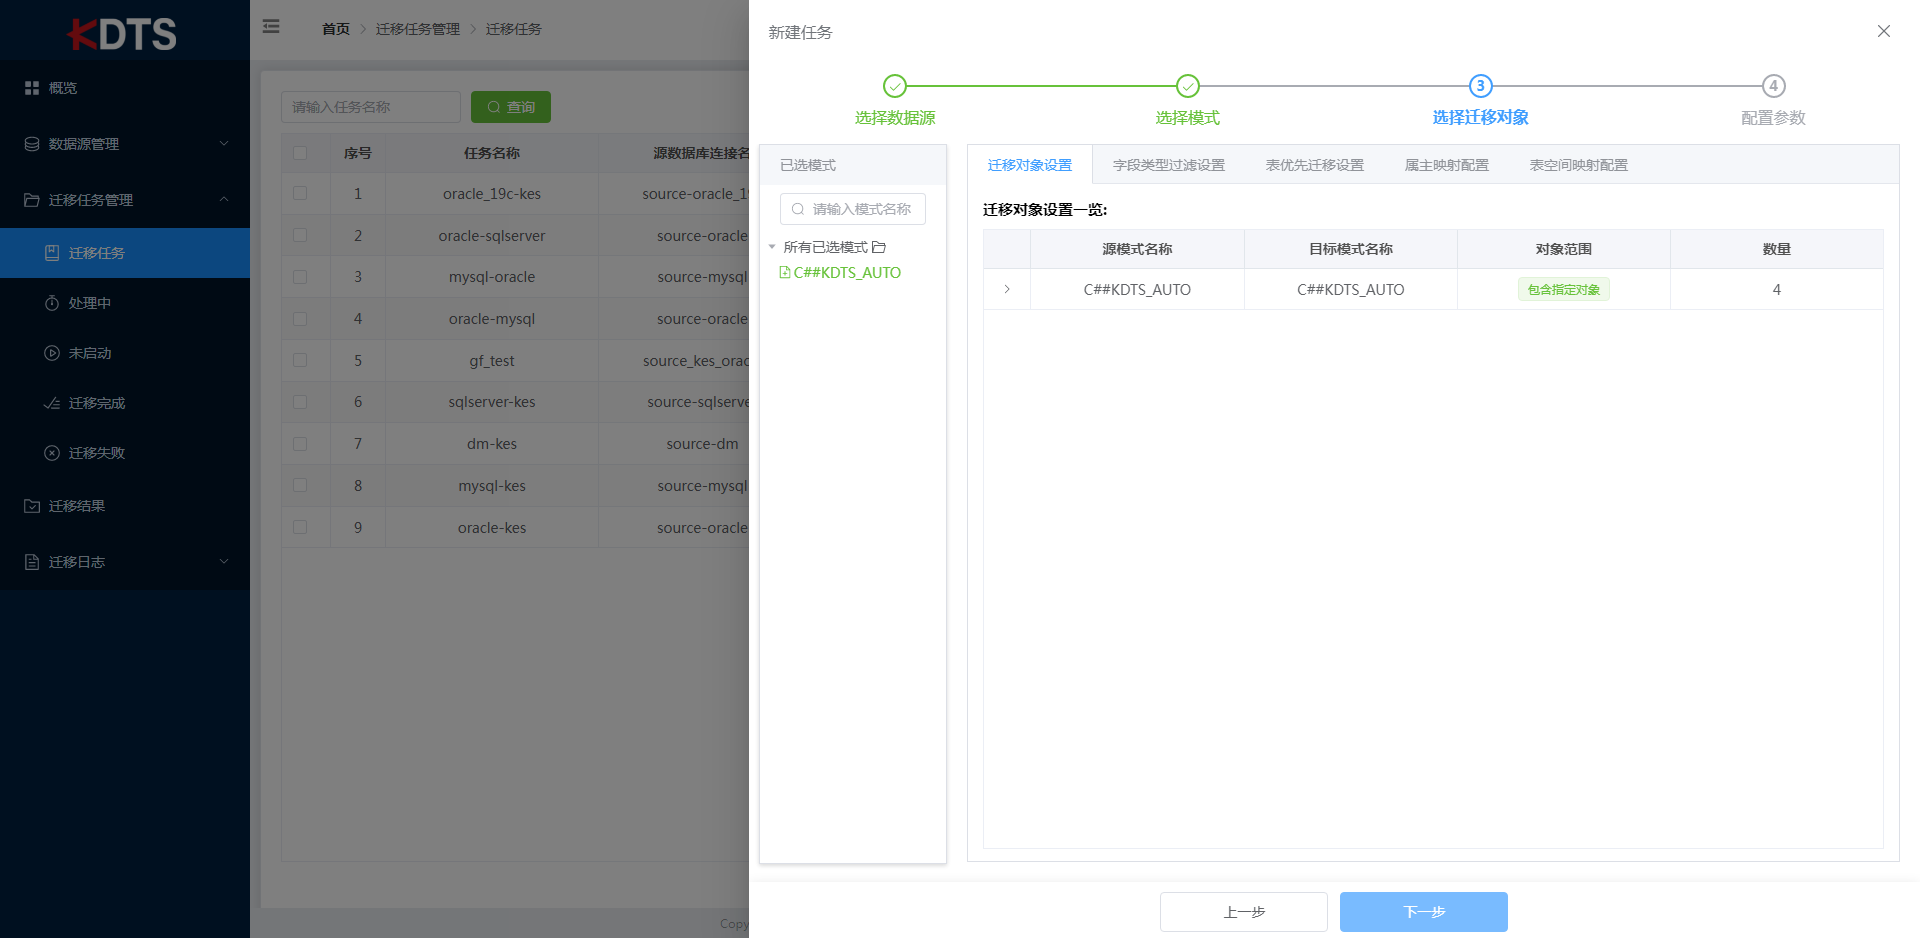
可迁移此模式下全部表,也可以指定或排除部分表。当选择"包含指定表"或"排除指定表"时,请通过"从列表选择"、"从文件导入"或者在输入框内输入表名将数据添加到包含列表中,若未添加数据,则会提示错误导致无法进行下一步并完成新建任务。
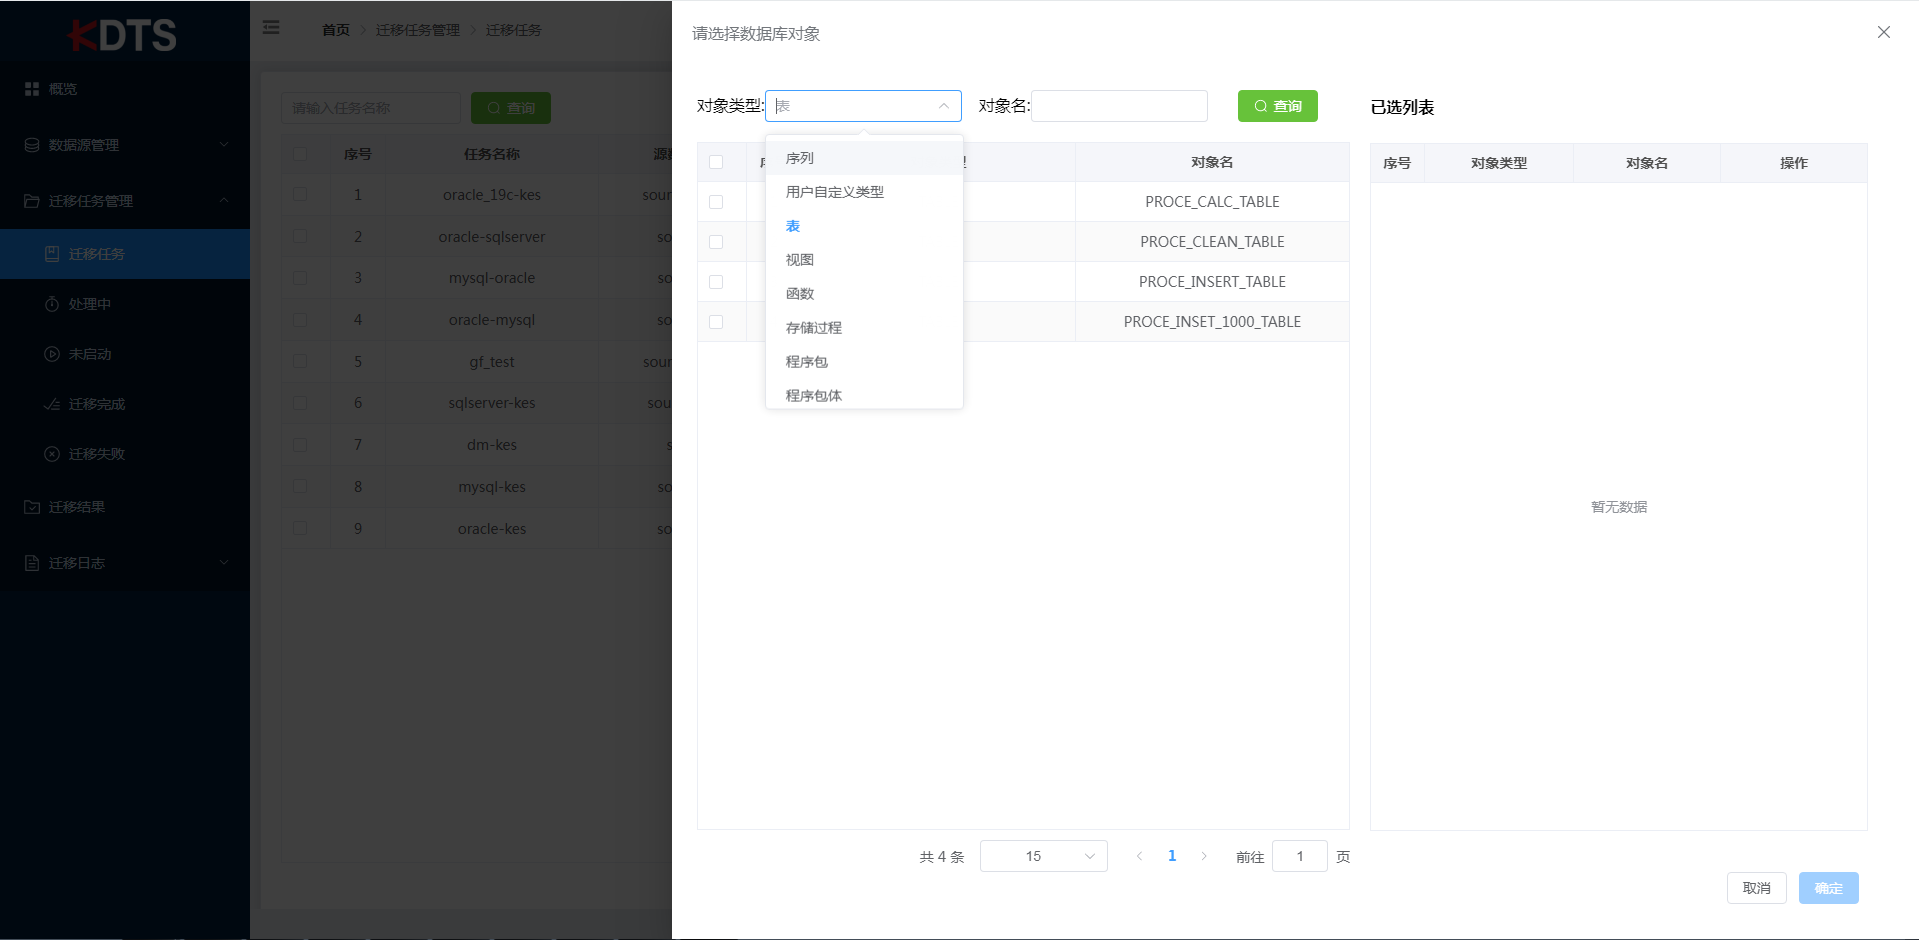
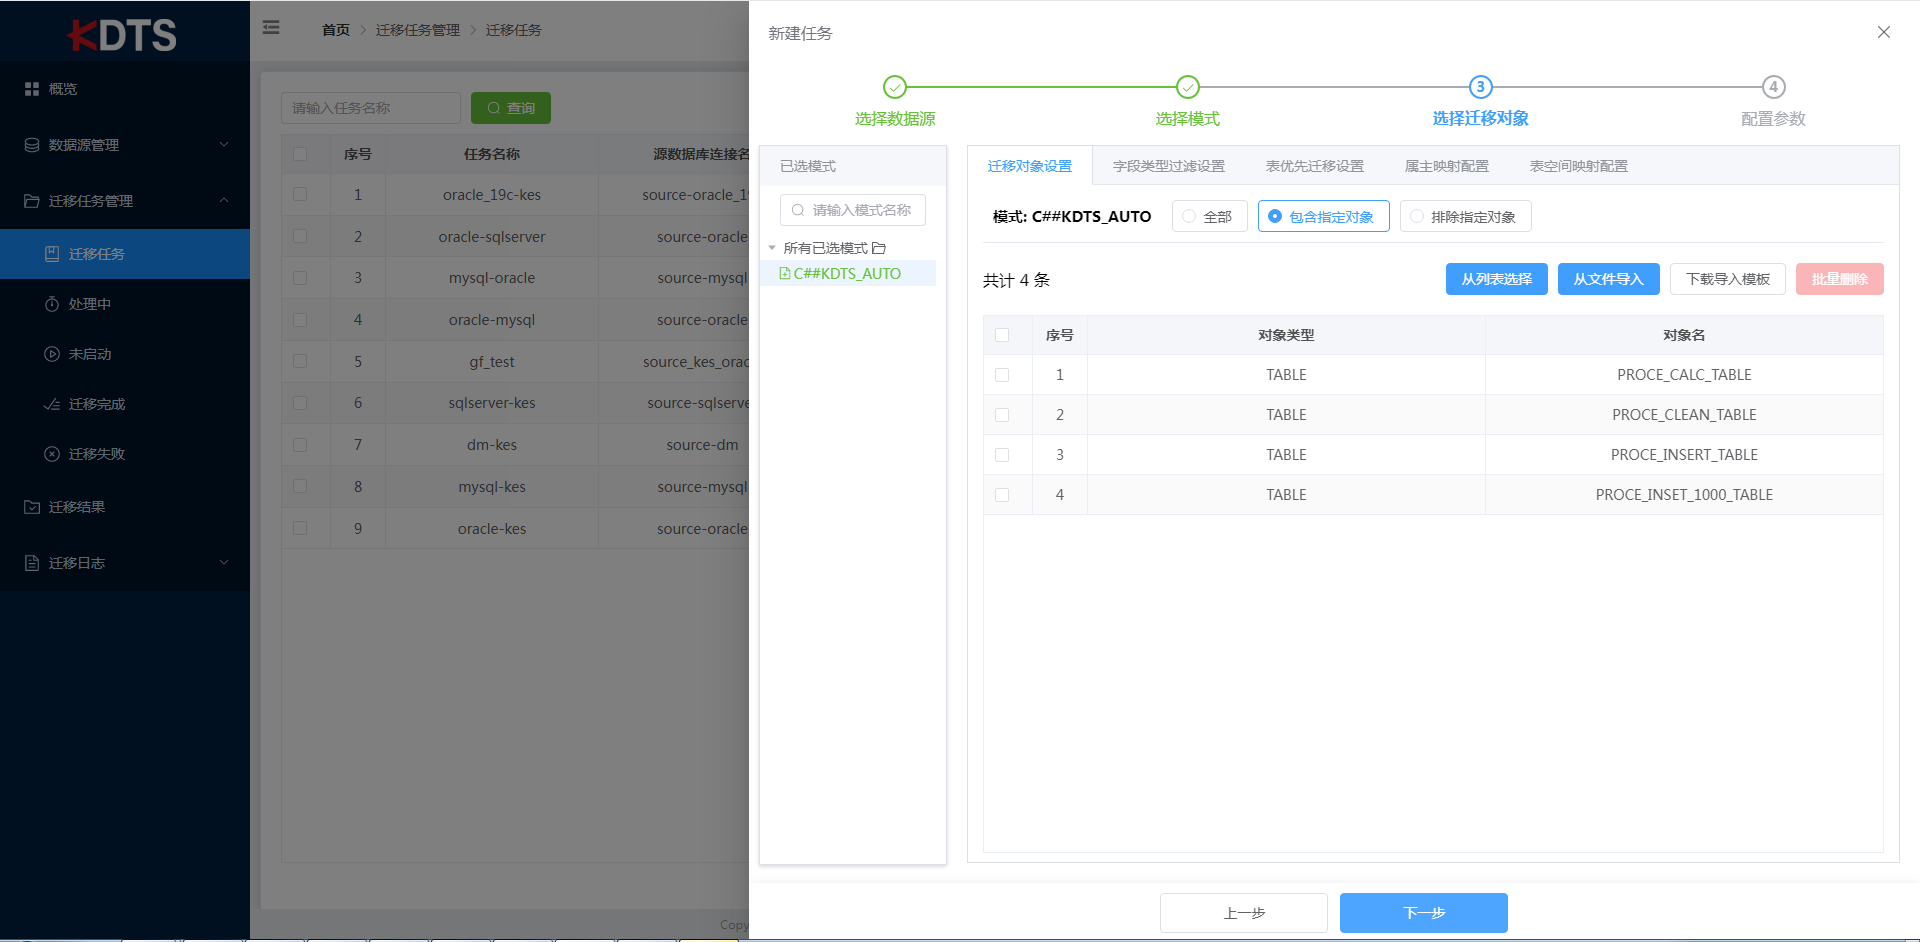
点击"包含指定表"时也可选择多种方式:
- 输入框内填写表名,多个表用","分割,回车确认
- "从列表选择"在模式中选择指定表
- "从文件导入"可点击"下载导入模板",按模板规则填写后导入
当需要"排除指定表"时,同指定部分表相同操作,但结果相反。
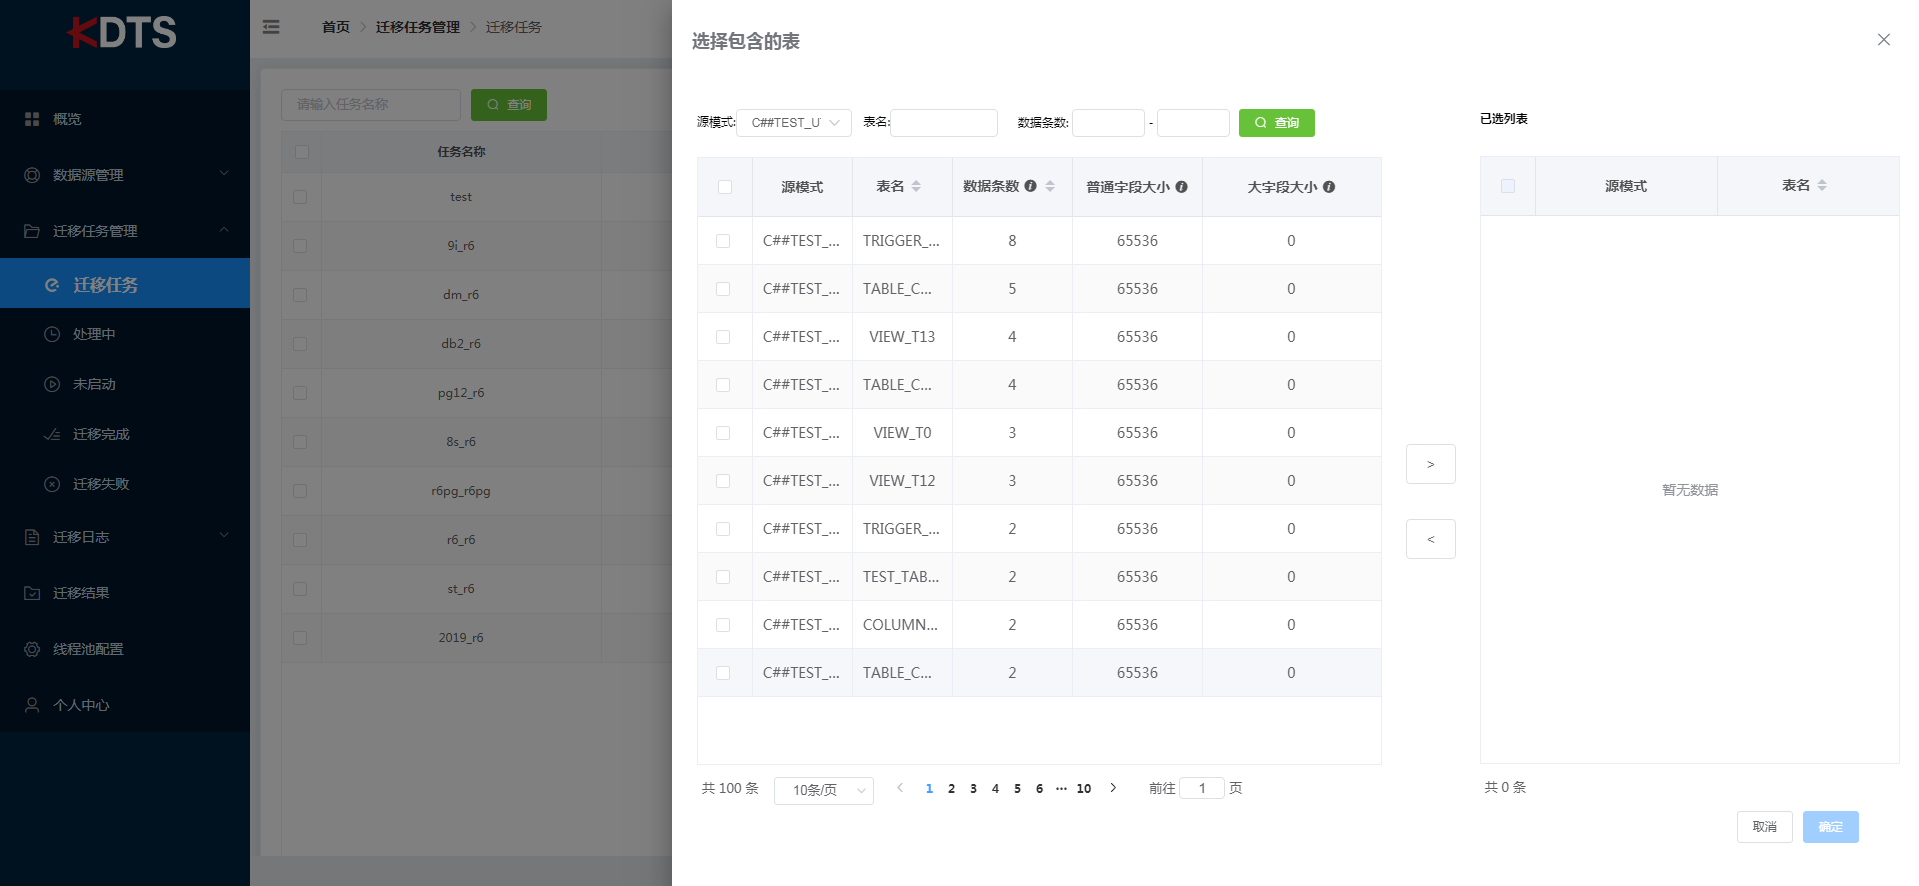
从列表选择表时,可选择对应模式、检索表名关键字、数据条数限制进行快速检索。点击"添加"加入已选列表;需要移除时选择对应表点击"移除"。完成后点击确定。
4)配置参数
迁移工具提供了一系列配置参数用于迁移方案的个性化配置,满足多种迁移场景。配置参数分为"迁移配置"、"数据类型映射"、"线程配置"三个方面。以下以迁移配置为例介绍各参数含义。
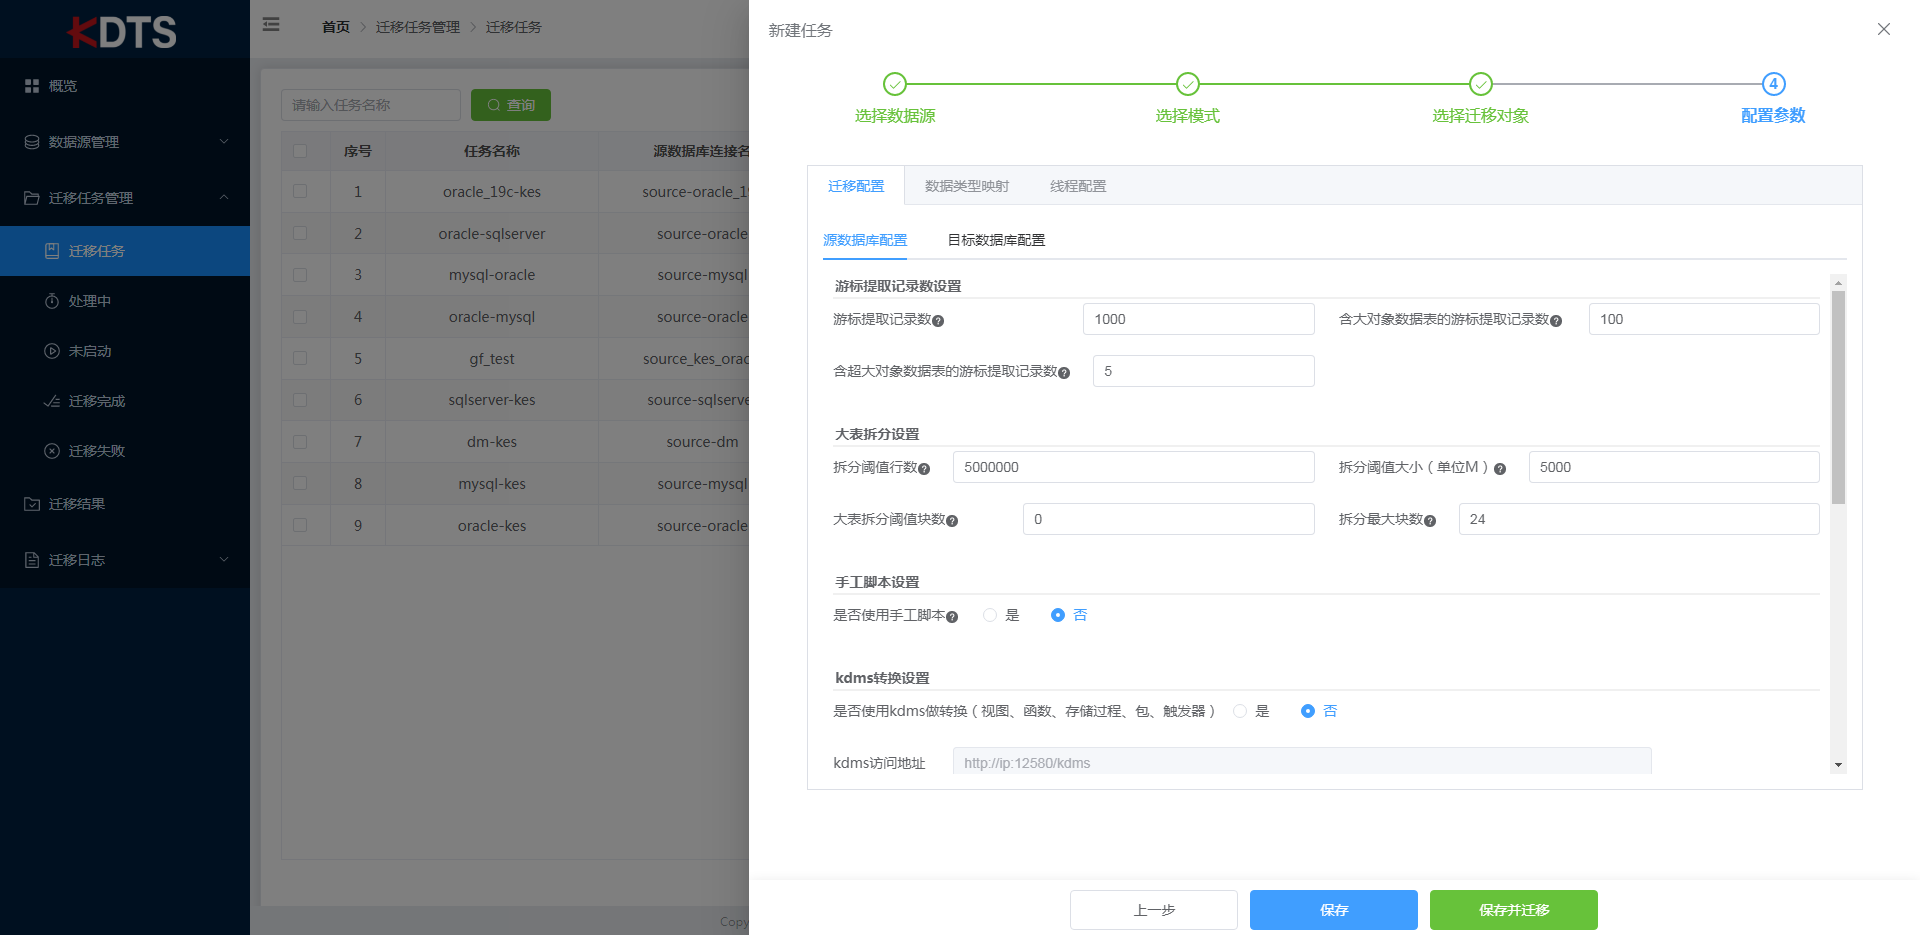
- 表默认处理方式:两个复选项("建表/重建表"、"导入数据"),用于选择是否建表/重建表、是否只迁移结构不迁移数据(默认全选)。
- 表排序依据:可按"按行数和大字段大小交替"、"行数"、"大小"排序(默认按行数和大字段大小交替)。
- 表数据读取和写入:包括"源库游标读取记录数"(默认 100)、"批量写入目标库记录数"(默认 1000)、"每次批量提交大小"(默认 100MB)、"LOB 字段预读取大小"(默认 4000Byte)。
- 大表拆分阈值依据:对大表进行拆分迁移,设置拆分界限。
- 非对象设置:主键、检查约束、唯一约束、外键、索引、触发器、自动转换对象名等,可按需选择(默认全选)。
- 数据库连接数设置:限制迁移程序对源/目标数据库的最大连接数(默认 100)。
执行迁移任务
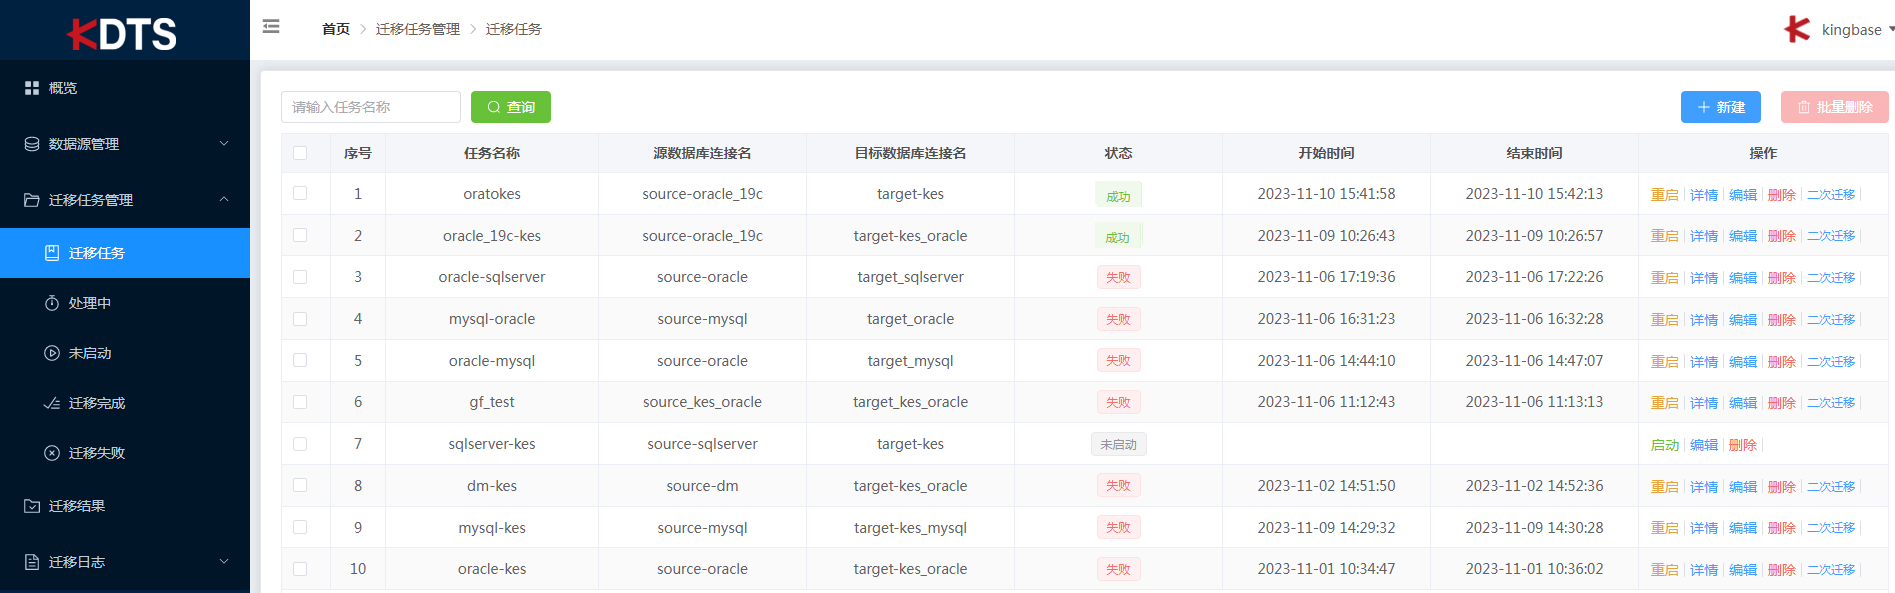
可将任务作为预迁移任务点击"保存",或者作为执行任务点击"保存并迁移"。迁移完成后任务状态将变成:
- 迁移完成:"状态"栏显示"成功",则迁移任务成功。
- 迁移失败:"状态"栏显示"失败",则迁移任务失败。失败后可点击详情查看日志以辅助排查。
查看迁移报告及问题处理
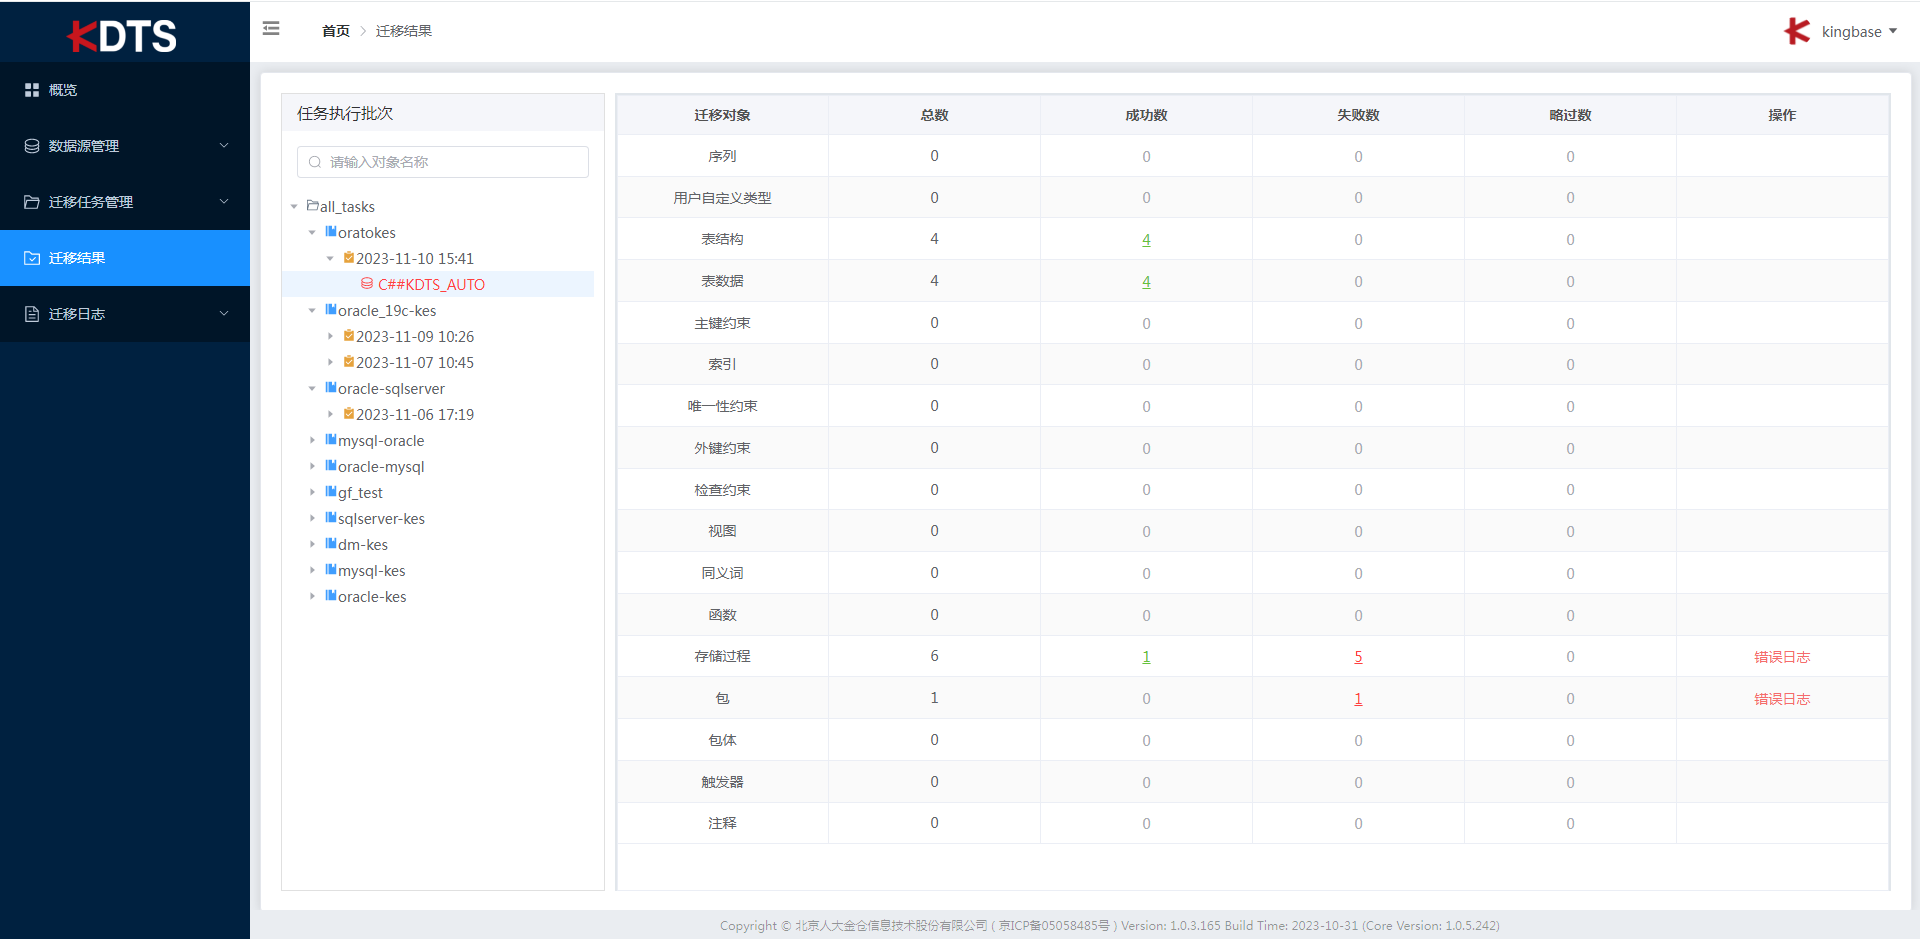
迁移完成后需要确认执行结果(迁移数据量、错误情况等),可通过迁移日志和迁移结果查看。
- "迁移日志":系统日志、Error 日志、Info 日志
- "迁移结果":任务执行批次、迁移对象、总数、成功数、失败数、略过数、操作;可查看历史迁移记录与失败日志
SHELL 迁移步骤
工程目录说明
使用 SHELL 方式迁移需对工程文件有一定了解:
- bin:启动脚本
- conf:配置文件
- doc:帮助文档
- drivers:数据库连接驱动(不同版本驱动目录差别,详见 readme.md)
- jdk:jdk
- kdms:kdms 程序
- lib:程序包
- logs:日志
- result:迁移报告
JDK 安装
下载与 KDTS 安装服务器相匹配的 JDK(需匹配操作系统与 CPU 架构,如 Linux/AArch64、Linux/x64、Windows/x64 等),版本选择 JDK 11 或更高。将下载的 JDK 解压到 KDTS-CLI/jdk 目录下即可。
备注:
- 请使用解压版本的 JDK,以免安装 JDK 影响服务器上的其它应用。
- 不要把当前 JDK 加入系统环境变量,以免影响服务器上的其他应用。
- 如需使用服务器已有 JDK,配置 bin/startup.sh(Windows 平台为 startup.bat)中的 JAVA_PATH 即可。
配置数据库连接信息
配置步骤分为 3 步:激活配置文件、配置数据库连接、配置相关参数。
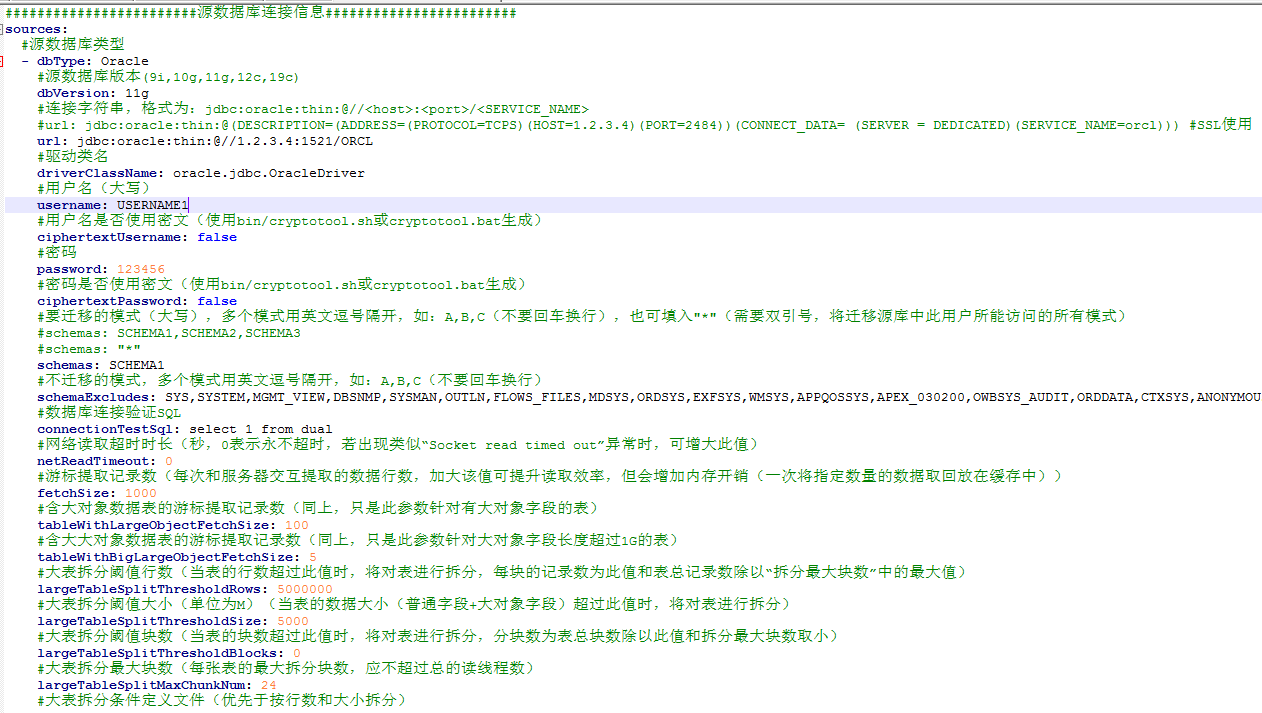
1)进入 KDTS-CLI/conf 目录,打开 application.yml,根据源库类型设置当前激活的源库配置(active: oracle)。
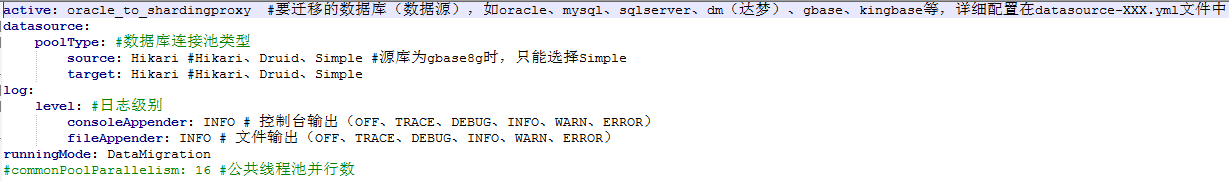
在正确设置 application.yml 中 active 项后,打开对应配置文件(datasource-oracle.yml),按实际运行环境配置。
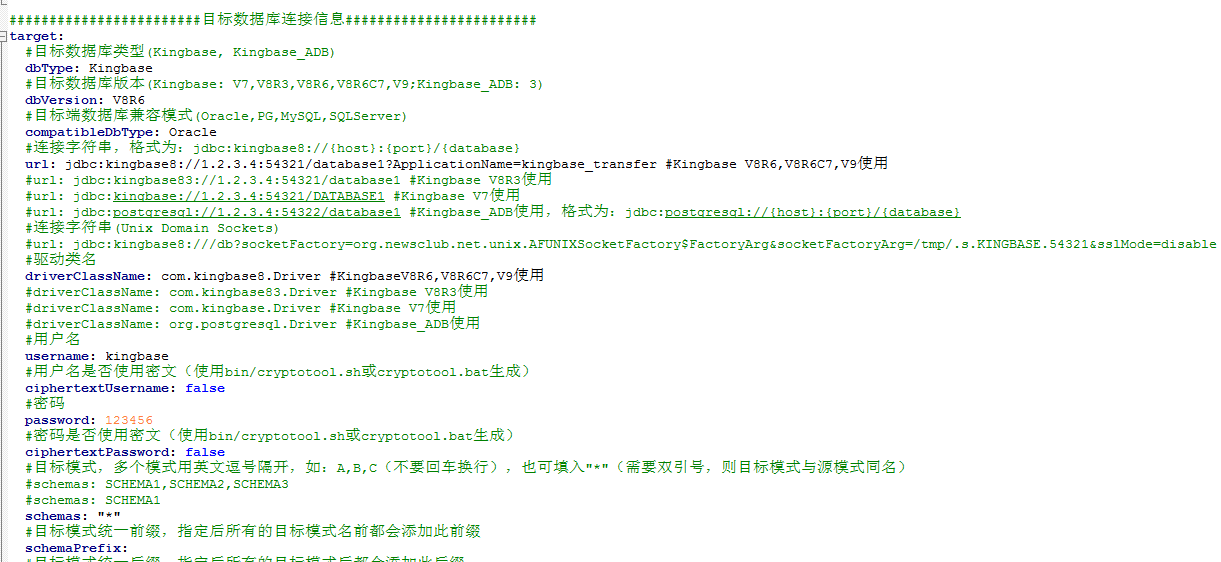
2)配置源端/目标端连接信息
编辑 conf/datasource-oracle.yml,配置 url、driver-class-name、username、password 等信息。
3)配置要迁移的源库模式、数据库对象及参数
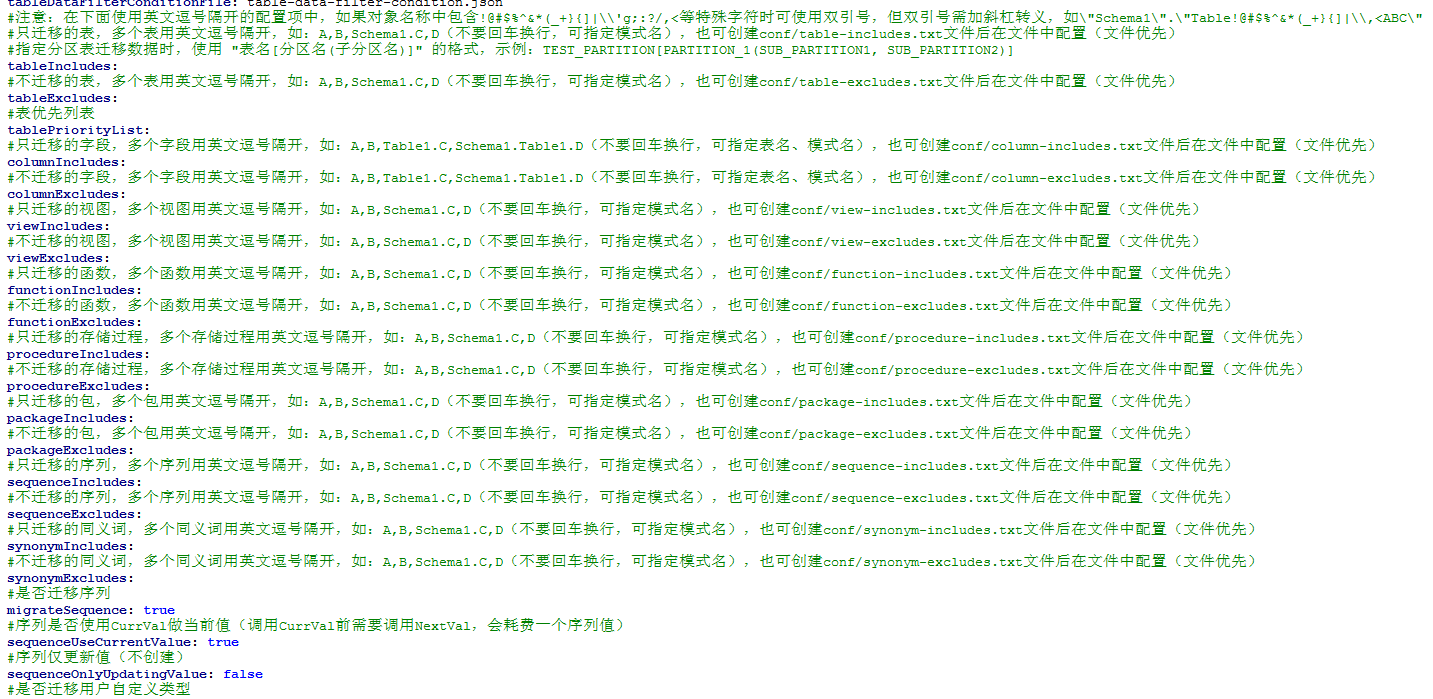
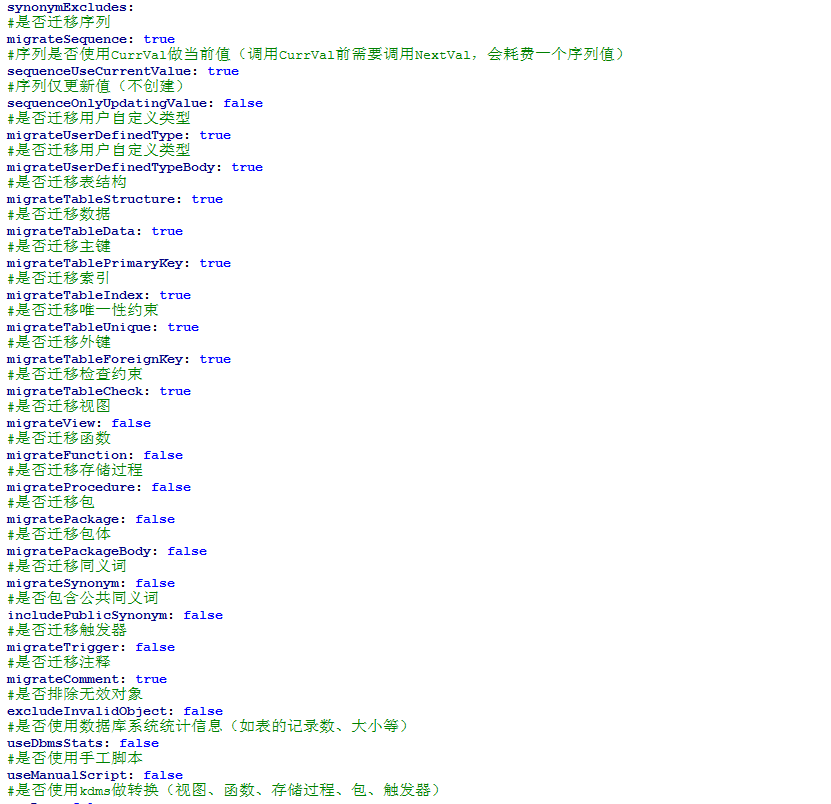
4)迁移配置参数说明(常用项摘录)
- fetch-size:源数据库游标读取记录数,适当增大可提升读取效率,但会增加内存开销。
- table-with-large-object-fetch-size:含大对象字段表的游标读取记录数。
- large-table-split-threshold-rows:大表拆分阈值行数。
- large-table-split-threshold-size:大表拆分阈值大小(单位 M)。
- large-table-split-condition-file:大表拆分条件定义文件(优先级高于行数/大小拆分)。
- table-data-filter-condition-file:表数据过滤条件定义文件。
- use-kdms / kdms-url:是否使用 kdms 做转换及其访问地址(视图/函数/存储过程/包/触发器)。
- write-batch-size:目标库批量提交记录数。
- write-batch-size-big-lob:大对象数据批量提交记录数。
- drop-existing-object:是否默认删除目标库已存在对象。
- truncate-table:是否默认清空目标库已存在表数据。
- rename-object:对象重命名策略(除表名/列名外的 pk、fk、constraint、unique、index 等)。
- useDbmsStats:是否使用数据库系统统计信息(记录数、大小等)。
- useManualScript:是否使用手工脚本。
- readDataTimeout:读数据超时时长(毫秒,0 表示永不超时)。
- maxRetries / retryInterval:最大重试次数与重试间隔。
- readDataCanResume:读数据中断后能否恢复。
- characterNeedDecoding / encodingCharset / decodingCharset / decodingBytes:处理源端字符集为 US7ASCII、WE8ISO8859P1 等时迁移中文乱码。
- dataCompareBufferSize / dataCompareAlgorithm:数据对比缓冲区大小与摘要算法。
- maximumPoolSize:源数据库最大连接数。
线程相关设置
可根据实际服务器配置按比例调整;若与目标数据库运行在同一服务器上,应将绝大部分资源分配给数据库。
进入 KDTS-CLI/conf 目录,打开 kb-thread-config.xml:
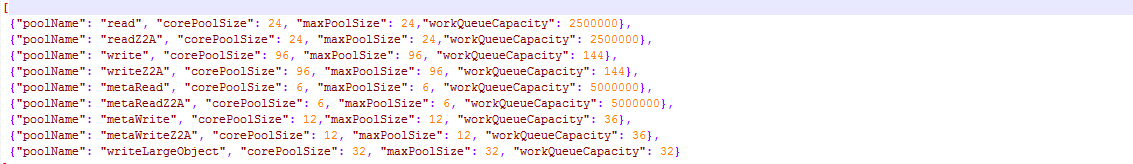
数据迁移属于 IO 密集型操作,涉及网络 IO 与磁盘 IO 交互。为提升效率可适当增加线程池线程数,提高并发处理效率,但线程数并非越高越好(上下文切换有代价)。IO 密集型线程数设置公式:
- 线程数 = CPU 核心数 / (1 - 阻塞系数)
- 阻塞系数一般为 0.8~0.9,取 0.9 时:
- 双核 CPU:2/(1-0.9)=20
- 64核2路 CPU:64*2/(1-0.9)=1280
启动脚本
进入 KDTS-CLI/bin 目录,编辑 startup.sh:
- 检查 JDK 路径:
JAVA_PATH=${BASE_PATH}/jdk - 设置 JVM 内存:
JAVA_OPT="-server -Dfile.encoding=UTF-8 -Dconfig.path=${CONFIG_DIR} -Xmx16g -Xms16g"(关键是 -Xmx/-Xms) - 启动:进入 KDTS-CLI/bin,执行
./startup.sh
查看迁移报告及问题处理
可在运行日志(kdts_plus_***.log)中查看任务启动、迁移进程、结果汇总。可查看 result 下迁移结果(例如 result/2021-12-02_15-15-15/Sehcma1):
- index.html:报告主页面
- detail_XXX.html:详细信息(表结构、表数据、主键等)
- FailedScript:失败脚本目录
- IgnoredScript:略过脚本目录
- SuccessScript:成功脚本目录
迁移过程中若某对象创建失败,KDTS 会将创建 SQL 保留到本次任务文件夹 FailedScript 目录下的 *.sql 文件,可手动修改后通过 Ksql 或 KStudio 执行。
在线迁移
在线迁移过程中,为保障异构数据库数据同步且客户业务不停机,需要一个中间数据库(与源端数据库版本相同的单实例数据库)做媒介迁移存量数据。操作过程分两部分:
- 先将存量数据迁移至中间数据库上,然后使用 KDTS 进行初始数据搬迁或通过 ETL 进行初始数据搬迁至目标数据库(异构数据库)中。
- 待上一步完成,从指定断点开始启动 KFS 源端,同时正常启动目标端 KFS 程序(如已有 KFS 运行,可能需要重置 KFS)。
备注:迁移源库存量数据时避免做以下操作:
- 运行大型批处理操作会降低复制速率。
- 备份时执行 DDL 操作将导致 DML 和 DDL 之间存在锁问题。
源端数据库备份
1)获取当前数据库一致性 scn 号
sql
alter system checkpoint global;
select checkpoint_change# from v$database;

-- 假设获取的值为200725471,该scn号将用作启动KFS起始的scn号。
2)创建备份目录(需要 sysdba 权限)
sql
create directory dump_dir as 'd:/dump_dir';
grant read,write on directory dump_dir to kfs_user;
3)完整备份数据库(导出用户 kfs_user 内容)
bash
expdp kfs_user/123456 schemas=kfs_user directory=dump_dir flashback_scn=200725471 dumpfile=DBNAME_20220511.dump存量数据迁移(中间库)
1)在中间库中创建备份目录(需要 sysdba 权限)
sql
create directory dump_dir as 'E:/dump_dir';
grant read,write on directory dump_dir to kfs_user;
2)将源端备份的数据文件拷贝至 E:/dump_dir 目录下
3)将备份的数据还原至中间库
bash
impdp kfs_user_new/123456 directory=dump_dir remap_schema=kfs_user:kfs_user_new table_exists_action=replace dumpfile=DBNAME_20220511.dump4)使用 KDTS 将中间库数据搬迁至目标数据库。
启动 KFS 完成数据追平
备注:若 KFS 之前已经部署运行,则源端和目标端需要先执行重置命令 fsrepctl --service XXX reset -all --y,确认中间表、kufl 文件等被清除。KFS 部署参考相关安装部署手册。
源端操作
先启动 KFS 到 offline 状态:replicator start offline。
再使用 ONLINE 命令完全启动源端 KFS,ONLINE 命令需要指定 -from-event 参数,参数值为备份数据库时查询的 scn 值。
bash
replicator start offline
fsrepctl -service oracle online -from-event ora:200725471: 200725471
目标端操作
启动目标端 KFS,等待数据追平。
提示:追平判断方法(示例输出):
text
fsrepctl services

appliedLastSeqno: 3   // 若源端无新数据产生,则源端和目标端相同
appliedLatency : 0.297 // 若源端无新数据产生,延迟时间为0
state : ONLINE
多次迁移
若项目开发过程中需要定期从指定源数据库迁移到目的数据库中,则根据迁移时源数据库和应用状态决定离线迁移还是在线迁移。
同时,由于是多次迁移,需要考虑每次迁移时数据库对象定义是否需要迁移:
- 若不需要:只迁移数据即可(KDTS 与 KFS 都支持只迁移数据)
- 若每次迁移都需要迁移对象定义:
1)定义发生变更的表:选择迁移定义和数据,可使用 KDTS 的"迁移部分表"功能完成。
2)定义未发生变更的表:只同步数据,可使用 KDTS 的"按条件迁移"功能完成。
应用代码迁移
服务器应用代码迁移
数据迁移后,需要迁移应用系统中用到的服务器应用代码,例如 PL/SQL。
KDTS 已经完成了存储过程、函数、包等 PL/SQL 对象的迁移,只需要关注应用代码中用到的匿名块的迁移。KingbaseES 的 plsql 语言与 Oracle plsql 高度兼容,需要关注如下 2 点:
- package 中 Oracle 允许存在同名同参数的存储过程和函数,KingbaseES 不支持,需要重命名为不同名字。
- KingbaseES 不支持 Object type 的方法连续调用(方法1.方法2.方法3),需要改写为:
plsql
var1 := 方法1;
var2 := var1.方法2;
var3 := var2.方法3;
客户端应用代码迁移
在应用编程接口方面,KingbaseES 与 Oracle 兼容程度较高,一般情况下应用程序迁移比较容易。应用程序迁移通常应和迁移后的系统测试同时进行,以便及时修改测试过程中发现的问题。
通常应用程序可采用 API 方式访问和操纵数据库:通过数据库厂商提供的标准应用编程接口与数据库交互并完成对数据的操作,常见接口如 JDBC、ODBC 等。一般应先加载驱动程序,加载成功后使用 API 函数与数据库交互。
ODBC
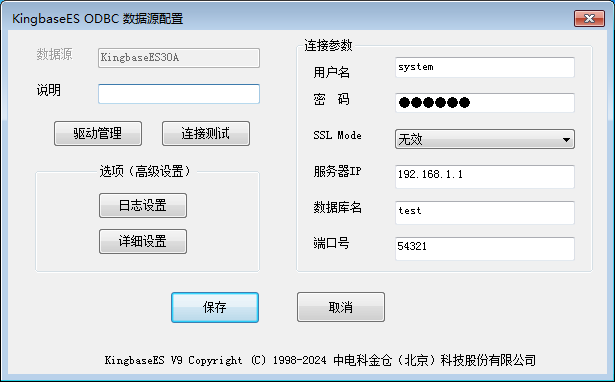
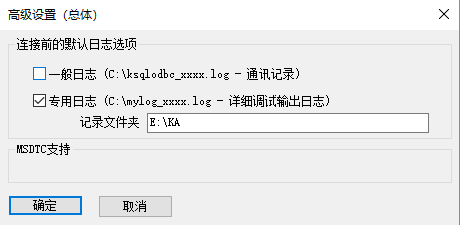
对于使用 ODBC 的应用程序,应创建 KingbaseES ODBC 数据源,然后修改应用程序中连接数据库的用户名、密码等。此外,在 Windows 系统下对于 OLEDB、ADO 和 NDP,则不需创建数据源。
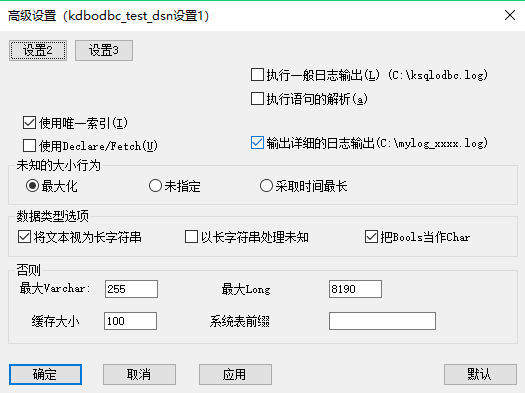
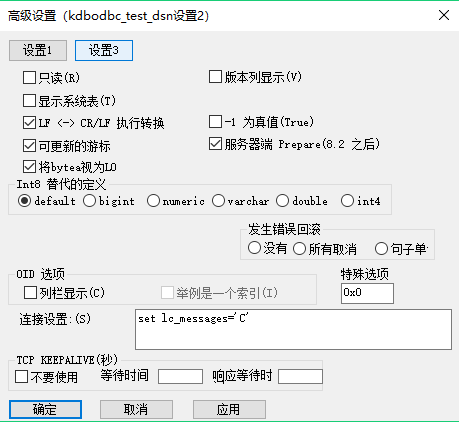
Windows 数据源配置
Linux 数据源配置
首先检查 ODBC Driver 是否已经安装。系统中 odbcinst.ini 文件位置与 odbcinst 程序路径相关:
/usr/bin/odbcinst对应的 odbcinst.ini 在/etc/usr/local/bin/odbcinst对应的 odbcinst.ini 在/usr/local/etc
在 odbcinst.ini 文件中查找 [KingbaseES 9 ODBC Driver] 项。若没有,可参考增加如下内容:
ini
[KingbaseES 9 ODBC Driver]
Description = KingbaseES 9 ODBC Driver for Linux
Driver = /opt/Kingbase/Odbc/lib/kdbodbcw.so
增加 odbc.ini 文件,内容如下:
ini
[kingbase]
Description = KingbaseES
Driver = KingbaseES 9 ODBC Driver
Servername = 127.0.0.1
Port = 54321
Username = SYSTEM
Password = MANAGER
Database = TEST
移植 Oracle OCI 应用程序
KingbaseES 支持 OCI 的大部分常用接口。
其它应用框架
其它应用框架的使用,请参照客户端编程开发框架的使用指南。如无说明,请及时联系 KingbaseES 支持工程师。
测试与调试迁移后的系统
任何一个成熟的应用系统如果代码、尤其是关键代码变动后,应进行全面细致的测试。同样,更换新的后台数据库系统以后,也应对迁移后的数据库系统进行全面的功能和性能测试。
功能测试和排错
功能测试是指对迁移后的数据库系统的每一个模块和功能进行全面的系统回归测试,用以确保新系统各个功能的正确性。
完成数据库对象和应用程序迁移后,应对迁移后的系统进行全面的功能测试,并对测出问题及时分析、排查和修改。对那些很难定位的问题,请及时联系 KingbaseES 支持工程师。
性能测试和调优
迁移后的系统性能测试和调优是在完成系统功能测试后、系统上线前,在实际或模拟生产数据上进行的性能测试和调优。主要步骤如下:
- 构造测试数据:建议构造与生产规模相同数据,并模拟未来一年、两年、五年或更长生命周期的数据进行测试。
- 部署测试软硬件环境:根据测试数据规模配置适当环境。
- 性能测试:可手动,也可利用 TPCC、LoadRunner 等工具自动测试。
- 性能调优:对未达到性能指标的功能模块及其 SQL 语句进行优化并给出建议。
通常性能测试效果与测试数据规模、软硬件配置等因素密切相关。建议性能测试时测试数据规模、软硬件配置尽量与未来生产环境一致;必要时在未来一年、两年、五年等不同模拟数据规模场景下分别测试性能指标,以保证系统未来仍能具有良好的性能表现。
