随着大语言模型(LLM)、计算机视觉模型等在生产环境中的广泛应用,推理服务的部署面临着两大核心挑战: 一是模型体积大、计算密集,对 CPU、GPU 资源依赖极高,需精准划分资源避免浪费或过载; 二是高并发场景下需支持多实例弹性调度,确保服务稳定性与响应效率。 Docker 作为容器化技术基石,可实现推理服务的环境一致性打包;Kubernetes(K8s)则凭借强大的编排能力,完成资源的动态分配与多实例的全生命周期管理。本文将详细拆解 Dockerfile 编写、K8s Deployment 配置、GPU 资源 requests/limits 设置三大核心环节。
一、部署前置准备与核心原则
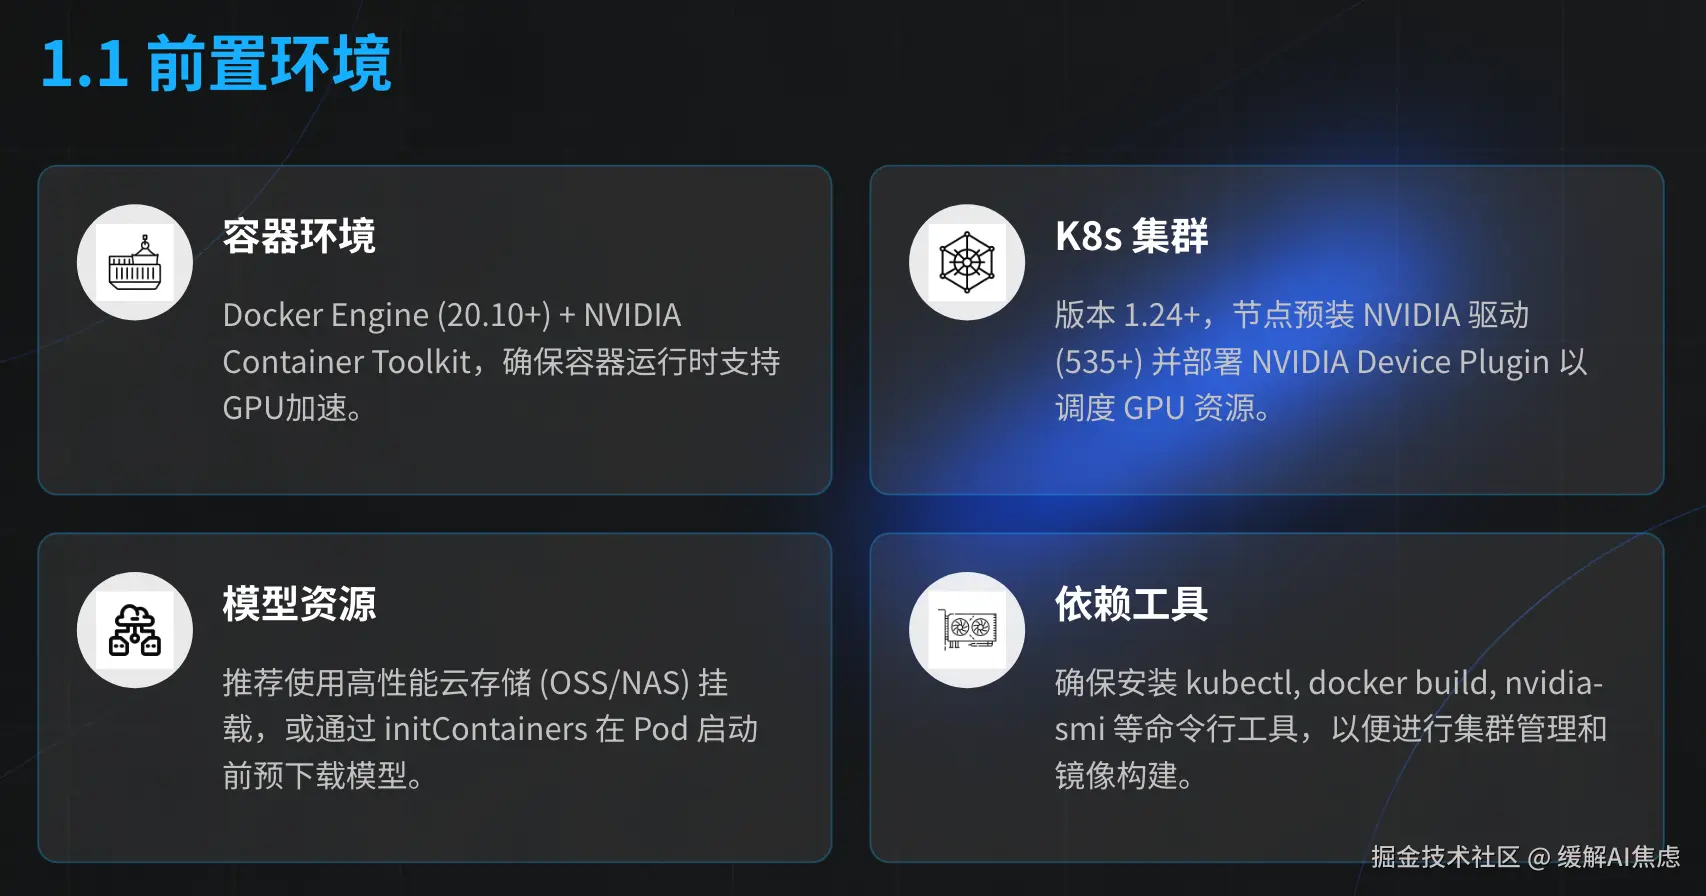
1.1 前置环境
- 容器环境 :Docker Engine(20.10+),需安装 NVIDIA Container Toolkit 以支持 GPU 容器化;
- K8s 集群 :1.24+ 版本,节点需预装 NVIDIA 驱动(建议 535+)并部署 NVIDIA Device Plugin;
- 模型资源 :建议通过高性能云存储(OSS/NAS)挂载,或利用
initContainers预下载,避免镜像过大; - 依赖工具:kubectl、docker build、nvidia-smi。
1.2 核心部署原则
- 环境一致性:通过 Docker 镜像封装推理引擎(如 vLLM、TensorRT-LLM),消除显存驱动与库版本的依赖冲突;
- 资源确定性 :GPU 资源需遵循 Requests 与 Limits 严格相等 的原则,确保显存独占;
- 高可用探测 :针对大模型加载慢的特点,必须配置合理的 ReadinessProbe(就绪探针) ,防止流量打入未初始化的实例。
二、Dockerfile 编写:推理服务的容器化封装
Dockerfile 的核心是将运行环境、依赖包与启动脚本统一打包。以下结合主流推理引擎 vLLM(高吞吐场景首选),提供生产级 Dockerfile 示例。
2.1 基础镜像选择
优先选用 NVIDIA 官方提供的 CUDA Runtime 镜像,确保驱动兼容性。
推荐镜像 :nvidia/cuda:12.1.0-runtime-ubuntu22.04(适配最新 H100/A100 及 L4 系列显卡)。
2.2 完整 Dockerfile 示例(vLLM 推理引擎)
ini
# 基础镜像:NVIDIA CUDA 12.1 + Ubuntu 22.04 运行时
FROM nvidia/cuda:12.1.0-runtime-ubuntu22.04
# 设置时区与环境变量
ENV TZ=Asia/Shanghai \
DEBIAN_FRONTEND=noninteractive \
PYTHONUNBUFFERED=1
# 更新系统源并安装基础依赖
RUN apt-get update && apt-get install -y --no-install-recommends \
python3-pip python3-dev libibverbs1 \
&& rm -rf /var/lib/apt/lists/*
# 核心:安装 vLLM 引擎,使用 --no-cache-dir 显著减小镜像体积
RUN pip3 install --no-cache-dir --upgrade pip && \
pip3 install --no-cache-dir vllm==0.7.0 torch==2.4.0
WORKDIR /app
# 复制启动脚本
COPY start.sh /app/start.sh
RUN chmod +x /app/start.sh
# 暴露推理服务端口(vLLM 默认 8000)
EXPOSE 8000
CMD ["/app/start.sh"]2.3 启动脚本优化(start.sh)
bash
#!/bin/bash
# 启动 vLLM 推理服务
# --gpu-memory-utilization 建议设为 0.9,预留部分显存防止碎片化导致的 OOM
vllm serve /app/model \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size ${TP_SIZE:-1} \
  --gpu-memory-utilization ${GPU_MEM_UTIL:-0.9} \
  --max-model-len 8192 \
  --trust-remote-code
三、K8s Deployment 配置:多实例管理
3.1 完整 Deployment YAML 示例
yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: llm-inference
  namespace: llm-service
spec:
  replicas: 3
  selector:
    matchLabels:
      app: qwen-inference
  template:
    metadata:
      labels:
        app: qwen-inference
    spec:
      containers:
      - name: inference-container
        image: harbor.example.com/llm/inference:v1.0
        # 修正:健康检查关键配置,防止模型加载中被 K8s 误杀
        readinessProbe:
          httpGet:
            path: /health
            port: 8000
          initialDelaySeconds: 120 # 修正:为大模型加载预留 2 分钟以上
          periodSeconds: 10
        livenessProbe:
          httpGet:
            path: /health
            port: 8000
          initialDelaySeconds: 240 # 存活探测需更宽松
        resources:
          requests:
            cpu: "8"
            memory: "32Gi"
            nvidia.com/gpu: 1
          limits:
            cpu: "16"
            memory: "48Gi"
            nvidia.com/gpu: 1 # 必须与 requests 相等
        volumeMounts:
        - name: model-data
          mountPath: /app/model
      volumes:
      - name: model-data
        hostPath: # 生产环境建议改用 PVC (NAS/JuiceFS)
          path: /data/models/qwen-14b
3.2 参数解释
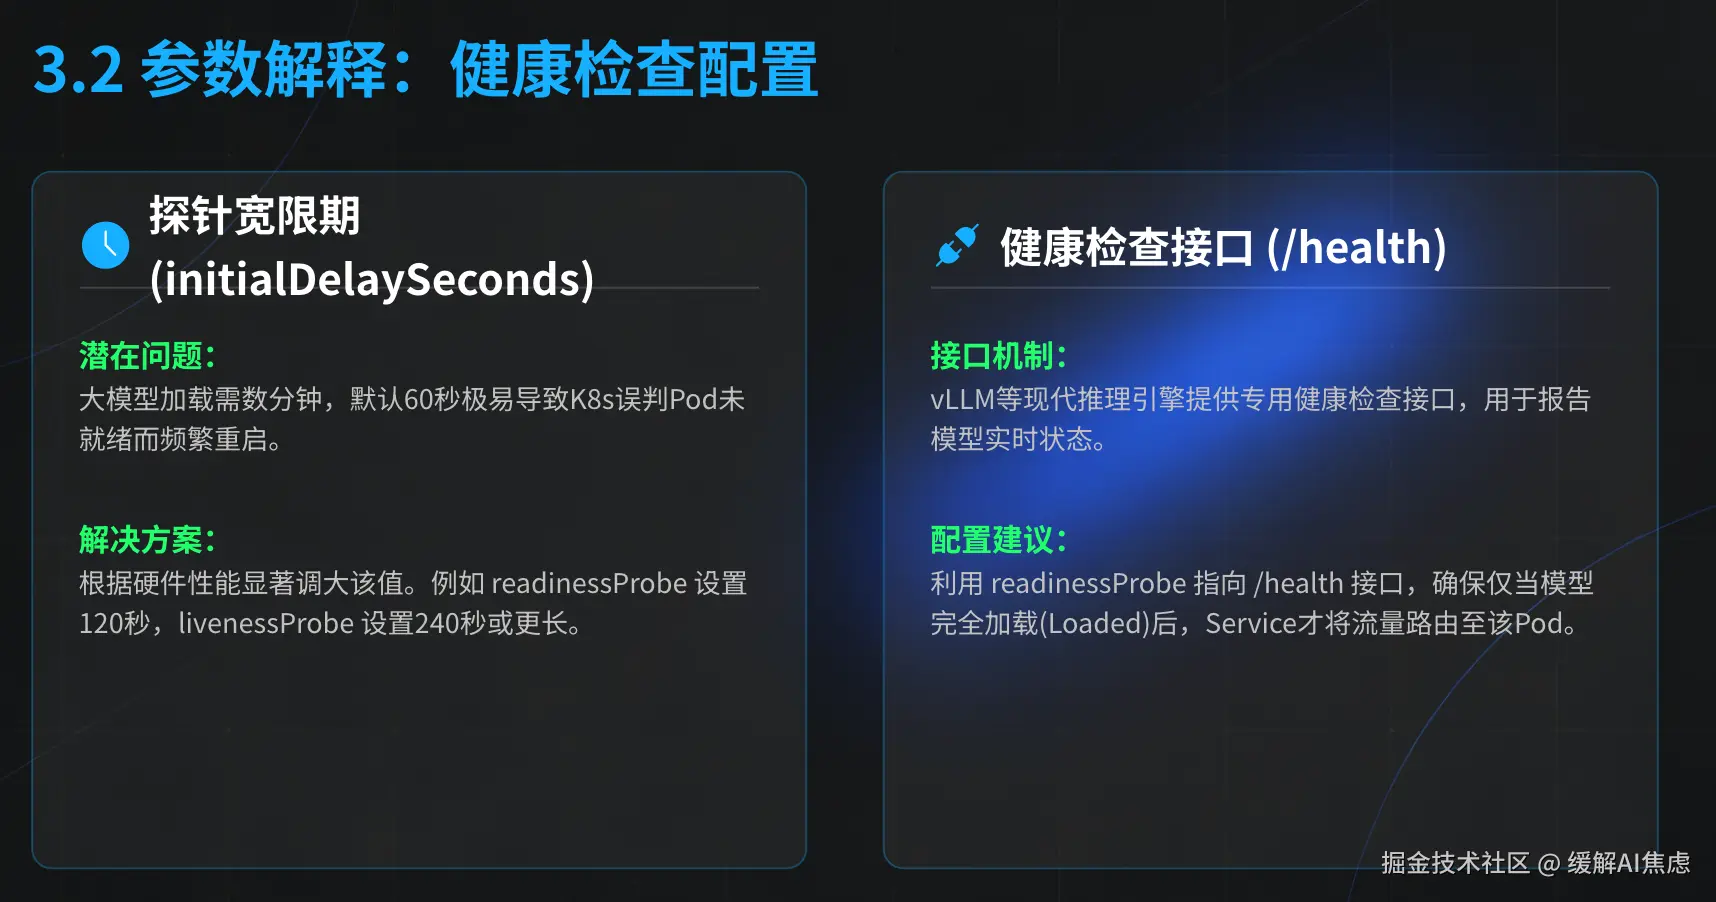
- 探针宽限期 :大模型权重(Weights)加载往往需要几分钟。原有的 60 秒极易触发 Pod 重启死循环,必须调大
initialDelaySeconds。 - 健康检查接口 :vLLM 官方提供
/health接口,应利用就绪探针确保模型 Loaded 完毕后再允许流量进入负载均衡。
四、GPU 资源分配核心实践
4.1 GPU 调度强制规则
K8s 调度 GPU 不同于 CPU,需遵循以下约束:
- 强一致性 :
nvidia.com/gpu的 requests 与 limits 必须严格相等。K8s 不支持原生 GPU 超分,若设置不等将导致 Pod 无法调度或运行异常。 - 独占性 :默认情况下一个 GPU 只能分配给一个 Pod。若需单卡跑多实例,需在宿主机配置 NVIDIA MPS 或使用虚拟化 GPU 技术。
4.2 资源建议方案
- 7B 模型 (INT8) :建议 1 块 24G 显存 GPU (如 3090/4090/L4),CPU 4-8 核,内存 16GiB+。
- 14B/32B 模型 :建议 1 块 40G/80G 显存 GPU (如 A100/A800),或 2 块 GPU 开启张量并行 (
--tensor-parallel-size 2)。
五、多实例调度优化与生产注意事项
5.1 调度优化
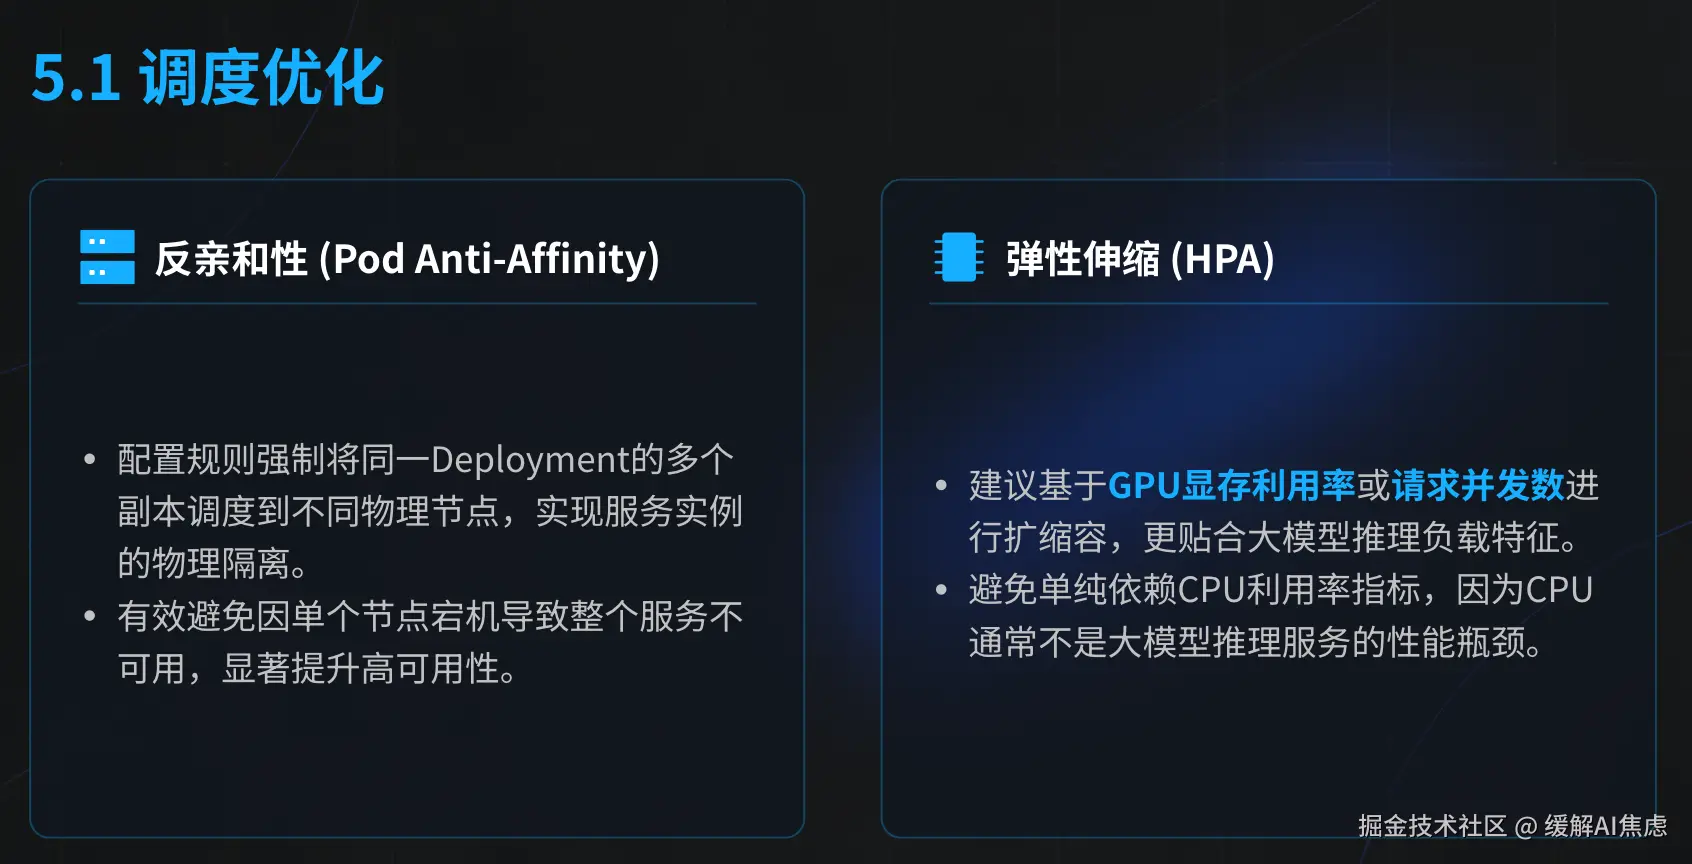
- 反亲和性 :配置
podAntiAffinity,强制将副本散开在不同物理节点,防止单机宕机导致服务全灭。 - 弹性伸缩 (HPA) :建议基于 GPU 显存利用率 或 请求并发数(通过插件采集)进行扩容,而非单纯依赖 CPU。
5.2 生产红线
- 镜像瘦身 :务必在 Dockerfile 中执行
rm -rf /root/.cache/pip。大模型相关库极其臃肿,不清理会导致镜像高达 15GB+,拉取耗时极长。 - 存储瓶颈:避免 10 个 Pod 同时从同一个低速磁盘读取模型,这会导致 IO 阻塞,建议使用 SSD 或分布式缓存文件系统。
六、总结
通过 Docker 实现环境标准化,利用 K8s 实现资源的精细化管理与自动纠错,是大模型推理服务的最佳落地路径。在 2026 年的云原生环境下,部署的重心已从"能跑通"转向了"高性能启动 "与"显存精细化调度"。持续关注 vLLM 等引擎的更新,能进一步压榨硬件性能,降低推理成本。