这篇文章只讲本项目里"HTTP状态查询"工具的功能 JavaScript 实现。它的目标很明确:用户输入一个网址后,返回当前状态码、重定向链路、响应头、页面标题、IP 和耗时等信息。
在线工具网址:see-tool.com/http-status...
工具截图:
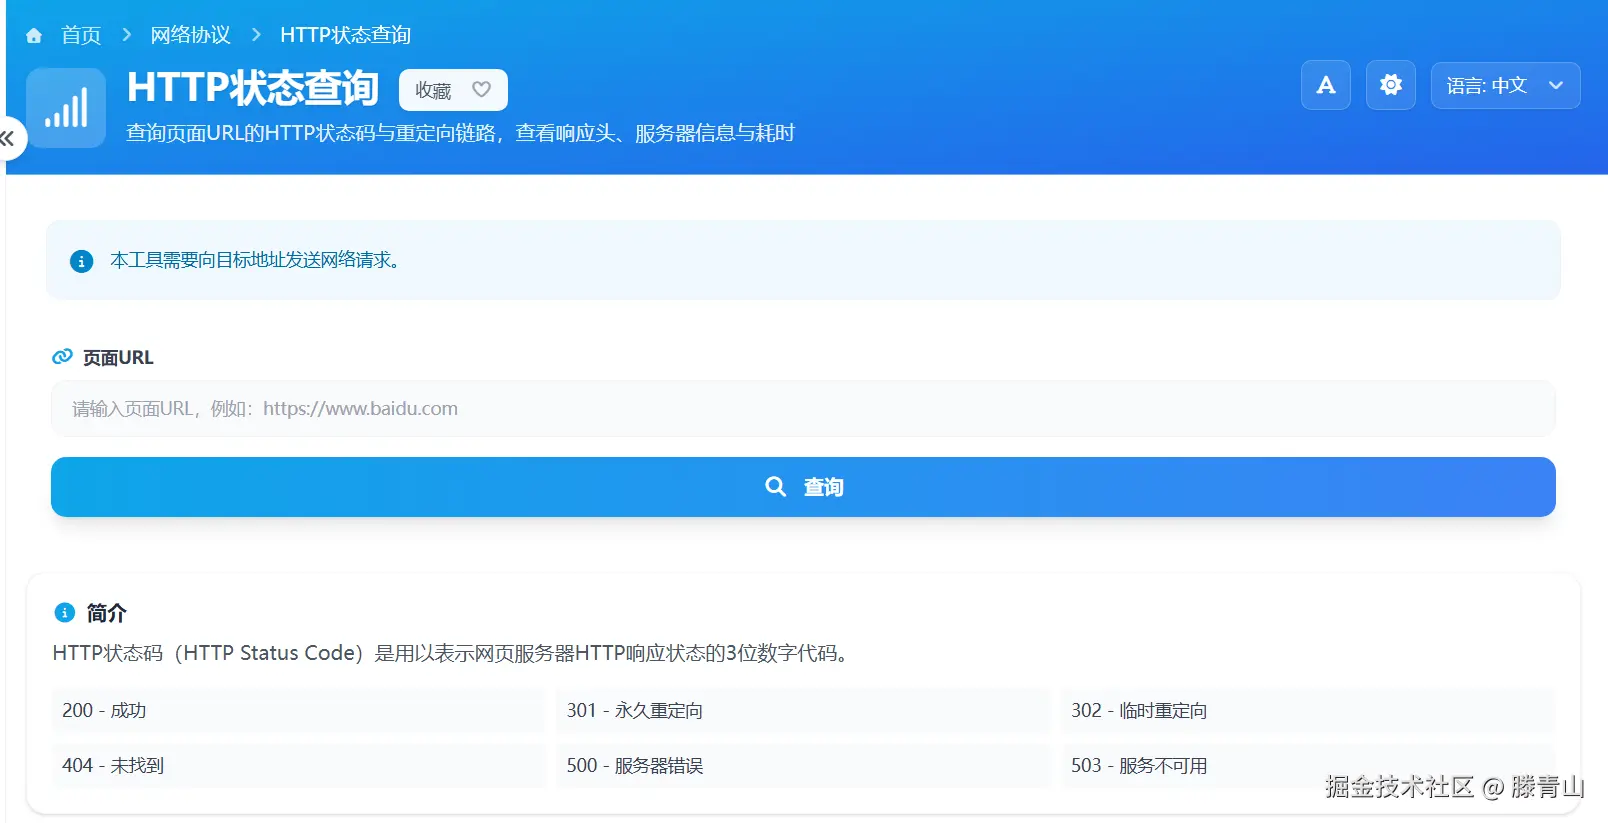
整个实现可以拆成 4 段:输入规范化、请求触发、服务端逐跳探测、结果整理展示。
1)输入先做规范化
这个工具不会直接拿用户原始输入去请求,而是先统一处理:
- 去掉首尾空格和中间多余空白
- 如果没写协议,自动补上
http:// - 用
URL构造函数校验格式 - 只允许
http和https
这样做的好处是,像 example.com、https://example.com 这种输入都能被转换成稳定可请求的地址,非法内容则会被提前拦下。
js
const normalizeUrl = (value) => {
  const rawValue = String(value || "").trim();
  if (!rawValue) return "";

  const cleaned = rawValue.replace(/\s+/g, "");
  const withProtocol = /^https?:\/\//i.test(cleaned)
    ? cleaned
    : `http://${cleaned}`;

  try {
    const target = new URL(withProtocol);
    if (!["http:", "https:"].includes(target.protocol)) return "";
    return target.toString();
  } catch {
    return "";
  }
};
2)前端状态围绕"查询过程"设计
前端没有把逻辑拆得很散,而是直接围绕一次查询需要的状态来组织:
urlInput:输入框内容isLoading:是否正在查询errorMessage:错误提示resultData:接口返回的完整结果pendingUrl:当前准备发送的规范化 URL
结果展示时,再通过计算属性把 resultData 拆成页面标题、结果列表和摘要文案。这样界面层只负责渲染,不需要重复处理原始数据。
3)服务端核心是"手动接管跳转链"
真正的核心不在于请求一次 URL,而在于把每一跳都查出来。实现上使用循环逐跳请求,并把 redirect 设为 manual,这样程序不会自动跟随跳转,而是自己读取 Location,再决定下一跳。
js
const isRedirectStatus = (statusCode) =>
  [301, 302, 303, 307, 308].includes(statusCode);

for (let i = 0; i <= MAX_REDIRECTS; i += 1) {
  if (visited.has(currentUrl)) break;
  visited.add(currentUrl);

  const { result, title: pageTitle } = await requestOnce(currentUrl, i + 1);
  results.push(result);

  if (!isRedirectStatus(result.code) || !result.location) {
    break;
  }

  currentUrl = new URL(result.location, currentUrl).toString();
}
这里有两个关键点:
- 用
visited记录已经访问过的地址,避免循环跳转 - 用
new URL(result.location, currentUrl)兼容相对跳转地址
所以用户最后看到的不是单个状态码,而是一整条请求链路。
4)单次请求会提取多种信息
每请求一跳,都会同时收集一组结构化结果:
code和statusTextcontentTypecacheControlresponseDateserverlocationtotalTimehead(原始响应头文本)
耗时的计算方式也很直接:请求前记开始时间,响应结束后减一次时间戳,最后拼成 123ms 这种格式。
5)页面标题不是直接取字符串,而是先按内容类型解码
如果响应是 HTML,工具还会继续读取正文前一部分内容,用于提取页面 <title>。这里有两个步骤:
第一步,先根据 content-type 里的 charset 选择解码方式;第二步,再从 HTML 里匹配标题标签。
js
const extractTitleFromHtml = (html) => {
  const match = html.match(/<title[^>]*>([\s\S]*?)<\/title>/i);
  if (!match) return "";
  return match[1].replace(/\s+/g, " ").trim();
};
这样即使页面不是 UTF-8,只要响应头里带了字符集,标题也能尽量正确显示。
6)IP 和端口信息来自额外解析
HTTP 响应本身不会直接告诉你目标域名解析到了哪个 IP,所以这里额外做了一次域名解析。协议是 https 时默认端口记为 443,否则记为 80。这样结果里除了状态码,还能把访问目标的基础网络信息一起展示出来。
7)前端会再做一层结果归纳
查询结果返回后,前端不是机械地把数组打印出来,而是根据最后一个状态码和是否发生重定向,生成更容易理解的摘要:
- 2xx:访问成功
- 3xx 且有跳转:发生重定向
- 4xx:客户端错误
- 5xx:服务器错误
同时还会按状态码给文字加不同颜色,让用户一眼区分成功、跳转和异常结果。
8)这套实现的关键点
这个工具的功能 JS,本质上是在做一条清晰的数据链:
输入 URL -> 规范化 -> 逐跳请求 -> 提取状态与响应头 -> 解析标题/IP/耗时 -> 生成可读结果
从实现角度看,最关键的不是"发起请求"本身,而是把跳转链、响应头、标题和状态归纳成一份普通用户也能看懂的结果。这也是这个 HTTP状态查询 工具的核心实现思路。