网页爬取曾经需要整个设置。启动Playwright或Puppeteer,管理浏览器实例,处理分页,应对JavaScript渲染页面,编写重试逻辑,并自己解析HTML。在爬取单个页面之前要花费半天的工作。
Cloudflare刚刚将所有这些压缩到一个API调用中。
1、新功能
Cloudflare的浏览器渲染现在在公开测试中有一个/crawl端点。你给它一个URL。它爬取整个网站。它以你需要的任何格式返回内容------HTML、Markdown或结构化JSON。
没有浏览器管理。没有脚本。没有需要照看的基础设施。
这可以在Workers免费和付费计划上使用。
2、基础知识
两个请求。这就是整个工作流程。
开始爬取:
# Initiate a crawl
curl -X POST 'https://api.cloudflare.com/client/v4/accounts/{account_id}/browser-rendering/crawl' \
  -H 'Authorization: Bearer <apiToken>' \
  -H 'Content-Type: application/json' \
  -d '{
    "url": "https://blog.cloudflare.com/"
  }'
你获得一个作业ID。爬取在后台异步运行。
检查结果:
# Check results
curl -X GET 'https://api.cloudflare.com/client/v4/accounts/{account_id}/browser-rendering/crawl/{job_id}' \
  -H 'Authorization: Bearer <apiToken>'
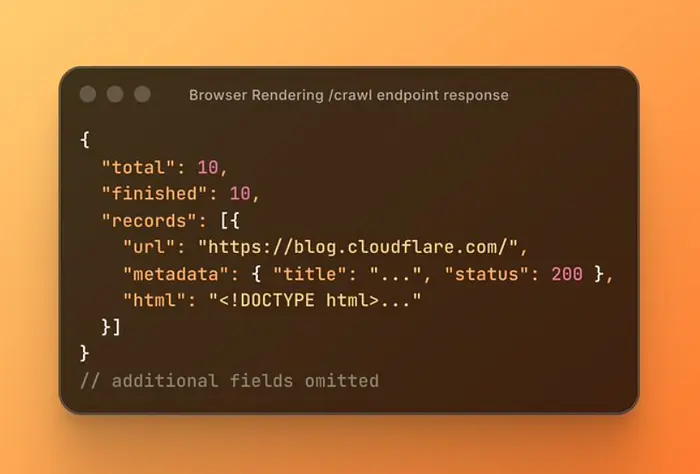
完成后,响应看起来像这样:
{
  "total": 10,
  "finished": 10,
  "records": [{
    "url": "https://blog.cloudflare.com/",
    "metadata": { "title": "...", "status": 200 },
    "html": "<!DOCTYPE html>..."
  }]
}
每个页面都返回其URL、标题、HTTP状态和完整内容。干净。
3、为什么这实际上很重要
明显的用例是Cloudflare提到的那些------模型的训练数据、RAG管道、内容监控。所有这些都需要从站点批量提取内容,而在此之前,这意味着要么为爬取服务付费,要么维护自己的爬取服务。
但这里还有一个微妙的事情。这在无头浏览器中运行。这意味着重JavaScript的站点------单页应用程序、React站点、任何需要JS渲染的东西------在返回内容之前都会被正确渲染。大多数爬虫在没有大量设置的情况下都无法做到这一点。
你不会得到因为内容动态加载而半空的原始HTML。你得到的是真正的浏览器看到的东西。
4、值得了解的控制
当基本爬取不够时,端点有可选参数。
爬取深度和页面限制------设置你想要多深并限制总页面数。当你只想要顶级内容并且不需要深入五个链接时很有用。
通配符URL模式 ------包含或排除特定路径。假设你只想要/blog/内容并想要跳过/docs/。你可以设置它。
URL发现源------爬虫从网站地图、从每个页面上的链接,或两者中发现新页面。你选择。
增量爬取 ------这是一个实用的。使用modifiedSince或maxAge跳过自你上次爬取以来没有更改的页面。如果你在定期计划上运行它来监控站点,你只获取实际新的内容。
静态模式 ------设置render: false,爬虫完全跳过无头浏览器,只是获取原始HTML。对于不需要JavaScript渲染的静态网站快得多。
5、它尊重robots.txt
爬虫遵守robots.txt指令,包括crawl-delay。它被设计为像一个有礼貌的机器人而不是锤子。Cloudflare有关于robots.txt和网站地图最佳实践的文档,以帮助你的爬取从一开始就顺利进行。
6、何时实际使用它
一些场景,这取代了大量自定义工作:
**在文档站点上构建RAG系统。**将爬虫指向文档,以Markdown格式获取所有内容,将其分块,嵌入它。特别是Markdown输出足够干净,可以直接馈送到大多数管道而无需预处理。
**监控竞争对手内容。**每周运行一次增量爬取,将modifiedSince设置为你上次运行的日期。只有更改的页面才会返回。你确切地看到什么是新的。
**创建训练数据。**批量爬取站点,收集HTML或结构化JSON,馈送到你的数据管道。异步作业模型处理大型站点而不会超时。
**一次性研究。**有时你只需要一个站点的所有内容而不需要为它编写脚本。就是这样。
7、结束语
robots.txt最佳实践在developers.cloudflare.com/browser-rendering/reference/robots-txt。
端点目前在公开测试中。免费计划用户可以在没有任何付费承诺的情况下尝试它。
两个curl命令爬取整个站点。这就是我们现在所在的位置。
原文链接:反爬虫大师的网络爬取API - 汇智网