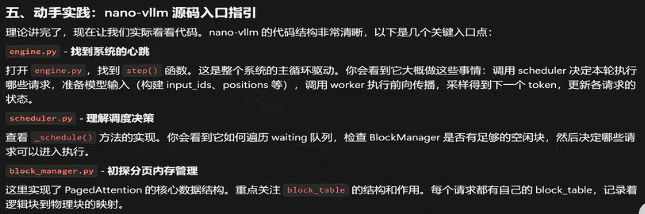
看代码步骤
 1. 调度:决定下一步运行哪些序列
seqs, is_prefill = self.scheduler.schedule()
其中seqs表示被调度的序列列表。
seqs是一个包含 Sequence对象的列表,这些是被调度器选中、将要送入模型进行本次推理的序列。
这些序列的来源:
新请求:第一次运行的序列(需要预填充)
进行中的请求:已生成部分token,需要继续生成的序列
混合批次:可能同时包含新序列和进行中序列
3. 后处理:更新序列状态
self.scheduler.postprocess(seqs, token_ids)更新序列状态什么意思
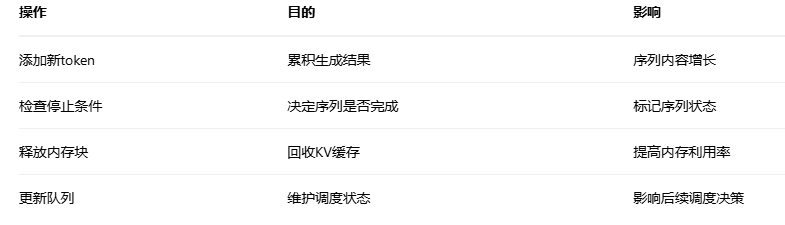
在 LLM 推理中,每个用户请求对应一个Sequence(序列)对象。每次模型生成一个新的 token 后,需要更新这个序列的状态。具体包括:
1.添加新生成的 token 到序列中
python
# 在 Sequence 类中可能有这样的逻辑:
for seq, new_token_id in zip(seqs, token_ids):
    seq.generated_token_ids.append(new_token_id)  # 添加到已生成列表
seq.total_tokens += 1 # 总token数+12.检查序列是否应该结束
需要检查各种停止条件:
-
是否生成了结束符(EOS token)
-
是否达到最大生成长度
-
是否满足特定的停止字符串条件
python
# 伪代码示例
for seq in seqs:
    # 检查EOS token
    if new_token_id == config.eos_token_id:
        seq.is_finished = True

    # 检查最大长度
    if len(seq) >= seq.max_tokens:
        seq.is_finished = True

    # 检查停止字符串
    current_text = tokenizer.decode(seq.generated_token_ids)
    if any(stop_str in current_text for stop_str in seq.stop_strings):
        seq.is_finished = True
3.更新KV缓存的元数据
在vLLM的内存管理中,每个序列的KV缓存存储在特定的内存块中。更新状态包括:
-
记录当前使用了哪些内存块
-
如果序列结束,标记这些块为可回收状态
-
更新序列在内存块中的位置指针
- 更新调度器的内部数据结构
调度器需要维护不同状态的序列:
-
运行中:正在生成token的序列
-
等待中:等待调度的序列
-
已完成:生成结束的序列
postprocess会将已完成的序列从运行队列移到完成队列。
实际例子
假设有两个序列:
-
序列A:已生成 "你好", "世界",还需要继续生成
-
序列B :已生成 "今天天气", "不错",刚生成了结束符
<eos>
执行 postprocess后:
-
序列A的token列表变为 "你好", "世界", "新token"
-
序列B标记为已完成
-
序列B的KV缓存被释放
-
序列B从运行队列移除