引言
雪花算法将64位整数划分为时间戳(41位)、机器ID(10位)和序列号(12位),结合高位位移运算实现毫秒级ID生成,单机每秒可承载超400万次请求。其核心逻辑通过时间有序性确保ID单调递增,同时借助机器ID的分段设计支持横向扩展。然而,时钟回拨问题可能威胁算法的可靠性,为此衍生了多种容错策略,例如短暂等待、备份机器切换及容错序列复用等,兼顾了灵活性与鲁棒性。
雪花算法
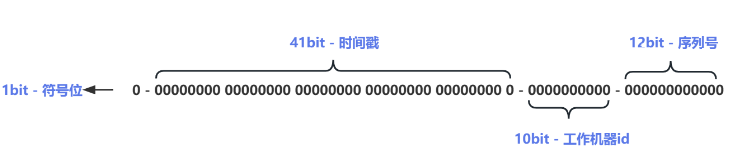
- 符号位:始终为 0,占用 1 位。
- 时间戳:精确到毫秒级,占用 41 位。
- 机器 ID:机器 ID 可以划分为两部分,占用 10 位。其中 5 位是数据中心 ID,另外 5 位是机器 ID。
- 序列号:序列号可以精确控制单位时间内最大生成的 ID 数量,占用 12 位,最大4096并且单调递增。
- 总共 64 位,除去符号位后剩下 63 位,刚好是一个 Java long 类型的取值范围。
Leaf 雪花算法生成逻辑
- 如果当前时间<上次时间,直接抛出异常。
- 如果当前时间=上次时间,序列号累加,当序列号>4095时,会一直等待直到下一毫秒。
- 组装分布式ID,时间戳左移22bit(10机器ID + 12序列号长度)| 机器ID左移12bit(12序列号长度)| 序列号。
雪花算法时钟回拨解决方法
- 如果当前时间<上次时间,直接抛出异常。(Leaf)
- 睡眠3ms,再次比对当前时间和上次时间,如果还存在时钟回拨问题,再抛出异常。
- 使用备份机器号,例如将1024个机器号分半,前512个机器号是有效的,后512个机器号是备份机器号,当0号机器出现问题时,可以使用512号机器作为机器号。
- 使用备份机器,总共10台机器,当0号机器出现问题时使用其他机器生成分布式ID,不太可能所有机器都存在问题。
- 使用上次时间作为时间戳,继续使用最大序列号之后的序列号。
优势
- 空间效率更高,64位整数在现代计算机系统中非常常见,并且足够大,能够容纳大量的唯一ID。64位的空间可以生成非常多的唯一ID,而不会很快用完。
- 性能和实现简单性,使用64位整数使得算法比较简单易实现,且生成ID的速度非常快(只需要在内存中操作位即可),非常适合高并发场景。
- 分布式系统中的唯一性,跨不同的机器和进程生成唯一ID是雪花算法的目标,可以确保在分布式系统中每个生成的ID都是唯一的。
感谢您的阅读!如果文章中有任何问题或不足之处,欢迎及时指出,您的反馈将帮助我不断改进与完善。期待与您共同探讨技术,共同进步!