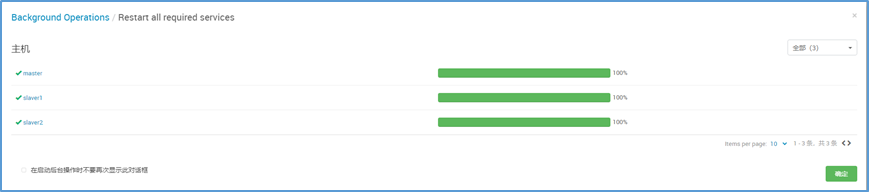
一、停止使用postgreSQL的组件
1.1停止Hive
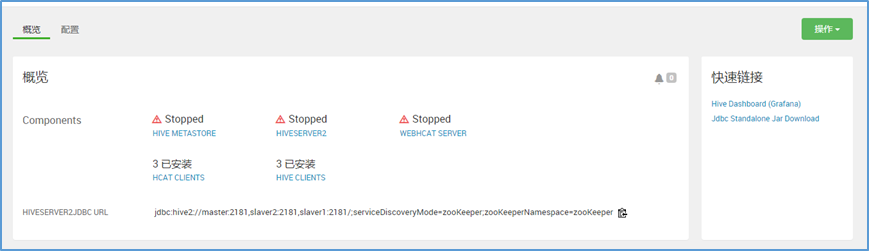
1.2停止ranger
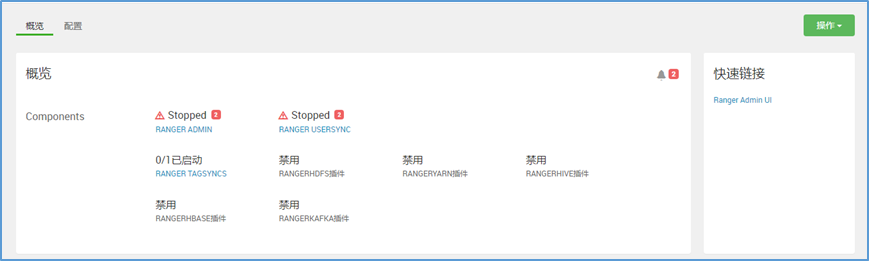
二、停止ambari-server服务
bash
ambari-server status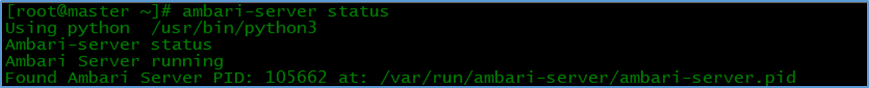
bash
ambari-server stop
备份配置文件目录
bash
tar -czvf /tmp/ambari_server_conf_backup.tar.gz /etc/ambari-server/conf备份密钥目录
bash
tar -czvf /tmp/ambari_server_keys_backup.tar.gz /var/lib/ambari-server/keys记录当前数据库连接信息
bash
grep "jdbc" /etc/ambari-server/conf/ambari.properties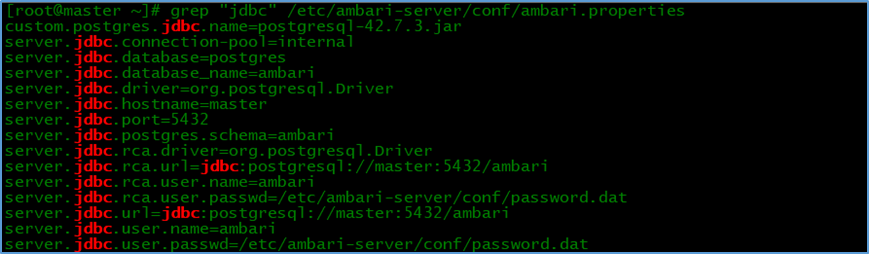
三、备份数据库(postgreSQL)
bash
su - postgres
cd /var/lib/pgsql/backups/
ambari
pg_dump -U ambari -h ambari_server_ip_address -d ambari -F c -b -v -f ambari_backup.dump
pg_dump -U ambari -h ambari_server_ip_address -d ambari -F p -b -v -f ambari_backup.sql
hive
pg_dump -U hive -h ambari_server_ip_address -d hive -F c -b -v -f hive_backup.dumppg_dump -U hive -h ambari_server_ip_address -d hive -F p -b -v -f hive_backup.sql
ranger
pg_dump -U ranger -h ambari_server_ip_address -d ranger -F c -b -v -f ranger_backup.dump
pg_dump -U ranger -h ambari_server_ip_address -d ranger -F p -b -v -f ranger_backup.sql
rangerkms
pg_dump -U rangerkms -h ambari_server_ip_address -d rangerkms -F c -b -v -f rangerkms_backup.dump
pg_dump -U rangerkms -h ambari_server_ip_address -d rangerkms -F p -b -v -f rangerkms_backup.sql
全局角色信息
bash
pg_dumpall -U postgres --globals-only -f postgres_globals.sql四、目标环境准备
4.1安装postgresql
bash
yum install postgresql-server.x86_64
/usr/bin/postgresql-setup --initdb
配置postgresql
bash
vim /var/lib/pgsql/data/postgresql.conf
bash
listen_addresses = '*'
max_connections = 1000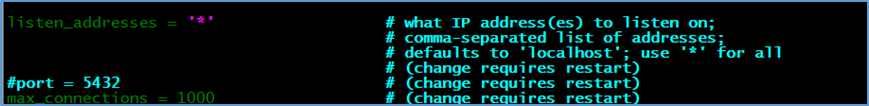
bash
vim /var/lib/pgsql/data/pg_hba.conf
bash
host ambari ambari 0.0.0.0/0 md5
host hive hive 0.0.0.0/0 md5
host ranger ranger 0.0.0.0/0 md5
host rangerkms rangerkms 0.0.0.0/0 md5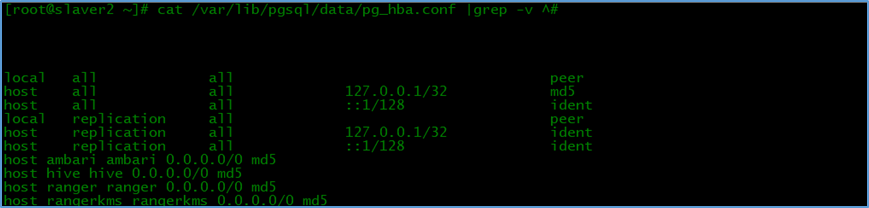
重启postgreSQL
bash
systemctl restart postgresql.service创建数据库及用户
导入全局角色
bash
su - postgres
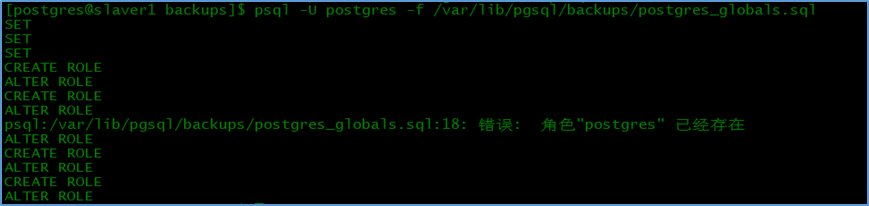
psql -U postgres -f /var/lib/pgsql/backups/postgres_globals.sql
角色postgres导入忽略报错
创建数据库
bash
psql
sql
CREATE DATABASE ambari OWNER ambari;
CREATE DATABASE hive OWNER hive;
CREATE DATABASE ranger OWNER ranger;
CREATE DATABASE rangerkms OWNER rangerkms;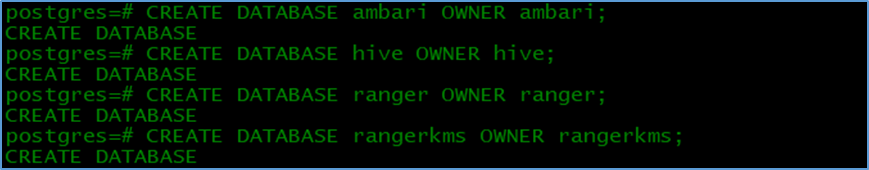
授予权限
sql
GRANT ALL PRIVILEGES ON DATABASE ambari TO ambari;
GRANT ALL PRIVILEGES ON DATABASE hive TO hive;
GRANT ALL PRIVILEGES ON DATABASE ranger TO ranger;
GRANT ALL PRIVILEGES ON DATABASE rangerkms TO rangerkms;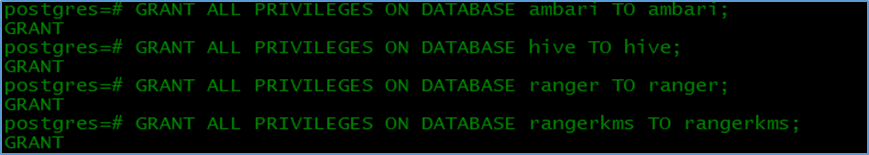
4.2导入数据库
导入ambari
bash
psql -U ambari -d ambari -h new_ambari_server_ip_address -f /var/lib/pgsql/backups/ambari_backup.sql
psql -U hive -d hive -h new_ambari_server_ip_address -f /var/lib/pgsql/backups/hive_backup.sql
psql -U ranger -d ranger -h new_ambari_server_ip_address -f /var/lib/pgsql/backups/ranger_backup.sql
psql -U rangerkms -d rangerkms -h new_ambari_server_ip_address -f /var/lib/pgsql/backups/rangerkms_backup.sql
4.3安装ambari-server
bash
yum install ambari-server
初始化ambari
bash
ambari-server setup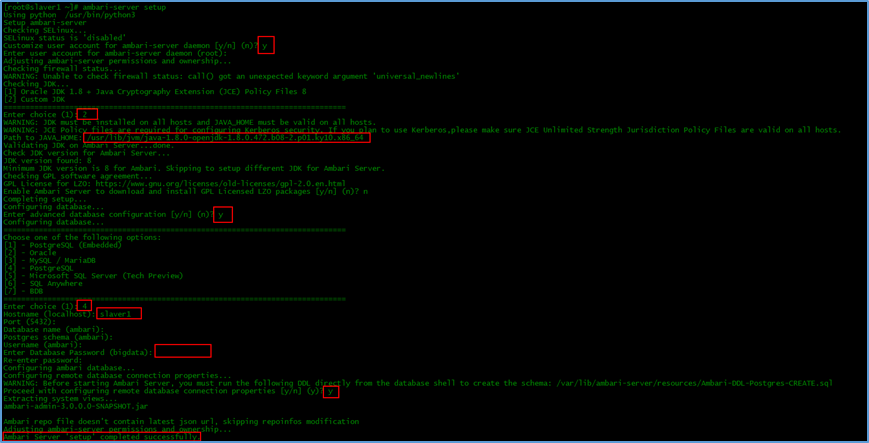
bash
scp old_ambari_server:/var/lib/ambari-server/resources/postgresql-42.7.3.jar new_ambari_server:/tmp/
ambari-server setup --jdbc-db=postgres --jdbc-driver=/tmp/postgresql-42.7.3.jar
4.4验证导入结果
bash
psql -U ambari -d ambari -h new_ambari_server_ip_address -c "SELECT COUNT(*) FROM clusters;"
bash
psql -U ambari -d ambari -h new_ambari_server_ip_address -c "SELECT COUNT(*) FROM hosts;"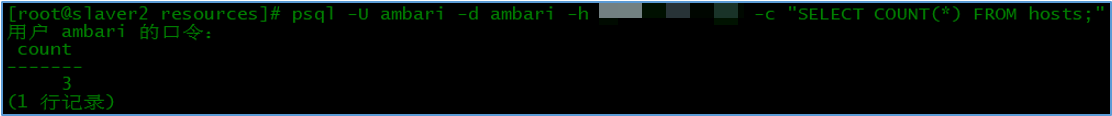
五、切换ambari server
启动新的ambari-server节点:
bash
ambari-server start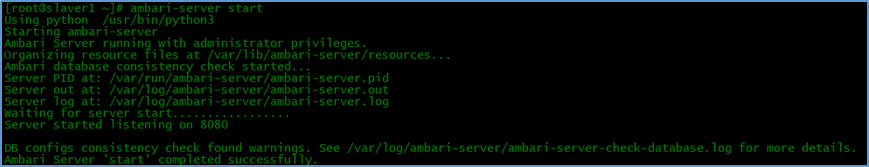
修改所有agent的配置项/etc/ambari-agent/conf/ambari-agent.ini的hostname=新的server hostname
bash
ansible -i /home/security/hosts agent -b -m shell -a "cp /etc/ambari-agent/conf/ambari-agent.ini /etc/ambari-agent/conf/ambari-agent.ini.bak"
ansible -i /home/security/hosts agent -b -m shell -a "sed -i 's/^hostname=.*/hostname=新的AmbariServer地址/' /etc/ambari-agent/conf/ambari-agent.ini"
ansible -i /home/security/hosts agent -b -m shell -a "ambari-agent restart "
六、登录ambari修改组件配置
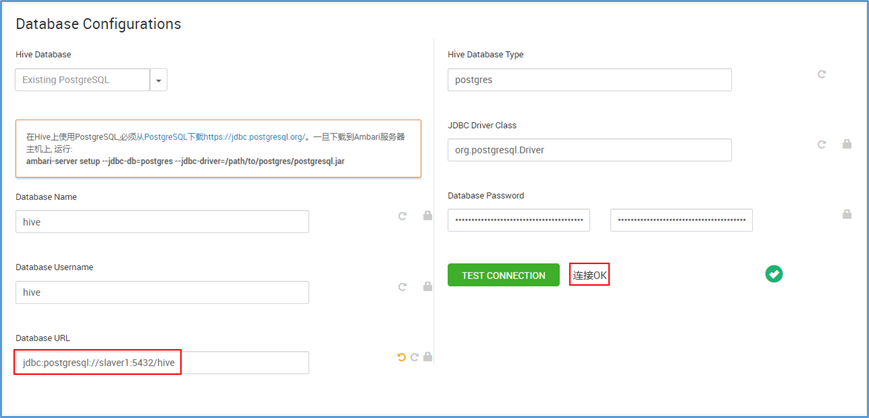
6.1修改Hive配置
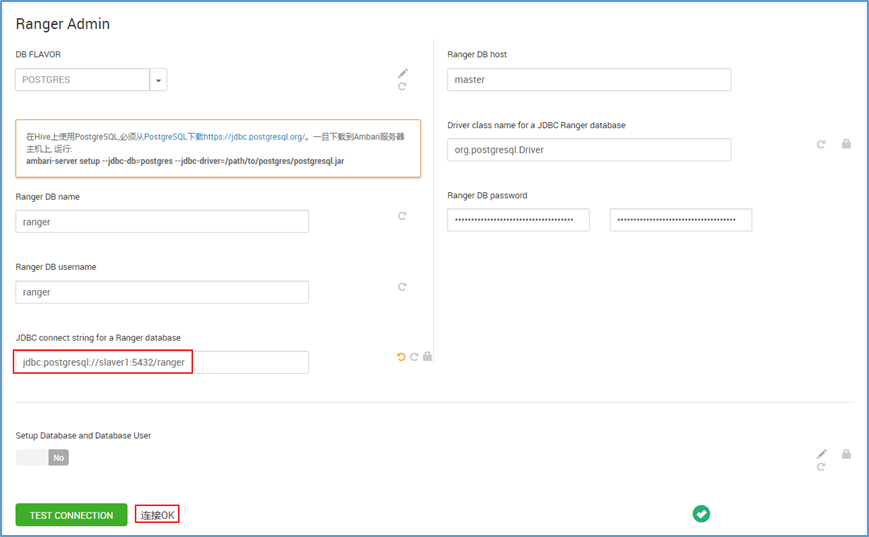
6.2修改ranger配置
6.3重启所需的服务