第1章:准备工作与初窥门径
1.1 为什么我们要读懂汇编?(哪怕我们平时只写高级语言)
绝大多数程序员日常都在写 Python、Java、Go,哪怕是 C 语言,也被称为"高级语言"。高级语言屏蔽了机器的物理细节,让我们专注于业务逻辑。既然编译器(Compiler)已经那么强大,能帮我们把 C 代码翻译成机器能懂的0和1,为什么我们还要自找麻烦,去啃晦涩难懂的机器级代码(汇编语言)呢?
在工程现实中,原因主要有以下四个核心痛点,我大概说一下,不会太深入:
1. 性能调优:看破编译器的"自作聪明"与"无能为力" 编译器(如 GCC 或 Clang)在开启优化(比如 -O1, -O2)时,会对你的 C 代码进行大改。有时它会将循环展开,有时会把变量直接塞进寄存器而不是写回内存。 但是,编译器不是神。当你写了一段自认为效率很高的代码,但在高并发场景下却成了性能瓶颈时,只有通过查看生成的汇编代码,你才能确切知道 CPU 到底在执行什么指令。 你会发现,也许是你的一行错误代码阻止了编译器的优化,或者引发了频繁的内存读写。读懂汇编,是写出极致性能代码(如高频交易系统、游戏引擎底层的核心算法)的必经之路。
2. 调试底层 Bug:定位那些"凭空出现"的崩溃 在高级语言中,数组越界可能会直接抛出异常(如 Java)。但在 C 语言中,数组越界可能不会立刻报错,而是默默覆盖了相邻的内存数据,导致程序在几秒钟后、在另一个完全不相关的函数里崩溃(Segmentation Fault)。 遇到这种"幽灵 Bug",传统的单步调试 C 代码往往无济于事。此时,你必须在机器级层面查看栈帧(Stack Frame)的状态、寄存器的值,才能揪出那个悄悄破坏内存的罪魁祸首。
3. 安全防御与漏洞利用:黑客的真正战场 :缓冲区溢出攻击(Buffer Overflow),其本质并不是 C 语言层面的游戏,而是汇编层面的内存覆写。黑客通过输入精心构造的恶意数据,溢出当前函数的局部变量区域,精准覆盖掉栈上的"返回地址"(Return Address),从而将 CPU 的执行流劫持到黑客自己的恶意代码(Shellcode)上。 不懂汇编和函数调用约定(Calling Convention),你不仅无法理解这些经典攻击是如何成功的,更无法理解现代操作系统(如栈金丝雀、ASLR)是如何防御它们的。
4. 降维打击:建立计算机系统的全局观 写高级语言就像是在开自动挡汽车,踩油门就走,踩刹车就停。而学习汇编,就是打开引擎盖,去了解气缸是如何运作的,变速箱是如何换挡的。当你真正理解了高级语言中的 if-else、for 循环、多态、指针在底层无非是几条简单的 cmp(比较)和 jmp(跳转)指令,以及内存地址的加减法时,你对代码的恐惧感会彻底消失。无论学习什么新语言,你都能一眼看透它的本质。
总结一下: 我们学习汇编,绝对不是为了用汇编去从头写复杂的项目(那是上个世纪的做法)。我们学习它,是为了能够"阅读"它。我们要做的是能够对比 C 语言源码和编译器生成的汇编代码,借此分析程序的性能、排查深层 Bug、防御安全漏洞。
1.2 窥探 CPU 内部的核心架构
你一定听过"CPU 是计算机的大脑"这句话。但如果你真的潜入底层,你会发现 CPU 其实是一个极其机械、极其死板,但动作极快的流水线工人。
在汇编程序员的眼中,整个计算机世界可以极度简化为三个核心部件:内存(Memory) 、寄存器(Registers) 和 程序计数器(PC)。
1. 内存 (Memory / RAM)
在底层看来,内存不仅仅是用来存你的照片和电影的。内存是一个超级大的、连续的字节数组。 最关键的一点是:冯·诺依曼架构规定,程序的数据(比如你的变量 a = 5)和程序的指令(比如 movq 这些编译出来的机器码),都混在同一个内存里。 CPU 闭着眼睛去内存里抓取,抓到数据就计算,抓到指令就执行。
2. 寄存器 (Registers) ------ CPU 的"贴身口袋"
既然有了几 GB 的内存,为什么 CPU 内部还需要寄存器? 答案是:速度 。 如果 CPU 每次做加法都要跑去内存里拿数据,那就像是一个大厨每次切菜都要跑去 10 公里外的农贸市场买洋葱一样慢。 为了解决这个问题,CPU 内部内置了极其少量的存储空间,叫做寄存器 。在 x86-64 架构中,有 16 个核心的通用寄存器(我们会在第 2 章详细讲它们的名字和用途)。它们就像是大厨案板上的小碗,存取速度和 CPU 的计算速度一样快。 汇编代码里超过一半的指令,都是在把数据从内存搬到寄存器,或者从寄存器搬回内存。
3. 程序计数器 (Program Counter / PC) ------ x86 里的 RIP
既然指令都存在内存里,CPU 怎么知道接下来该执行哪一条指令呢? 这就全靠 程序计数器(在 x86-64 架构中,这个寄存器叫做 %rip) 。 你可以把 PC 想象成看书时夹的书签 。它里面只存一个东西:下一条将要执行的指令在内存中的地址。
CPU 的终极工作循环 (Fetch-Decode-Execute)
CPU 在死循环做下面这三件事,永不停歇:
-
取指 (Fetch) :CPU 看一眼 PC(
%rip)里存的地址,去内存的那个地址把指令拿出来。 -
译码 (Decode):CPU 看一眼这条指令,哦,这是一条加法指令。
-
执行 (Execute) :CPU 执行加法,更新寄存器里的值。然后,自动把 PC 的值加上这条指令的长度,指向下一条指令。
实例
准备一段极简代码 :
cpp
long mult2(long a, long b) {
    long s = a * b;
    return s;
}

void multstore(long x, long y, long *dest) {
    long t = mult2(x, y);
    *dest = t;
}
第一步:预处理 (Preprocessing) ------ 帮我们"整理"代码 我们平时代码里写的 #include <stdio.h> 或者 #define MAX 100,其实 C 语言本身并不认识。 预处理器的作用,就是把这些宏定义展开,把头文件的内容复制粘贴进来,去掉所有的注释。
我们手动执行预处理:
gcc -E mstore.c -o mstore.i
第二步:编译 (Compilation) ------ C语言变身汇编语言(最关键的一步!) 这是最神奇的一步!编译器会阅读你的 C 代码,将其翻译成人类还能看懂的、最接近机器指令的汇编代码 (Assembly)。
我们将 mstore.c 编译成汇编代码,并且开启一级优化 (-O1),这能让汇编代码更简洁易读:
gcc -O1 -S mstore.c -o mstore.s
现在,打开生成的 mstore.s 文件,你会看到类似这样的东西:
cpp
multstore:
    pushq   %rbx
    movq    %rdx, %rbx
    call    mult2
    movq    %rax, (%rbx)
    popq    %rbx
    ret
不要害怕!这就是底层世界的入场券。 虽然你现在可能看不懂 pushq、movq,但你只需要知道:这就是你的 C 代码经过翻译后的真实样貌,每一行对应着 CPU 的一个基础操作。
小结: 从 .c (源代码) -> .i (预处理代码) -> .s (汇编代码) -> .o (目标机器码) -> 最终可执行文件,这就是一个程序诞生的全过程。
第2章:数据格式与核心寄存器
2.1 C 语言数据类型在底层的真实大小
在 C 语言里,我们有 char, short, int, long, float, double 等等各种数据类型。C 语言编译器会在编译时严格检查类型匹配,防止你把字符串赋值给整数。
但在 CPU 眼里,根本没有"类型"这个概念。 CPU 不知道什么是整数,什么是字母,什么是内存地址。CPU 只认一个东西:数据的尺寸(大小)。
CPU 操作内存和寄存器时,唯一的区别就是:"我是该搬运 1 个字节 ,还是 4 个字节 ,还是 8 个字节?"
1. 历史遗留的奇葩命名法:什么是"字"?
为了看懂汇编代码,我们必须先接受 Intel 的一个历史包袱:
-
在几十年前的老古董 16 位处理器(Intel 8086)时代,CPU 一次只能处理 16 位(2 个字节)的数据,所以 Intel 把 16 位(2 字节)定义为一个"字 (Word)"。
-
后来 CPU 进化成了 32 位,但为了保持名字的向后兼容,32 位(4 字节)就被叫做"双字 (Double word)"。
-
现在我们的电脑都是 64 位了,64 位(8 字节)就被顺理成章地叫作"四字 (Quad word)"。
2. 必备的底层"翻译字典"
这就是 C 语言类型与底层汇编指令的映射表。这张表非常重要,它是我们阅读所有汇编代码的基石。 注意看"汇编指令后缀"那一列。
| C 语言数据类型 | 底层实际含义 | 汇编指令后缀 | 占用空间 (字节 Bytes) |
|---|---|---|---|
char |
字节 (Byte) | b |
1 |
short |
字 (Word) | w |
2 |
int |
双字 (Double word) | l |
4 |
long |
四字 (Quad word) | q |
8 |
任何指针 (如 char *) |
四字 (Quad word) | q |
8 (在 64 位系统中) |
float (单精度浮点) |
单精度 (Single) | s |
4 |
double (双精度浮点) |
双精度 (Double) | l |
8 |
注:你会发现 int 和 double 的汇编后缀都是 l。不用担心混淆,因为 CPU 处理浮点数和整数用的是完全两套不同的指令和寄存器,所以后缀一样也不会认错。
3. 实例验证:见证后缀
我们经常在汇编里看到 mov 指令,它的意思是把数据从 A 搬到 B。因为数据大小不同,mov 会变形。
看下面这段 C 代码对应的汇编动作:
cpp
char  a = 1;      // 1个字节
int   b = 2;      // 4个字节
long  c = 3;      // 8个字节
int  *p = &b;     // 指针,存的是内存地址
cpp
movb  $1, ...     # movb (move byte):搬运 1 字节数据
movl  $2, ...     # movl (move long/double word):搬运 4 字节数据
movq  $3, ...     # movq (move quad word):搬运 8 字节数据
movq  地址, ...   # 任何指针在 64 位机器上都是 8 字节,所以一律用 movq
小结: 以后当你看到汇编代码里带有 b、w、l、q 后缀时,你的大脑要立刻条件反射出:它们分别在操作 1 字节(char)、2 字节(short)、4 字节(int)和 8 字节(long 或指针)的数据。
2.2 x86-64 的 16 个通用寄存器全解析
在 1.4 节我们说过,寄存器是 CPU 内部速度极快的"贴身口袋"。在 x86-64 架构下,CPU 给了我们 16 个 64位(8字节)的通用寄存器。
汇编代码里满屏幕都是带 % 号的单词(比如 %rax, %rsp),如果你不认识它们,看汇编就像看天书。但只要你懂了它们的命名规则和分工,一切都会变得像呼吸一样自然。
1. 寄存器的"套娃"命名法则(彻底解决名字记不住的问题)
这 16 个寄存器,其实并不是只有 16 个名字。因为历史原因(从 16 位 CPU 进化到 32 位,再到 64 位),为了向下兼容,同一个寄存器有 4 个不同的名字,分别对应它不同的使用尺寸!
以最著名的 "累加寄存器 (Accumulator)" 为例,它的 64 位全名是 %rax:
-
如果指令只想用它的 低 8 位(1 个字节) ,汇编里就叫它
%al(a-low)。 -
如果指令想用它的 低 16 位(2 个字节) ,汇编里就叫它
%ax。 -
如果指令想用它的 低 32 位(4 个字节) ,汇编里就叫它
%eax(e 代表 extended)。 -
如果指令想用 完整的 64 位(8 个字节) ,汇编里就叫它
%rax(r 代表 register)。
心记住:%rax, %eax, %ax, %al 物理上是同一个盒子! 只是你抓取数据的尺寸不同而已。
规律总结:
-
R 开头的是 64 位(如
%rax) -
E 开头的是 32 位(如
%eax) -
后续新增的 8 个寄存器命名比较粗暴,叫
%r8到%r15。它们的 32 位版本叫%r8d(d代表 double word),16位叫%r8w(w代表 word),8位叫%r8b(b代表 byte)。
2. 16 个寄存器的"专属分工" (The VIP List)
虽然名字叫"通用寄存器",意思是它们都可以用来做加减乘除,但在 C 语言编译器(GCC)的规则里,它们有着极其严格的分工潜规则(调用约定 Calling Convention)。
这是你阅读汇编必备的字典,重点看前 8 个:
| 64 位全名 | 32 位名字 | 主要分工与用途 (重点记忆!) |
|---|---|---|
%rax |
%eax |
【返回值】 :函数运行结束时,return 的结果永远放在这里。 |
%rdi |
%edi |
【参数 1】:调用函数时,第 1 个参数放这里。 |
%rsi |
%esi |
【参数 2】:调用函数时,第 2 个参数放这里。 |
%rdx |
%edx |
【参数 3】:第 3 个参数。 |
%rcx |
%ecx |
【参数 4】:第 4 个参数。 |
%r8 |
%r8d |
【参数 5】:第 5 个参数。 |
%r9 |
%r9d |
【参数 6】:第 6 个参数。 |
%rsp |
%esp |
【栈指针 (Stack Pointer)】:极度重要!永远指向栈顶,千万别乱动它。 |
%rbp |
%ebp |
【帧指针 / 被调用者保存】:曾经用来指向当前栈的底部,现在常被当做普通寄存器用。 |
%rbx |
%ebx |
【被调用者保存】:普通数据存储。 |
%r10 |
%r10d |
【调用者保存】:普通数据存储。 |
%r11 |
%r11d |
【调用者保存】:普通数据存储。 |
%r12 ~ %r15 |
%r12d ~ %r15d |
【被调用者保存】:普通数据存储。 |
3. 实例验证:C 语言函数调用与寄存器的映射
光看表格没感觉,我们来看一个实际的 C 代码例子,看看它是怎么严格遵守上述寄存器规则的。
C 语言源码:
cpp
long add_three_numbers(long a, long b, long c) {
    long sum = a + b + c;
    return sum;
}
对应的核心汇编代码(伪代码拆解):
bash
add_three_numbers:
    # 刚进入函数时,外界已经帮我们把参数放好了:
    # %rdi 里面装的是参数 a
    # %rsi 里面装的是参数 b
    # %rdx 里面装的是参数 c

    # 第一步:把 a 挪到 %rax 里 (准备做加法,而且 %rax 最后要当返回值)
    movq    %rdi, %rax

    # 第二步:把 b 加到 %rax 上 (%rax = a + b)
    addq    %rsi, %rax

    # 第三步:把 c 加到 %rax 上 (%rax = a + b + c)
    addq    %rdx, %rax

    # 函数结束,返回!此时 %rax 里正好是我们算出的 sum
    ret
你看,没有声明任何局部变量,CPU 直接利用 %rdi, %rsi, %rdx 接收参数,并利用 %rax 一边做计算一边作为最终的返回值。这就是底层的效率!
小结: 这一节你需要刻在脑子里的只有两件事:
-
%rax= 返回值 -
%rdi,%rsi,%rdx等 = 函数传递的参数
当这 16 个寄存器的数据不能满足计算时,CPU 就需要去内存里找数据了。
2.3 寻址模式大观(Addressing Modes):CPU 的"内存 GPS"
在上一节,我们知道数据可以存在寄存器里。但寄存器太少了,大部分数据(比如大数组、长字符串、复杂的结构体)都必须存在内存里。
当 C 语言里的指针 p 或者数组 arr[i] 被翻译成汇编时,CPU 必须有一个极其精准的公式,来计算出数据在内存中的绝对物理位置。这就是寻址模式。
x86-64 架构虽然指令繁多,但它访问内存的终极奥义,全部浓缩在了一个"万能公式"里。
1. x86-64 的内存寻址"万能公式"
在汇编代码中,表示内存地址的标准格式长这样: D(Rb, Ri, S)
CPU 看到这个表达式,会自动在内部进行一次数学计算,算出最终的内存地址:
最终内存地址 = Rb + Ri * S + D
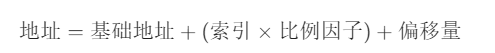
这四个字母分别代表:
-
Rb(Base Register / 基址寄存器) :可以是你上一节学过的任何一个 64 位通用寄存器(如%rdi,%rbx)。它通常存着一个基础地址(比如数组的开头,或者对象的指针)。 -
Ri(Index Register / 变址寄存器) :除了%rsp之外的任何 64 位通用寄存器。它通常代表"索引"或"偏移计数"(比如for循环里的i)。 -
S(Scale / 比例因子) :这是一个极度死板的常数,只能是 1、2、4 或 8。为什么只有这四个?回想一下 2.1 节,因为 C 语言的基本数据类型大小就是 1(char), 2(short), 4(int), 8(long/指针)! -
D(Displacement / 偏移量):一个立刻就能知道的常数(立即数),可以是正数也可以是负数。
2. 万能公式的"降维打击"(常见寻址方式)
这个万能公式平时很少四个参数全满,它经常省略掉其中几个,演变成我们在汇编中最常见的几种形态。请把下面这张表当成你的"汇编阅读字典":
| 寻址模式名字 | 汇编格式写法 | CPU 实际计算的地址 | 对应的 C 语言场景(极度重要!) |
|---|---|---|---|
| 间接寻址 | (%rax) |
地址 = %rax 的值 |
指针解引用 :*p |
| 基址 + 偏移量 | 8(%rax) |
地址 = %rax + 8 |
结构体成员访问 / 类的属性 :p->age 或访问栈上的局部变量。 |
| 变址寻址 | (%rbx, %rcx) |
地址 = %rbx + %rcx |
无特定类型大小的偏移 |
| 比例变址 | (%rbx, %rcx, 4) |
地址 = %rbx + %rcx * 4 |
数组访问 :arr[i] (假设数组元素是 4 字节的 int)。 |
| 终极完全体 | 16(%rbx, %rcx, 8) |
地址 = %rbx + %rcx * 8 + 16 |
复杂对象数组访问 :objArray[i].field |
我们可以把 CPU 想象成一个"外卖小哥",而寻址模式就是客户给他的"收货地址写法"。
有些地址很直接,有些地址却需要小哥自己算一下。
立即数寻址 (Immediate) ------ "直接给你东西"
这不是找地址,而是直接给数值。
-
汇编写法 :
MOV EAX, 100 -
比喻:外卖小哥不用跑腿,我直接把 100 块钱塞他手里。
-
用途:给变量赋初值。
寄存器寻址 (Register) ------ "东西就在你兜里"
数据就在 CPU 的寄存器里,速度最快。
-
汇编写法 :
MOV EAX, EBX -
比喻:小哥问:"货呢?" 答:"就在你左手提着的袋子里。"
-
用途:寄存器之间的数据快速交换。
间接寻址 (Indirect) ------ "按门牌号找人"
这是指针的本质。寄存器里存的是一个地址。
-
汇编写法 :
MOV EAX, [EBX](注意方括号,代表"去 EBX 指向的地方") -
比喻 :客户说:"货在 101 号房间,你自己去拿。" EBX 里存的就是
101。 -
用途 :解引用指针(
*p)。
变址/比例寻址 (Scaled Indexed) ------ "最强 GPS"
这是最复杂的模式,专门为数组设计的。
-
汇编公式 :
[Base + Index * Scale + Disp] -
例子 :
MOV EAX, [RBP + RDI * 4 + 8] -
拆解这个 GPS:
-
Base (RBP):数组的起始地址(家门口)。
-
Index (RDI):数组的下标(第几个元素)。
-
Scale (4) :每个元素的大小(比如
int占 4 字节)。 -
Disp (8):额外的偏移量(比如跳过结构体开头的某些成员)。
-
3. 实例验证:C 语言代码如何触发这些公式?
让我们看一段稍微复杂一点的 C 语言代码,看看编译器是如何妙用这个万能公式的:
cpp
// 假设有这样一个数组和指针
// short 占 2 个字节
void update_array(short *arr, long i, short val) {
    arr[i] = val;
}
对应的汇编代码分析: 回想 2.2 节的传参潜规则:
-
arr(数组起始地址) 在%rdi里。 -
i(数组索引) 在%rsi里。 -
val(要赋的值) 在%rdx里(其实只用了低 16 位的%dx)。
执行 arr[i] = val 的汇编代码只有极其精妙的一行:
cpp
movw %dx, (%rdi, %rsi, 2)CPU 是如何执行这一行的?
-
看到
movw,CPU 知道要搬运 2 个字节(Word)。 -
把源数据(寄存器
%dx里的val)拿在手上。 -
计算目标内存地址:使用公式
D(Rb, Ri, S),此时D省略(为0),Rb是%rdi,Ri是%rsi,S是 2。地址 =%rdi(数组开头) +%rsi(索引 i) * 2 (每个 short 占 2 字节)。 -
完美!精准定位到了
arr[i]的物理内存位置,将数据塞进去。
小结: 以后看到汇编里带括号的东西,比如 8(%rax, %rbx, 4),千万不要慌。在脑子里立刻套用 地址 = Rb + Ri * S + D 这个公式,你就瞬间明白了 CPU 到底在摸哪块内存。
第3章:数据传送与内存访问
3.1 最核心的搬运工:mov 指令家族
如果你随便打开一个编译好的真实程序,你会震撼地发现:里面有将近一半的指令全是 mov! CPU 就像一个极度勤奋的搬砖工,它绝大部分的时间都在把数据从内存搬到寄存器,或者从寄存器搬回内存。
mov 指令的语法非常简单(注意我们用的是 CSAPP 里的 AT&T 格式,左边是源,右边是目的):
cpp
mov 源头(Source), 目的地(Destination)因为数据的尺寸不同,mov 会带上我们在 2.1 节学过的后缀,变成:movb (1字节), movw (2字节), movl (4字节), movq (8字节)。
1. 数据能从哪搬到哪?(操作数组合表)
在汇编里,数据存在三种形态:
-
立即数 (Immediate) :就是常数,前面必须加
$符号,比如$5,$-147,$0x1F。 -
寄存器 (Register) :比如
%rax,%rdi。 -
内存 (Memory) :带有括号的寻址公式,比如
(%rax),8(%rbp)。
看下面这张极其重要的组合表,它规定了搬砖的合法路线:
| 源头 (Source) | 目的地 (Destination) | 汇编例子 | 对应的 C 语言含义 |
|---|---|---|---|
| 立即数 | 寄存器 | movq $5, %rax |
temp = 5; |
| 立即数 | 内存 | movl $5, (%rdi) |
*p = 5; |
| 寄存器 | 寄存器 | movq %rax, %rbx |
temp2 = temp1; |
| 寄存器 | 内存 | movq %rax, (%rdi) |
*p = temp; |
| 内存 | 寄存器 | movq (%rdi), %rax |
temp = *p; |
2. 底层第一铁律:绝对禁止"内存到内存"的直接搬运!
你仔细观察上面的表格,会发现少了一种组合:内存 -> 内存 。 这是 x86-64 架构的一条死规定:一条单独的 mov 指令,不能直接把数据从一个内存地址拷贝到另一个内存地址。
(为什么?因为 CPU 的电路设计决定了它一次只能访问一次内存,要么读,要么写,不能同时又读又写两块不同的内存。)
实例:C 语言与汇编的碰撞
假设我们有一段最简单的 C 代码,把指针 src 里的值,赋给指针 dest:
cpp
void copy_value(long *src, long *dest) {
    *dest = *src;
}
在 C 语言里,这只是一行代码。但在底层的汇编里,CPU 必须找个中间人(寄存器)来倒个手。
回忆一下传参规则:src 的地址在 %rdi,dest 的地址在 %rsi。 真实生成的汇编是这样的两步走:
cpp
copy_value:
    # 第一步:把源内存的数据,搬到寄存器 %rax 里 (Mem -> Reg)
    movq    (%rdi), %rax

    # 第二步:把寄存器 %rax 里的数据,搬到目标内存里 (Reg -> Mem)
    movq    %rax, (%rsi)
    ret
3. 一个反直觉的底层"暗坑":movl 的高位清零
mov 家族有一个特殊规定,无数初学者在这里栽跟头,你必须记住它: 当使用 movl(搬运 4 个字节,比如 C 里的 int)作为指令,且目的地是一个寄存器时,CPU 会自动把这个 64 位寄存器的高 32 位全部清零!
你可以把 64 位的寄存器 %rax 想象成一块长条形的黑板,这块黑板被划分成了好几个区域:
-
整块黑板 :
%rax(64位) -
右半边 :
%eax(32位) -
右下角更小的一块 :
%ax(16位)
现在你要往黑板上写字(执行 mov 指令),CPU 面临着两种截然不同的工作方式:
1. 为什么 8位/16位 会"保留高位"?(小心翼翼地修改)
当你执行 movw(写 16 位)去修改右下角时,CPU 的操作逻辑是:合并(Merge)。
-
CPU 心想:"主人只让我改右下角那一丁点,黑板上其他地方画的东西我不能弄坏!"
-
代价:CPU 必须先"看一眼"黑板上原本有什么,把新数据贴上去,再把整个黑板重新拼好。这在 CPU 内部会导致一个问题,叫做"虚假依赖(False Dependency)"。CPU 必须等待上一条用到这块黑板的指令完全执行完,才能进行这种"精细的拼图作业",这会让处理器的运行速度变慢。
2. 为什么 32位(movl)会"高位清零"?(简单粗暴地推平)
时间来到了 64 位处理器被发明的年代(AMD 制定 x86-64 标准时)。工程师们发现,32 位的运算(比如 C 语言里的 int)在代码里用得实在太频繁了。如果每次 movl 都要像上面那样"小心翼翼地合并拼图",CPU 根本快不起来。
于是工程师们拍板做了一个强制且双标的规定:
-
当执行
movl写%eax时,CPU 心想:"反正右半边都要被覆盖了,左半边我干脆也不保留了,直接把左半边全部擦成零(0)!" -
好处 :CPU 再也不用去管这块黑板以前写了什么垃圾数据,也不用等前面的指令了。它直接拿一块全新的黑板覆盖你的原本黑板,左边填 0,右边填你的数据,瞬间完成!这极大地提升了 CPU 乱序执行和流水线的性能。
举个例子: 假设 %rax 里面原本存着一串全 F 的数据:0xFFFFFFFF FFFFFFFF 然后执行一条指令:
代码段
cpp
movl $-1, %eax # 将 32 位的 -1 放入 %eax 32 位的 -1 = 0xFFFFFFFF
直觉上,你觉得 %rax 会变成 0xFFFFFFFF FFFFFFFF 对吧? 错! 实际结果是 %rax 变成了 0x00000000 FFFFFFFF。 CPU 强制把高 32 位变成了 0。
| 指令位宽 | 举例指令 | CPU 的内心戏 | 最终 %rax 的结果 |
|---|---|---|---|
| 16位 (写一半的一半) | movw $-1, %ax |
"只改最小的角落,其他不动。" | 0xFFFFFFFF FFFFFFFF |
| 32位 (写一半) | movl $-1, %eax |
"为了速度,我把高位直接抹零!" | 0x00000000 FFFFFFFF |
3.2 符号扩展与零扩展(小数据放进大容器)
在 C 语言中,当你把一个 char 赋值给一个 int 时,编译器在底层必须做"数据填充"。填充的规则完全取决于这个数据是有符号(Signed)还是无符号(Unsigned)。
为此,x86-64 提供了两套完全不同的 mov 变体:
1. 零扩展(Zero Extension):无脑填 0 的 movz 家族
适用场景 :用于 C 语言中的无符号数(unsigned)转换。 底层动作 :把源数据原封不动搬过去,大容器多出来的高位,全部用 0 填充。
指令格式是 movz 加上两个尺寸后缀(先写源大小,再写目的大小):
| 汇编指令 | 英文全拼 | 动作含义 |
|---|---|---|
movzbw |
Move with Zero extension, B yte to Word | 1 字节搬到 2 字节,高位填 0 |
movzbl |
Move with Zero extension, B yte to Long | 1 字节搬到 4 字节,高位填 0 |
movzbq |
Move with Zero extension, B yte to Quad | 1 字节搬到 8 字节,高位填 0 |
movzwl |
Move with Zero extension, W ord to Long | 2 字节搬到 4 字节,高位填 0 |
movzwq |
Move with Zero extension, W ord to Quad | 2 字节搬到 8 字节,高位填 0 |
底层暗坑再次出现:为什么没有 movzlq(4字节到8字节的零扩展)? 回想我们在 3.1 节讲过的铁律:在 x86-64 中,所有向 32 位寄存器(如 %eax)写入数据的指令,都会自动把高 32 位清零 ! 所以,如果你想把 4 字节零扩展到 8 字节,直接用普通的 movl 指令就行了,CPU 免费帮你做了零扩展,根本不需要单独的 movzlq 指令。
2. 符号扩展(Sign Extension):复制符号位的 movs 家族
适用场景 :用于 C 语言中的有符号数(普通的 char, short, int)转换。 底层动作 :把源数据搬过去,大容器多出来的高位,全部复制源数据的最高位(符号位)。
-
如果源数据是个正数(最高位是 0),那么多出来的高位全填
0。 -
如果源数据是个负数(最高位是 1),那么多出来的高位全填
1。(这是补码机制决定的,只有全填 1,这个负数的大小才不会变)。
同样,指令格式是 movs 加上两个尺寸后缀:
| 汇编指令 | 动作含义 |
|---|---|
movsbw |
1 字节搬到 2 字节,高位填符号位 |
movsbl |
1 字节搬到 4 字节,高位填符号位 |
movsbq |
1 字节搬到 8 字节,高位填符号位 |
movswl |
2 字节搬到 4 字节,高位填符号位 |
movswq |
2 字节搬到 8 字节,高位填符号位 |
movslq |
4 字节搬到 8 字节,高位填符号位(这个指令极其常见!) |
(注意:这里就有 movslq 了,因为普通的 movl 会无脑把高位填 0,如果你想填 1 保留负数,就必须明确使用 movslq。)
3. 一个特殊的"孤儿"指令:cltq
如果你经常阅读 GCC 生成的汇编,你会发现一个没有操作数的奇怪指令:cltq (Convert Long to Quad)。
其实你完全可以把它当成一个"语法糖"。 它在底层的动作等价于 movslq %eax, %rax 。 也就是说,它专门负责把 %eax 里的 32 位数据,符号扩展到 64 位的 %rax 里。因为这种操作在 C 语言返回值(int 转 long)中太常见了,所以 CPU 专门给它起了一个极其简短的名字。
4. 实例验证:C 语言的隐式类型转换机制
我们来看一段极度典型的 C 语言代码,看看有符号和无符号在底层是怎么分道扬镳的。
C 语言源码:
cpp
long extend_signed(char s_char) {
    long result = s_char;  // 有符号 char (1字节) 赋值给 long (8字节)
    return result;
}

long extend_unsigned(unsigned char u_char) {
    long result = u_char;  // 无符号 char (1字节) 赋值给 long (8字节)
    return result;
}
底层真实汇编代码对照:
extend_signed (有符号转换):
cpp
# 参数 s_char 放在 %dil 中 (它是 %rdi 的最低 1 个字节)
extend_signed:
    # 使用 movsbq (符号扩展),将 %dil 中的 1 字节扩展成 8 字节放到 %rax 中
    movsbq  %dil, %rax
    ret
extend_unsigned (无符号转换):
代码段
# 参数 u_char 放在 %dil 中
extend_unsigned:
    # 使用 movzbq (零扩展),将 %dil 中的 1 字节扩展成 8 字节放到 %rax 中
    movzbq  %dil, %rax
    ret
你看,C 语言里轻描淡写的一个赋值等号 =,在底层,编译器必须精准地选择是用 movs 还是 movz,否则稍微算错一位,数字就完全不对了。
小结: 看到这里,你应该彻底掌握了 CPU 是怎么"搬砖"的了。
-
如果尺寸一样大:用
mov。 -
如果从小盒子搬到大盒子:有符号用
movs,无符号用movz。
3.3 压栈与出栈:程序在内存中的"生存空间"
在前面的小节,我们知道可以用 mov 把数据随意放在内存的任何地方。但是,程序在运行过程中,会产生大量临时数据(比如你要保存一下某个寄存器的值,或者函数里定义了几个局部变量)。
如果每次都用绝对地址去找内存,不仅麻烦,还极易冲突。于是,操作系统在内存里专门划出了一块特殊区域 ,采用"后进先出"(LIFO)的规则来管理临时数据。这块区域,就叫栈(Stack)。
我们可以把栈想象成一个装薯片的圆筒:
-
你只能把新的薯片放在最上面(入栈 Push)。
-
你吃的时候,只能先拿最上面的那片(出栈 Pop)。
-
这就是著名的 LIFO(Last In, First Out,后进先出) 原则。
一个非常反直觉的"暗坑":栈是"倒着长"的
就像前面提到的 movl 高位清零一样,x86 架构的栈也有一个反人类的规定:栈是从高内存地址向低内存地址生长的。
假设栈底(薯片筒的底部)在地址 0x1000:
-
当你放第一片薯片进去,它可能在
0x0FF8。 -
放第二片,它就在
0x0FF0。 地址越来越小!
入栈(PUSH)发生了什么?
当你执行一条入栈指令,比如把寄存器 %rax(8 个字节)压入栈中:
cpp
pushq %raxCPU 其实在背地里连续做了两件事:
-
先挪指针 :因为栈是向下生长的,CPU 会先把栈顶指针
%rsp的值减去 8(腾出 8 个字节的空位)。 -
再存数据 :把
%rax里面的数据,塞进刚刚腾出来的这个内存地址里。
cpp
# 指令:pushq %rbp
# 底层等价于以下两条指令:

subq    $8, %rsp        # 1. 栈指针向下移动 8 个字节 (分配空间)
movq    %rbp, (%rsp)    # 2. 把 %rbp 的值写入新的栈顶内存
详细拆解:出栈(POP)发生了什么?
CPU 同样按顺序做了两件事:
-
先读数据 :CPU 去
%rsp当前指向的内存地址,把里面的 8 个字节数据抄出来,塞进寄存器%rbx里。 -
再退指针 :CPU 把
%rsp的值加上 8,相当于告诉大家:"最上面的这块空间我不用了,交还给系统"。
当你执行一条出栈指令,比如把栈顶的数据弹出来,放进寄存器 %rbx 里:
cpp
# 指令:popq %rax
# 底层等价于以下两条指令:

movq    (%rsp), %rax    # 1. 把栈顶内存的数据复制到 %rax
addq $8, %rsp # 2. 栈指针向上移动 8 个字节 (释放空间)| 操作 | 汇编指令 | CPU 动作 1(指针) | CPU 动作 2(数据) | 现实比喻 |
|---|---|---|---|---|
| 入栈 | pushq %rax |
%rsp = %rsp - 8 (向下腾空) |
把 %rax 写入 (%rsp) |
把薯片压入筒里 |
| 出栈 | popq %rbx |
读 (%rsp) 数据给 %rbx |
%rsp = %rsp + 8 (向上回收) |
把最上面的薯片拿走 |
一个进阶的底层秘密:出栈并不会"擦除"数据
这是无数底层初学者(包括写 C 语言的新手)最容易踩的坑: 当你执行 popq 之后,栈指针 %rsp 确实加了 8,退回去了。但是,原本存在那块内存里的旧数据,CPU 并没有去清零!
那里的数据依然原封不动地躺在物理内存中,只不过 %rsp 不再指向它了。那块区域现在被视为"未分配的垃圾内存"。如果在未来的某一步,又执行了一次 push,新数据才会覆盖掉这些幽灵数据。 (黑客在进行复杂攻击时,经常会利用这些残留在栈上的废弃数据。)
实例:用栈来交换两个寄存器的值
我们用一个非常精妙的汇编小片段,来看看 push 和 pop 是怎么合作的。假设我们想交换 %rax 和 %rbx 里的值。
常规做法是找个第三者(比如 %rcx)当临时变量,像这样转交:mov %rax, %rcx ... 但汇编里更优雅的做法是用栈:
cpp
# 假设初始状态: %rax = 100, %rbx = 200

pushq   %rax     # 第一步:把 %rax(100) 压入栈顶。  栈里现在有:[100]
pushq   %rbx     # 第二步:把 %rbx(200) 压入栈顶。  栈里现在有:[200, 100]

popq    %rax     # 第三步:弹出栈顶元素(200)给 %rax。 栈里剩下:[100]。此时 %rax = 200
popq    %rbx     # 第四步:弹出栈顶元素(100)给 %rbx。 栈清空。     此时 %rbx = 100

# 结果:不需要第三个寄存器,%rax 和 %rbx 的值完美交换!