4 月 22 日,蚂蚁百灵正式推出 Ling-2.6-flash ------ 一款总参数量 104B、激活参数 7.4B 的 Instruct 模型。该模型主打"Token 效率(Token Efficiency)",在保持竞争力智能水平的同时,更快、更省以及更适合大规模真实应用。
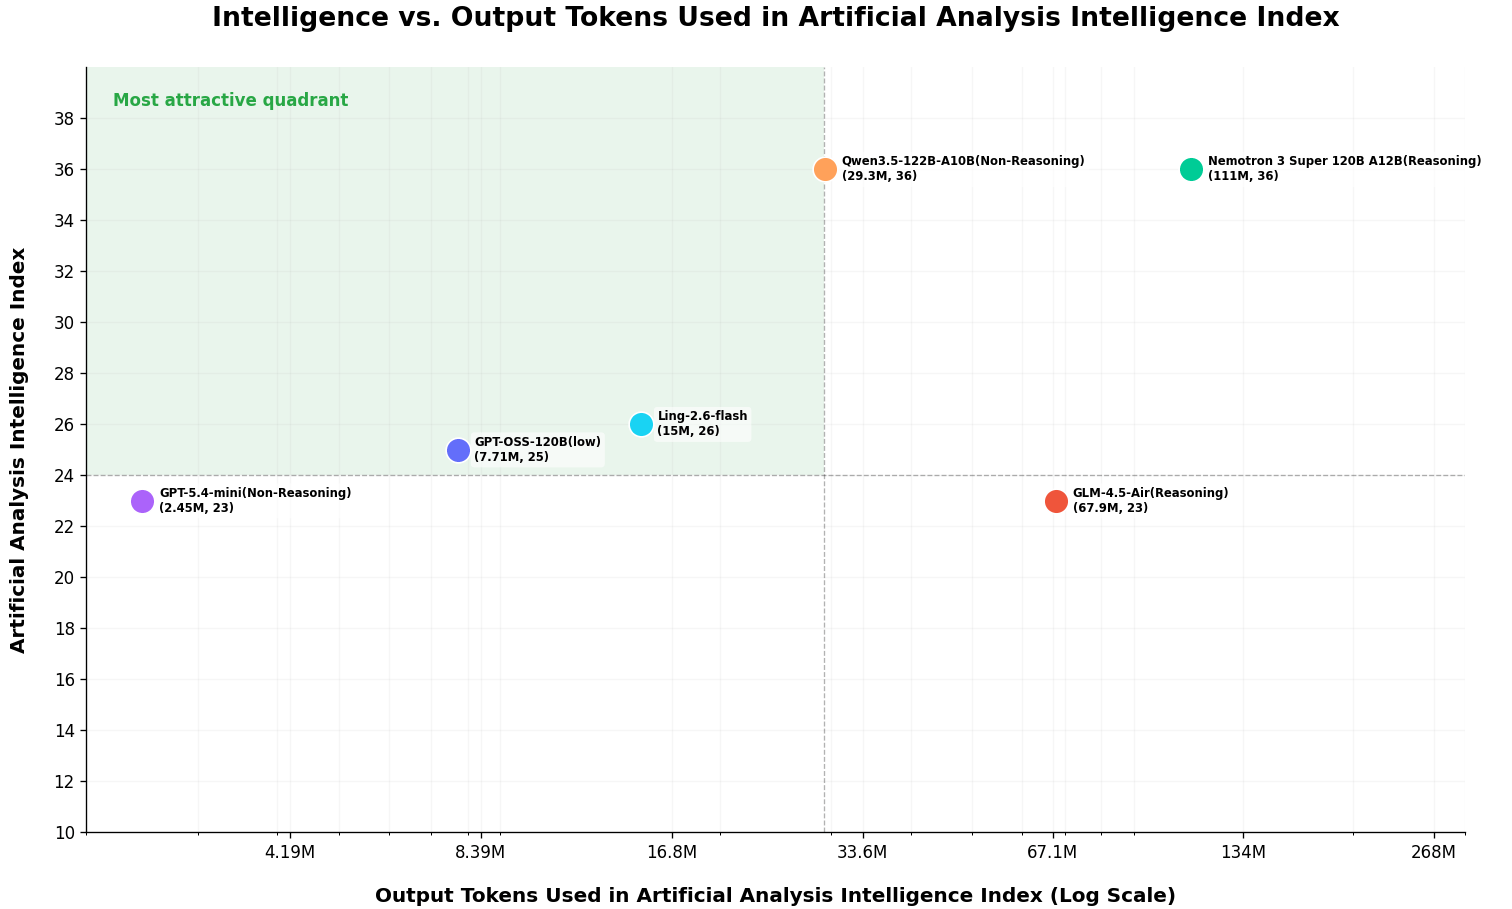
据权威三方评测Artificial Analysis 数据,Ling-2.6-flash 展现了突出的 Token Efficiency 优势,以 15M output tokens 实现了 26 分 的 Intelligence Index,在保持较强智能水平的同时,将输出消耗控制在相对更低的位置。相比部分依赖更长输出换取更高分数的模型,Ling-2.6-flash 在"智能表现"与"输出成本"之间取得了更优平衡。
对于开发者和企业场景而言,这种效率优势意味着更低的推理开销、更快的首字响应、更短的整体生成时延,以及更流畅的交互体验,满足在真实部署环境下对速度、成本与体验的综合要求。
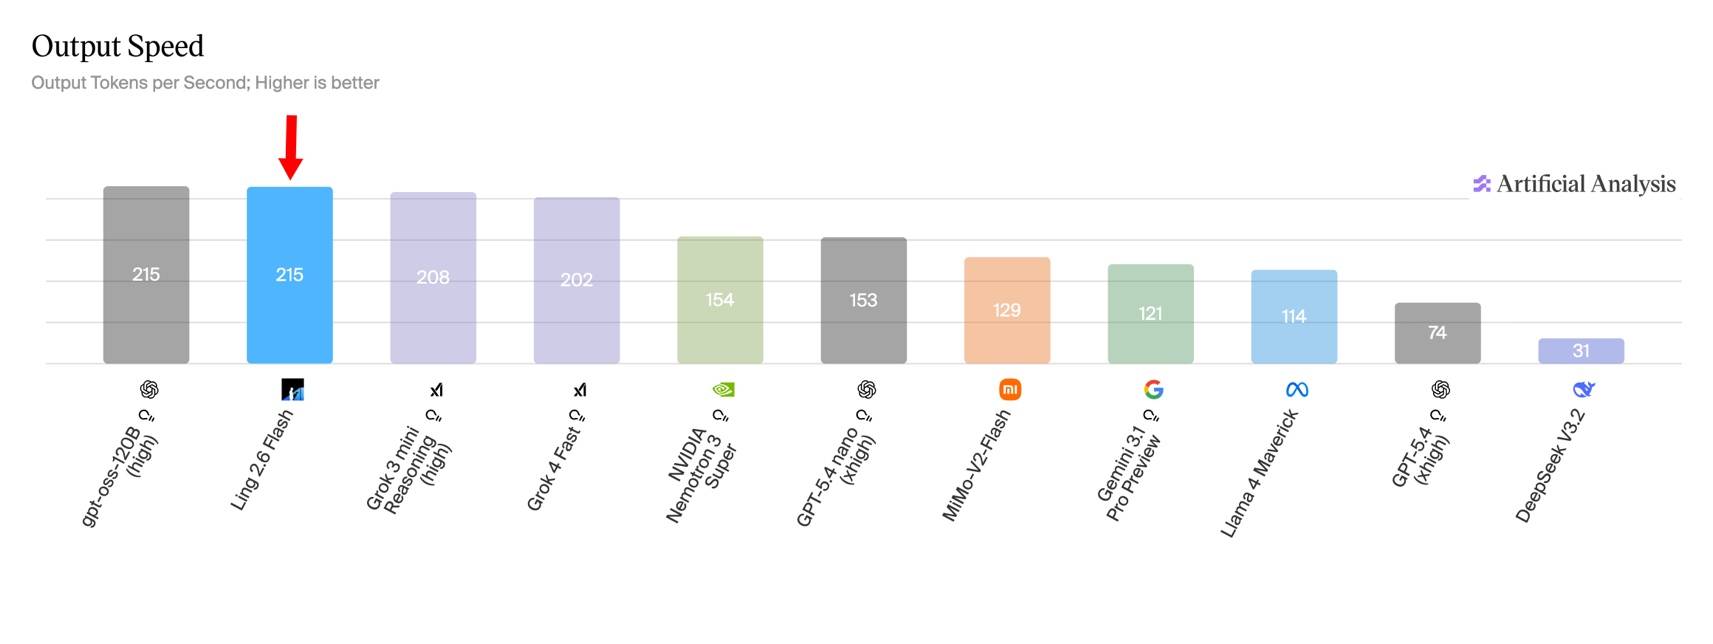
Ling-2.6-flash 沿用了 Ling 2.5 的混合线性架构设计,这种高度稀疏化的 MoE 架构在硬件表现上优势明显。在 4 卡 H20 条件下推理速度最快可达到 340 tokens/s,Prefill 吞吐达到 Nemotron-3-Super 的 2.2 倍。在 Output Speed 测评中,Ling-2.6-flash以 215 tokens/s 的稳定输出速度位列同参数级别模型的第一梯队。
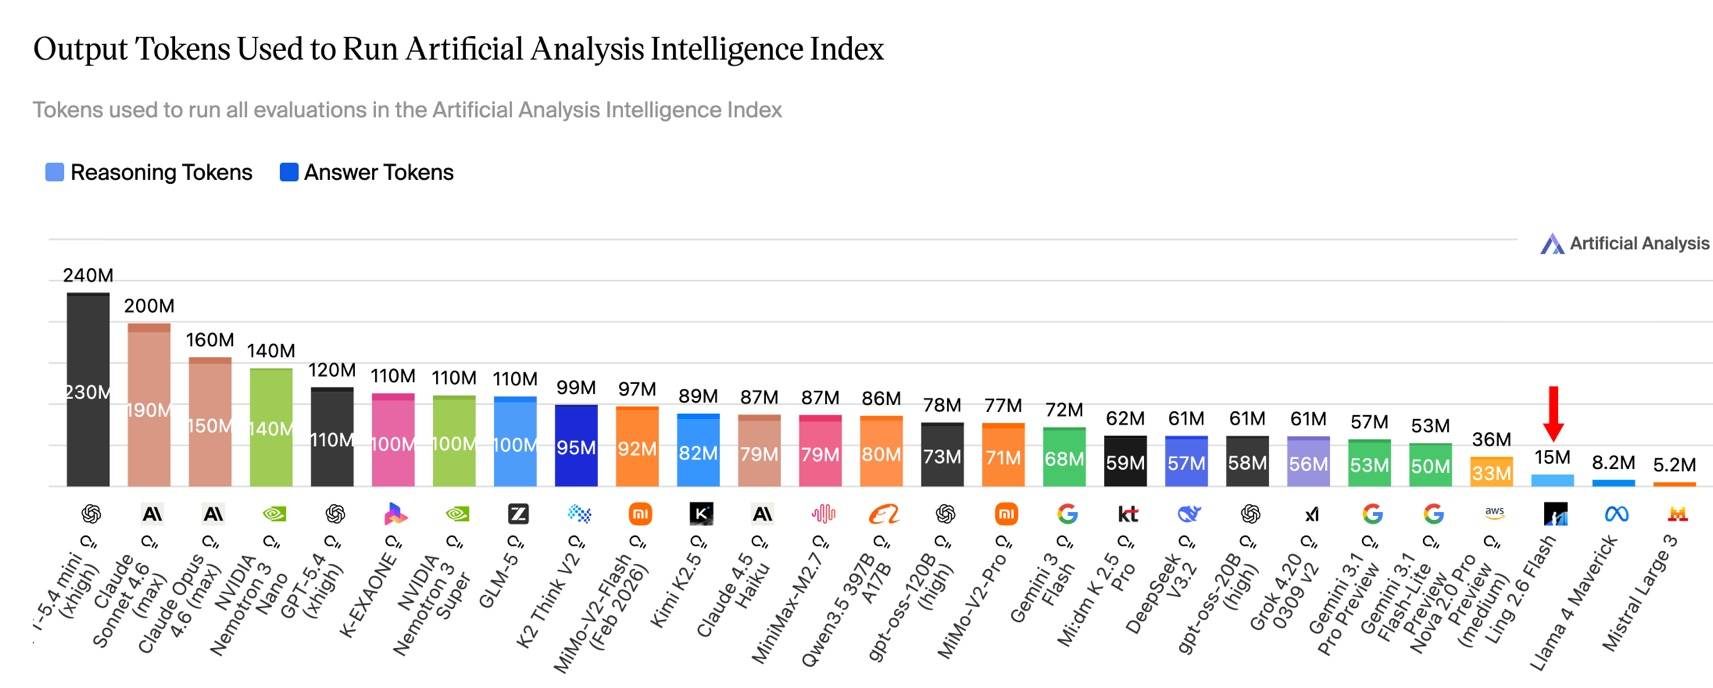
从 Token 消耗来看,Ling-2.6-flash 的智效比显著提升。在 Artificial Analysis 完整测评中,Ling-2.6-flash 总消耗为 15M tokens,而 Nemotron-3-Super 等模型达到或超过 110M tokens。这意味着,Ling-2.6-flash 仅用约 1/10 的 token 消耗完成了同类评测任务。
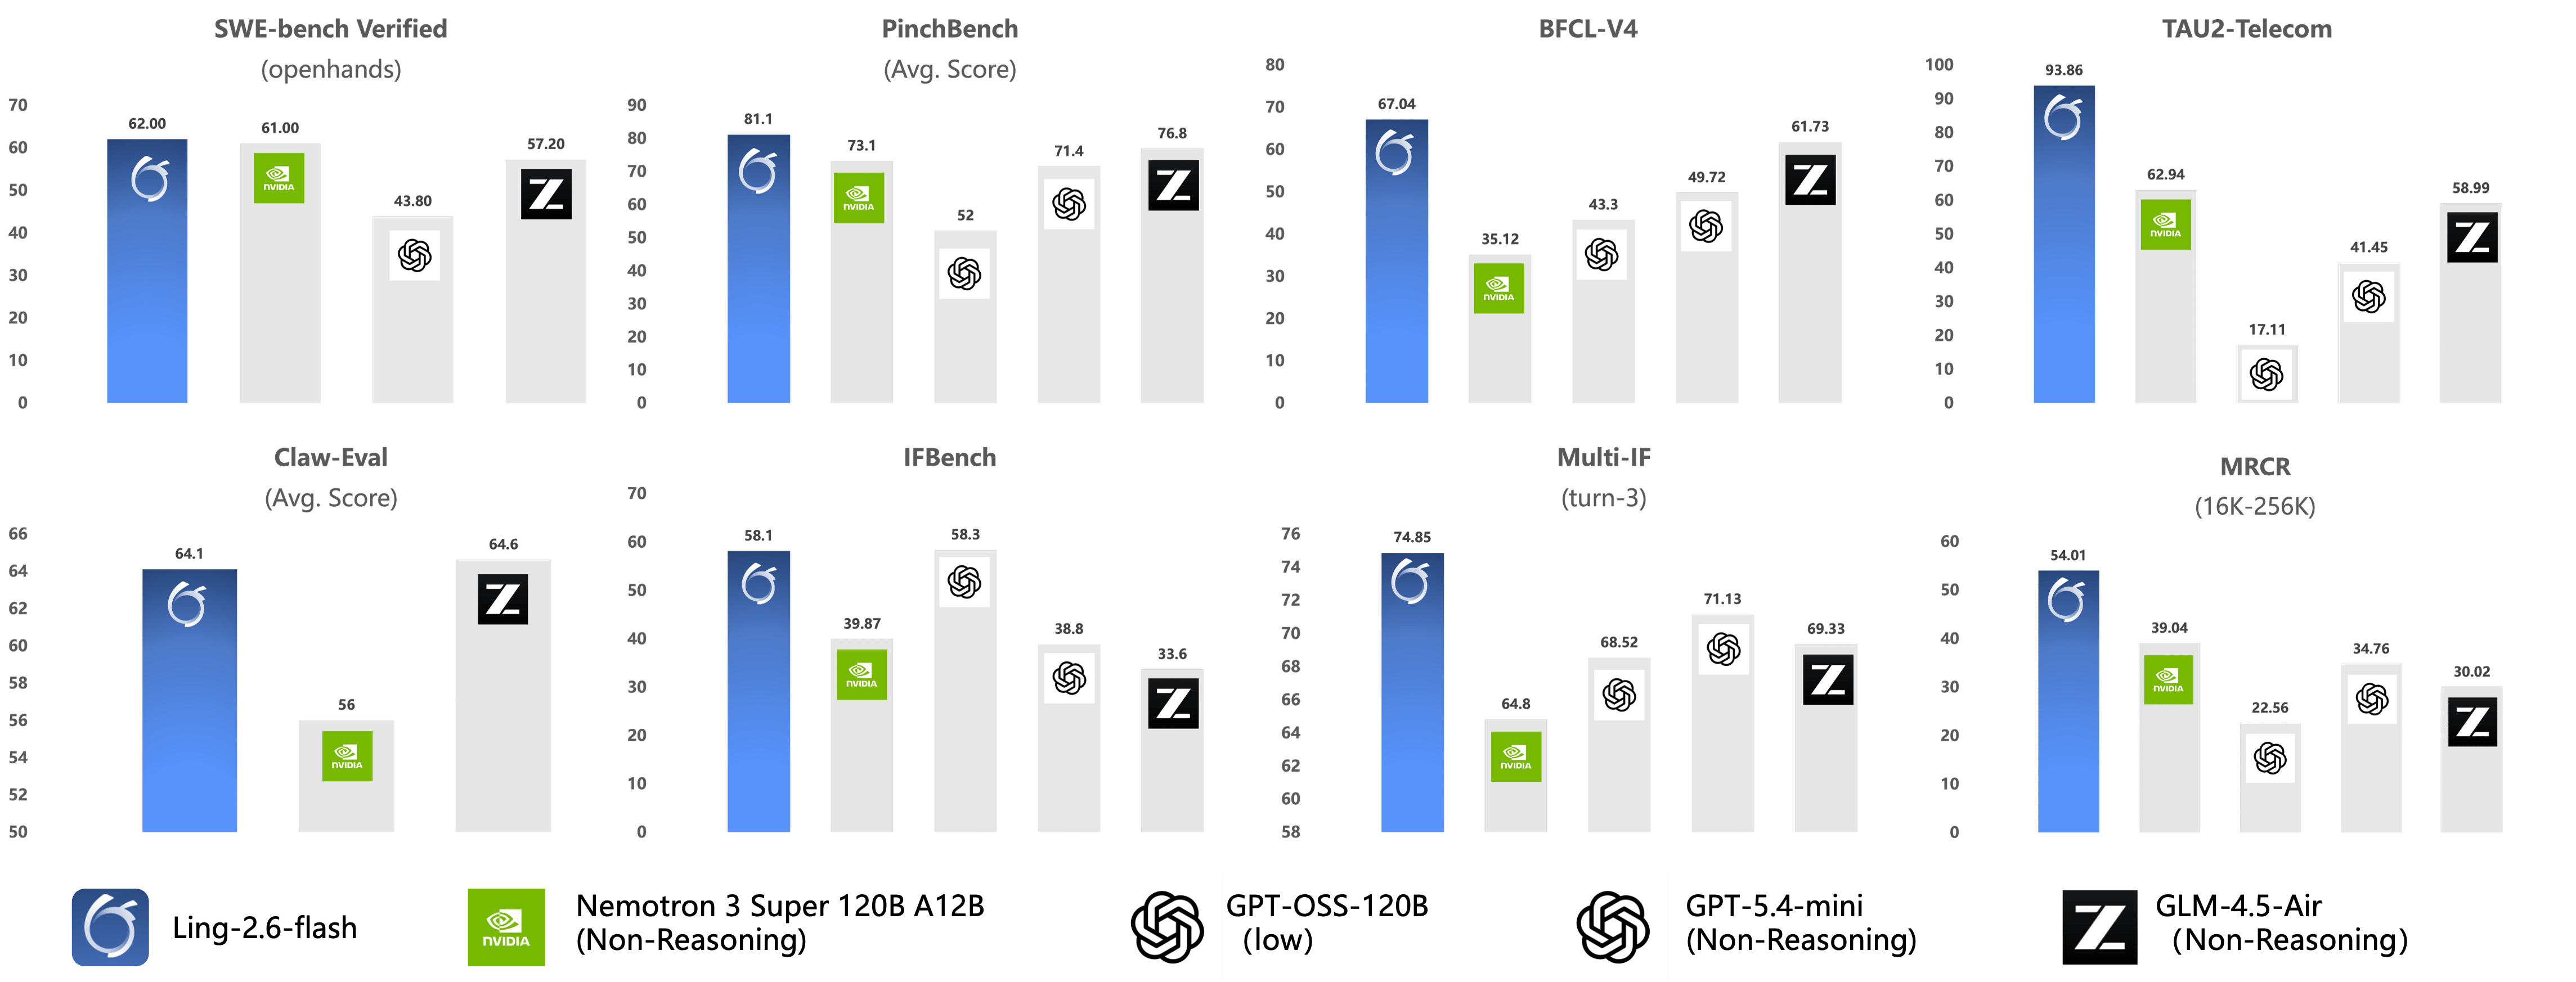
Ling-2.6-flash 面向 Agent 场景进行了定向增强,在控制 Token 消耗的前提下,依然保持了极强的任务执行力,模型在 BFCL-V4、TAU2-bench、SWE-bench Verified、Claw-Eval、PinchBench 等Agent 相关基准上达到同尺寸 SOTA 水平。与此同时,Ling-2.6-flash 在通用知识、数学推理、指令遵循及长文本解析等维度保持优秀水准。
API 定价方面,Ling-2.6-flash 输入每百万tokens定价 0.1 美元,输出 0.3 美元。目前,Ling-2.6-flash 的 API 已正式向用户开放,并提供为期一周的限时免费试用。用户可以通过OpenRouter 、百灵大模型 tbox 获取对应服务。据了解,该模型后续将通过蚂蚁数科发布商业版本LingDT,服务全球开发者及中小企业。
一周前,Ling-2.6-flash 的匿名测试版本"Elephant Alpha"上线OpenRouter,上线以来,其调用量持续增长,连续多日位列 Trending 榜首,日均 tokens 调用量达 100B 级别,周增长超5000%。