本次实战通过完整的代码示例和Web UI监控,深入讲解了Spark RDD持久化机制。首先通过WordCount案例对比了未持久化(重复计算)与持久化(缓存复用)的性能差异,验证了持久化能显著提升重复计算效率。接着详细介绍了MEMORY_ONLY、DISK_ONLY、MEMORY_AND_DISK等多种存储级别及其适用场景,强调根据内存容量和性能需求合理选择。通过spark-shell交互式操作,演示了如何使用persist()和cache()方法设置不同存储级别,并利用Spark Web UI的Storage页面实时监控RDD缓存状态(内存/磁盘占用、分区分布)。最后展示了unpersist()方法用于手动释放缓存,完整呈现了RDD生命周期管理的最佳实践。
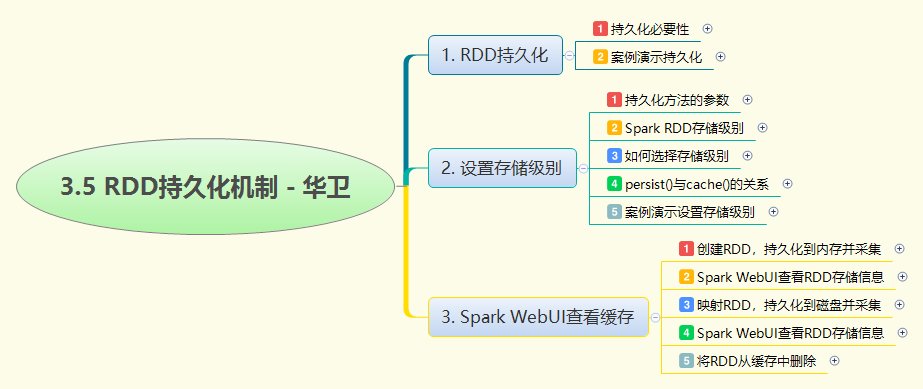
3.5 RDD持久化机制
howard20052026-05-08 20:39
相关推荐
寻道码路7 天前
AI Agent 工程化开发实战(五):持久化与断点恢复——Checkpointer 与 Store我不会起名字32223 天前
Redis 突然只能读不能写:MISCONF 报错的 3 类触发条件与 4 步恢复我不会起名字32223 天前
Redis RDB 落盘时的 fork 停顿:COW 机制与 3 个降低影响的配置for_ever_love__1 个月前
LangGraph Checkpointer:持久化、断点续跑与多轮记忆for_ever_love__1 个月前
Redis 持久化讲透:RDB、AOF 与混合持久化怎么选ShineWinsu1 个月前
对于Redis:AOF持久化的解析ShineWinsu1 个月前
对于Redis:RDB持久化的解析在世修行1 个月前
干货:配置持久化与引擎状态的可视化小小工匠5 个月前
Redis - 事务机制:能实现 ACID 属性吗典学长编程5 个月前
Redis分布式缓存超详细教学(微服务版)!