我最近才意识到:
AI Coding 最大的 token 黑洞,可能根本不是 prompt。
而是 shell output。
Claude Code / Cursor 在长时间 agent session 里,会不断读取:
- git log
- npm install
- cargo build
- docker logs
这些 CLI 输出很多都是"人类都不会认真看"的噪音,但模型会把它们重新塞进 context。
结果就是:
你在花钱让 LLM 重复阅读终端垃圾信息。
最近看到一个很有意思的项目:
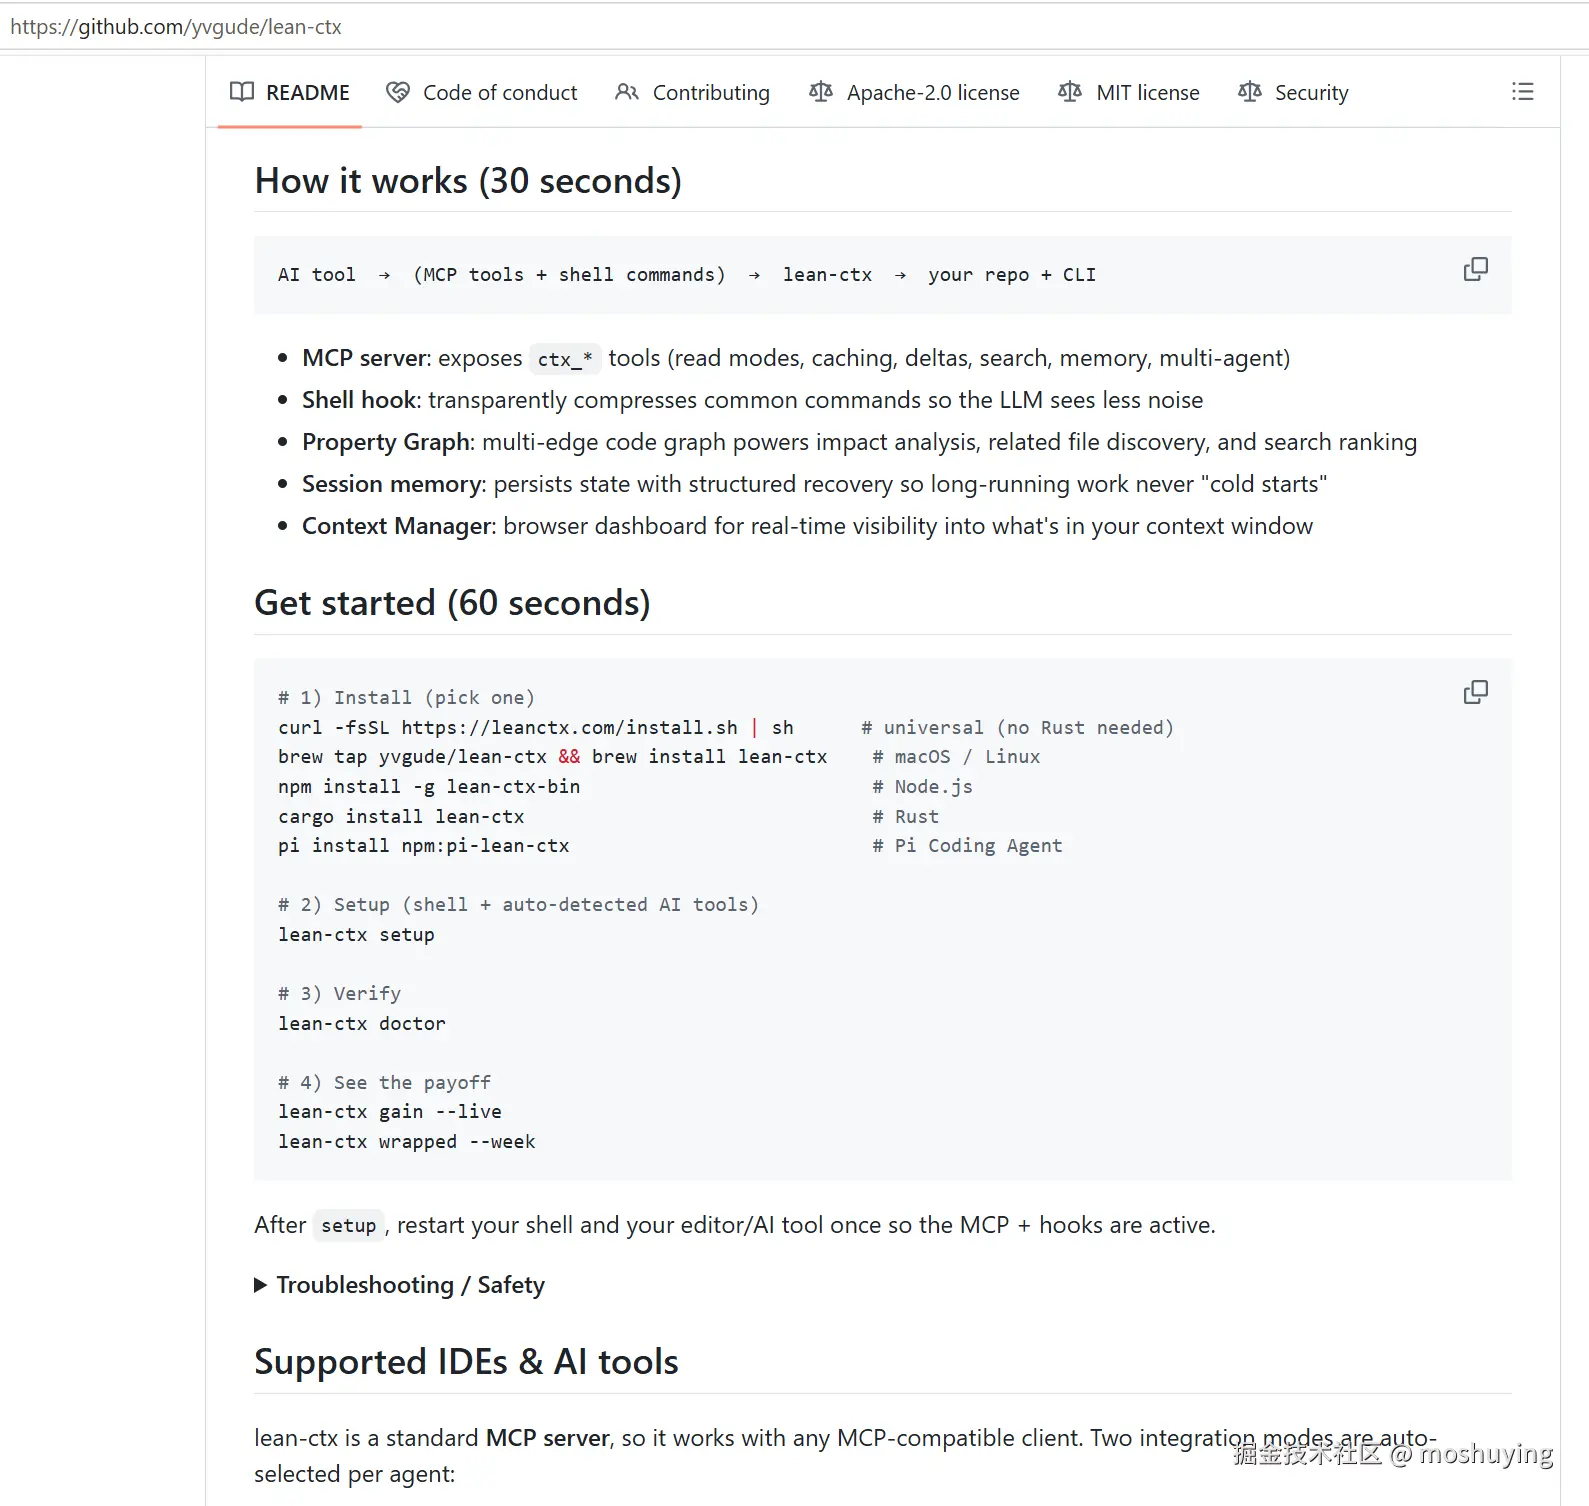
lean-ctx(GitHub 已经 1.7k⭐)
它做的事情其实很简单:
在 AI Agent 和代码仓库之间加一层 context optimization。
核心包括:
• 压缩 shell 输出
• AST / Tree-sitter 分析代码结构
• 缓存重复上下文
• 只给模型真正相关的代码片段
官方数据里提到:
- token reduction 可达 60--95%
- cached re-read 最低只需要十几个 token
- 支持 Claude Code、Cursor、Codex、Windsurf 等 Agent
但我觉得最有意思的不是"压缩文件读取"。
而是:
它终于开始优化 CLI output 了。
现在很多 AI Coding 工具都在做 RAG、memory、prompt engineering。
但真正疯狂烧 token 的,
往往是那些没人关注的终端日志。
AI Coding 下一阶段,
可能已经不是 "更强模型" 竞争了。
而是:
谁能更高效地管理 context。