安装节点划分
|--------------|-----------------|-----------------|---------------|
| 节点名称 | Hive服务器 | Hive客户端 | MySQL |
| node1 | ★ | | |
| node2 | | | ★ |
| node3 | | ★ | |
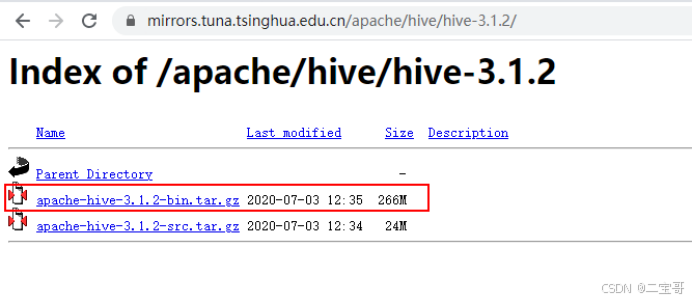
下载
https://mirrors.tuna.tsinghua.edu.cn/apache/hive/hive-3.1.2/
解压
bash
tar -zxvf ./apache-hive-3.1.2-bin.tar.gz
mv apache-hive-3.1.2-bin hive-3.1.2
配置
配置node1、node3两台节点的Hive环境变量
bash
vim /etc/profile
export HIVE_HOME=/software/hive-3.1.2/
export PATH=$PATH:$HIVE_HOME/bin

#source  生效
source /etc/profile
在node1节点$HIVE_HOME/conf下创建hive-site.xml并配置
XML
<configuration>
<property>
<name>hive.metastore.warehouse.dir</name>
<value>/user/hive/warehouse</value>
</property>
<property>
<name>javax.jdo.option.ConnectionURL</name>
<value>jdbc:mysql://node2:3306/hive?createDatabaseIfNotExist=true&useSSL=false</value>
</property>
<property>
<name>javax.jdo.option.ConnectionDriverName</name>
<value>com.mysql.jdbc.Driver</value>
</property>
<property>
<name>javax.jdo.option.ConnectionUserName</name>
<value>root</value>
</property>
<property>
<name>javax.jdo.option.ConnectionPassword</name>
<value>123456</value>
</property>
</configuration>在node3节点$HIVE_HOME/conf/中创建hive-site.xml并配置
XML
<configuration>
 <property>
  <name>hive.metastore.warehouse.dir</name>
  <value>/user/hive/warehouse</value>
 </property>
 <property>
  <name>hive.metastore.local</name>
  <value>false</value>
 </property>
 <property>
  <name>hive.metastore.uris</name>
  <value>thrift://node1:9083</value>
 </property>
</configuration>
node1、node3节点删除$HIVE_HOME/lib下"guava"包,使用Hadoop下的包替换,这一步操作是因为hadoop版本较
XML
#删除Hive lib目录下"guava-19.0.jar "包
[root@node1 ~]# rm -rf /software/hive-3.1.2/lib/guava-19.0.jar
[root@node3 ~]# rm -rf /software/hive-3.1.2/lib/guava-19.0.jar

#将Hadoop lib下的"guava"包拷贝到Hive lib目录下
[root@node1 ~]# cp /software/hadoop-3.1.4/share/hadoop/common/lib/guava-27.0-jre.jar /software/hive-3.1.2/lib/

[root@node3 ~]# cp /software/hadoop-3.1.4/share/hadoop/common/lib/guava-27.0-jre.jar /software/hive-3.1.2/lib/
将"mysql-connector-java-5.1.47.jar"驱动包上传到node1 node3节点的$HIVE_HOME/lib目录下
在node1节点中初始化Hive
bash
#初始化hive,hive2.x版本后都需要初始化
[root@node1 ~]# schematool -dbType mysql -initSchema
在服务端和客户端操作Hive
这里node1是服务端 node3是客户端。先启动hdfs,才能使用hive
bash
#在node1启动Hive metastore
[root@node1 hadoop]# hive --service metastore &

#在node1中登录Hive ,创建表test(需要先启动hdfs)
[root@node1 conf]# hive
hive> create table test (id int,name string,age int ) row format delimited fields terminated by '\t';
#向表test中插入数据
hive> insert into test values(1,"zs",18);

#在node3上登录Hive客户端查看表数据
[root@node3 lib]# hive
hive> select * from test;
OK
1	zs	18