wsl中llama.cpp源码编译

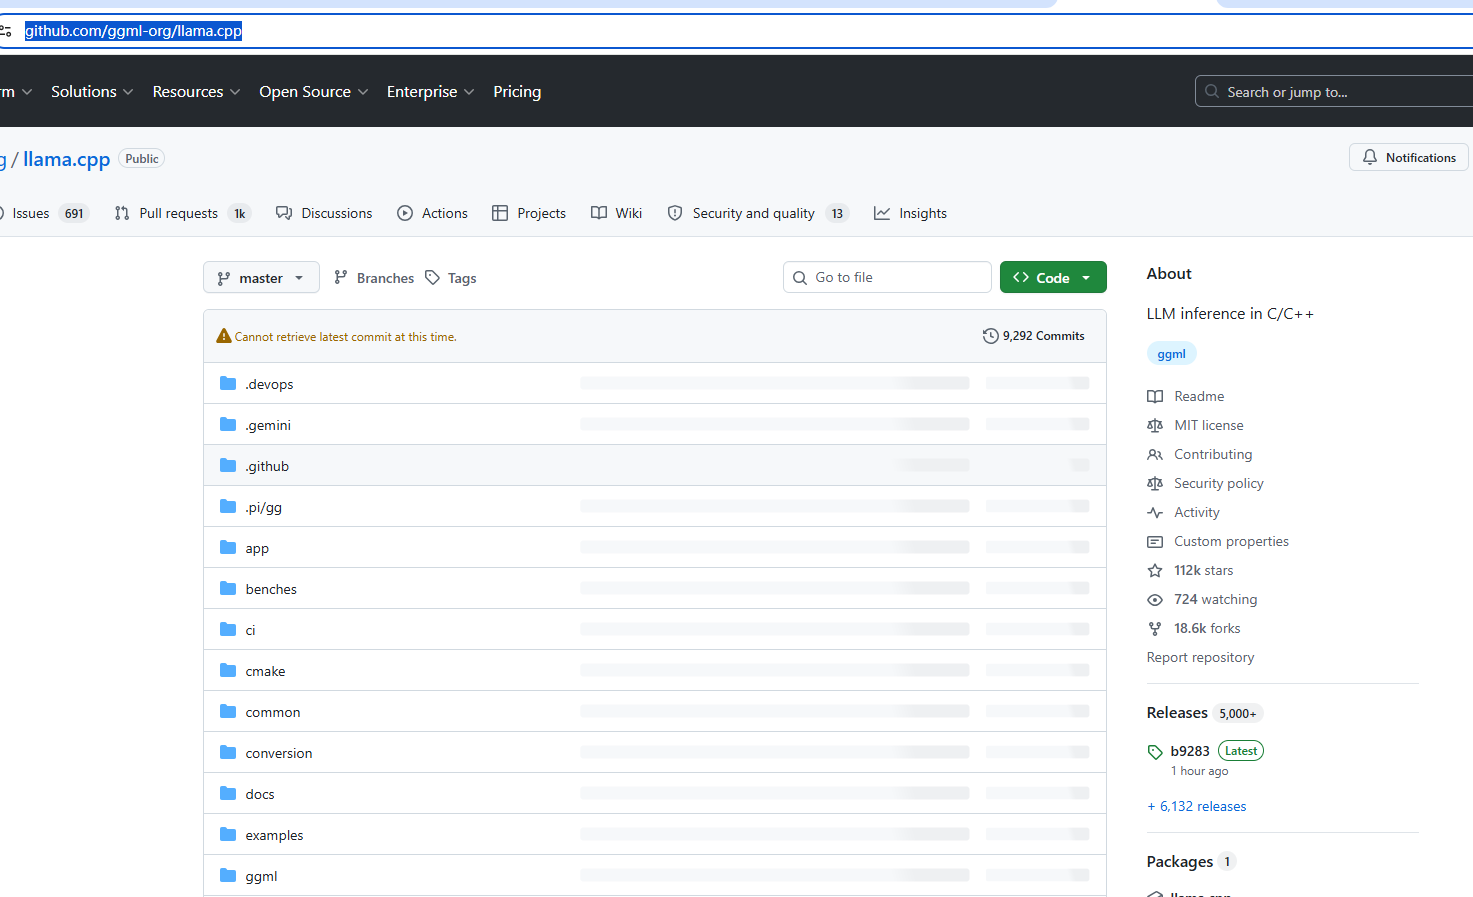
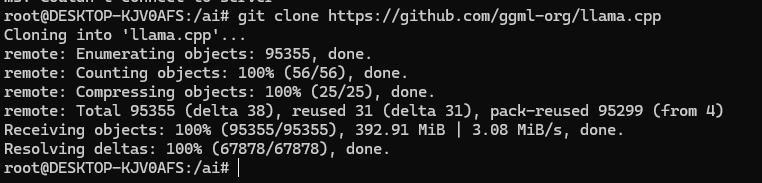
1、下载源码,从地址:https://github.com/ggml-org/llama.cpp下载,如下图所示:
2、安装cuda,安装方法请看地址:https://blog.csdn.net/sunxiaoju/article/details/157170558?spm=1011.2415.3001.5331中的安装方法,安装好之后还需要安装:

bash 复制代码
apt install nvidia-cuda-toolkit

然后执行如下命令:

bash 复制代码
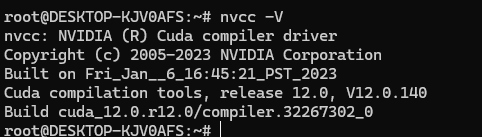
nvcc -V

如下图所示:

3、安装如下工具:

bash 复制代码
apt install -y build-essential cmake git wget
apt install libssl-dev

4、然后进入到llama.cpp源码目录创建一个build文件夹如:

bash 复制代码
mkdir build
cd build/
cmake .. -DGGML_CUDA=ON -DCMAKE_BUILD_TYPE=Release
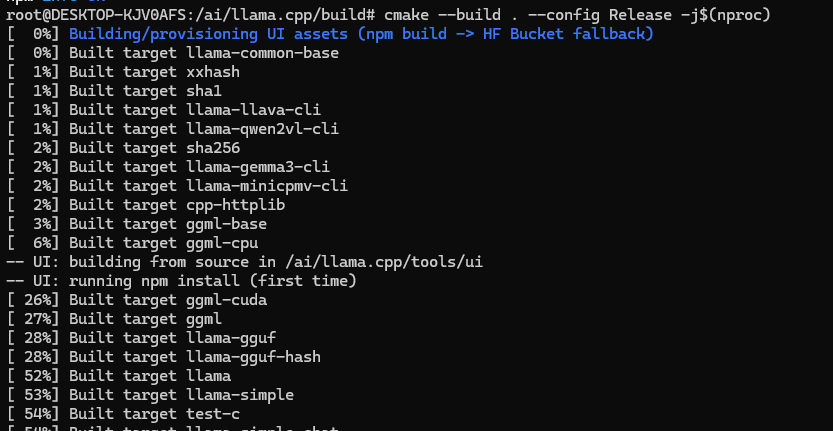
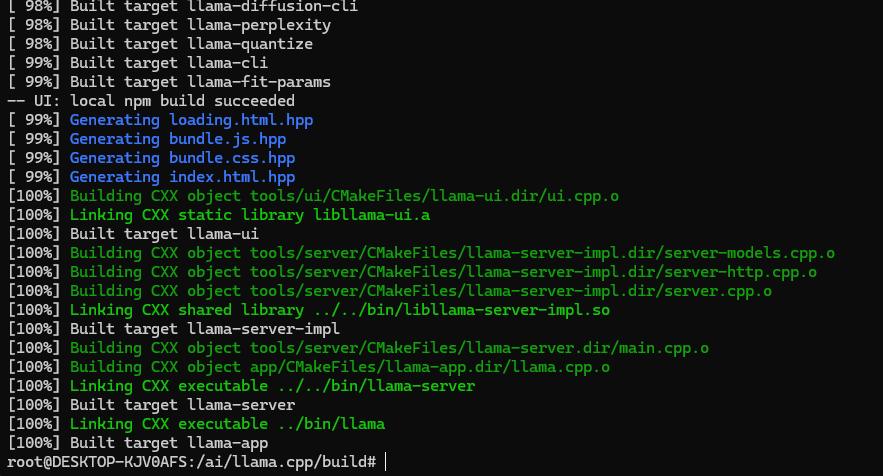
cmake --build . --config Release -j$(nproc) 


mkdir -p /usr/share/llama.cpp/bin
cp bin/* /usr/share/llama.cpp/bin/
vim ~/.bashrc
export PATH=$PATH:/usr/share/llama.cpp/bin

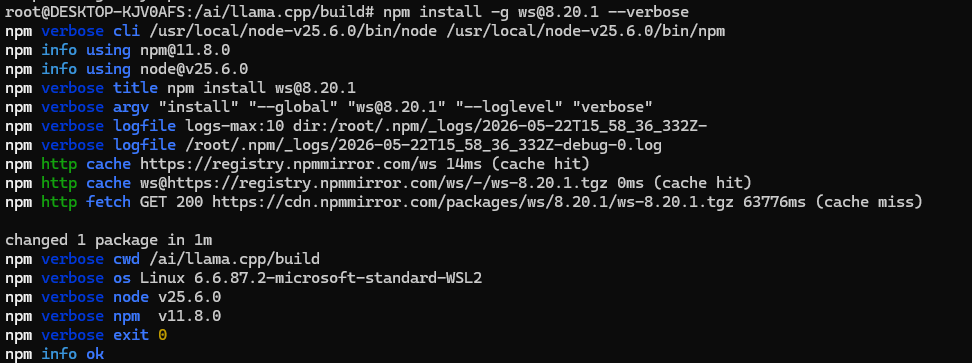
编译过程中出现如下错误:
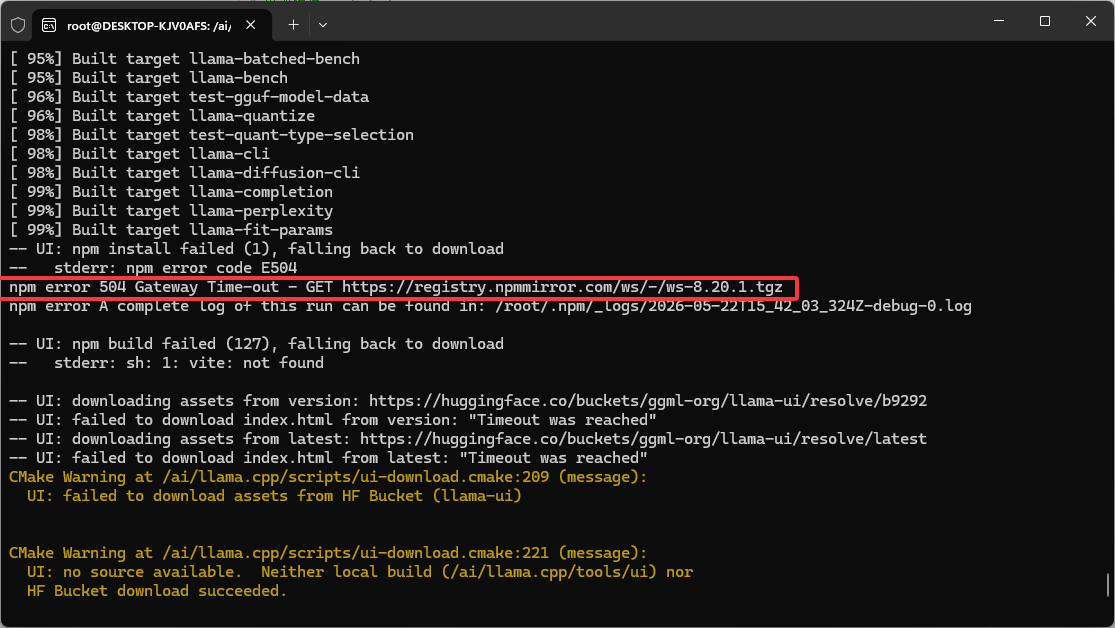
那就手动安装,通过如下命令安装:

bash 复制代码
npm install -g ws@8.20.1 --verbose

5、然后查看版本:

bash 复制代码
./bin/llama-cli --version
相关推荐
顾鸟1 天前
ComfyUI 使用 LLaMA-Factory 微调的 Qwen3.5:从模型导出到工作流出图--晨羽算力平台
llama·comfyui·工作流·qwen3.5
一条大祥脚9 天前
llama.cpp 深度解析:从 GGUF 到本地推理的事实标准
llama
~远在太平洋~17 天前
大模型评测框架 OpenCompass 本地部署保姆级教程:从安装到跑通 C-Eval 基准(含依赖冲突修复与判分避坑)
llama
程序猿编码19 天前
告别 GPU 空转!token 级调度,Qwen/Llama 高并发推理引擎
人工智能·机器学习·llm·llama·大模型推理
还卿一钵无情泪21 天前
PEFT-Transformers、Unsloth、LLaMA-Factory 微调框架 横向对比
深度学习·大模型·llama·ollama
程序猿编码22 天前
不依赖 vLLM/llama.cpp:一套面向学习的 DeepSeek-R1 CUDA 推理实现
c++·学习·语言模型·llama·vllm·大模型推理
天燹22 天前
本地部署大模型ollama
人工智能·llama
骑着蜗牛撵大象32723 天前
N1 小盒子撑起 AI 接口中转层:New-API 接管本地 Ollama,用 Token 分发模型能力
docker·llama·1024程序员节·api网关·飞牛nas·new-api
言简行敏,心静致远。24 天前
llama-bench使用说明及其应用
llama
AI_Gump25 天前
模型篇|llama.cpp 推理引擎深度解读:从一人练手到 LLM 端侧的事实标准
llama·llama.cpp