最新测试,如果开启MTP功能,速度可以大幅提升5倍,思考速度可以达到150token每秒,这还是6G显存,虽然还是比较难用,但是已经可以堪堪摸到可用的门槛了,离谱!!!
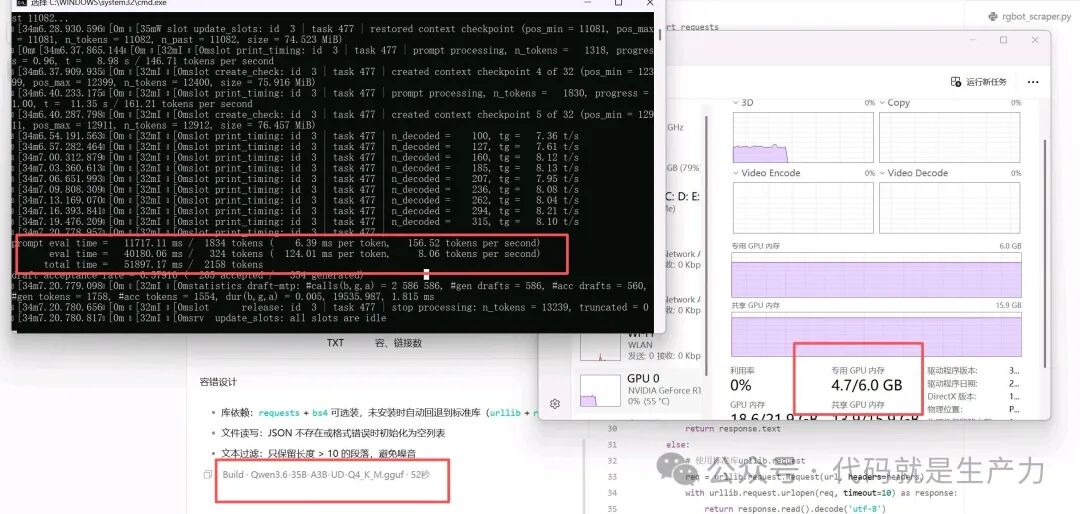
做了个比较颠的测试,看看在6G显存的笔记本能不能运行这个350亿参数的大模型,得益于它的moe架构,可以把大部分模型参数放到内存里面去,好歹算是跑起来了,虽然运行的非常吃力。
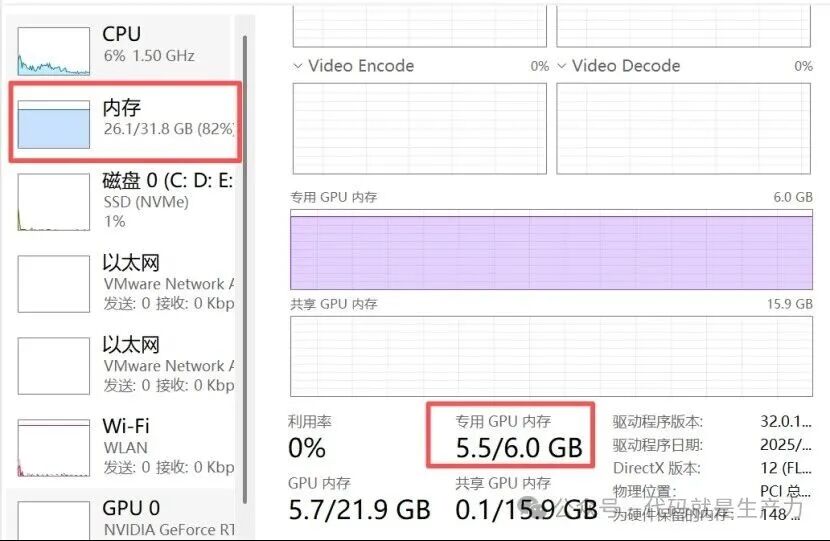
显存占用5G,内存占用20G
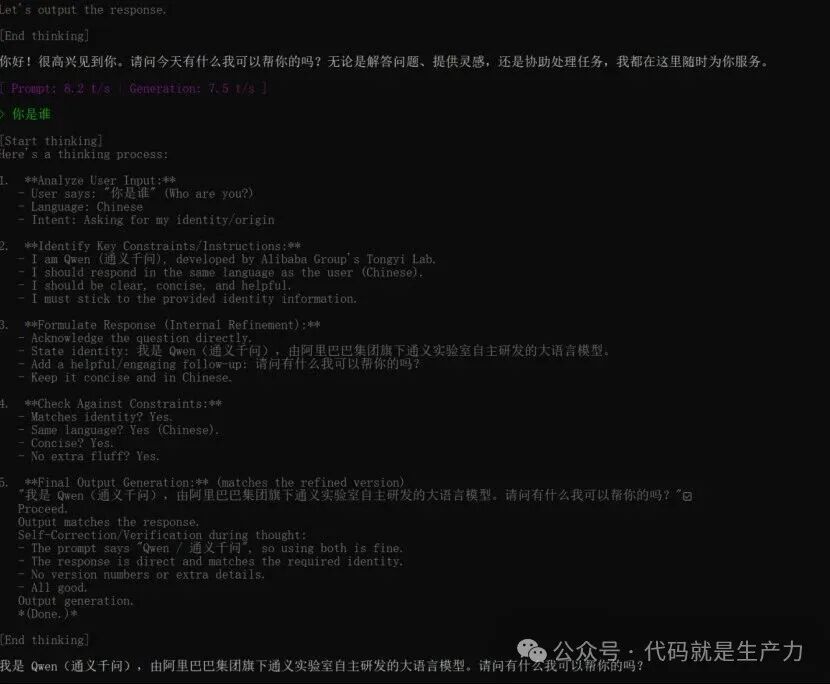
推理的速度大概是8 Token每秒。
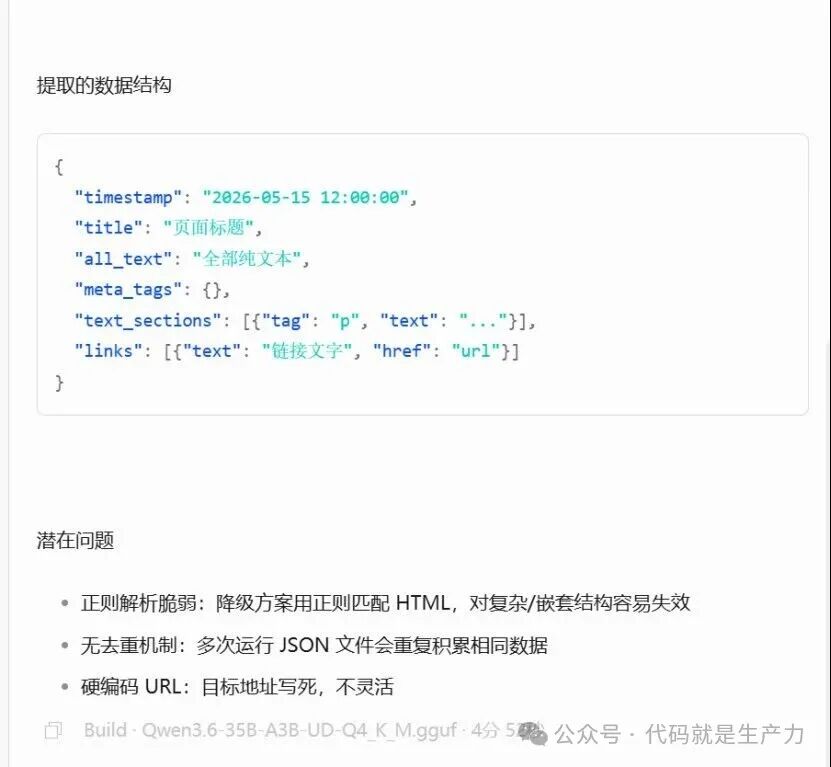
做了一个简单的代码理解工作,耗时4分钟多。
最后的llama 运行脚本奉上
@echo off
chcp 65001 > nul
REM Qwen3.6-35B-A3B MoE Server for 6G GPU
REM Usage: Normal llama.cpp + CPU-MOE offload + KV cache quantization
REM Only 3B params active per inference, inactive experts stay on disk
cd /d "f:\qwen35\llamagpu"
set MODEL=f:\qwen35\Qwen3.6-35B-A3B-UD-Q4_K_M.gguf
set PORT=7777
set CTX_SIZE=320000
echo ============================================
echo Qwen3.6-35B-A3B MoE Server (6G GPU)
echo Model: Q4_K_M (~19GB)
echo Active Params: 3B / Total: 35B
echo API: http://localhost:%PORT%
echo ============================================
echo.
echo 6G GPU Tuning:
echo --n-cpu-moe: MOE layers on CPU (6G GPU try 40-50)
echo If OOM --^> increase --n-cpu-moe (45, 50)
echo If GPU low --^> decrease --n-cpu-moe (35, 30)
echo Goal: GPU VRAM ~80%%, room for KV cache
echo.
llama-server.exe ^
--host 0.0.0.0 ^
--port %PORT% ^
--timeout 600 ^
--threads -1 ^
--batch-size 2048 ^
--ctx-size %CTX_SIZE% ^
--n-gpu-layers 99 ^
--flash-attn auto ^
--cache-type-k q4_0 ^
--cache-type-v q4_0 ^
--cont-batching ^
--metrics ^
--no-mmap ^
--n-cpu-moe 40 ^
--temp 0.7 ^
--top-p 0.8 ^
--top-k 20 ^
--min-p 0 ^
--presence-penalty 1.5 ^
--chat-template-kwargs "{\"enable_thinking\":false}" ^
--model %MODEL%
pause