1、强化学习中的回报与策略

一、强化学习中的回报

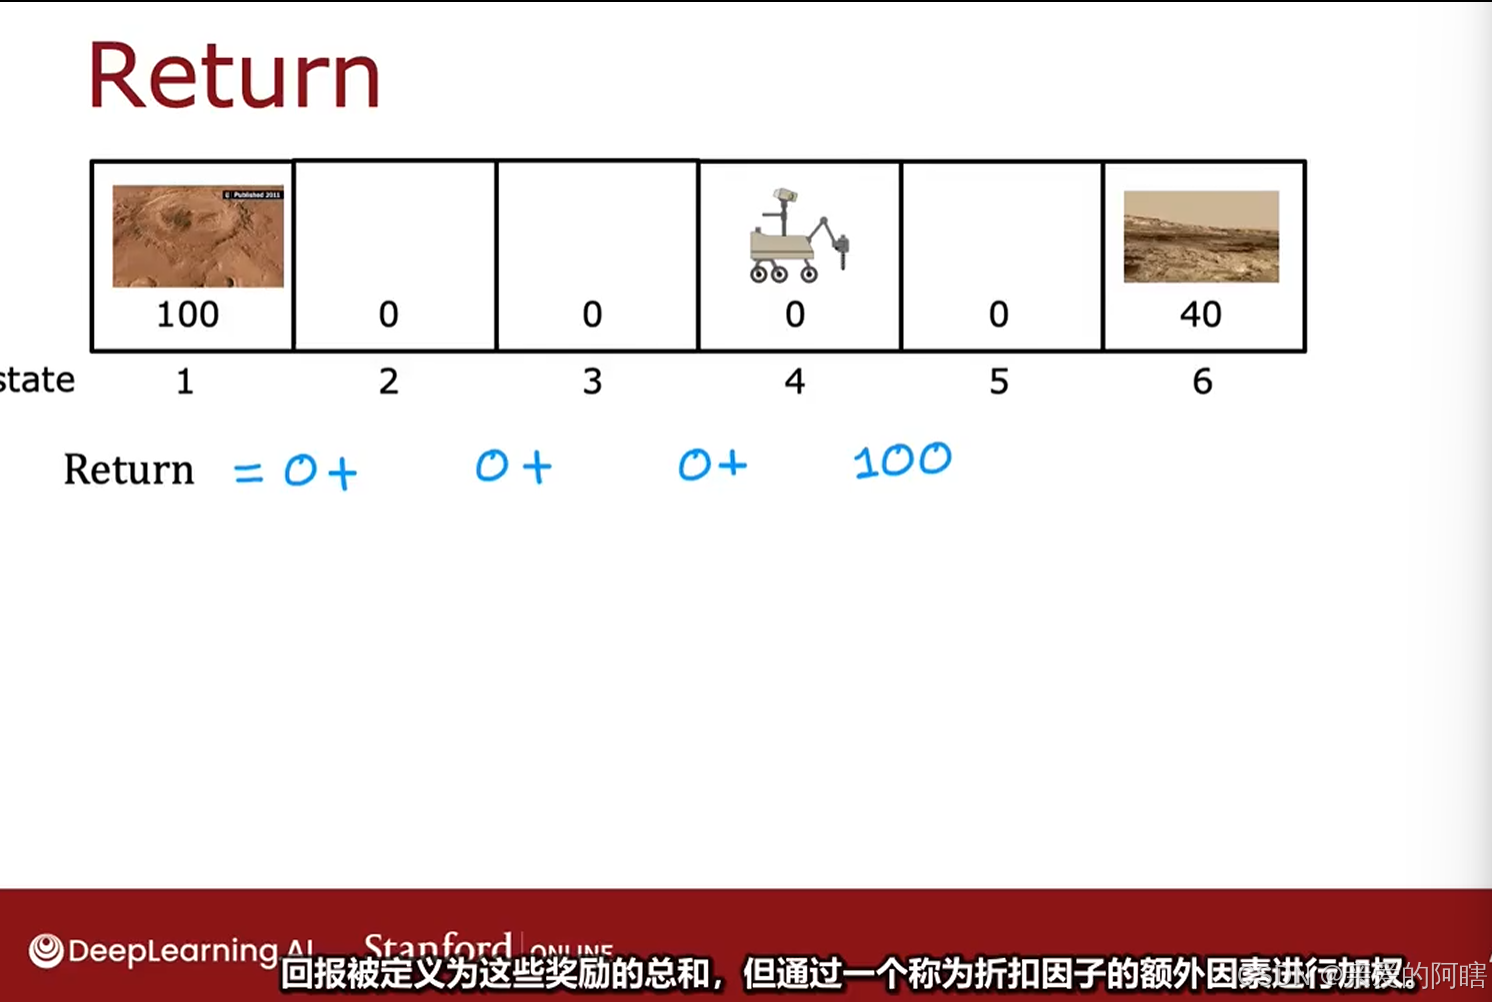
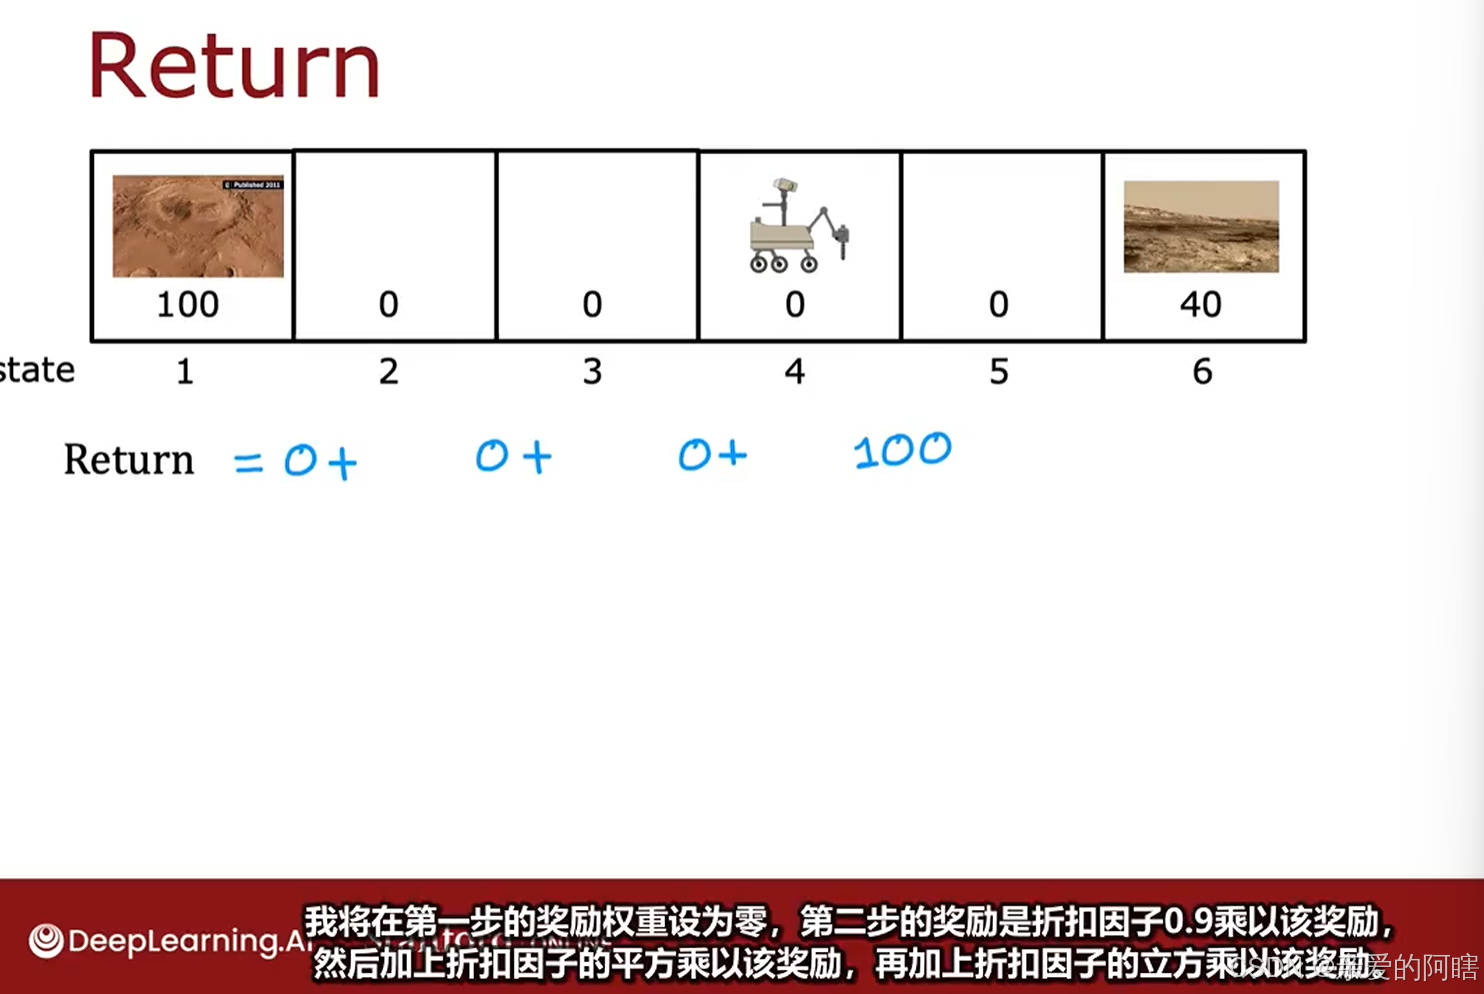
状态:

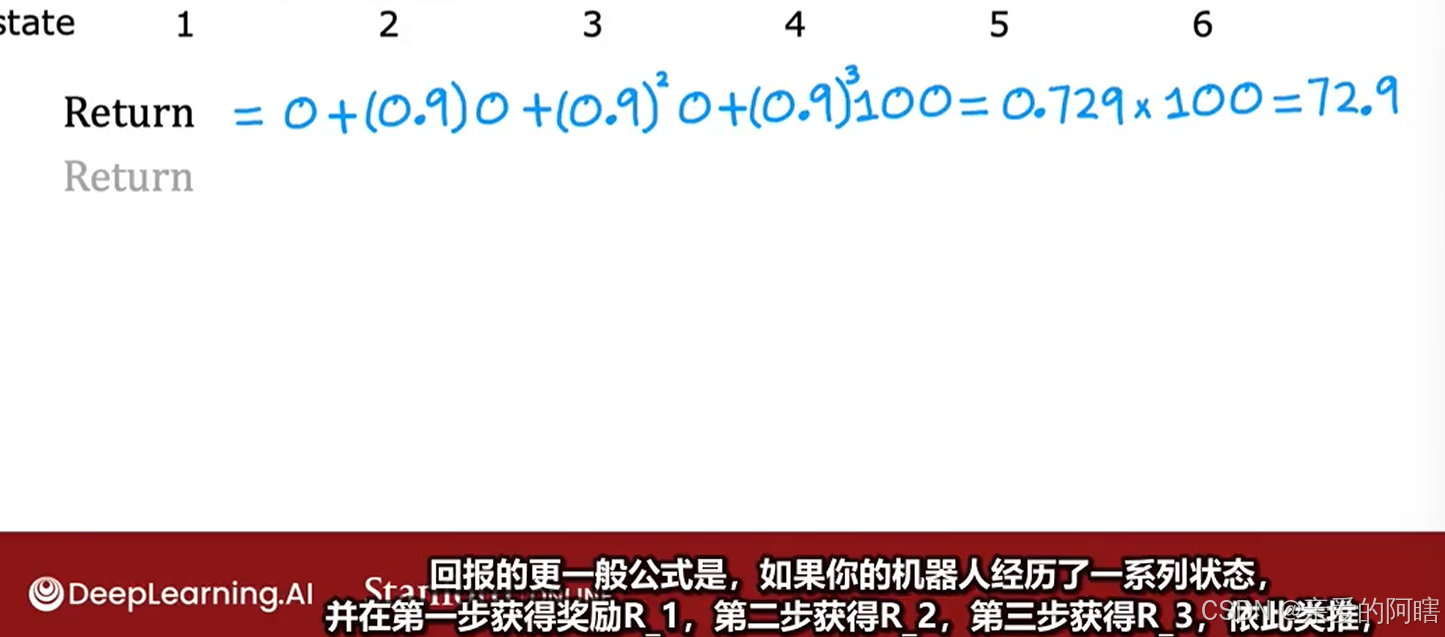
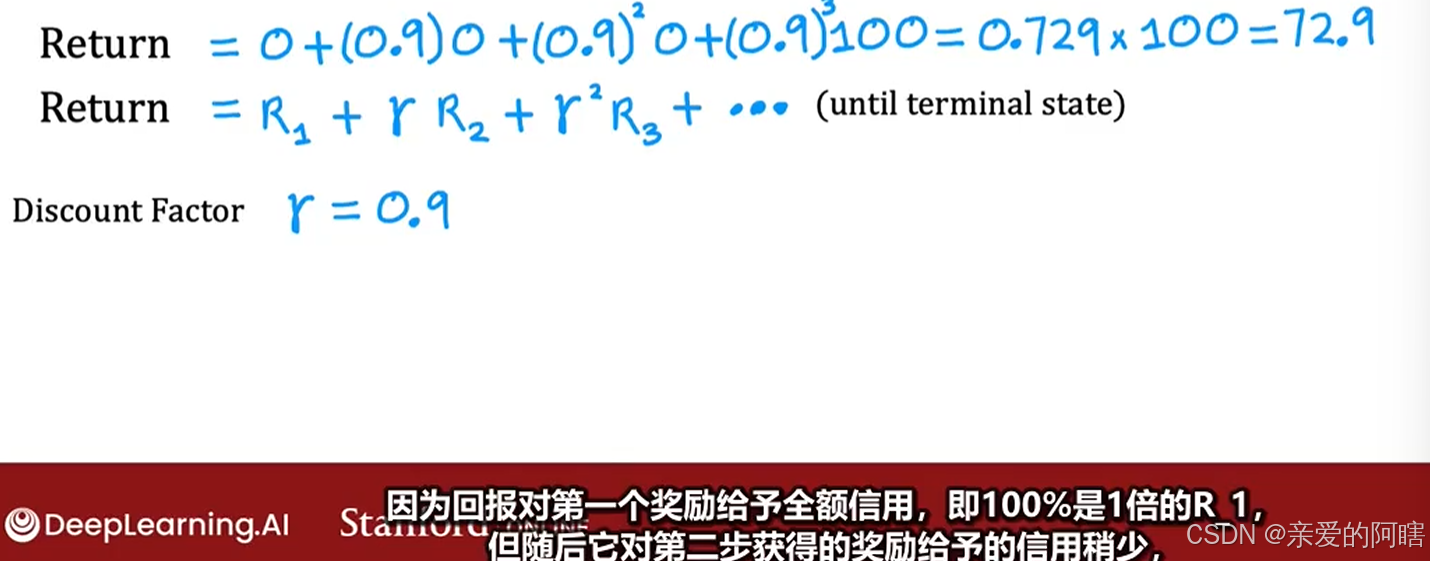
回报:

(更快的获得奖励可能比需要很长时间才能得到的奖励更具有吸引力)
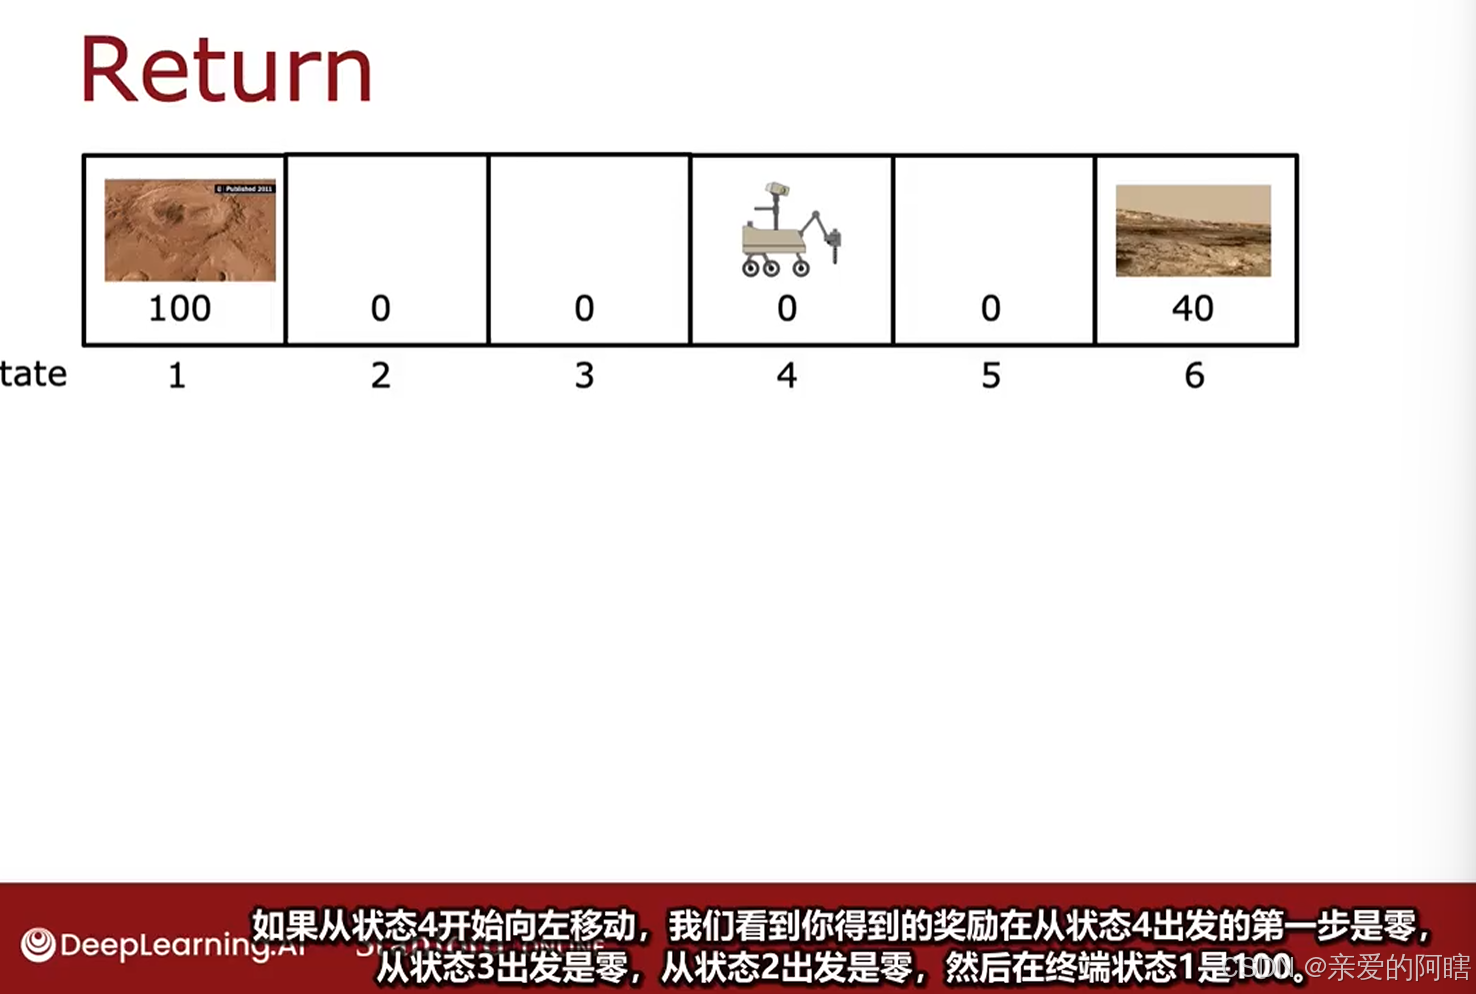


折扣因子一般是比1少一点的数,如0.9,0.99,0.999等,下面为了说明目的,暂且使用0.5的折扣因子,这将极大的降低未来奖励的权重,或者说极大的折扣了未来的奖励,因为每经过一个时间戳,你只能获得比前一步少一半的奖励信用。
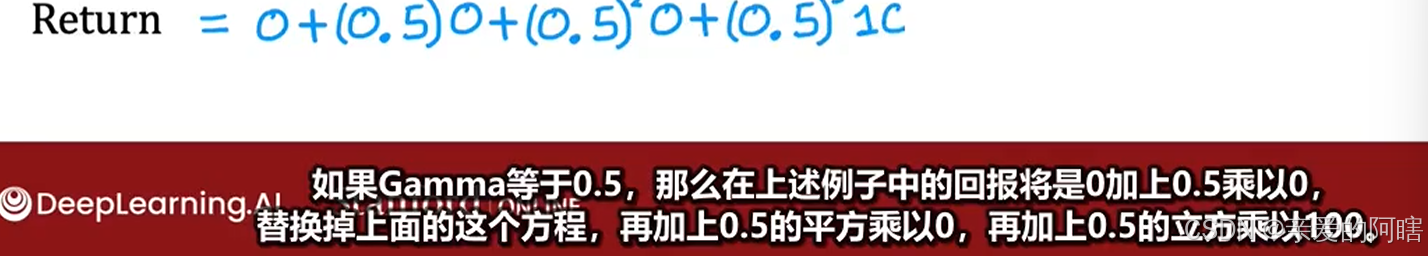
例子:

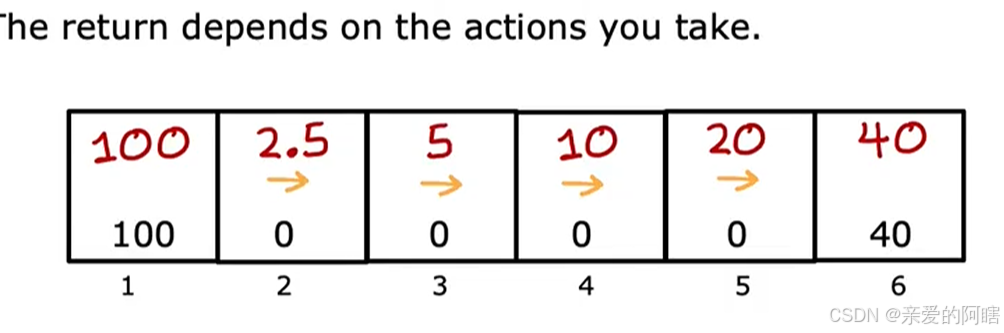
(你得到的奖励取决于奖励,而奖励又取决于你采取的行动,因此回报取决于你采取的行动)

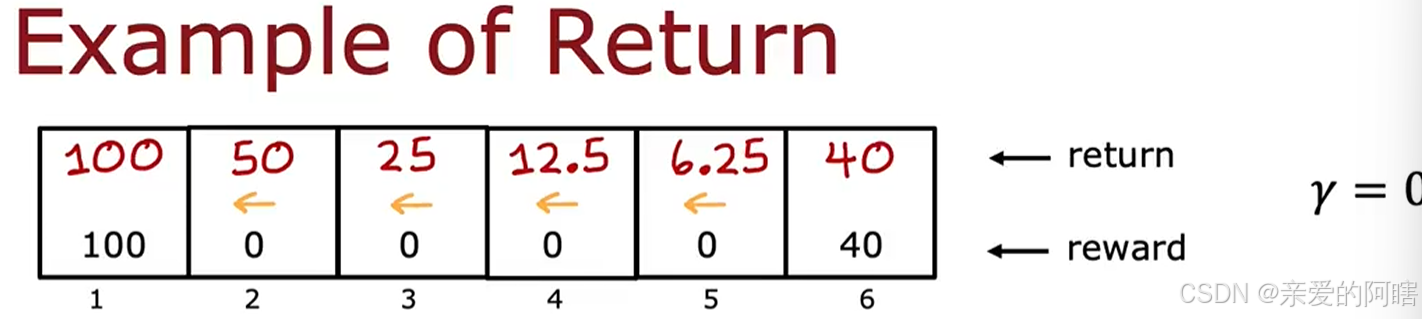
例1:基于上述例子,若一直只往左走,折扣因子=0.5,则分别从不同状态起步获得的奖励计算如下:
例2:如果总往右走,那么如果从状态4开始,(下图中第一个0右上角的4表示状态4)
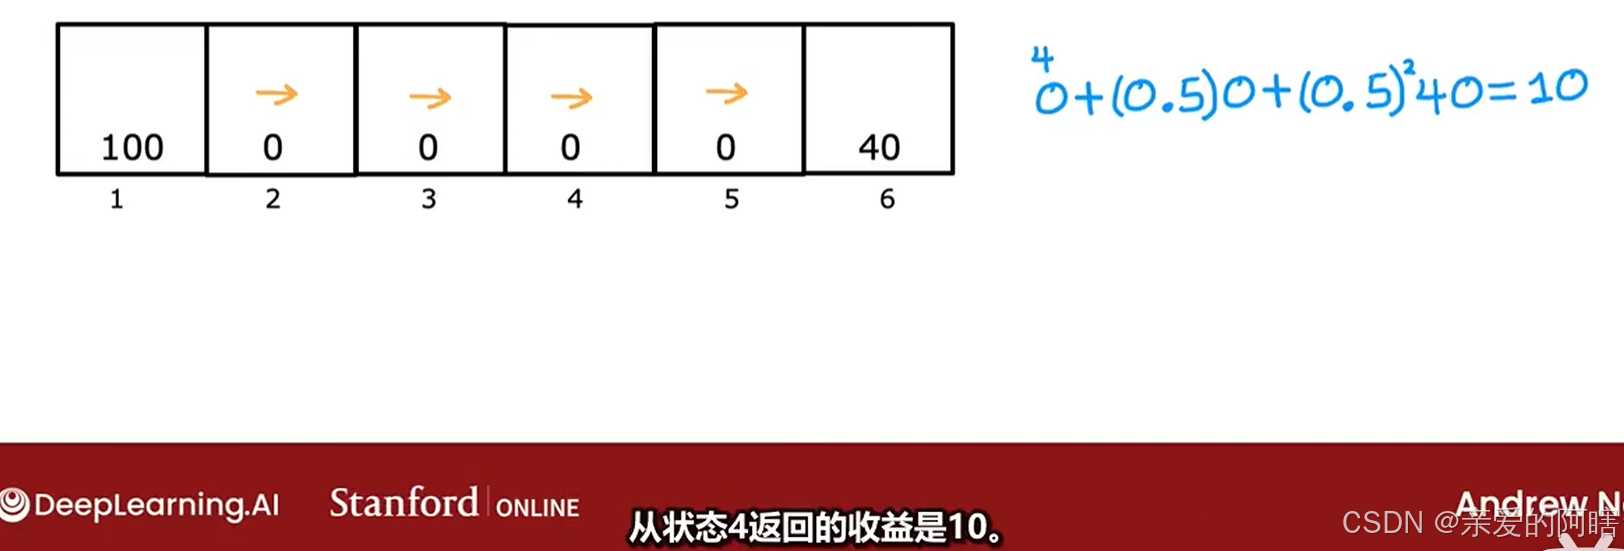
分别从不同状态起步获得的奖励计算如下:
二、强化学习中的策略

在强化学习中,我们的目标是提出一个称为策略Pi的函数,其任务是接收任何状态s作为输入,并将其映射到它希望我们采取的某个动作a。
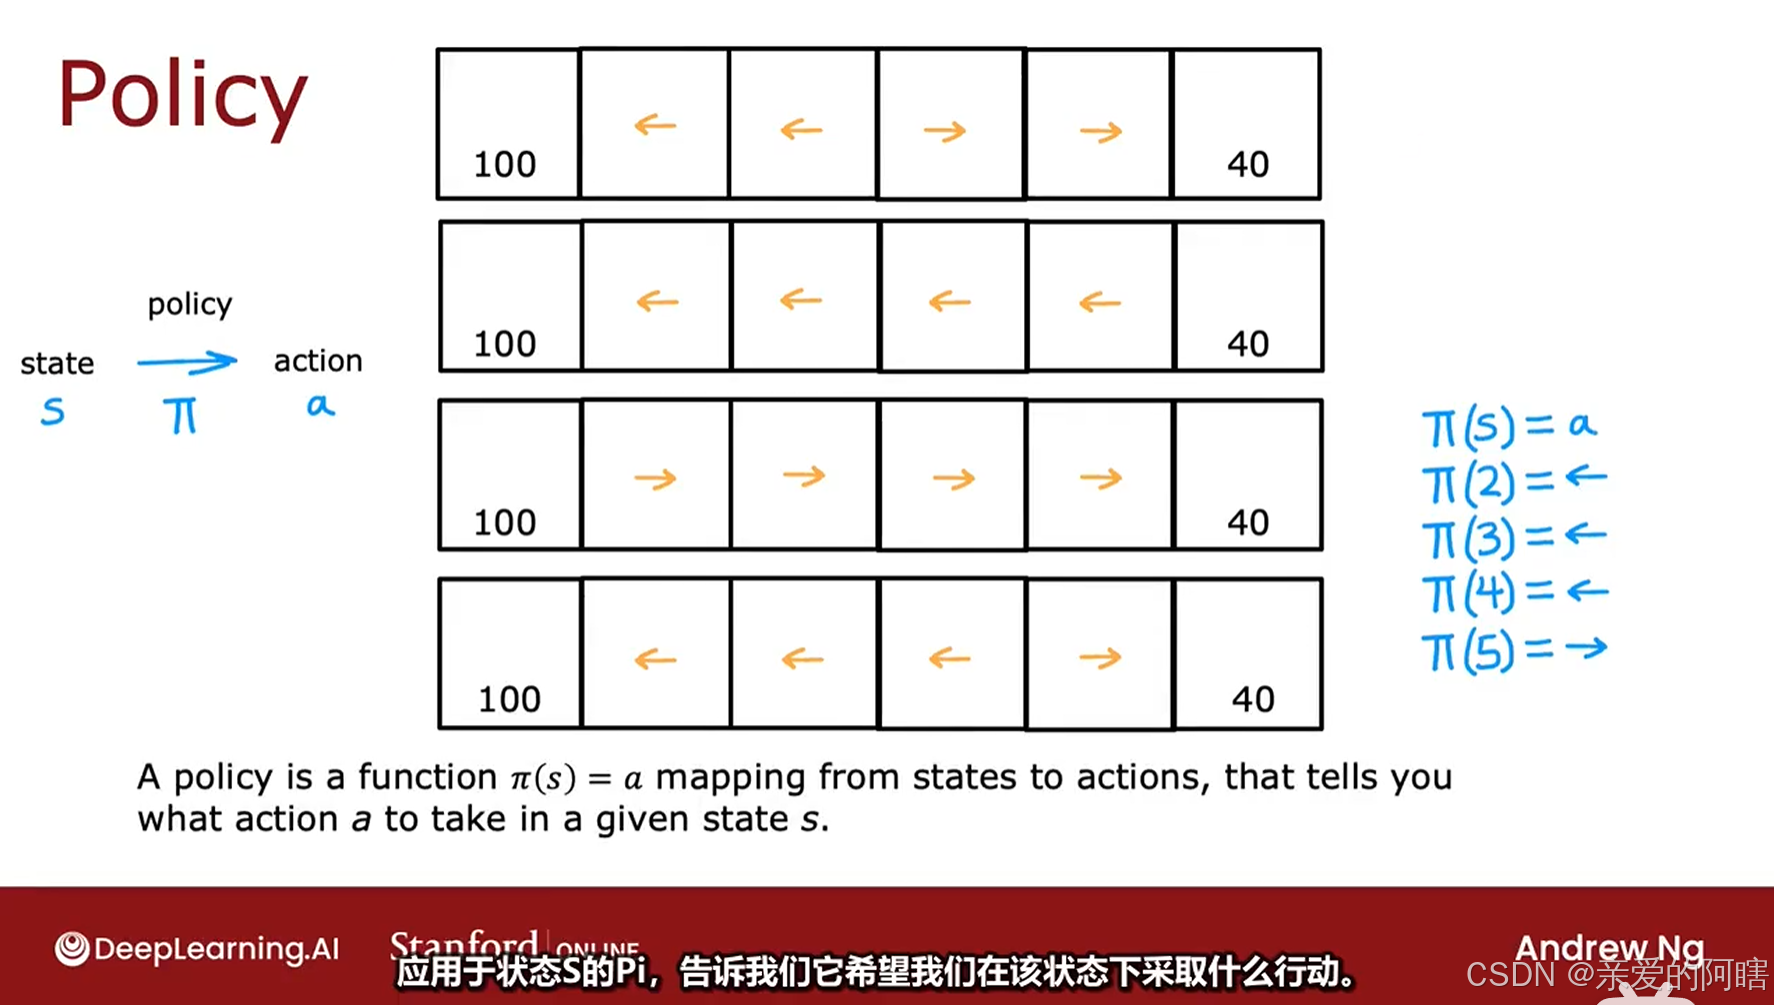
强化学习的目标是找到一个策略Pi或S的Pi,它告诉你在每个状态下应采取什么行动,以最大化回报。

相关推荐
橙臣程10 小时前
RL 冷启动省在哪?从 GRPO 同分组到工具调用奖励
强化学习
草履虫AI课1 天前
强化学习从零到一 03|算法地图:基于模型 vs 不基于模型
强化学习
星马梦缘1 天前
openarm 双臂协作模仿学习 · 入门路线
机械臂·强化学习·模仿学习·openarm·双臂协作·冗余臂
隔窗听雨眠4 天前
大模型强化学习训练的工程实现与调优路径
大模型·强化学习·llm训练
Jsundoku4 天前
第十四章 深度学习 -- 基于模型的方法
人工智能·强化学习
草履虫AI课6 天前
强化学习从零到一 01|基本概念:从试错到马尔可夫决策过程
强化学习
盼小辉丶6 天前
PyTorch强化学习实战——从零开始实现魔方求解器
pytorch·深度学习·强化学习
lucas_AI9 天前
预训练、SFT、RL 是同一个算法?CMU 把大模型训练流水线拧成了一个「数据旋钮」
强化学习
猫先生Mr.Mao10 天前
让动作先接受“未来检验”:ThinkWorld 如何用世界想象强化机器人推理
机器人·强化学习·具身智能·vla·世界模型·thinkworld
Jsundoku10 天前
第三章 强化学习 -- 多臂老虎机
人工智能·强化学习·多臂老虎机·朴素策略·置信上界算法·贝叶斯老虎机·上下文老虎机