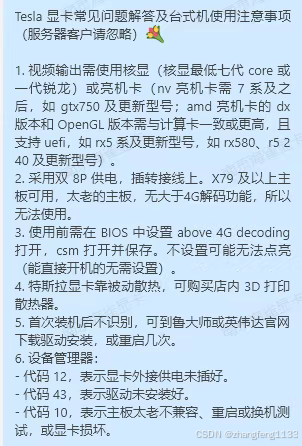
P100显卡使用体验&AI部署小结,转发网友的用户体验
入手多张P100显卡用于本地AI部署,这款卡属于帕斯卡架构初代AI卡,也是该架构里唯一搭载FP16单元的型号,游戏表现并不理想:FP32性能相比1080Ti低16%,借道输出还会进一步损耗性能,基本不适合玩游戏。
但它跑AI任务实用性很强,虽架构偏老旧,FP16算力和2080持平,运行大语言模型完全够用,相关实测情况如下:
- 双卡部署:使用LM Studio流水线做多卡部署,运行Qwen3 14B FP16模型,推理速度可达16词/秒;
- 单卡部署:单卡运行Q6_K_M量化版模型(部分参数载入内存),推理速度约15词/秒,MOE模型受内存加载影响较小;
- 待测试模型:理论上可运行Qwen3 30B A3B INT8版本,暂未实测。
P100 与 P40 对比
两款显卡各有优劣,适配场景不同:
- P100:支持FP16、无原生INT8;
- P40:支持INT8、无原生FP16,拥有24GB大显存,显存优势突出。
模型精度决定实际算力表现,若显卡精度与模型不匹配,会自动切换更高精度运行,推理速度会有所下降。
目前已用双卡流水线部署沐雪Qwen3 14B FP16模型并接入QQ,整体响应速度流畅,主要用于社群娱乐使用。
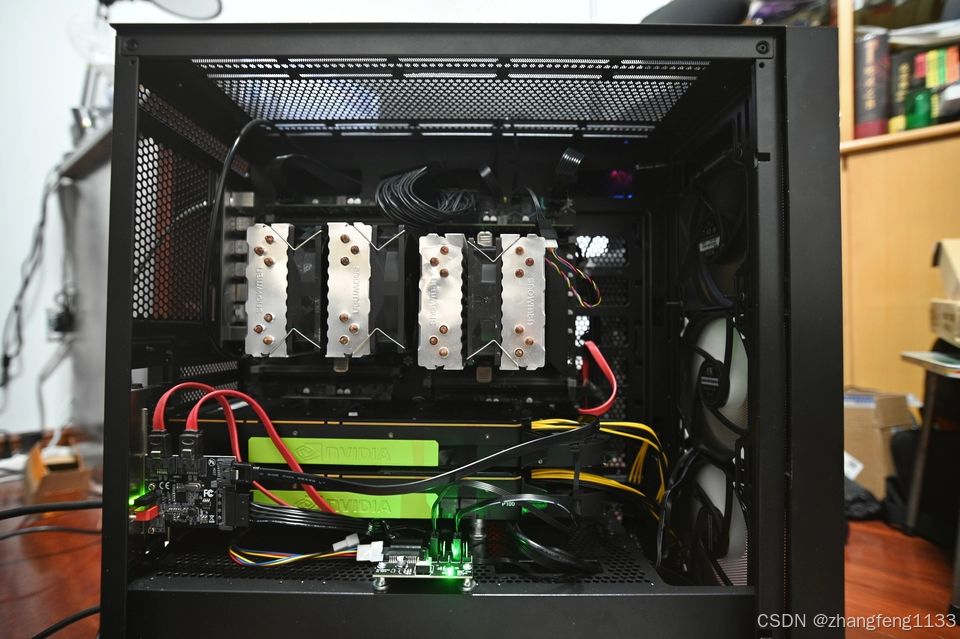
如图双卡流水线部署沐雪qwen3 14b fp16(感谢沐雪项目组调出如此萌的模型~
下面把 P100 / P40 / V100 / RTX 4090 的发布/上市时间、大致出厂年份、架构与工艺一次性说清楚(都用北京时间/公版正式发布为准):
1. Tesla P100(Pascal,16nm)
- 发布:2016-04-05(GTC 2016)
- 正式上市:2016-06-20 起(PCIe 版)
- 主要出厂年份 :2016--2017
- 定位:初代 Pascal 数据中心卡,唯一带原生 FP16 的 Pascal 卡。
2. Tesla P40(Pascal,16nm)
- 发布:2016-09-13(GTC China)
- 正式上市:2016-10 起
- 主要出厂年份 :2016--2017
- 定位:推理卡,INT8 强、FP16 极弱,24GB GDDR5。
3. Tesla V100(Volta,12nm)
- 发布:2017-05-10(GTC 2017)
- 正式上市:2017 年中(DGX-1 先上,之后 PCIe/SXM2)
- 主要出厂年份 :2017--2019
- 定位:第一代带 Tensor Core 的数据中心卡,FP16 训练/推理王者。
4. RTX 4090(Ada Lovelace,4N/5nm)
- 发布:2022-09-20(GTC 2022)
- 正式上市:2022-10-12
- 主要出厂年份 :2022--2024
- 定位:消费旗舰,第四代 Tensor Core,FP16 峰值算力远超 V100。
一眼看懂时间线
- 2016:P100(4月)→ P40(9月)
- 2017:V100(5月)
- 2022:RTX 4090(9/10月)
P100 P40 v100 4090 FP16下面的的基准算力和峰值算力
先给结论(单位都是 TFLOPS):
FP16 基准算力(纯 CUDA Core,无 Tensor Core)
- P100 :18.7~21.2(PCIe≈18.7,SXM2≈21.2)
- P40 :≈0.184(基本无FP16加速,靠FP32模拟)
- V100 :≈28~30(不用Tensor Core时)
- RTX 4090 :≈82.6(纯CUDA Core,非Tensor Core模式)
FP16 峰值算力(含 Tensor Core 加速)
- P100 :21.2(本身就没有Tensor Core,基准=峰值)
- P40 :0.184(无Tensor Core,且FP16极弱)
- V100 :112~125(PCIe≈112,SXM2≈125)
- RTX 4090 :165~166(开启Tensor Core)
简要说明(帮你和你前面的使用感受对上)
- P100 :Pascal里唯一有原生FP16,21.2 TFLOPS,和**2080(≈20~23 TFLOPS)**差不多,所以你跑Qwen3 14B FP16很合适。
- P40 :FP16极弱(只有0.184 TFLOPS ),强项是INT8(≈47 TOPS) +24GB显存,适合INT8推理,不适合FP16训练/大模型FP16推理。
- V100 :Volta,第一代Tensor Core,FP16峰值125T,远强于P100,但老、贵、显存只有16/32GB。
- 4090 :消费卡,FP16 Tensor Core 165T,比V100还高,24GB显存,LLM推理现在最香,但不是数据中心卡,ECC/长期稳定性不如Tesla系列。