一、简介
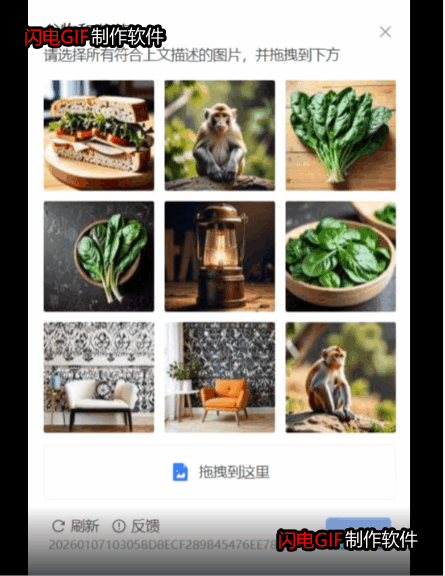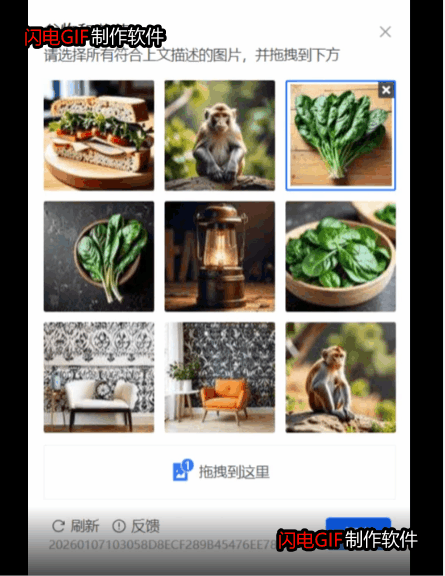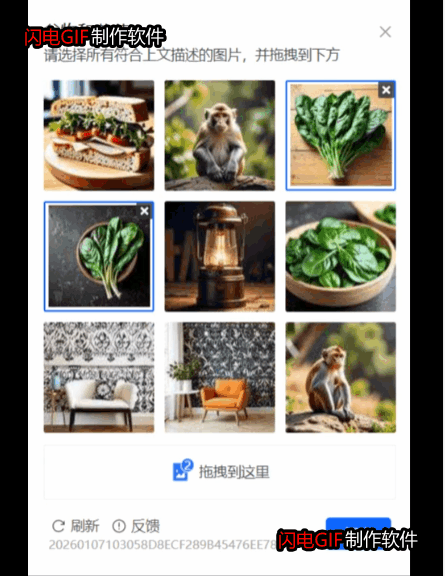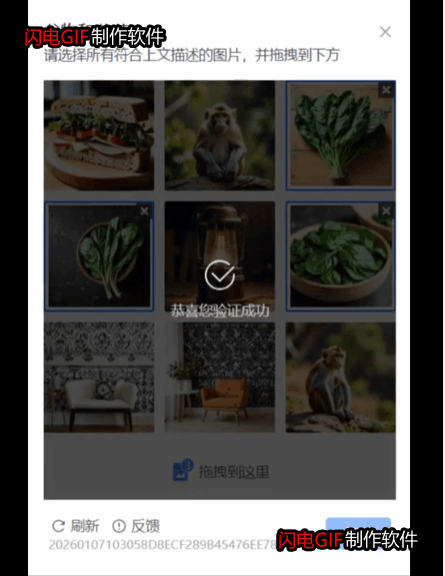
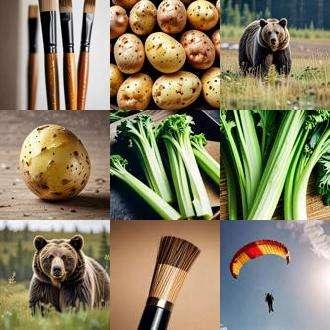
上图是抖音九宫格验证码图片的样例图片。这款验证码确实有很大的难度,有一下几个特点:
1、首先是图片种类非常多。
2、其次图片都是由AI随机生成,每一张图片都不一样。
3、还需要结合语义进行理解
二、识别准备
经过我们几个月的研究,终于完成了这款识别模型的开发,正确率能达到90%以上,并且我们还会持续更新,争取达到100%的正确率。
识别这个图片需要上传两个东西:
1、九宫格原图
目前不支持截图,原图是通过图片链接下载的图片,是这种直接拼接的图片,不像页面显示的有变色间隔。
2、点击描述文本
描述文本页面上显示的是什么,就需要传什么。不能修改,不能自定义描述,也不能去掉原本的标点符号。
三、识别代码
下面是使用python写的识别样例代码
python
import base64
import requests
import datetime
from io import BytesIO
from PIL import Image, ImageDraw

t1 = datetime.datetime.now()

#PIL图片保存为base64编码
def PIL_base64(img, coding='utf-8'):
    img_format = img.format
    if img_format == None:
        img_format = 'JPEG'

    format_str = 'JPEG'
    if 'png' == img_format.lower():
        format_str = 'PNG'
    if 'gif' == img_format.lower():
        format_str = 'gif'

    if img.mode == "P":
        img = img.convert('RGB')
    if img.mode == "RGBA":
        format_str = 'PNG'
        img_format = 'PNG'

    output_buffer = BytesIO()
    # img.save(output_buffer, format=format_str)
    img.save(output_buffer, quality=100, format=format_str)
    byte_data = output_buffer.getvalue()
    base64_str = 'data:image/' + img_format.lower() + ';base64,' + base64.b64encode(byte_data).decode(coding)
    # base64_str = base64.b64encode(byte_data).decode(coding)

    return base64_str

# 加载图片
img1 = Image.open(r'E:\Python\lixin_project\OpenAPI接口测试\test_img\86.jpg')
# 图片转base64
img1_base64 = PIL_base64(img1)

得塔云地址
http://bq1gpmr8.xiaomy.net(电信)
http://220.167.181.200:9009(移动、电信、联通)
根据不同网络选择不同接口

# 验证码识别接口
url = "http://bq1gpmr8.xiaomy.net/openapi/verify_code_identify/"
data = {
    # 用户的key
    "key":"2zLW3AnTbYJaEV4ofH3G",
    # 验证码类型
    "verify_idf_id":"86",
    # 样例图片
    "img_base64":img1_base64,
    # 点击的物品名称
    "words": "有哪些生态元素可以在森林中看到?",
}
header = {"Content-Type": "application/json"}

# 发送请求调用接口
response = requests.post(url=url, json=data, headers=header)
point_list = eval(response.json()['data']['res_str'])
# 获取响应数据,识别结果
print(response.text)
print("耗时:", datetime.datetime.now() - t1)

img1 = img1.convert("RGB")
draw = ImageDraw.Draw(img1)
point_list = [(x[0] - 5, x[1] - 5, x[0] + 5, x[1] + 5) for x in point_list]
for point in point_list:
    draw.ellipse(point, fill=(255, 0, 0))
# 显示识别后标记的点击点
img1.show()
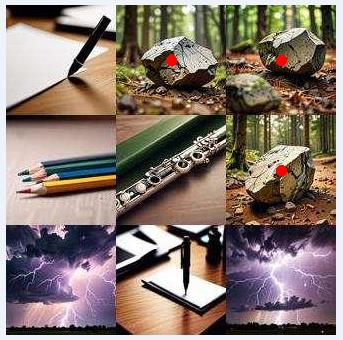
运行上面代码,用红色圆点标注出了需要点击的图片,如下图
想了解更多验证码识别请访问:得塔云