FastAPI业务开发几乎离不开数据库的CRUD。很多入门教程沿用同步 SQLALchemy的写法,在路由函数创建Session,用seeeion.query(...).filter(...)查数据库,看起来直观,却于FastAPI的async def异步模型天然冲突。一旦在async路由中调用同步ORM,底层会在主线程做阻塞IO,整个事件循环被卡住,其他请求只能排队等待,并发能力瞬间清零。 在本文面向需要对接Mysql/PostgreSQL/SQLite做CRUD业务的开发者,采用SQLAlchemy2.0全套异步写法,create_async_engine创建引擎、AsyncSession执行查询、依赖注入管理会话生命周期,并落地分页、联表、事务回滚与完整用户CRUD。
一、为什么必须摒弃同步SQLAlchemy
1.1 同步ORM在async路由里发生了什么
FastAPI的worker基于asyncio事件循环。当你写async def get_users()时,框架期望函数内部的IO都是可让出控制权的,遇到网络或磁盘等待时,事件循环可以去处理别的请求。
同步SQLAlchemy的session.execute()底层调用的是阻塞式 驱动如标准库sqlite3、pymysql,调用期间线程被占满,事件循环无法切换。表现就是QPS上不去、延迟随并发线性恶化。
常见反模式包括,在async路由里直接用Session;用run_in_executor把同步ORM包一层当作异步用;混用time.sleep与同步数据库调用。正确路径是引擎、会话、驱动、路由四层全部走async栈。
1.2 异步栈的核心组件
下面这段代码展示了SQLAlchemy 2.0异步ORM的最小闭环:
python
from sqlalchemy import select
from sqlalchemy.ext.asyncio import create_async_engine, async_sessionmaker, AsyncSession

engine = create_async_engine("sqlite+aiosqlite:///./data/app.db")
SessionLocal = async_sessionmaker(engine, class_=AsyncSession, expire_on_commit=False)

async with SessionLocal() as session:
    result = await session.execute(select(User).where(User.id == 1))
user = result.scalar_one_or_none() create_async_engine创建的是异步引擎 ,连接串前缀必须是sqlite+aiosqlite或postgresql+asyncpg、mysql+asyncmy,而不能是裸sqlite:///,后者会走同步sqlite3驱动。async_sessionmaker是会话工厂,每次SessionLocal()产出一个AsyncSession实例。expire_on_commit=False表示commit之后ORM对象属性仍可访问,避免在Pydantic转换时触发懒加载异常。
async with SessionLocal() as session进入上下文时从连接池或SQLite的NullPool取连接,退出时归还。await session.execute(select(User)...)中的await不可省略:它把控制权交还给事件循环,等待aiosqlite完成磁盘IO。scalar_one_or_none()从结果集中取单行或None,比老版.query().first()更符合2.0风格。
1.3 同步与异步,请求调度差异
为了方便理解画了一个图:
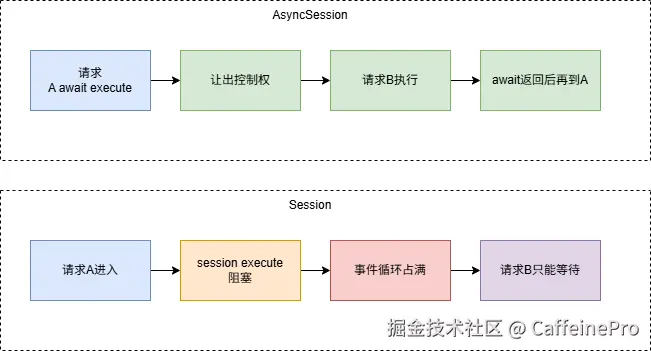
同步执行的session.execute会阻塞当前线程并持续占用事件循环,数据库IO等待期间不会释放执行权。当新请求到达时只能排队等待,无法实现真正并发,高并发场景下极易出现接口响应缓慢、服务吞吐量暴跌。
AsyncSession依托异步IO模型适配异步框架。执行await session.execute遇到数据库IO等待时,会主动让出事件循环控制权,允许其他请求继续处理;待数据库响应返回后,调度器再恢复当前请求后续逻辑,充分利用等待时间处理更多请求,保障服务并发能力。
二、工程分层与整体架构
2.1 目录职责
在写这篇博客时创建了一个demo,demo按配置、连接、模型、业务、路由分层,避免把所有SQL写在路由里:
bash
demo/
├── data/app.db                 # SQLite文件,首次启动自动创建
├── app/
│   ├── core/config.py          # DATABASE_URL、连接池环境变量
│   ├── core/database.py        # 异步引擎、session工厂、池状态
│   ├── core/lifespan.py        # 建表、种子数据、关闭引擎
│   ├── dependencies/session.py # get_db依赖注入
│   ├── models/user.py          # ORM表模型(User + UserProfile)
│   ├── schemas/user.py         # Pydantic请求/响应DTO
│   ├── services/user_service.py# 分页、联表、CRUD、事务逻辑
│   └── api/users.py            # HTTP路由,只做参数校验与调用service
├── run.py
└── scripts/smoke_test.py 路由层不写SQL,service层不碰Request对象,模型层不混入Pydantic,职责清晰后,换数据库或加缓存只需改core/与services/,路由签名可以保持不变。
2.2 从HTTP到磁盘的数据流
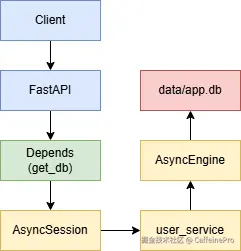
一次典型的GET /api/v1/users请求会经过:FastAPI解析Query参数、Depends(get_db)创建AsyncSession并注入路由、路由调用user_service.list_users(session, ...)、service用await session.execute(select(User)...)发SQL、aiosqlite读写data/app.db、结果转成Pydantic返回JSON、get_db在成功路径commit(只读查询commit开销很小)、异常路径 rollback。
三、配置与本地SQLite真实连接
3.1 连接串与环境变量
数据库地址集中在app/core/config.py,默认指向项目内的SQLite文件:
python
DEFAULT_SQLITE_PATH = DATA_DIR / "app.db"

database_url: str = _env_str(
    "DATABASE_URL",
    f"sqlite+aiosqlite:///{DEFAULT_SQLITE_PATH.as_posix()}",
) 这里有三处细节值得注意。第一,前缀是sqlite+aiosqlite,明确告诉SQLAlchemy使用aiosqlite异步驱动。第二,路径用as_posix()转成正斜杠,避免Windows反斜杠在URL中被误解析(在window环境中)。第三,通过_env_str("DATABASE_URL", ...)支持环境变量覆盖,上线换库不用改代码。
本地开发可直接使用默认值;切换MySQL/PostgreSQL时设置环境变量即可:
bash
set DATABASE_URL=sqlite+aiosqlite:///./data/app.db

rem 生产MySQL示例
rem set DATABASE_URL=mysql+asyncmy://user:pass@127.0.0.1:3306/demo

rem 生产PostgreSQL示例
rem set DATABASE_URL=postgresql+asyncpg://user:pass@127.0.0.1:5432/demo 连接池相关参数也在Settings中定义:pool_size、max_overflow、pool_timeout、pool_recycle、pool_pre_ping。SQLite本地开发会忽略大部分池参数,MySQL/PostgreSQL则会生效。
3.2 lifespan建表与种子数据
应用启动时,lifespan负责初始化数据库结构,而不是在第一个请求里顺手建表:
python
async def _init_schema() -> None:
    DATA_DIR.mkdir(parents=True, exist_ok=True)
    engine = get_engine()
    async with engine.begin() as conn:
        await conn.run_sync(Base.metadata.create_all)

async def _seed_if_empty() -> None:
    factory = get_session_factory()
    async with factory() as session:
        count = await session.scalar(select(User.id).limit(1))
        if count is not None:
            return
        alice = User(username="alice", email="alice@example.com", role="admin")
        bob = User(username="bob", email="bob@example.com", role="user")
        session.add_all([alice, bob])
        await session.flush()
        session.add_all([
            UserProfile(user_id=alice.id, nickname="管理员 Alice", bio="系统管理员"),
            UserProfile(user_id=bob.id, nickname="Bob", bio="普通用户"),
        ])
await session.commit() _init_schema先确保data/目录存在,再用engine.begin()开启事务上下文,调用Base.metadata.create_all根据ORM模型创建users、user_profiles表。run_sync是因为create_all内部仍是同步API,SQLAlchemy 用这种方式在async引擎上安全执行。
_seed_if_empty检查是否已有用户,避免每次重启重复插入。flush()把INSERT发到数据库并拿到自增id,但尚未commit;随后用alice.id创建关联的UserProfile。种子数据的commit在lifespan里显式完成,与请求级get_db的commit相互独立。
应用关闭时await dispose_engine()释放连接池,防止进程退出时连接泄漏。
四、异步引擎与会话工厂,连接池调优
4.1 按数据库类型选择池策略
app/core/database.py中的create_engine_from_settings()根据URL方言选择不同的连接池实现:
python
def create_engine_from_settings() -> AsyncEngine:
    kwargs: dict = {"echo": settings.db_echo}

    if _is_sqlite(settings.database_url):
        kwargs["poolclass"] = NullPool
        kwargs["connect_args"] = {"timeout": 30}
    else:
        kwargs.update({
            "poolclass": QueuePool,
            "pool_size": settings.pool_size,
            "max_overflow": settings.max_overflow,
            "pool_timeout": settings.pool_timeout,
            "pool_recycle": settings.pool_recycle,
            "pool_pre_ping": settings.pool_pre_ping,
        })

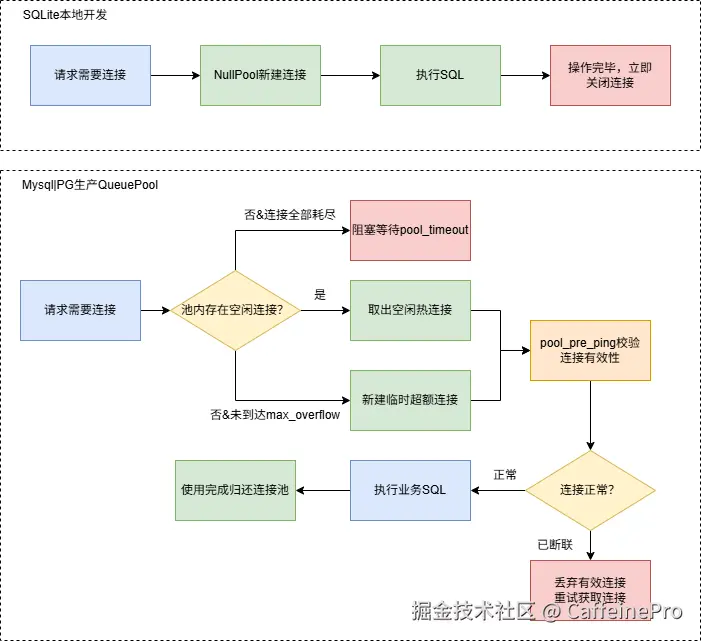
return create_async_engine(settings.database_url, **kwargs) SQLite使用NullPool的含义是:每次需要连接时新建、用完即关 ,不做连接复用。这是因为SQLite文件锁机制与多连接复用在高并发写场景下容易踩坑;本地demo求稳不求极致性能。connect_args={"timeout": 30}表示锁等待最多30秒,避免立刻抛出database is locked。
MySQL/PostgreSQL则使用QueuePool常驻连接池,各参数含义如下:pool_size=5表示池内保持5条热连接;max_overflow=10表示高峰时最多再临时创建10条;pool_timeout=30是等待空闲连接的上限秒数;pool_recycle=1800每30分钟回收连接,防止MySQL gone away;pool_pre_ping=True在取出连接前先ping,自动丢弃已断开的连接。
4.2 进程级单例,引擎与会话工厂
python
_session_factory: async_sessionmaker[AsyncSession] | None = None

def get_session_factory() -> async_sessionmaker[AsyncSession]:
    global _session_factory
    if _session_factory is None:
        _session_factory = async_sessionmaker(
            bind=get_engine(),
            class_=AsyncSession,
            expire_on_commit=False,
            autoflush=False,
            autocommit=False,
        )
return _session_factory 引擎和async_sessionmaker在进程内只创建一次,所有请求共享同一个连接池(SQLite的NullPool除外)。切忌 在每个路由或每次get_db里调用create_async_engine,那样每请求一个池,连接数会爆炸,且无法发挥池化优势。autoflush=False让flush时机由代码显式控制(await session.flush()),避免在复杂事务中发生意外写入。
GET /health/db调用get_pool_status()SQLite返回dialect与NullPool说明;MySQL/PG返回checked_in、checked_out、overflow等实时指标,便于运维观察池是否耗尽。整体流程如下图所示:
五、数据库会话依赖注入
5.1 get_db的完整生命周期
每个HTTP请求borrow一个AsyncSession,请求结束时统一commit或rollback:
python
async def get_db() -> AsyncGenerator[AsyncSession, None]:
    factory = get_session_factory()
    async with factory() as session:
        try:
            yield session
            await session.commit()
        except Exception:
            await session.rollback()
raise 这段代码是FastAPI依赖注入与SQLAlchemy会话管理的标准结合。yield session之前,会话已创建并绑定连接;路由函数和service层拿到的都是同一个session实例 。yield之后、路由正常返回时,执行await session.commit()提交本请求内的所有改动(包括service里flush过的INSERT/UPDATE/DELETE)。
若路由或service抛出任何异常,进入except分支rollback(),撤销未提交改动,再raise把异常交给FastAPI转成500/404等HTTP响应。
service层不应 自行commit(种子数据等特殊场景除外),否则与get_db的双重commit容易让事务边界混乱。service只负责add、flush、execute;何时提交由依赖统一决定。
5.2 路由侧如何声明
python
@router.get("", response_model=PaginatedUsers)
async def list_users(
    page: int = Query(default=1, ge=1),
    page_size: int = Query(default=10, ge=1, le=100),
    session: AsyncSession = Depends(get_db),
) -> PaginatedUsers:
    items, total = await user_service.list_users(session, page=page, page_size=page_size)
return PaginatedUsers(total=total, page=page, page_size=page_size, items=[...]) Depends(get_db)告诉FastAPI:在执行list_users之前,先运行get_db生成器,把产出的session注入参数。对调用方而言,函数签名一眼可见这个接口需要数据库会话。测试时可以用app.dependency_overrides[get_db]替换为内存假session,无需启动真实数据库。
若service抛出UserNotFoundError,路由转为HTTPException(404),同样触发get_db的rollback------虽然只读查询rollback无实质影响,但保证了异常路径行为一致。
六、表模型定义Mapped与relationship
6.1 User主表
SQLAlchemy 2.0推荐使用带类型注解的Mapped风格,IDE与mypy都能推断字段类型:
python
class User(Base):
    __tablename__ = "users"

    id: Mapped[int] = mapped_column(primary_key=True, autoincrement=True)
    username: Mapped[str] = mapped_column(String(50), unique=True, index=True)
    email: Mapped[str] = mapped_column(String(120), unique=True, index=True)
    role: Mapped[str] = mapped_column(String(20), default="user")
    is_active: Mapped[bool] = mapped_column(Boolean, default=True)
    created_at: Mapped[datetime] = mapped_column(
        DateTime(timezone=True),
        server_default=func.now(),
) __tablename__指定真实表名。unique=True 与 index=True 会在建表时生成唯一约束与索引,对应 username/email 不可重复的业务规则。server_default=func.now() 让数据库在 INSERT 时自动填创建时间,不必在 Python 侧手动赋值。主键 autoincrement=True 配合后面的 flush() 可以在 commit 前拿到新用户的 id。
6.2 UserProfile与一对一关系
python
    profile: Mapped["UserProfile | None"] = relationship(
        "UserProfile",
        back_populates="user",
        uselist=False,
        cascade="all, delete-orphan",
    )

class UserProfile(Base):
    __tablename__ = "user_profiles"
    user_id: Mapped[int] = mapped_column(
        ForeignKey("users.id", ondelete="CASCADE"),
        unique=True,
    )
    nickname: Mapped[str] = mapped_column(String(80))
    bio: Mapped[str | None] = mapped_column(Text, nullable=True)
user: Mapped[User] = relationship(back_populates="profile") relationship不会在数据库里多建列,而是告诉ORM如何JOIN两张表。uselist=False表示一对一:一个User最多一个Profile。back_populates在两侧互指,便于双向导航。cascade="all, delete-orphan"表示删除User时自动删除其Profile;ondelete="CASCADE"在数据库外键层双保险。user_id上的unique=True保证一对一约束。
6.3 Pydantic与ORM的边界
HTTP层使用Pydantic,持久层使用ORM,二者通过model_validate转换:
python
class UserOut(BaseModel):
    model_config = ConfigDict(from_attributes=True)
    id: int
    username: str
    email: EmailStr
    role: str
    is_active: bool
created_at: datetime from_attributes=True(原V1的orm_mode)允许从ORM对象读取属性。路由里写UserOut.model_validate(user)即可生成响应,不要 把ORM对象直接return给FastAPI,也不要在路由里手动{"id": user.id, ...}拼装,Field校验、文档生成都会失效。
七、分页查询
7.1 先count再offset/limit
分页逻辑在user_service.list_users中,分两步:统计总数、查询当前页数据。
python
async def count_users(session: AsyncSession) -> int:
    return int(await session.scalar(select(func.count()).select_from(User)) or 0)

async def list_users(session, *, page, page_size) -> tuple[list[User], int]:
    total = await count_users(session)
    stmt = (
        select(User)
        .order_by(User.id.asc())
        .offset((page - 1) * page_size)
        .limit(page_size)
    )
    result = await session.execute(stmt)
return list(result.scalars().all()), total func.count()生成SELECT count(*) FROM users,scalar()直接取标量值作为 total返回给前端分页组件。第二条查询用offset((page-1)*page_size)跳过前N条,limit(page_size)只取一页。order_by(User.id.asc())保证分页结果稳定,没有ORDER BY时分页可能出现重复或遗漏。
路由把service返回的ORM列表转成Pydantic:
python
return PaginatedUsers(
    total=total,
    page=page,
    page_size=page_size,
    items=[UserOut.model_validate(u) for u in items],
) 响应JSON结构为{"total": 2, "page": 1, "page_size": 10, "items": [...]} 。切忌users = (await session.execute(select(User))).scalars().all()拉全表再在Python里切片,数据量上万时会内存溢出。深度分页(百万行以后)可改用keyset pagination(WHERE id > last_id LIMIT N)。
八、联表查询与N+1问题
8.1 错误做法N+1查询
若先查所有User,再循环查每个User的Profile,会发出1+N条SQL:
python
# 反模式:N+1
users = (await session.execute(select(User))).scalars().all()
for user in users:
    profile = (await session.execute(
        select(UserProfile).where(UserProfile.user_id == user.id)
    )).scalar_one_or_none()
10个用户就是11次数据库往返,列表页用户越多越慢。
8.2 正确做法joinedload一次JOIN
python
stmt = (
    select(User)
    .options(joinedload(User.profile))
    .where(User.id == user_id)
)
result = await session.execute(stmt)
user = result.unique().scalar_one_or_none() joinedload(User.profile)告诉SQLAlchemy在查询User时用LEFT OUTER JOIN一并加载profile,生成的SQL类似 SELECT users.*, user_profiles.* FROM users LEFT JOIN user_profiles ON ... WHERE users.id = ?。unique()必不可少JOIN可能使结果集出现重复行,unique按ORM实体去重。scalar_one_or_none()取单条User(含已加载的profile),找不到则service抛UserNotFoundError,路由转404。
九、完整用户CRUD接口
9.1 创建flush与唯一约束
python
async def create_user(session: AsyncSession, payload: UserCreate) -> User:
    user = User(username=payload.username, email=str(payload.email), role=payload.role)
    session.add(user)
    try:
        await session.flush()
    except IntegrityError as exc:
        raise DuplicateUserError("username or email already exists") from exc

    if payload.nickname:
        session.add(UserProfile(user_id=user.id, nickname=payload.nickname, bio=payload.bio))
        await session.flush()
    return user
session.add(user) 把对象放入会话缓存,尚未写库。await session.flush()把INSERT同步到数据库,拿到自增id,但事务仍未commit,若后续步骤失败,get_db的rollback可以整体撤销。若username/email违反唯一约束,数据库抛IntegrityError,service转为业务异常DuplicateUserError,路由捕获后返回409 Conflict。
路由侧:
python
@router.post("", response_model=UserOut, status_code=201)
async def create_user(payload: UserCreate, session: AsyncSession = Depends(get_db)):
    try:
        user = await user_service.create_user(session, payload)
    except user_service.DuplicateUserError as exc:
        raise HTTPException(status_code=409, detail=str(exc))
    return UserOut.model_validate(user)
9.2 更新partial update与profile同步
python
async def update_user(session, user_id, payload: UserUpdate) -> User:
    user = await get_user_with_profile(session, user_id)
    data = payload.model_dump(exclude_unset=True)
    # 分离 profile 字段与 user 字段,分别 setattr
    ...
    await session.flush()
return user model_dump(exclude_unset=True)只包含客户端实际传入的字段,实现PATCH语义的partial update。若传入nickname而用户尚无profile,会自动创建UserProfile记录。
9.3 删除-级联
python
async def delete_user(session: AsyncSession, user_id: int) -> None:
    user = await get_user(session, user_id)
    await session.delete(user)
await session.flush() ORM级联与数据库ON DELETE CASCADE会同时删除关联profile。路由返回204 No Content,无body。
十、事务回滚演示
10.1 故意失败的事务
python
async def demo_failed_transaction(session, username, email) -> None:
    session.add(User(username=username, email=email, role="user"))
    await session.flush()
raise RuntimeError("simulated business error, transaction should rollback") flush之后数据已在当前事务内可见,但尚未commit。随后抛出RuntimeError模拟业务校验失败(如库存不足、余额不够)。
10.2 路由捕获并验证
python
@demo_router.post("/transaction-rollback")
async def transaction_rollback_demo(session: AsyncSession = Depends(get_db)):
    before = await user_service.count_users(session)
    try:
        await user_service.demo_failed_transaction(session, username, email)
    except RuntimeError as exc:
        await session.rollback()
        after = await user_service.count_users(session)
        return {
            "message": str(exc),
            "users_before": before,
            "users_after": after,
            "rolled_back": before == after,
} 路由在捕获异常后显式rollback(),再查用户数。若rolled_back: true,说明flush的INSERT未被commit,数据库行数不变。生产环境更复杂的跨表事务可用async with session.begin():包裹多个操作,任一步失败自动回滚。
总结
FastAPI数据库集成的正解是SQLAlchemy 2.0 全异步 :create_async_engine作为进程级单例,AsyncSession通过Depends(get_db)请求级注入,service层所有IO都带await,Pydantic负责HTTP出入参。demo用本地SQLite文件跑通分页、联表、CRUD与回滚,连接池参数为MySQL/PostgreSQL预留,换库时改连接串与驱动即可。
不在async路由使用同步Session、不在每次请求创建engine、不让任何阻塞IO溜进事件循环。