这是一篇为你整理的深度强化学习技术博客,内容侧重于核心原理与数学直觉,而非浅尝辄止的应用列表。
如果说监督学习是模仿已有的答案,无监督学习是发现隐藏的模式,那么强化学习(Reinforcement Learning, RL)则是关于"如何在动态环境中通过序列决策,实现长期收益最大化"的学问。
今天这篇博客,我想带你扒开代码和公式的外衣,直击强化学习的哲学根基与核心数学原理。理解了这些,你再看任何前沿论文(如PPO、SAC),都会有一种"看山还是山"的清晰感。
第一章:灵魂拷问------强化学习究竟在解决什么问题?
在正式推导公式前,请先记住强化学习最核心的三条哲学观:
- 试错是唯一的学习途径(没有上帝告诉你每一步该怎么做,只能自己踩坑)。
- 时间是最重要的维度(当下的决策会影响未来的所有可能性)。
- 奖励是唯一的外界信号(环境不讲道理,只给一个数字反馈)。
基于此,我们引入第一个核心假设:马尔可夫性(Markov Property)。
系统的下一时刻状态仅与当前状态和当前动作有关,与更早的历史无关。
这看似严苛的假设,其实是让数学可解的"救命稻草"。在强化学习中,环境被抽象为马尔可夫决策过程(MDP),用一个五元组定义:(S,A,P,R,γ)
S (状态):智能体观察到的环境快照。
A (动作):智能体拥有的操作集合。
P (状态转移概率):环境的"物理规则",P(s ∣ˊs,a) 表示在 s 下执行 a 跳到 的概率。
R (奖励函数):即时反馈 R(s,a,s )ˊ。
γ (折扣因子):这是强化学习数学魅力的关键,取值范围 0,1,用于折损未来奖励的当前价值。
第二章:数学基石------回报(Return)与贝尔曼方程
强化学习的终极目标不是最大化眼前的即时奖励 r t ,而是最大化累积折扣回报(Cumulative Discounted Return) :
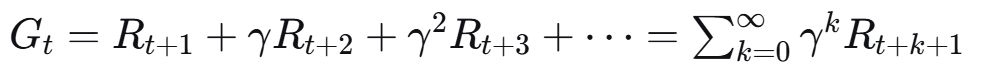
为什么一定要乘以 γ? 这背后有深刻的数学和现实考量:
数学上:如果不乘 γ(即 γ=1),在无限时间长河中,回报极易发散到无穷大,无法收敛。
现实上:经济学中"今天的一块钱比明天的一块钱更值钱"。我们更倾向于尽快获得确定性的收益,而非遥远的、不确定的"大饼"。
有了回报的定义,我们引入了强化学习最核心的灵魂方程------贝尔曼方程(Bellman Equation)。它揭示了当前状态的价值与下一状态价值之间的递推关系。
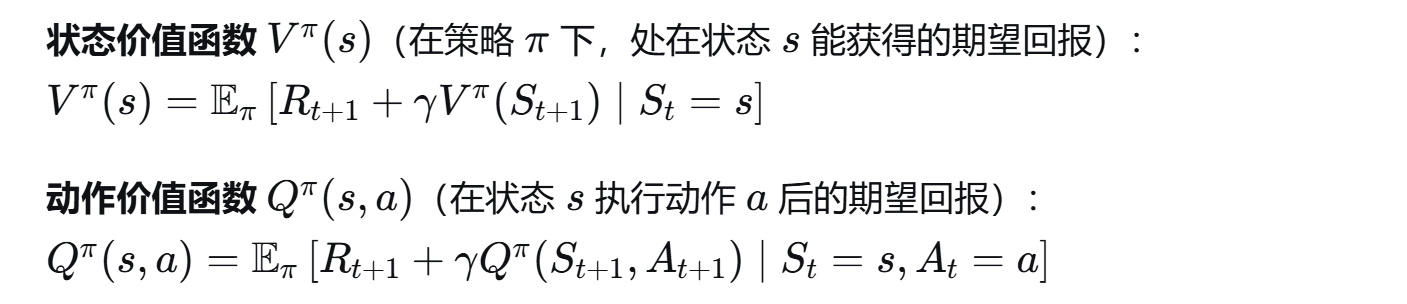
直觉解读:贝尔曼方程的本质是一种"自举(Bootstrapping)"思想------用当前的估计值去更新未来的估计值。这就像在黑暗中摸索,虽然一开始不准,但通过不断迭代,价值估计会像手电筒的光束一样,逐渐照亮整个决策路径。
第三章:两大经典求解路线------动态规划与蒙特卡洛
有了 MDP 和贝尔曼方程,我们怎么求解最优策略呢?在深度学习介入之前,计算机科学家开辟了两条截然不同的路线:
1. 动态规划(Dynamic Programming)------已知物理规则的"上帝视角"
如果状态转移概率 P 和奖励函数 R 完全已知(即环境规则是透明的),我们可以直接通过策略迭代或价值迭代来求解。
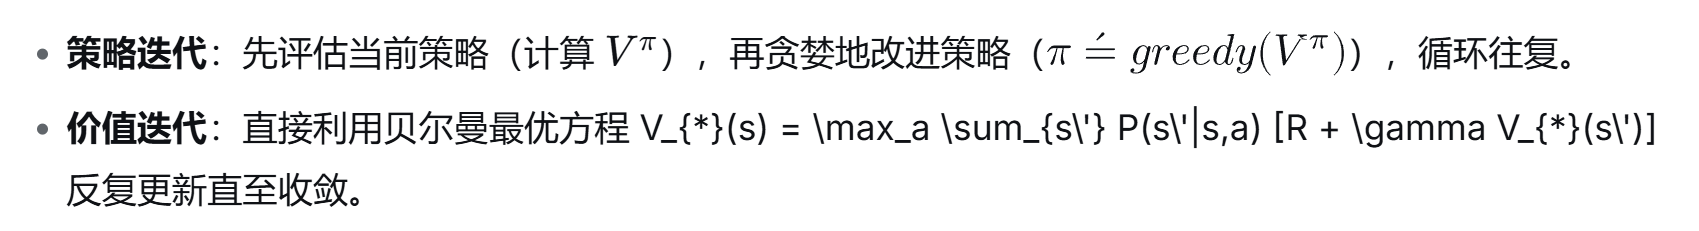
2. 蒙特卡洛(Monte Carlo)------未知规则的"实战派"
现实世界(如股市、游戏)我们根本无法获知 P 和 R。蒙特卡洛方法摒弃了数学模型,直接让智能体与环境互动完整的一整局(Episode),在游戏结束后记录下每个状态的实际回报 G t,然后用 G t 去更新 V(s)。
优缺点:不需要环境模型,但必须等到一局结束才能更新,且方差极大。
第四章:时差分学习(TD)------深度强化学习的真正核心
如果你只学一个强化学习的概念,那一定是时差分(Temporal Difference, TD)。它结合了动态规划的"自举"和蒙特卡洛的"采样",是当前所有主流算法(DQN、PPO)的底层基因。
TD 的核心更新公式(以 Q-learning 为例):
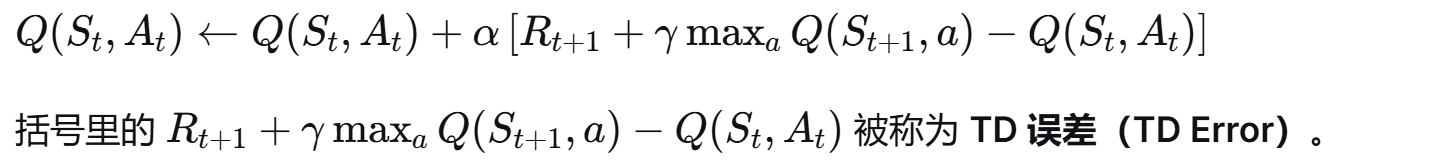
这个公式的伟大之处在于: 它不再需要等待整局游戏结束(不用等 G t),而是用下一步的即时奖励 R t+1+ 下一状态的价值估计,来修正当前状态的价值估计。它实时、高效、且极其符合人类直觉------你走在路上摔了一跤,不需要等到一天结束才知道疼,那一刻的疼痛就足以让你修正"走路"这个行为的价值认知。
第五章:策略梯度(Policy Gradient)------绕过价值陷阱
传统的价值方法(如 Q-learning)在解决连续动作空间(比如控制机械臂的力度)时会崩溃,因为无法穷举所有动作的 Q 值。
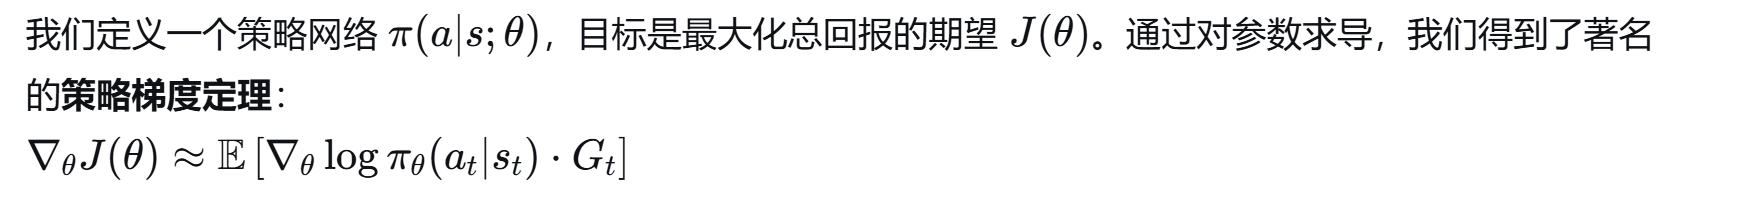
这段公式的通俗翻译是:
如果执行动作 at 后获得的回报 G t是正的,那就增加这个动作被选中的概率;如果是负的,就降低它的概率。
这就是著名的"奖励加权最大似然"。但这带来了一个新问题:如果 G t全是正数(或负数),概率总和必须归一化,导致好的动作概率反而可能下降。为此,人们引入了基线(Baseline),最著名的就是 Actor-Critic(演员-评论家) 结构。
第六章:大一统架构------Actor-Critic 与 PPO 的崛起
现在的深度强化学习,99% 的落地项目都在使用 Actor-Critic 架构。
Actor(演员):负责决策,输出动作(基于策略梯度)。
Critic(评论家):负责打分,输出状态价值 V(s)(基于 TD 方法)。
评论家不再使用原始的 G t(方差太大),而是使用 优势函数(Advantage Function):
A(s,a)=Q(s,a)−V(s)
这衡量的是"这个动作相比平均水平好多少"。正优势就鼓励,负优势就惩罚,极大稳定了训练。
在众多 AC 算法中,PPO(近端策略优化) 凭借其相对保守的更新机制(限制新旧策略的 KL 散度),成为了工业界的默认首选。它完美地解决了此前算法(如 TRPO)复杂且难用的问题,成为了大模型(ChatGPT)人类反馈强化学习(RLHF)的基础算法之一。
结语:通向通用人工智能(AGI)的必经之路
强化学习不仅仅是游戏 AI 的专属。当你理解了 MDP(状态空间抽象)、贝尔曼方程(时序递推) 和 探索-利用困境(Exploration-Exploitation Dilemma),你会发现在经济学、推荐系统、甚至神经科学中,处处都是强化学习的影子。
它之所以迷人,是因为它不教条------它不告诉你答案,只给一个目标;它不在乎你走了多少弯路,只在乎你是否走到了终点。
思考留给你的小问题:强化学习中的"探索"与"利用"本质上是矛盾的。如果一味利用当前已知的最优动作,你会错过更好的;如果一直随机探索,你会浪费累积的成果。你觉得现实商业决策中,如何平衡这两种策略?
欢迎在评论区留下你的思考,下一期我们可能会深入聊聊 SAC(柔性演员-评论家) 中的最大熵原理------一种教你如何"优雅地"探索世界的算法。