在模块化 iOS 工程里,经常会遇到一类看似简单、却很容易让依赖关系变脏的问题:每个业务模块都想"贡献"一个能力,但应用入口不应该认识每一个业务模块。
启动任务、路由、埋点、调试菜单、测试元数据都属于这一类问题。理想的调用方式是:业务模块只声明自己提供什么;框架在合适的时机自动发现全部声明并完成注册。
本文从 Objective-C 的 +load 出发,解释 Mach-O section 自动注册的原理,再记录 Swift 从 Objective-C runtime 过渡到语言级 @section / @used 的路径,最后落到 TKMacros 的实现与 CocoaPods 集成。
本文讨论的是"注册信息的发现"。注册后如何排序、去重、执行,以及业务协议如何设计,仍应由各自的注册中心负责。
1. 自动注册到底想解决什么
以启动任务为例。假设网络、日志、账号等模块都需要在不同阶段初始化,最直观的写法是在 AppDelegate 或启动器里逐一调用:
objc
[LoggerSetup register];
[NetworkSetup register];
[AccountSetup register];
这会让应用入口成为所有模块的聚合点。每增加一个模块,就要改中心文件;模块也无法真正独立交付。
小项目里这不是问题。入口文件十几行,谁需要初始化一眼就能看清。但当工程开始拆分组件,事情会逐渐变得别扭:网络模块要改自己的初始化,为什么还要去碰 App target?一个调试功能本来只属于某个业务 Pod,为什么主工程必须知道它的类型名?
更麻烦的是,这种中心化清单往往会变成冲突热点。两个同学在不同模块里加能力,却都要改同一个注册文件;模块明明已经被链接进应用,却仍然需要额外"报到"一次。
自动注册把依赖方向反过来:模块把一条"我是某种注册项"的记录交给二进制,注册中心只扫描记录,不直接 import 业务模块。
换句话说,依赖从"应用入口依赖所有业务模块"变成"业务模块依赖统一的注册协议"。注册中心只约束记录格式和处理规则,不需要在源码中直接引用每一个贡献者。
2. Objective-C:最简单的 +load
Objective-C runtime 会在 image 被装载时调用类和分类的 +load。因此最简单的自动注册是直接在其中执行代码:
objc
@implementation NetworkSetup

+ (void)load {
    [[TKLaunchRegistry shared] registerClass:self priority:100];
}

@end这种写法没有集中清单,也没有显式调用;NetworkSetup 被装进应用后会自行完成登记。对于日志 hook、路由表、埋点处理器这类只需要登记、暂时不执行实际业务工作的能力,+load 是一个低门槛的答案。
业务模块不需要通知中心,确实很方便。为了少写样板代码,通常还会把这段逻辑包进宏:
objc
#define TK_AUTO_REGISTER(priority) \
+ (void)load { \
    [[TKLaunchRegistry shared] registerClass:self priority:(priority)]; \
}

@implementation NetworkSetup
TK_AUTO_REGISTER(100)
@end
但 +load 的"自动"来自执行副作用:image 一加载,就立刻跑注册代码。它有几个天然限制:
- 时机很早,运行环境和依赖不一定已经准备好;
+load中不适合做耗时或复杂工作。 - 不应该依赖不同 image、类或分类之间的
+load顺序。 - 注册行为分散在许多加载回调中,不利于集中统计、延迟加载或统一排序。
- 如果静态库里的 Objective-C 类/分类没有被链接器带入最终产物,
+load也不会存在;这与-ObjC、-all_load等链接策略相关。
这里最常见的误解是:+load 不是一个轻量版 application:didFinishLaunchingWithOptions:。它发生得更早,早到不应该假设 UIApplication、业务单例、网络环境甚至其他模块的初始化状态已经可靠。把真正的初始化工作塞进去,短期看很省事,长期通常会变成启动问题的来源。
所以更稳妥的约定是:+load 只做极小的"登记",不做业务工作。但即使只登记,它仍把调用分散到了大量不可见的加载回调里。我们开始希望它不要马上执行,而是先把"谁想注册什么"保存下来。
C/C++ 静态初始化器:不依赖 Objective-C runtime 的加载回调
除了 +load,C/C++ 还可以在 main() 前执行初始化代码。常见写法包括:
cpp
// 全局对象的动态初始化
struct FeatureBootstrap {
    FeatureBootstrap() {
        registerFeature();
    }
};

static FeatureBootstrap bootstrap;
c
// Clang constructor attribute
__attribute__((constructor))
static void registerFeature(void) {
    register_feature();
}
需要先区分 C++ 的两类静态初始化。零初始化和常量初始化在编译期完成,只是把数据放入合适的 section;全局对象构造函数、__attribute__((constructor)) 等需要执行代码的初始化,则会以函数指针的形式放入 Mach-O 的 __DATA,__mod_init_func,由 dyld 在进入 main() 前调用。
这使它能够服务不依赖 Objective-C 的 C/C++ 基础设施,但它仍然属于"加载时执行副作用":不能延迟、会占用启动阶段、并且不适合作为复杂业务初始化入口。更重要的是,顺序规则很弱:同一翻译单元内通常遵从定义顺序;不同翻译单元之间的初始化先后不受可靠保证;跨 dylib/framework 的先后更不应被业务逻辑依赖。+load 与 C/C++ 初始化器的具体相对顺序也不应作为项目契约。
跨翻译单元的初始化顺序问题
这个问题通常被称为 Static Initialization Order Fiasco:C++ 全局对象的动态初始化 在同一个 .cpp 文件内通常按定义顺序执行,但跨 .cpp 文件时没有可靠的先后保证。只要一个全局对象的构造函数依赖另一个翻译单元中的全局对象,就可能在对方尚未构造完成时读取它:
cpp
// Logger.cpp
extern Config globalConfig;
Logger globalLogger(globalConfig);

// Config.cpp
Config globalConfig;
globalLogger 和 globalConfig 谁先构造不可依赖。如果前者先运行,Logger 接收到的就是尚未完成动态初始化的 globalConfig。析构阶段还存在对应的反向问题:对象销毁顺序与依赖关系不一致,也可能访问已销毁对象。
常见规避方式是把依赖对象改为函数内静态变量,并在首次使用时取得它:
cpp
Config& sharedConfig() {
    static Config value;
    return value;
}
现代 C++ 保证函数内 static 的初始化只发生一次且具备线程安全性。但它解决的是对象依赖顺序,不会让静态初始化器适合承担模块自动注册的业务调度;启动任务的 phase、priority 和执行时机仍应由注册中心显式控制。
从自动注册的角度看,C/C++ 初始化器与 +load 的共同问题是"发现"和"执行"绑在一起。它们适合极少量、必须在 main() 前运行的底层准备;如果只是收集可注册项,写入 section 后按需扫描通常更可控。
Objective-C runtime 类表扫描:另一条动态路线
Objective-C 还提供过一条更直接的路线:运行时枚举全部类,再筛选目标协议:
objective-c
unsigned int count = 0;
Class *classes = objc_copyClassList(&count);

for (unsigned int index = 0; index < count; index++) {
    if (class_conformsToProtocol(classes[index], @protocol(FeatureEntry))) {
        registerFeatureClass(classes[index]);
    }
}
free(classes);
这不需要每个模块显式写注册宏,但扫描范围是整个 Objective-C runtime 的类表,而不是实际参与注册的那一小部分类型。大型应用中它会遍历大量无关类;动态加载 image 后还需要重新扫描。更关键的是,纯 Swift struct、enum,或未暴露到 Objective-C runtime 的 Swift class 都不在这条发现路径上。
因此 runtime 枚举适合 Objective-C 存量工程或诊断工具,却不是纯 Swift 自动注册的长期基础。它解释了为什么早期 Swift 实现经常先经由 NSObject / @objc 过渡,最终又回到更明确的 section metadata。
于是问题从"如何执行注册"变成了"如何把注册描述留下,等需要时再统一处理"。
3. 从执行代码到写入 Mach-O section
Mach-O 是 Apple 平台使用的可执行文件格式。一个 image 包含多个 segment,每个 segment 又包含若干 section。我们可以让编译器把静态变量放进自定义 section;只要所有模块使用相同的 section 名称,这些变量就在最终 image 中形成一个连续的记录集合。
在 Mach-O 中,segment 是较大的存储分区,section 是 segment 内的具体区域。正常情况下,静态变量由编译器决定存放位置;section 属性则要求把变量写入指定区域。所有模块使用同一个 section 名称后,运行时无需枚举所有类型,只需读取该 section 中连续存放的注册记录。
下面是一个典型的 Objective-C 实现。每项记录包含类、优先级和调试名称:
objc
#import <Foundation/Foundation.h>

typedef struct {
    Class cls;
    int32_t priority;
    const char *name;
} TKRegisterEntry;

#define TK_REGISTER(cls, order) \
    __attribute__((used, section("__DATA,__tk_register"))) \
    static const TKRegisterEntry tk_register_##cls = { \
        cls, order, #cls \
    }

TK_REGISTER(NetworkSetup, 100)
TK_REGISTER(LoggerSetup, 1000)
这里有两个不可省略的属性:
section("__DATA,__tk_register"):把变量放到 Mach-O 的__DATAsegment、__tk_registersection。used:即使没有普通代码引用该静态变量,也要求编译器保留它,避免优化或 dead strip 让注册记录消失。
used 只保证这条记录在已经参与链接的目标文件 中不会被当作无用符号删除;它不能强制链接器从静态库 archive 中抽取一个从未被引用的 .o。如果注册项位于静态库且该对象文件没有其他引用,仍需通过锚点符号、-force_load,或针对 Objective-C archive 的合适链接策略保证对象文件进入最终 image。这个问题与 +load 并无本质区别:类没有进入 image,就没有任何可扫描或可调用的注册入口。
section 里不必存一个完整对象。更常见、也更稳定的做法是存固定布局的 POD 数据:类指针、C 函数指针、整数、C 字符串或这些值组成的结构体。扫描器可以根据 sizeof(TKRegisterEntry) 逐项读取。
"固定布局"是这套方案的契约。写入方说每一格是 Class + Int32 + 字符串指针,读取方就必须按同样的顺序、同样的大小读取。它不像 JSON 一样有字段名,也没有运行时校验,因此结构定义一旦变更,写入端和读取端必须一起更新。正因为它靠近 ABI 边界,才更适合封装在基础设施里,而不是散落在业务代码中。
扫描 section
在主可执行文件中,可以通过 getsectiondata 取得 section 的首地址和大小:
objc
#import <mach-o/getsect.h>
#import <mach-o/loader.h>

extern const struct mach_header_64 _mh_execute_header;

unsigned long byteCount = 0;
const TKRegisterEntry *entries = getsectiondata(
    &_mh_execute_header,
    "__DATA",
    "__tk_register",
    &byteCount
);

NSUInteger count = byteCount / sizeof(TKRegisterEntry);
for (NSUInteger index = 0; index < count; index++) {
    TKRegisterEntry entry = entries[index];
    [[TKLaunchRegistry shared] registerClass:entry.cls priority:entry.priority];
}
如果注册项可能来自动态 framework、debug dylib 或其他已加载 image,扫描器就不应只看 _mh_execute_header。可以遍历 _dyld_image_count(),对每个 _dyld_get_image_header() 调用 getsectiondata。这也是 Swift 方案仍然沿用的核心步骤。
Debug 构建下,注册项不一定在主可执行文件
这一点在 Xcode 的 Debug 构建中尤其容易被忽略。某些调试配置会将部分 Swift 代码放入与主可执行文件分离的 *.debug.dylib image。它与 app 可执行文件一起被 dyld 加载,但路径和 Mach-O header 都不同;宏生成的 section entry 会随定义它的类型落在对应 image 中。
因此,只读取 _mh_execute_header 或只按主可执行文件名查找,Release 看似正常、Debug 却可能扫描不到启动任务或调试菜单项。问题不在 macro 没有展开,而在扫描范围遗漏了实际承载 section 的 dylib。
一种面向启动任务的实现,可以在 #if DEBUG 下先根据主可执行文件名查找同名的 ".debug.dylib" image 并扫描,再扫描主可执行文件;生产环境只扫描主可执行文件。另一种更通用的实现则直接遍历 _dyld_image_count() 返回的全部已加载 image。对于需要支持任意动态 framework 或插件的注册中心,应选择后者,并按业务规则过滤和去重。
关键前提:扫描范围必须与最终的链接产物一致。 section 记录属于具体的 Mach-O image,不属于抽象的"模块"。扫描器只覆盖主程序,还是覆盖全部已加载 image,直接决定哪些注册项会被发现。
扫描范围应由项目的二进制组织方式决定,而不是由"模块化"这个词决定。以 monorepo 为例:如果子模块以源码或静态库方式参与构建,链接后其 section 记录会合并进 app 主可执行文件;Debug 构建中,部分 Swift 代码还可能位于同名的 .debug.dylib。在这种组织方式下,只扫描主可执行文件和 Debug dylib 就足够,同时也避免遍历系统 framework 等无关 image。
如果某些业务模块改为动态 framework、可下载的插件或运行时 dlopen 的 dylib,它们的 section 记录会保留在各自 image 中,主程序扫描策略就会漏项。此时应遍历全部已加载 image,或维护一个明确的 image 白名单。换言之,扫描器的范围是构建与链接策略的一部分;调整模块交付方式时,应同时检查注册项最终落在哪个 Mach-O image,而不能假设它总在主程序中。
扫描本身只是一次内存遍历:拿到 section 起始地址,拿到字节数,用"总字节数 ÷ 单条记录大小"得到数量,再顺序读取。真正的价值在于,扫描发生在注册中心选择的时刻------例如启动器正式开始调度时,或用户第一次打开调试面板时------而不再被 image 装载时机绑死。
这种方案解决了什么
section 方案的关键不是"更酷的宏",而是把模型从副作用改成数据:
text
+load:image 装载 → 立即执行注册

section:编译期生成记录 → 运行时按需扫描 → 集中注册
于是注册中心可以自行决定扫描时机,读取 metadata 后按优先级排序、过滤环境、去重或记录耗时;模块只负责贡献描述。
这也带来一个很实用的好处:可观测性回到了中心。我们可以打印"本次扫描发现 18 个启动任务",可以记录哪个任务排在最前面,也可以在 Debug 环境检查重复 identifier。+load 时代这些信息往往分散在许多加载回调里,出了问题很难拼出全貌。
4. Swift 的过渡:借 NSObject,但不止于 NSObject
纯 Swift 没有 +load。把 Swift 类型标记为 NSObject 子类或 @objc,然后由一个 Objective-C 类的 +load 回调 Swift,曾经是一个可行的过渡方案:
objc
// Objective-C bridge
@implementation TKRegistrationBootstrap
+ (void)load {
    [TKSwiftRegistry performRegistration];
}
@end
swift
@objcMembers
final class TKSwiftRegistry: NSObject {
    static func performRegistration() {
        // 通过显式列表或 Objective-C runtime 发现并注册。
    }
}
这能复用 Objective-C 的加载模型,但它并没有消除问题:它仍依赖 +load 的早期时机,要求类型可暴露给 Objective-C runtime,并且 Swift 的类型系统、泛型和模块边界并不天然适合用 Objective-C runtime 枚举。
这个阶段的关键收获不是"NSObject 不好",而是发现了一个边界:NSObject 是与 Cocoa、KVO、delegate、runtime 交互时非常自然的桥梁;但为了自动注册而强迫每个纯 Swift 类型继承 NSObject,等于让底层发现机制反过来塑造业务模型。一个调试菜单项只是一个值类型时,没有理由为了被发现而变成 Objective-C 类。
另一种看似可行的办法是遍历 Objective-C runtime 的全部类,再按协议筛选。它同样不够理想:你扫描到的是"所有可见的 Objective-C 类",而不是"明确愿意参与此注册协议的声明";更不用说纯 Swift 类型、泛型类型和跨模块可见性都会让规则变得模糊。
更重要的是,自动注册的本质并不是"枚举所有类型",而是发现一组明确声明的 metadata。Mach-O section 正好表达了这件事。
5. Swift 终于拥有 section placement
Swift 曾以实验接口提供 @_section、@_used,并需要开启:
text
-enable-experimental-feature SymbolLinkageMarkers下划线意味着它是未稳定的编译器接口:可以用于探索,但源码兼容性不应被视为承诺。
这段历史说明,这并非只服务 iOS 的技巧。系统编程、嵌入式场景、测试 metadata 与插件发现都需要可靠地向二进制写入可枚举记录。早期接口用于验证可行性,正式提案则明确了语义、适用范围和限制。
SE-0492: Section Placement Control 在 Swift 6.3 将这组能力正式化为 @section 与 @used:
swift
@section("__DATA_CONST,__tk_registry")
@used
private static let entry: @convention(c) () -> UnsafeRawPointer = {
    unsafeBitCast(MyFeature.self, to: UnsafeRawPointer.self)
}
两者的职责与 C/Objective-C 时代相同:
@section指定存储符号进入哪个 section,并要求其初始化可在编译期完成。@used告知编译器该存储即使在源代码中看起来未使用,也必须被发射并避免被 dead-strip。
正式接口仍是低层能力。它只解决"把固定布局记录放入二进制并保留",不会替应用决定记录格式、跨 image 的扫描方式或注册时机。Swift Evolution 也明确建议上层业务通过库或 macro 包装它,而不是让普通业务代码直接接触这些属性。
从使用者角度看,最好的 API 不应该是"请给我一个 section 名、一个无捕获函数指针和一段 unsafe bitcast";最好的 API 应该是"这个类型是调试菜单入口"或"这个类是启动任务"。前者是实现细节,后者才是领域语言。macro 正好可以完成这种翻译。
还有两个实践约束需要牢记:
- section 名是目标文件格式相关的。本文的
__DATA_CONST,__xxx是 Mach-O 命名;ELF、COFF 和 Wasm 的写法不同。 - 可放入 section 的 static/global 值必须满足静态初始化要求,不能依赖运行时执行的初始化逻辑。泛型上下文和复杂捕获也会让这类记录不再适合直接使用。
Mach-O 还规定了名称长度:segment_command_64 和 section_64 中的 segname、sectname 都是 char[16]。因此 @section("__DATA_CONST,__feature_entry") 中,__DATA_CONST 和 __feature_entry 要分别计算,二者都不能超过 16 字节 ;中间逗号只是 section specifier 的分隔符,不计入任一名称。建议统一使用 ASCII,并将名称控制在 16 字节以内,不要依赖字段末尾一定有 \0。例如 __feature_entries 有 17 个 ASCII 字节,不适合作为 Mach-O section 名;本文示例使用 15 字节的 __feature_entry。
6. 用 Swift Macros 封装注册声明
接下来用一个完全独立的示例说明 macro 应该承担什么职责。假设有一类可扩展的功能入口:
swift
protocol FeatureEntry {
    init()
}

@AutoRegister
struct NetworkDiagnostics: FeatureEntry {
    init() {}
}业务代码只表达两件事:NetworkDiagnostics 是一个 FeatureEntry,并且希望被自动发现。它不应该知道自定义 section 的名称,也不需要知道类型 metadata 如何转换为裸指针。
@AutoRegister 可以是一个 attached member macro。它会校验目标类型和协议一致性,并为上面的声明生成类似下面的成员:
swift
@section("__DATA_CONST,__feature_entry")
@used
private static let registrationGetter: @convention(c) () -> UnsafeRawPointer = {
    unsafeBitCast(NetworkDiagnostics.self, to: UnsafeRawPointer.self)
}
这里最值得注意的是记录形态:section 中不直接保存 NetworkDiagnostics 的实例,而是保存一个零捕获、C 调用约定的 getter。调用 getter 后可以获得类型 metadata,再由 Swift 类型系统转换回 FeatureEntry.Type。
这样设计有三个原因:
- 函数指针有固定的内存布局,适合顺序写入和读取 section。
- macro 不需要在编译期构建实例;实例创建仍可以推迟到注册中心需要它的时候。
- 扫描器能够在恢复类型后再次做协议检查,避免把错误记录直接交给业务逻辑。
这也是 macro 的价值所在。手写 section 代码当然可以工作,但只要复制几次,section 名拼错、遗漏 @used、closure 意外捕获值、记录布局与扫描器不一致等问题就会出现。macro 把这条危险路径收敛为一个可测试的生成器;业务作者只接触经过约束的声明。
扫描器:从 dyld image 到 Swift 类型
写入 section 只是前半段;真正让自动注册成立的是扫描。扫描器需要完成四件事:找到已加载的 Mach-O image、定位目标 section、按记录布局读取内容、恢复并验证 Swift 类型。
下面是与上文示例配套的简化实现:
swift
import MachO

private typealias EntryGetter = @convention(c) () -> UnsafeRawPointer

func scanFeatureEntries() -> [any FeatureEntry.Type] {
    var results: [any FeatureEntry.Type] = []

    for index in 0..<_dyld_image_count() {
        guard let rawHeader = _dyld_get_image_header(index) else { continue }
        let header = UnsafePointer<mach_header_64>(OpaquePointer(rawHeader))
        results += readEntries(from: header)
    }

    return results
}

private func readEntries(
    from header: UnsafePointer<mach_header_64>
) -> [any FeatureEntry.Type] {
    var byteCount: UInt = 0
    guard let data = getsectiondata(
        header,
        "__DATA_CONST",
        "__feature_entry",
        &byteCount
    ), byteCount > 0 else {
        return []
    }

    let stride = MemoryLayout<EntryGetter>.stride
    let count = Int(byteCount) / stride
    let base = UnsafeRawPointer(data)

    return (0..<count).compactMap { index in
        let getter = base.load(
            fromByteOffset: index * stride,
            as: EntryGetter.self
        )
        let type = unsafeBitCast(getter(), to: Any.Type.self)
        return type as? any FeatureEntry.Type
    }
}先看外层循环。_dyld_image_count() 返回当前进程已加载 image 的数量;它不只包含主可执行文件,还可能包含 framework、动态库以及 Debug 构建中的 debug dylib。每个 image 都有自己的 Mach-O header,因此都要单独调用 getsectiondata。
getsectiondata 返回的是目标 section 的首地址,同时通过 byteCount 返回 section 总字节数。如果 image 没有该 section,它返回 nil,扫描器直接跳过即可。对于包含记录的 image,byteCount / stride 就是条目数;这里的 stride 是一个 EntryGetter 的大小,因此每次偏移一个函数指针。
读取一条记录后,扫描器先把它解释为 EntryGetter,再调用 getter 得到 UnsafeRawPointer。这个指针指向 Swift 的类型 metadata,unsafeBitCast 将它还原为 Any.Type。最后使用 as? any FeatureEntry.Type 做运行时验证:只有真正符合协议的类型才会进入结果。
如果 section 中存储的不只是一个 getter,例如还需要优先级或阶段信息,做法也一样:把记录定义成稳定的 struct 或 tuple,扫描时以 MemoryLayout<RegistrationRecord>.stride 为步长读取,再把附加字段交给注册中心排序和调度。关键是写入端与读取端共享完全相同的布局定义。
7. Swift 类型、协议与 witness table
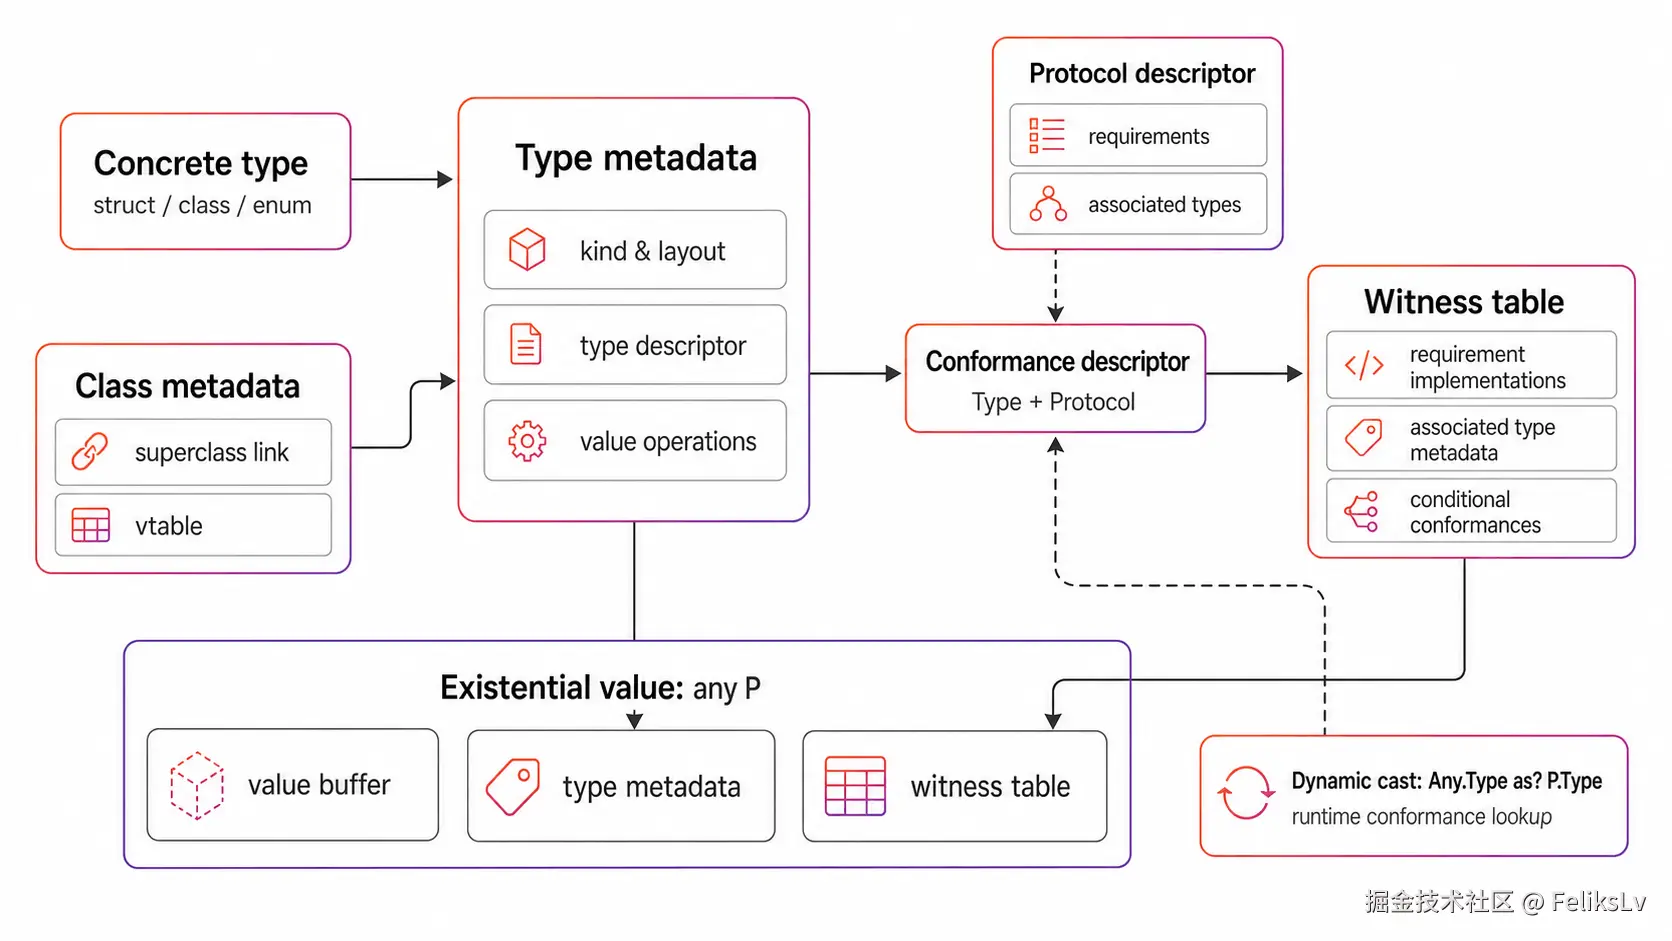
上面的代码示例最后有一行:
swift
return type as? any FeatureEntry.Type它很安全,也很直观,但不能把它误解成普通的指针转换。要理解这一步,先要区分 Swift runtime 中几个容易被混为一谈的概念。
Any.Type:类型 metadata 的入口
NetworkDiagnostics.self 是一个 metatype,也就是"类型本身的运行时表示"。把它保存为 Any.Type 时,可以把它理解为拿到了该类型 metadata 的入口。runtime 会通过 metadata 得知这个类型是 struct、class 还是 enum,如何构造、销毁和拷贝它,以及它关联的类型描述信息。
对于 class,metadata 还包含 superclass 关系等信息。因此当 runtime 判断一个类是否可视为某个基类时,主要是在类型 metadata 的继承链上做判断:
swift
class FeatureBase {}
class NetworkDiagnostics: FeatureBase {}

let type: Any.Type = NetworkDiagnostics.self
let baseType = type as? FeatureBase.Type
这里的 as? 仍然是动态转换,并非零成本;但它的核心问题是"这个 class 是否在目标基类的继承链上"。
协议遵守:类型 metadata 之外还需要一份实现表
协议的情况不同。协议允许 struct、enum、class 在不共享继承树的前提下拥有同一种能力:
swift
protocol FeatureEntry {
    init()
}

struct NetworkDiagnostics: FeatureEntry {
    init() {}
}
NetworkDiagnostics 的 metadata 只能说明"这是 NetworkDiagnostics 类型",却不足以直接回答"它如何实现 FeatureEntry 的每一项要求"。Swift 还需要一条 protocol conformance:它把 具体类型 与 具体协议 关联起来,并指向对应的 witness table。
witness table 可以理解为 runtime 使用的一张实现表。表中包含协议要求所对应的具体实现入口,以及与 associated type、继承协议或条件遵守有关的其他信息。运行时把一个值当作 any FeatureEntry 使用时,除了保存值和类型 metadata,还需要这份 table,才能按协议要求进行动态派发。
text
NetworkDiagnostics.Type metadata
              │
              ├── type descriptor / 类型信息
              │
              └── (NetworkDiagnostics, FeatureEntry) conformance
                                      │
                                      └── witness table
                                          ├── FeatureEntry.init 的实现
                                          └── 其他协议要求的实现信息
这也是协议比类继承更灵活的原因:一个类型可以遵守多个互不相关的协议,协议也可以带 associated type、继承关系和条件遵守;代价是 runtime 需要额外的 conformance 信息,而不是只看一条 superclass 链。
从 Any.Type 转成 any FeatureEntry.Type 时发生了什么
type 此时只是 Any.Type。运行时要把它转换为 any FeatureEntry.Type,需要完成两件事:确认该类型是否遵守 FeatureEntry,并取得相应的 conformance / witness table 信息。
对于跨模块、条件遵守、泛型或 resilient 类型,编译器不能在所有场景把"是否遵守某协议"简化为固定地址比较。因此 as? any FeatureEntry.Type 通常需要走 runtime conformance lookup。runtime 会利用缓存,但首次查找和缓存未命中的路径仍可能涉及类型 metadata、协议描述和 conformance 记录的查询。
这里还要区分 any FeatureEntry 与 any FeatureEntry.Type:前者是一个协议 existential value,通常需要容纳值、类型 metadata 和 witness table;后者是协议 existential metatype,关注的是"某个类型作为协议成员"的表示。它们的精确内存布局属于 Swift ABI 细节,不应该在业务代码里假设它等于单个裸指针。
因此,as? SomeProtocol.Type 和 as? SomeBaseClass.Type 不能简单视为同一种"类型转换"。前者要建立"类型 + 协议遵守"的关系,后者主要判断类继承关系。两者具体耗时与 Swift 版本、链接方式、是否首次扫描、条目数量和缓存状态相关;不要凭经验给出固定倍数,应在 Release、真机和目标数量级下分别测量冷启动与热路径。
对自动注册而言,扫描通常只执行一次,几十个条目的协议转换往往不是瓶颈。不过如果它处于首屏关键路径、条目达到数百或数千,或者注册中心会重复扫描,就应该避免让扫描器逐条做 protocol cast。
把协议检查前移到 macro,扫描时只执行 thunk
一种更适合性能敏感场景的记录设计,是让 section 记录保存"安装函数"而不是类型 getter:
swift
struct RegistrationRecord {
    let install: @convention(c) () -> Void
}

// 下面是 @AutoRegister 在 NetworkDiagnostics 内生成的示意成员。
struct NetworkDiagnostics: FeatureEntry {
    init() {}

    @section("__DATA_CONST,__feature_entry")
    @used
    private static let registration: RegistrationRecord = (
        install: {
            FeatureRegistry.register(NetworkDiagnostics.self)
        }
    )
}
这里 NetworkDiagnostics 是否符合 FeatureEntry,由 macro 的声明约束和生成代码在编译期确认;FeatureRegistry.register 的参数也可以写成泛型约束,例如 register<T: FeatureEntry>(_ type: T.Type)。扫描器只需读取 RegistrationRecord 并调用 install():
swift
for record in records {
    record.install()
}
这样,运行时扫描层不再持有 Any.Type,也不再执行 as? any FeatureEntry.Type。如果还需要把类型列出来用于日志或调试,可以在 record 中额外保存 typeGetter,但业务注册路径应优先调用 install thunk。
不要尝试把一个 Any.Type 的裸 metadata 指针直接 unsafeBitCast 成 any FeatureEntry.Type 来跳过检查。协议 existential metatype 的有效表示依赖协议遵守信息;绕开 runtime 查找不仅依赖未公开的 ABI 细节,也会把"宏生成错误或跨版本变化"变成难以定位的崩溃。若确实要把 witness table 作为记录的一部分,应将其视为 Swift runtime ABI 层的专门工作,而不是普通业务基础设施的优化手段。
如果注册对象天然都是 class,基类约束也是一个折中方案:macro 只接受 FeatureBase 子类,扫描后按基类处理。但它会限制 struct 和 enum 参与注册,是否采用取决于业务模型;不能只为了省一次 cast 而改变领域类型设计。
性能分析时建议把总耗时拆开:dyld image 枚举、getsectiondata、section 内存遍历、getter 调用、动态协议转换、实际注册逻辑分别打点。否则即使看到"扫描慢",也无法判断问题是协议 conformance lookup、某个注册项初始化,还是 Debug dylib 带来了更多 image。
8. 从通用机制到可复用组件
到这里,自动注册的核心链路已经完整:macro 生成固定布局记录,编译器把记录放入 section,运行时扫描器读取记录并交给注册中心。示例里把这些代码放在同一个工程中,足以说明原理;但在模块化项目中,还要解决一个工程化问题:业务模块如何稳定地使用同一套 macro,而不重复维护 section 名、记录布局、扫描约定和编译器参数?
一个可复用的自动注册组件至少要同时提供三层能力:
- 业务侧声明:对使用方可见的 macro 定义和必要的公开类型。
- 编译期实现:负责验证声明并生成成员的 macro plugin。
- 运行时约定:section 名称、记录布局、扫描器和注册中心之间共享的协议。
前两层决定"代码能否正确展开",第三层决定"展开后的记录能否被正确发现"。如果这些约定散落在多个业务 Pod 中,任何一次记录布局或编译参数调整都会变成跨模块修改;因此更适合收敛为独立基础组件。
TKMacros 的位置
TKMacros 是本文机制的一种工程化实现:它把 Swift Macros 的声明与实现集中维护,让业务模块只表达"这个类型需要注册";具体使用哪个 section、如何生成 getter、如何保留未引用记录,则由组件统一处理。
它支持两类常见记录:一类只需要让运行时发现类型,另一类除了类型外还需要携带阶段、优先级等调度 metadata。它们共享 section 扫描的基本思路,但记录布局和后续注册行为不同。项目代码中的具体宏名、section 名和业务协议属于实现细节;本文一直使用独立示例,是为了把注意力放在通用机制上。
CocoaPods:宏插件也要被正确带到编译现场
Swift Macros 不只有供业务代码 import 的声明模块,还需要编译器加载实现宏的插件 executable。SwiftPM 会处理这层关系;CocoaPods 则需要显式分发和配置。
TKMacros 的 CocoaPods 方案包含三部分:
Sources/TKMacros/**/*.swift作为 Pod 源码提供 macro 声明和公开类型。Prebuilt/TKMacrosExecutable作为保留文件随 Pod 安装,用于承载宏实现。- podspec 通过如下 flag 让 Swift 编译器加载插件:
text
-load-plugin-executable ${PODS_ROOT}/TKMacros/Prebuilt/TKMacrosExecutable#TKMacrosExecutable这里容易踩一个坑:链接到 TKMacros,不等于 Swift 编译器已经能执行其中的 macro。宏声明中的 #externalMacro 只是告诉编译器"实现在哪个模块、哪个类型";真正展开源码时,编译器还必须启动对应的 plugin executable。SwiftPM 将 package 内的这层关系自动管理,而 CocoaPods 并不知道 Swift Macros 的分发规则,所以需要显式携带预构建 executable 和加载参数。
间接依赖 TKMacros 的 Pod target 同样需要展开宏。为此,Scripts/tk_swift_flags.rb 在 Podfile 的 post_install 中遍历 Pods project(也兼容 generate_multiple_pod_projects),递归识别依赖链后为需要的 target 注入 flags。旧实验工具链还会注入 -enable-experimental-feature SymbolLinkageMarkers;采用正式属性时,应以实际 Swift/Xcode 工具链支持情况为准。
这段脚本的存在并不是为了让使用方多记一条命令,而是为了处理 CocoaPods 的真实构建拓扑:一个业务 Pod 可能没有直接声明 TKMacros,却通过另外两层依赖使用了带宏的源码。如果只给 app target 加 flag,Pod 自己在编译时仍会无法展开属性。脚本把"谁需要 macro plugin"这件事也做成了依赖图上的自动发现。
ruby
require_relative 'Pods/TKMacros/Scripts/tk_swift_flags'

post_install do |installer|
  inject_tk_swift_flags_if_needed(installer)
end