文章目录
- Ceph对象存储与文件系统存储管理:从RADOS网关、S3与Swift到CephFS快照同步
-
- 前言
- [一、对象存储与 RADOS 网关(RGW)概述](#一、对象存储与 RADOS 网关(RGW)概述)
-
- [1.1 对象存储的三个组成部分](#1.1 对象存储的三个组成部分)
- [z1.2 桶:扁平的命名空间](#z1.2 桶:扁平的命名空间)
- [1.3 对象存储的四个特征](#1.3 对象存储的四个特征)
- [1.4 RADOS 网关:对象存储的入口](#1.4 RADOS 网关:对象存储的入口)
- [1.5 RGW 依赖的七个池](#1.5 RGW 依赖的七个池)
- 二、域、区域组、区域与期间:多站点对象存储的坐标系
-
- [2.1 四层概念](#2.1 四层概念)
- [2.2 数据复制边界与配置更新规则](#2.2 数据复制边界与配置更新规则)
- [2.3 RGW 的适用场景](#2.3 RGW 的适用场景)
- [三、RADOS 网关的部署、扩缩容与删除](#三、RADOS 网关的部署、扩缩容与删除)
-
- [3.1 部署流程与编排器](#3.1 部署流程与编排器)
- [3.2 命令行部署:从 realm 到 rgw](#3.2 命令行部署:从 realm 到 rgw)
- [3.3 用服务规格文件部署](#3.3 用服务规格文件部署)
- [3.4 验证对象存储是否可以访问](#3.4 验证对象存储是否可以访问)
- [3.5 扩缩容与配置备份](#3.5 扩缩容与配置备份)
- [3.6 删除 RADOS 网关与删除域](#3.6 删除 RADOS 网关与删除域)
- 四、网关用户、密钥与访问控制
-
- [4.1 创建网关用户](#4.1 创建网关用户)
- [4.2 重新生成与增删密钥](#4.2 重新生成与增删密钥)
- [4.3 临时禁用与启用用户](#4.3 临时禁用与启用用户)
- [4.4 修改用户与访问控制级别](#4.4 修改用户与访问控制级别)
- [4.5 删除用户](#4.5 删除用户)
- [五、用 Amazon S3 API 访问对象存储](#五、用 Amazon S3 API 访问对象存储)
-
- [5.1 为什么用 S3 API](#5.1 为什么用 S3 API)
- [5.2 必须先知道的大小限制](#5.2 必须先知道的大小限制)
- [5.3 安装与配置 aws cli](#5.3 安装与配置 aws cli)
- [5.4 桶操作](#5.4 桶操作)
- [5.5 对象上传、查看与下载](#5.5 对象上传、查看与下载)
- [5.6 用浏览器直接下载:ACL 的直观效果](#5.6 用浏览器直接下载:ACL 的直观效果)
- [5.7 删除对象与删除桶](#5.7 删除对象与删除桶)
- [六、对象存储配额:user / bucket / global 三级](#六、对象存储配额:user / bucket / global 三级)
-
- [6.1 三级作用域](#6.1 三级作用域)
- [6.2 user 级别配额](#6.2 user 级别配额)
- [6.3 bucket 级别配额](#6.3 bucket 级别配额)
- [6.4 global 级别配额](#6.4 global 级别配额)
- [6.5 配额排障与最佳实践](#6.5 配额排障与最佳实践)
- [七、用 OpenStack Swift API 访问对象存储](#七、用 OpenStack Swift API 访问对象存储)
-
- [7.1 两套用户模型的差异](#7.1 两套用户模型的差异)
- [7.2 创建子用户](#7.2 创建子用户)
- [7.3 创建子用户密钥](#7.3 创建子用户密钥)
- [7.4 修改与删除子用户](#7.4 修改与删除子用户)
- [7.5 完整准备一套 Swift 凭据](#7.5 完整准备一套 Swift 凭据)
- [7.6 安装与配置 swift 客户端](#7.6 安装与配置 swift 客户端)
- [7.7 swift 的子命令与关键选项](#7.7 swift 的子命令与关键选项)
- [八、Swift 客户端实战:容器、对象与配额验证](#八、Swift 客户端实战:容器、对象与配额验证)
-
- [8.1 查看存储状态与认证信息](#8.1 查看存储状态与认证信息)
- [8.2 创建容器(桶)](#8.2 创建容器(桶))
- [8.3 上传、查看与下载](#8.3 上传、查看与下载)
- [8.4 删除对象与容器](#8.4 删除对象与容器)
- [8.5 用 Swift 验证配额限制](#8.5 用 Swift 验证配额限制)
- 九、多站点对象存储与区域故障转移
-
- [9.1 三种多站点架构](#9.1 三种多站点架构)
- [9.2 元数据与数据的同步流程](#9.2 元数据与数据的同步流程)
- [9.3 配置主集群](#9.3 配置主集群)
- [9.4 配置备集群](#9.4 配置备集群)
- [9.5 验证同步状态](#9.5 验证同步状态)
- [9.6 区域故障转移](#9.6 区域故障转移)
- [9.7 radosgw-admin 子命令速查](#9.7 radosgw-admin 子命令速查)
- [十、CephFS 与元数据服务器(MDS)](#十、CephFS 与元数据服务器(MDS))
-
- [10.1 CephFS 是什么](#10.1 CephFS 是什么)
- [10.2 三种存储方式对比](#10.2 三种存储方式对比)
- [10.3 元数据服务器(MDS)](#10.3 元数据服务器(MDS))
- [10.4 MDS 的关键配置选项](#10.4 MDS 的关键配置选项)
- [10.5 客户端访问 CephFS 的过程](#10.5 客户端访问 CephFS 的过程)
- [十一、CephFS 的部署、挂载与访问控制](#十一、CephFS 的部署、挂载与访问控制)
-
- [11.1 两种部署方式](#11.1 两种部署方式)
- [11.2 手动部署 CephFS](#11.2 手动部署 CephFS)
- [11.3 验证部署状态](#11.3 验证部署状态)
- [11.4 删除 CephFS](#11.4 删除 CephFS)
- [11.5 卷部署(更省事的方式)](#11.5 卷部署(更省事的方式))
- [11.6 两种挂载方式:Kernel 与 FUSE](#11.6 两种挂载方式:Kernel 与 FUSE)
- [11.7 授权挂载用户:ceph fs authorize](#11.7 授权挂载用户:ceph fs authorize)
- [11.8 客户端挂载准备](#11.8 客户端挂载准备)
- [11.9 用 Kernel 客户端挂载](#11.9 用 Kernel 客户端挂载)
- [11.10 挂载特定子目录与永久挂载](#11.10 挂载特定子目录与永久挂载)
- [11.11 用 FUSE 客户端挂载](#11.11 用 FUSE 客户端挂载)
- [十二、CephFS 快照与跨集群镜像同步](#十二、CephFS 快照与跨集群镜像同步)
-
- [12.1 快照藏在 `.snap` 里](#12.1 快照藏在
.snap里) - [12.2 创建快照:在 `.snap` 下建一个目录](#12.2 创建快照:在
.snap下建一个目录) - [12.3 从快照恢复文件与删除快照](#12.3 从快照恢复文件与删除快照)
- [12.4 CephFS Mirror:文件系统级跨集群复制](#12.4 CephFS Mirror:文件系统级跨集群复制)
- [12.5 同步原理](#12.5 同步原理)
- [12.6 配置 CephFS Mirror 的九个步骤](#12.6 配置 CephFS Mirror 的九个步骤)
- [12.7 挂载验证同步结果](#12.7 挂载验证同步结果)
- [12.1 快照藏在 `.snap` 里](#12.1 快照藏在
- 十三、验证测试、排障指南与最佳实践
-
- [13.1 环境与前置条件](#13.1 环境与前置条件)
- [13.2 验证测试](#13.2 验证测试)
- [13.3 排障指南](#13.3 排障指南)
- [13.4 最佳实践](#13.4 最佳实践)
- 写在最后
Ceph对象存储与文件系统存储管理:从RADOS网关、S3与Swift到CephFS快照同步
块存储给虚拟机用,对象存储给海量数据用,文件存储给需要目录树的业务用------Ceph 用同一套 RADOS 后端把三种接口都供上了。
前言
前面两篇我们打通了 Ceph 的配置与池管理 (第 3、4 章)和认证授权与块存储 (第 5、6 章)。到这一步,集群已经能安全地给虚拟机提供块设备了。但真实业务的需求远不止"给我一块盘":图片、视频、日志、备份这类海量非结构化数据 ,用块设备存是折磨;需要共享目录树的应用 (比如 Web 集群的静态资源、HPC 的共享工作区),块设备也解决不了。这两类需求分别对应 Ceph 的对象存储(RADOS 网关)和文件系统存储(CephFS)。
这两块在生产里踩的坑非常典型:网关刚部署完,curl 能通但 S3 客户端报签名错误 ------因为网关用户和 cephx 用户是两套完全独立的身份体系;多站点配好了却不复制数据 ------因为元数据更新必须在主区域组的主区域进行,你在次要区域建用户,配置压根没生效;某天存储桶突然写不进去 ------其实是桶配额或用户配额被打满了,而配额生效还需要 period update --commit;CephFS 挂载上去看不到快照 ------因为 .snap 是个隐藏目录,得换个姿势访问。
本文是系列的收官篇,覆盖第 7、8 章。先讲清 对象存储与 RADOS 网关(RGW) :对象存储的三要素与桶的扁平结构、RGW 作为 S3/Swift 双接口守护进程的定位、它依赖的七个 .rgw.* 池;再深入 域 / 区域组 / 区域 / 期间 这套多站点坐标系;接着完成 RGW 的部署、扩缩容、配置备份与删除 ,以及网关用户与子用户、密钥、配额 的完整管理;然后分别用 Amazon S3 API(aws cli) 和 OpenStack Swift API(swift 客户端) 把对象存进去取出来;最后进入 CephFS 与元数据服务器(MDS) ------部署、两种客户端挂载、子目录挂载、快照恢复,以及 CephFS 跨集群快照镜像同步 。读完你应该能回答:同一个集群,什么时候该给业务对象存储、什么时候该给 CephFS;以及这两套东西的生产配置该怎么收口。
一、对象存储与 RADOS 网关(RGW)概述
1.1 对象存储的三个组成部分
对象存储是一个基于对象的存储服务,提供海量、安全、高可靠、低成本的数据存储能力。 它把数据存储为离散项 ,每一项也是一个对象 。每个对象都具有唯一的对象 ID (也称对象密钥),用户可在不了解对象位置的情况下,通过对象 ID 进行存储或检索 ------这正是对象存储与块设备、文件系统的根本区别:你永远不需要知道数据在哪块盘上。
对象存储中的对象实际是一个文件数据与其相关属性信息的集合体,包括三个部分:
| 组成部分 | 含义 |
|---|---|
| Key(键值) | 对象的名称,为经过 UTF-8 编码 、长度大于 0 且不超过 1024 的字符序列。一个桶里的每个对象必须拥有唯一的对象键值 |
| Metadata(元数据) | 对象的描述信息,包括系统元数据和用户元数据 ,以**键值对(Key-Value)**的形式上传。元数据由对象存储产生,处理对象数据时使用,包括 Date、Content-length、Last-modify、ETag 等 |
| Data(数据) | 文件的数据内容本身 |
z1.2 桶:扁平的命名空间
对象存储在扁平的命名空间 中,称为桶(bucket),是对象存储存放对象的容器。
桶中的所有对象都处于同一逻辑层级,去除了文件系统中的多层级树形目录结构。 每个桶都有自己的存储类别、访问权限、所属区域等属性;用户可以在不同区域创建不同存储类别和访问权限的桶,并配置更多高级属性来满足不同场景的存储诉求。
💡 提示 :桶里"没有目录"这一点,是对象存储与文件存储最大的认知差异。很多人第一次用 S3 时会问"怎么建文件夹"------答案是没有文件夹 ,
photos/2025/a.jpg这种看着像路径的东西,只是对象键的一部分,对象依然平铺在桶里。理解这点,后面配额按"对象数量"统计、列举按前缀过滤就都顺了。
1.3 对象存储的四个特征
| 特征 | 说明 |
|---|---|
| 接入灵活 | 支持多种形态客户端,如对象存储接口、RESTful 接口、SDK 等 |
| 访问协议简单 | 使用 HTTP 或 HTTPS 协议访问 |
| 访问网络不受限 | 通过互联网或局域网都可访问 |
| 结构扁平化 | 对象直接存放在桶中,无目录结构 |
1.4 RADOS 网关:对象存储的入口
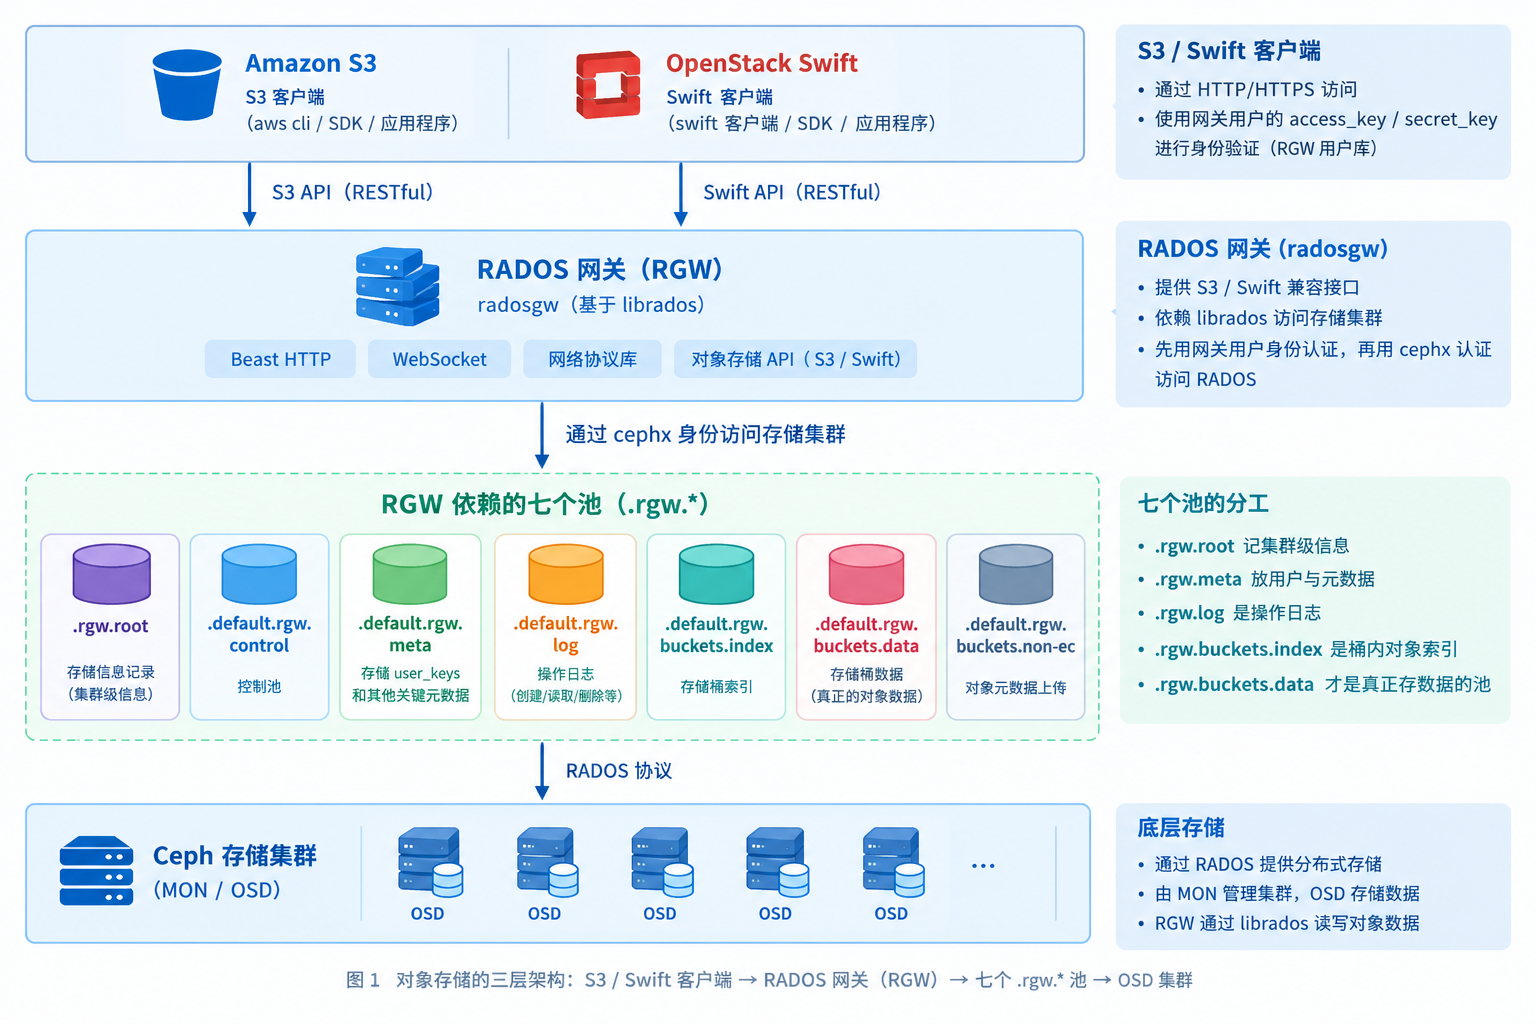
Ceph 对象网关是一个构建在 librados 之上的对象存储接口,Ceph 对象存储支持两个接口:
- 兼容 S3 :通过与 Amazon S3 RESTful API 的大部分子集兼容的接口提供对象存储功能;
- 兼容 Swift :提供对象存储功能,其接口与 OpenStack Swift API 的大部分子集兼容。
RADOS GateWay(也称对象网关,RGW)为客户端提供标准对象存储 API 来访问 Ceph 集群。 两种 API 对"扁平命名空间"的叫法不同:Amazon S3 称为存储桶(bucket),OpenStack Swift 称为容器(container)。
守护进程 radosgw 在 librados 库的基础上构建 ,提供基于 Beast HTTP、WebSocket 和网络协议库 的 Web 服务接口,作为处理 API 请求的前端;它本身也是Ceph 存储的客户端,用于访问对象存储中的对象。
这里有一条极强的边界规则,也是最容易搞混的地方:
⚠️ 重要 :RADOS 网关中用户只能访问网关,不能像 cephx 用户一样直接访问存储集群。 提交 Amazon S3 或 OpenStack Swift API 请求时,RADOS 网关客户端会使用这些网关用户帐户进行身份验证 ;网关用户通过 RADOS 网关完成身份验证后,网关会使用 cephx 凭据向存储集群进行身份验证,以处理对象请求。
也就是说链路是两段认证:
text
S3 / Swift 客户端
   │  ① 网关用户身份(access_key / secret_key,存在 RGW 自己的用户库)
   ▼
RADOS 网关(radosgw)
   │  ② cephx 身份(client.rgw.<hostname>,访问 RADOS 集群)
   ▼
Ceph 存储集群(MON / OSD)
💡 提示 :网关用户和 cephx 用户是两套完全独立的身份体系。 在 S3 客户端上报
SignatureDoesNotMatch,就别去翻ceph auth list了------该查的是radosgw-admin user info。另外,也可以通过集成基于 LDAP 的外部身份验证服务来管理网关用户。
1.5 RGW 依赖的七个池
RADOS 网关会为默认区域创建多个池:
| 池名 | 用途 |
|---|---|
.rgw.root |
存储信息记录 |
.default.rgw.control |
控制池 |
.default.rgw.meta |
存储 user_keys 和其他关键元数据 |
.default.rgw.log |
包含所有存储桶/容器和对象操作 (创建、读取、删除)的日志 |
.default.rgw.buckets.index |
存储存储桶的索引 |
.default.rgw.buckets.data |
存储存储桶数据 |
.default.rgw.buckets.non-ec |
用于对象元数据上传 |
用户也可以手动创建这些池。建议这些池名称以区域名称为前缀 ------例如区域名称是 us-east-1,则池名称可以是 .us-east-1.rgw.buckets.data。
💡 提示 :这七个池的分工值得记住一句话------
.rgw.root记集群级信息、.rgw.meta放用户与元数据、.rgw.log是操作日志、.rgw.buckets.index是桶内对象索引、.rgw.buckets.data才是真正存数据的那个 。排障时必须分清:桶里对象"看不见"通常是 index 或 meta 的问题,而"存不下"才是 data 池的问题。
二、域、区域组、区域与期间:多站点对象存储的坐标系
2.1 四层概念
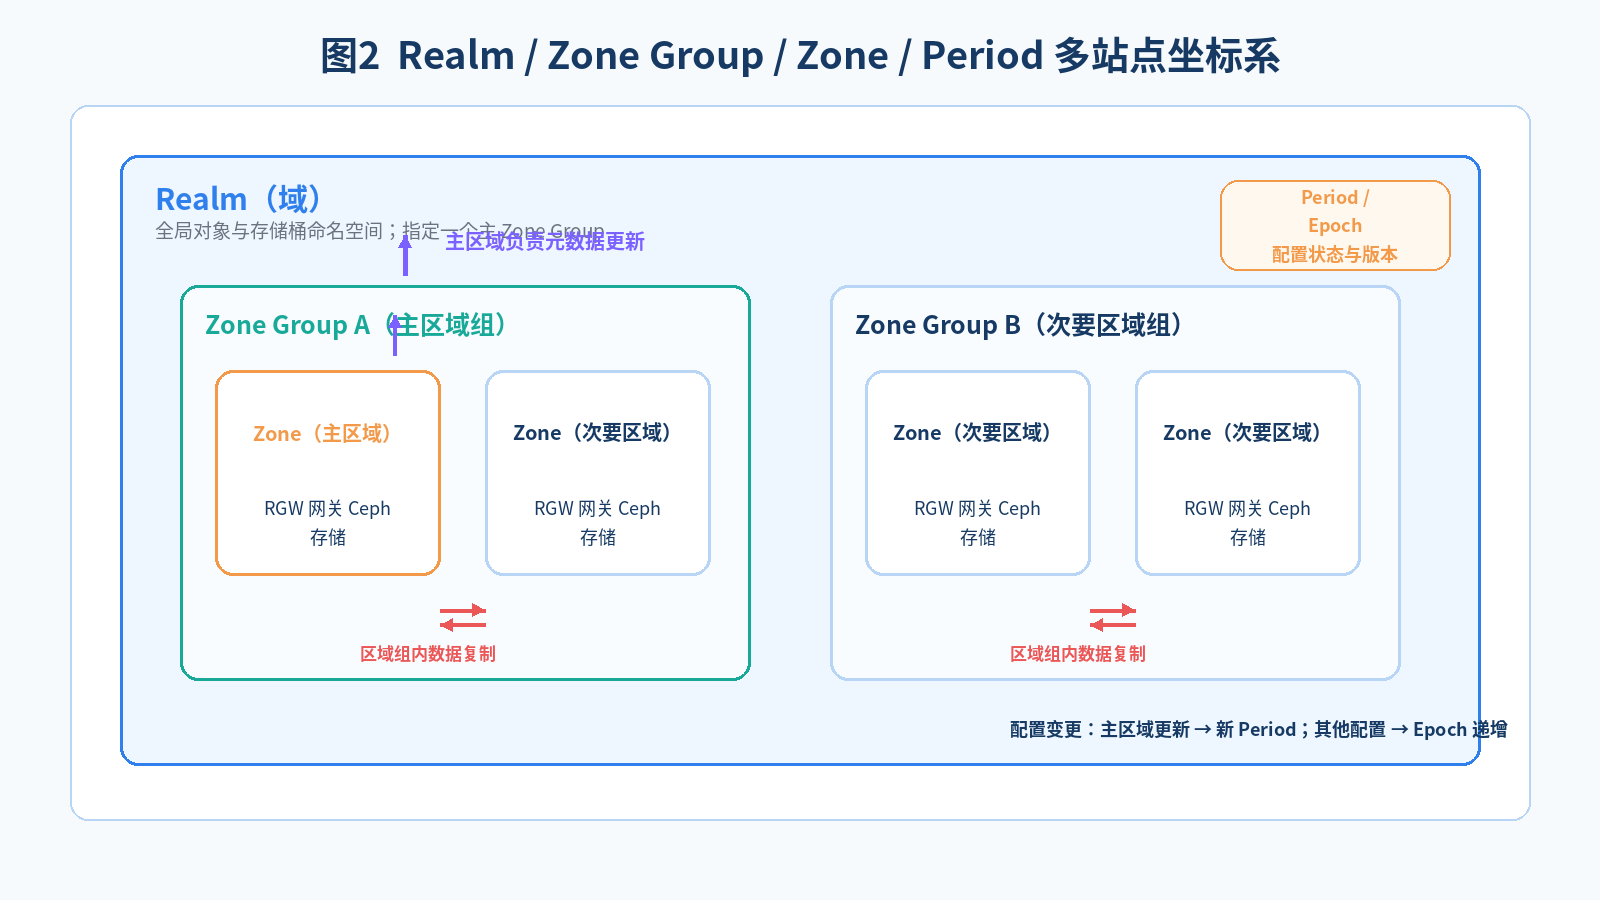
Ceph RADOS 网关支持多站点部署 :在多个 Ceph 存储集群之间自动复制对象数据 。常见的用例是在地理上分隔的集群之间进行主动/主动复制,以便于灾难恢复。要理解这套机制,必须先理清四个层层嵌套的概念:
| 层级 | 概念 | 说明 |
|---|---|---|
| 域 | realm | 代表所有对象和存储桶的全局命名空间 。域中含有一个或多个区域组,各自包含一个或多个区域。域中会指定一个区域组为主区域组,其他都是次要区域组 |
| 区域组 | zone group | 由一个或多个区域的集合 。存储在区域组中某个区域中的数据会被复制到该区域组中的所有其他区域 。每个区域组中会有一个区域为主区域 ,其他区域为次要区域 |
| 区域 | zone | 每个区域会关联一个或多个 RADOS 网关,这些网关关联 Ceph 存储 |
| 期间 | period | 用于跟踪特定时间域、区域组和区域的配置状态 。每个期间有一个唯一 ID ,包含域配置,并且知道前一个期间的 ID |
| 时期 | epoch | 用于跟踪特定域期间的配置版本号 |
⚠️ 重要 :域(realm)中的所有 RADOS 网关都从位于主区域组中主区域的 RADOS 网关拉取配置。因为主区域组中的主区域负责处理所有元数据更新,所以创建用户等操作都必须在主区域进行。 这条规则解释了多站点环境里最常见的"为什么改了不生效"------你跑到次要区域上建了个用户,元数据更新根本没被主区域受理。
2.2 数据复制边界与配置更新规则
复制的边界是区域组 :存储在某个区域中的数据会被复制到同一个区域组内的所有其他区域 。跨区域组的复制不在这个层级上发生------这也正是"主动/主动"多站点容灾通常把各地站点放在同一区域组里的原因。
配置更新的两条规则(很值得单独记):
- 更新主区域的配置时,RADOS 网关服务使用当前时间更新"期间" 。这个新期间会变成域的当前期间 ,该期间的时期值会增加一;
- 至于其他配置更改,只有时期会递增,期间不会变化。
💡 提示 :把"期间"理解成一次带时间戳的配置快照 、"时期"理解成版本号 就通了------动主区域配置 → 开一个新期间(时期 +1);只改局部配置 → 期间不动,只把时期 +1 。这也是为什么 RGW 的配置变更后面几乎总要跟一条
radosgw-admin period update --commit------新配置要"提交"成一个新期间才算数。
2.3 RGW 的适用场景
Ceph 对象存储因其高扩展性、高可靠性和灵活性,适用于多种场景,包括大规模数据存储、云服务、备份归档、大数据分析、多媒体存储、容器存储、灾难恢复、混合云、科学计算和物联网数据存储:
| 场景 | 具体用途 | 为什么选 Ceph 对象存储 |
|---|---|---|
| 1. 大规模数据存储 | 存储海量非结构化数据,如视频、图片、日志 | 能轻松扩展到 PB 甚至 EB 级别 |
| 2. 云存储服务 | 公有云或私有云中的对象存储服务 | 兼容 S3 和 Swift API,便于与现有云平台集成,提供高可用性和持久性 |
| 3. 备份和归档 | 长期数据备份和归档 | 高可靠性与低成本 存储,支持数据压缩和加密,适合长期保存 |
| 4. 大数据分析 | 存储大数据分析中的原始数据或中间结果 | 高吞吐量和低延迟特性适合读写需求 |
| 5. 多媒体内容存储与分发 | 存储和分发视频、音频等内容 | 高并发读写能力,适合内容分发网络(CDN)的需求 |
| 6. 容器存储 | 为 Kubernetes 等容器平台提供持久化存储 | 支持 RBD 和 CephFS,适合容器环境的动态存储需求 |
| 7. 灾难恢复 | 跨地域的数据复制和灾难恢复 | 支持多站点复制,确保灾难发生时的高可用性 |
| 8. 混合云存储 | 混合云环境中统一管理数据 | 可在私有云和公有云之间无缝迁移数据,提供一致的存储体验 |
| 9. 科学计算与高性能计算(HPC) | 存储科学计算和 HPC 中的大量数据 | 高吞吐量和并行访问能力 |
| 10. 物联网(IoT)数据存储 | 存储物联网设备生成的海量数据 | 高扩展性和高可靠性 |
三、RADOS 网关的部署、扩缩容与删除
3.1 部署流程与编排器
Ceph 使用 Ceph 编排器 来部署(或删除)RADOS 网关服务,用于管理单个集群或多个集群。使用集中式配置数据库中的 client.rgw.* 部分来定义新 RADOS 网关守护进程的参数和特征。
对象存储网关的部署流程就两步:
- 创建对象存储域;
- 创建对象网关。
3.2 命令行部署:从 realm 到 rgw
bash
# 创建 realm(域)
[root@ceph1 ~] radosgw-admin realm create --rgw-realm=webapp --default
[root@ceph1 ~] radosgw-admin realm list
{
    "default_info": "527e3bea-d51d-462e-92d7-79aaf422a89c",
    "realms": [
        "webapp"
    ]
}

# 创建 master zone group(主区域组)
[root@ceph1 ~] radosgw-admin zonegroup create --rgw-realm=webapp --rgw-zonegroup=video --master --default
[root@ceph1 ~] radosgw-admin zonegroup list
{
    "default_info": "0fdaf584-33ee-4be7-978c-fb2771181aee",
    "zonegroups": [
        "video"
    ]
}

# 创建 zone,并将其设置为 master
[root@ceph1 ~] radosgw-admin zone create --rgw-realm=webapp --rgw-zonegroup=video --rgw-zone=storage1 --master --default
[root@ceph1 ~] radosgw-admin zone list
{
    "default_info": "76366a48-2ab8-4830-9cf7-f9b2fe432c5a",
    "zones": [
        "storage1"
    ]
}

# 提交配置 ------ 这一步不能忘
[root@ceph1 ~] radosgw-admin period update --rgw-realm=webapp --commit

# 查看配置
[root@ceph1 ~] radosgw-admin zone get --rgw-zone=storage1
创建 RGW 服务实例 (与刚创建的 realm webapp 关联,数量为 3):
bash
[root@ceph1 ~] ceph orch apply rgw webapp --placement="3 ceph1.laogao.cloud ceph2.laogao.cloud ceph3.laogao.cloud" --realm=webapp --zone=storage1 --port=8080

# 查看服务
[root@ceph1 ~] ceph orch ls rgw
NAME        PORTS   RUNNING  REFRESHED  AGE  PLACEMENT
rgw.webapp  ?:8080      3/3  40s ago    45s  ceph1.laogao.cloud;ceph2.laogao.cloud;ceph3.laogao.cloud;count:3

# 查看进程
[root@ceph1 ~] ceph orch ps --daemon-type rgw| awk '{print $1,$4}'
NAME STATUS
rgw.webapp.ceph1.luxaau running
rgw.webapp.ceph2.hrdzlb running
rgw.webapp.ceph3.pyfond running
💡 提示 :
radosgw-admin realm/zonegroup/zone create之后必须执行period update --commit,否则这套域配置只停留在"暂存期间(staging period)"里,ceph orch apply rgw会在引用一个还不存在的 zone 时失败。
3.3 用服务规格文件部署
讲义给的 YAML 示例中,Ceph 编排器会把 rgw.webapp 服务和 3 个守护进程 部署到单个集群,并通过端口 8080 提供服务:
yaml
service_type: rgw
service_id: webapp
service_name: rgw.webapp
placement:
  count: 3
  hosts:
    - ceph1.laogao.cloud
    - ceph2.laogao.cloud
    - ceph3.laogao.cloud
spec:
  rgw_frontend_port: 8080
bash
[root@ceph1 ~] ceph orch apply -i rgw_service.yaml
Scheduled rgw.webapp update...
服务规格文件里的 count 有个必须记住的规则:
⚠️ 重要 :
count参数用于设定创建的 RGW 实例数量。如果在一个主机上创建多个实例,Ceph 编排器会将第一个实例的端口设置为指定的rgw_frontend_port或port值,对于每个后续实例,端口值加 1。 例如 ceph1.laogao.cloud 上运行两个 RGW 实例,一个使用 8080,另一个使用 8081。
同时:每个实例都启用自己的唯一端口进行访问,并对请求创建相同的响应。通过部署提供单一服务 IP 地址和端口的负载平衡器服务,为 RADOS 网关配置高可用性。
⚠️ 重要 :有些参数(如 RGW 实例使用的网络或 SSL 证书内容)只能使用服务规格文件来定义。 而且在服务规范文件中,域、区域和端口的参数名称与 CLI 使用的参数名称不同------照抄 CLI 的参数名写 YAML 是配不通的。
3.4 验证对象存储是否可以访问
bash
[root@ceph1 ~] curl http://ceph1.laogao.cloud:8080
<?xml version="1.0" encoding="UTF-8"?><ListAllMyBucketsResult xmlns="http://s3.amazonaws.com/doc/2006-03-01/"><Owner><ID>anonymous</ID><DisplayName></DisplayName></Owner><Buckets></Buckets></ListAllMyBucketsResult>

[root@ceph1 ~] curl http://ceph2.laogao.cloud:8080
(同上 XML 结构)

[root@ceph1 ~] curl http://ceph3.laogao.cloud:8080
(同上 XML 结构)
返回 ListAllMyBucketsResult 这个 XML 结构就是网关已就绪的标志------它虽然报的是"匿名用户没有任何桶",但恰好说明网关接受了请求并完成了 S3 协议握手。
3.5 扩缩容与配置备份
改实例数量 ------注意操作方式就是改 YAML 再重新 apply:
bash
# 改为 2 个实例
[root@ceph1 ~] vim rgw_service.yaml        # placement.count: 2,hosts 只留前两台
[root@ceph1 ~] ceph orch apply -i rgw_service.yaml

# 改回 3 个实例
[root@ceph1 ~] vim rgw_service.yaml        # placement.count: 3,hosts 三台都留
[root@ceph1 ~] ceph orch apply -i rgw_service.yaml导出当前配置作为备份(含运行状态与事件):
bash
[root@ceph1 ~] ceph orch ls rgw --format yaml
service_type: rgw
service_id: webapp
service_name: rgw.webapp
placement:
  count: 3
  hosts:
    - ceph1.laogao.cloud
    - ceph2.laogao.cloud
    - ceph3.laogao.cloud
spec:
  rgw_frontend_port: 8080
status:
  created: '2023-09-20T03:07:39.524771Z'
  running: 0
  size: 3
events:
- 2023-09-20T03:01:03.668554Z service:rgw.webapp [INFO] "service was created"

# 备份生成的文件
[root@ceph1 ~] ceph orch ls rgw --format yaml -o rgw_service.yaml

# 删除 status 之后所有行记录(只留可直接 apply 的部分)
[root@ceph1 ~] sed '/^status/,$d' rgw_service.yaml
service_type: rgw
service_id: webapp
service_name: rgw.webapp
placement:
  count: 3
  hosts:
    - ceph1.laogao.cloud
    - ceph2.laogao.cloud
    - ceph3.laogao.cloud
spec:
  rgw_frontend_port: 8080
💡 提示 :
ceph orch ls --format yaml -o <file>导出的内容不能直接拿去apply------里面带着status和events段,而status.created(本来是给系统填的)与events已经不再是合法的服务规格字段。sed '/^status/,$d'这一步是"备份可复用化"的关键 ,改完就能直接ceph orch apply -i恢复。
3.6 删除 RADOS 网关与删除域
bash
# 恢复/重建服务
[root@ceph1 ~] ceph orch apply -i rgw_service.yaml

# 删除 RADOS 网关服务
[root@ceph1 ~] ceph orch rm rgw.webapp
⚠️ 重要 :删除 RADOS 网关服务,将删除 RADOS 网关对应所有进程。注意:删除 RADOS 网关,并不会删除池中数据。
删除对象存储域(顺序:zone → zonegroup → realm):
bash
# 删除 zone
[root@ceph1 ~] radosgw-admin zone delete --rgw-zone=storage1

# 删除 zonegroup
[root@ceph1 ~] radosgw-admin zonegroup delete --rgw-zonegroup=video

# 删除 realm
[root@ceph1 ~] radosgw-admin realm delete --rgw-realm=webapp
💡 提示 :"删服务不删数据"和"删域不删池"是两件不同的事 ------
ceph orch rm rgw.webapp只摘掉网关进程,.rgw.*池和桶里的对象都还在;只有把池也删掉,数据才真正消失。做迁移时先删服务、观察业务无影响、再决定是否清池,是更稳的节奏。
四、网关用户、密钥与访问控制
4.1 创建网关用户
使用 radosgw-admin user create 命令创建 RADOS 网关用户:
- 必选选项 :
--uid(唯一的帐户名)和--display-name(人性化显示名); - 可选选项 :
--access-key和--secret,指定自定义的 AWS 帐户和机密密钥。
bash
[root@ceph1 ~] radosgw-admin user create --uid="operator" --display-name="S3 Operator" --email="operator@example.com" --access-key="12345" --secret-key="67890"
{
    "user_id": "operator",
    "display_name": "S3 Operator",
    "email": "operator@example.com",
    "suspended": 0,
    "max_buckets": 1000,
    "subusers": [],
    "keys": [
        {
            "user": "operator",
            "access_key": "12345",
            "secret_key": "67890"
        }
    ],
......

# 列出用户
[root@ceph1 ~] radosgw-admin user list
[
    "operator",
    "dashboard"
]

# 查看用户详情
[root@ceph1 ~] radosgw-admin user info --uid=operator如果未指定访问密钥和机密密钥,则自动生成,并显示在输出中:
bash
[root@ceph1 ~] radosgw-admin user create --uid=s3user --display-name="Amazon S3 API user"
{
    "user_id": "s3user",
    "display_name": "Amazon S3 API user",
    "email": "",
    "suspended": 0,
    "max_buckets": 1000,
    "subusers": [],
    "keys": [
        {
            "user": "s3user",
            "access_key": "ZQI72JZZDTA8BRCQOLGK",
            "secret_key": "BN6lMGhqacV61Fx2iEHww9N0ySI3Vvo6jMwCJnxX"
        }
    ],
......
⚠️ 注意 :
radosgw-admin命令自动生成的访问密钥和机密密钥可能包含 JSON 转义字符(\),客户端可能无法正确处理此字符。建议重新生成或手动指定密钥以避免此问题。 这是一个非常隐蔽的坑------密钥看起来"生成成功",客户端却一直认证失败,根因就在这个转义字符上。生产上建议显式指定--access-key和--secret-key。
4.2 重新生成与增删密钥
仅重新生成现有用户的机密密钥(access key 不变,secret 换新):
bash
[root@ceph1 ~] radosgw-admin key create --uid=s3user --access-key="ZQI72JZZDTA8BRCQOLGK" --gen-secret
{
    "user_id": "s3user",
    "display_name": "Amazon S3 API user",
    ...
    "keys": [
        {
            "user": "s3user",
            "access_key": "ZQI72JZZDTA8BRCQOLGK",
            "secret_key": "TJCcwo8rspE4xYyLAZHz4vapWA42YGB8hhrlPUnl"
        }
    ]
为现有用户添加访问密钥 ------用 --gen-access-key 选项:
💡 提示 :创建额外的密钥可以方便地授予同一用户对需要不同或唯一密钥的多个应用的访问权限。
bash
[root@ceph1 ~] radosgw-admin key create --uid=s3user --gen-access-key
{
    ...
    "keys": [
        {
            "user": "s3user",
            "access_key": "6WBR1FL8CBFX26KVRPPA",
            "secret_key": "UsytqYCeSudSqHKWwVVYZGFDdcS24lPpkXBrD42G"
        },
        {
            "user": "s3user",
            "access_key": "ZQI72JZZDTA8BRCQOLGK",
            "secret_key": "TJCcwo8rspE4xYyLAZHz4vapWA42YGB8hhrlPUnl"
        }
    ],
删除用户密钥 ------用 radosgw-admin key rm --access-key:
💡 提示 :此操作非常适用于删除单个应用的访问权限,并且不会影响使用其他密钥的访问权限。 这就是"一个用户多把钥匙"的价值------要下线某个应用,只吊销它那把钥匙即可,不用动其他应用。
bash
[root@ceph1 ~] radosgw-admin key rm --uid=s3user --access-key=6WBR1FL8CBFX26KVRPPA
{
    ...
    "keys": [
        {
            "user": "s3user",
            "access_key": "ZQI72JZZDTA8BRCQOLGK",
            "secret_key": "TJCcwo8rspE4xYyLAZHz4vapWA42YGB8hhrlPUnl"
        }
    ],
4.3 临时禁用与启用用户
bash
# 临时禁用(用户的子用户也会暂停,无法与 RADOS 网关服务交互)
[root@ceph1 ~] radosgw-admin user suspend --uid=s3user
{
    "user_id": "s3user",
    "display_name": "Amazon S3 API user",
    "email": "",
    "suspended": 1,                      <----看着变成了1
....

# 临时启用
[root@ceph1 ~] radosgw-admin user enable --uid=s3user
{
    ...
    "suspended": 0,
....
💡 提示 :
suspended字段就是开关------1= 已禁用,0= 正常 。user suspend是排查"业务突然报 403"时第一个该看的字段,也是做灰度下线最温和的手段(比删用户安全得多,随时可恢复)。
4.4 修改用户与访问控制级别
用户可修改用户信息,如电子邮件、显示名、密钥和访问控制级别:
bash
[root@ceph1 ~] radosgw-admin user modify --uid=s3user --display-name=huitailang
[root@ceph1 ~] radosgw-admin user modify --uid=s3user --access=full
--access 选项用于控制子用户访问权限,控制级别有四种:
| 级别 | 包含的能力 |
|---|---|
read |
只读 |
write |
只写 |
readwrite |
读写 |
full |
包含 readwrite 级别 + 访问控制管理功能 |
⚠️ 重要 :
full不是"readwrite 的加强版",它额外包含访问控制管理功能 ------也就是拿到这个级别的子用户可以自己去管理权限。给应用发凭据时,readwrite通常就是上限,full要慎给。
4.5 删除用户
bash
# 若要移除用户,同时删除其对象和存储桶,需使用 --purge-data 选项
[root@ceph1 ~] radosgw-admin user rm --uid=s3user --purge-data
[root@ceph1 ~] radosgw-admin user list
⚠️ 重要 :
--purge-data会连同该用户的对象和存储桶一起删除 ------这是网关层最危险的操作之一。不带--purge-data只是删用户,桶和数据会变成"无主"状态 (仍然占空间、仍能被管理员用radosgw-admin bucket操作)。删用户前务必先确认:这个用户是不是最后一个能访问这些桶的人。
五、用 Amazon S3 API 访问对象存储
5.1 为什么用 S3 API
在混合云环境中,用户希望应用可以通过相同的 API 无缝混用私有企业、公共云资源和存储位置。 Ceph 存储支持使用 Amazon S3 API 接口管理对象存储资源------意味着为亚马逊 S3 写的代码,几乎可以原样跑在 Ceph 上。
Amazon S3 API 称命名空间为存储桶,用于存储对象。 要使用 Amazon S3 API 管理对象和存储桶,应用需通过 RADOS 网关用户进行身份验证 :每个用户都有一个识别用户的 access key 和一个对用户进行身份验证的 secret key。
5.2 必须先知道的大小限制
| 限制项 | 数值 |
|---|---|
| 对象大小 | 0 B ~ 5 TB |
| 单次上传操作的最大大小 | 5 GB |
| 建议使用分段上传的场景 | 要上传 100 MB 以上的对象 |
| 单个 HTTP 请求中的元数据大小 | 最大 16,000 字节 |
⚠️ 重要 :"对象最大 5 TB"和"单次上传最大 5 GB"是两条不同的限制 ------超过 5 GB 的对象必须 用分段上传(multipart upload)才能传上去。而元数据 16,000 字节的上限意味着不要把大块业务信息塞进自定义元数据,那是对象存储最容易踩的隐性限制。
5.3 安装与配置 aws cli
Amazon S3 API 客户端有多个,例如 awscli、cloudberry、cyberduck 和 curl 。讲义用的是 aws 工具 ,由 awscli 软件包提供:
bash
# 准备 aliyun 源 pip 仓库(提升国内安装成功率)
[root@client ~] mkdir .pip
[root@client ~] cat > .pip/pip.conf << 'EOF'
[global]
index-url = http://mirrors.aliyun.com/pypi/simple/
[install]
trusted-host=mirrors.aliyun.com
EOF

# 安装软件包
[root@client ~] pip3 install awscli
配置凭据 ------目标是用 operator 用户,访问密钥 12345、机密密钥 67890 ,配置信息保存在 ~/.aws 目录:
bash
[root@client ~] aws
usage: aws [options] <command> <subcommand> [<subcommand> ...] [parameters]
To see help text, you can run:
  aws help
  aws <command> help
  aws <command> <subcommand> help
aws: error: the following arguments are required: command

# 配置默认凭据
[root@client ~] aws configure
AWS Access Key ID [None]: 12345
AWS Secret Access Key [None]: 67890
Default region name [None]: 回车
Default output format [None]: 回车

[root@client ~] ls .aws
config  credentials
[root@client ~] cat .aws/config
[default]
[root@client ~] cat .aws/credentials
[default]
aws_access_key_id = 12345
aws_secret_access_key = 67890
配置多个凭据 (用 --profile):
bash
[root@client ~] aws configure --profile=ceph
AWS Access Key ID [None]: 12345
AWS Secret Access Key [None]: 67890
Default region name [None]:
Default output format [None]:

[root@client ~] cat .aws/config
[default]
[profile ceph]
[root@client ~] cat .aws/credentials
[default]
aws_access_key_id = 12345
aws_secret_access_key = 67890
[ceph]
aws_access_key_id = 12345
aws_secret_access_key = 67890
💡 提示 :
aws命令默认使用default段里的凭据 ;要指定别的凭据用--profile,要指定服务器位置用--endpoint(配置项名是endpoint_url)。官方配置参考:https://docs.aws.amazon.com/cli/latest/userguide/cli-chap-configure.html。
5.4 桶操作
bash
# 环境准备:把集群节点的 hosts 文件同步过来(便于用域名访问)
[root@client ~] scp 192.168.108.11:/etc/hosts /etc/hosts

# 创建存储桶
[root@client ~] aws --endpoint=http://ceph1.laogao.cloud:8080 s3 mb s3://webapp
make_bucket: webapp

# 查看存储桶清单
[root@client ~] aws --endpoint=http://ceph1.laogao.cloud:8080 s3 ls
2025-08-25 17:14:05 webapp

# radosgw-admin 也支持存储桶操作
[root@ceph1 ~] radosgw-admin buckets list
[
    "webapp"
]
💡 提示 :
radosgw-admin bucket list/bucket rm是网关管理侧的桶操作 ,与 S3 客户端的aws s3 mb/rb是两条平行路径------前者用的是管理凭据,后者用的是网关用户凭据。排查"桶到底存不存在"时用radosgw-admin更权威,因为它绕过了 S3 协议的鉴权层。
5.5 对象上传、查看与下载
cp 子命令支持三种复制方向:
<LocalPath> <S3Uri>:将本地文件上传到对象存储中;<S3Uri> <LocalPath>:下载对象存储中对象到本地;<S3Uri> <S3Uri>:将对象存储中对象复制到对象存储中(桶内或跨桶复制)。
bash
# 准备两个测试文件,分别用不同 ACL 上传
[root@client ~] echo Hello World > Welcome-pub.html
[root@client ~] echo Hello laogao > Welcome-pri.html

# 上传并指定公开读写 ACL
[root@client ~] aws --endpoint=http://ceph1.laogao.cloud:8080 s3 cp Welcome-pub.html s3://webapp/ --acl=public-read-write
upload: ./Welcome-pub.html to s3://webapp/Welcome-pub.html

# 用默认权限上传(注意 --endpoint 放在后面也可以)
[root@client ~] aws s3 cp Welcome-pri.html s3://webapp --endpoint=http://ceph1.laogao.cloud:8080
upload: ./Welcome-pri.html to s3://webapp/Welcome-pri.html

# 查看存储桶中对象
[root@client ~] aws s3 ls s3://webapp --endpoint=http://ceph1.laogao.cloud:8080
2025-08-25 17:23:35         13 Welcome-pri.html
2025-08-25 17:22:18         12 Welcome-pub.html

# 下载单个对象
[root@client ~] aws s3 cp s3://webapp/Welcome-pri.html /tmp --endpoint=http://ceph1.laogao.cloud:8080
download: s3://webapp/Welcome-pri.html to ../tmp/Welcome-pri.html
[root@client ~] ls /tmp/Welcome-pri.html
/tmp/Welcome-pri.html

# 递归下载桶中所有对象
[root@client ~] aws s3 cp s3://webapp /tmp --recursive --endpoint=http://ceph1.laogao.cloud:8080
download: s3://webapp/Welcome-pri.html to ../tmp/Welcome-pri.html
download: s3://webapp/Welcome-pub.html to ../tmp/Welcome-pub.html
5.6 用浏览器直接下载:ACL 的直观效果
bash
# Welcome-pub.html 可以正常下载
[root@client ~] wget http://ceph1.laogao.cloud:8080/webapp/Welcome-pub.html

# Welcome-pri.html 不可以下载,因为权限不允许
[root@client ~] wget http://ceph1.laogao.cloud:8080/webapp/Welcome-pri.html
--2025-08-25 17:36:59--  http://ceph1.laogao.cloud:8080/webapp/Welcome-pri.html
Resolving ceph1.laogao.cloud (ceph1.laogao.cloud)... 192.168.108.11
Connecting to ceph1.laogao.cloud (ceph1.laogao.cloud)|192.168.108.11|:8080... connected.
HTTP request sent, awaiting response... 403 Forbidden
2025-08-25 17:36:59 ERROR 403: Forbidden.
⚠️ 注意 :
403 Forbidden在这里是"正确行为"而不是故障 ------Welcome-pub.html上传时带了--acl=public-read-write,所以匿名 HTTP 访问可行;Welcome-pri.html是私有对象,匿名访问就该被拒。这也是"对象存储对外发内容"的两种姿势 :要么给对象设公开读 ACL,要么用预签名 URL(presigned URL) 给临时访问权。生产上不要图省事把整个桶设成 public------那等于把数据挂到了公网上。
5.7 删除对象与删除桶
bash
# 删除单个对象
[root@client ~] aws s3 rm s3://webapp/Welcome-pri.html --endpoint=http://ceph1.laogao.cloud:8080
delete: s3://webapp/Welcome-pri.html
[root@client ~] aws s3 ls s3://webapp --endpoint=http://ceph1.laogao.cloud:8080
2025-08-25 17:22:18         12 Welcome-pub.html

# 非空的存储桶不能删除
[root@client ~] aws s3 rb s3://webapp --endpoint=http://ceph1.laogao.cloud:8080
remove_bucket failed: s3://webapp argument of type 'NoneType' is not iterable

# 先清空存储桶,再次删除
[root@client ~] aws s3 rm s3://webapp --recursive --include "Welcome-*" --endpoint=http://ceph1.laogao.cloud:8080
delete: s3://webapp/Welcome-pub.html
[root@client ~] aws s3 rb s3://webapp --endpoint=http://ceph1.laogao.cloud:8080
remove_bucket: webapp
💡 提示 :"非空桶不能删"是 S3 协议的设计约束 ,报错信息
argument of type 'NoneType' is not iterable看着莫名其妙,其实就是"桶里还有对象"。删桶的标准动作是aws s3 rm s3://<bucket> --recursive清空 →aws s3 rb删除 。清空时可以用--include/--exclude过滤,避免误删。
六、对象存储配额:user / bucket / global 三级
6.1 三级作用域
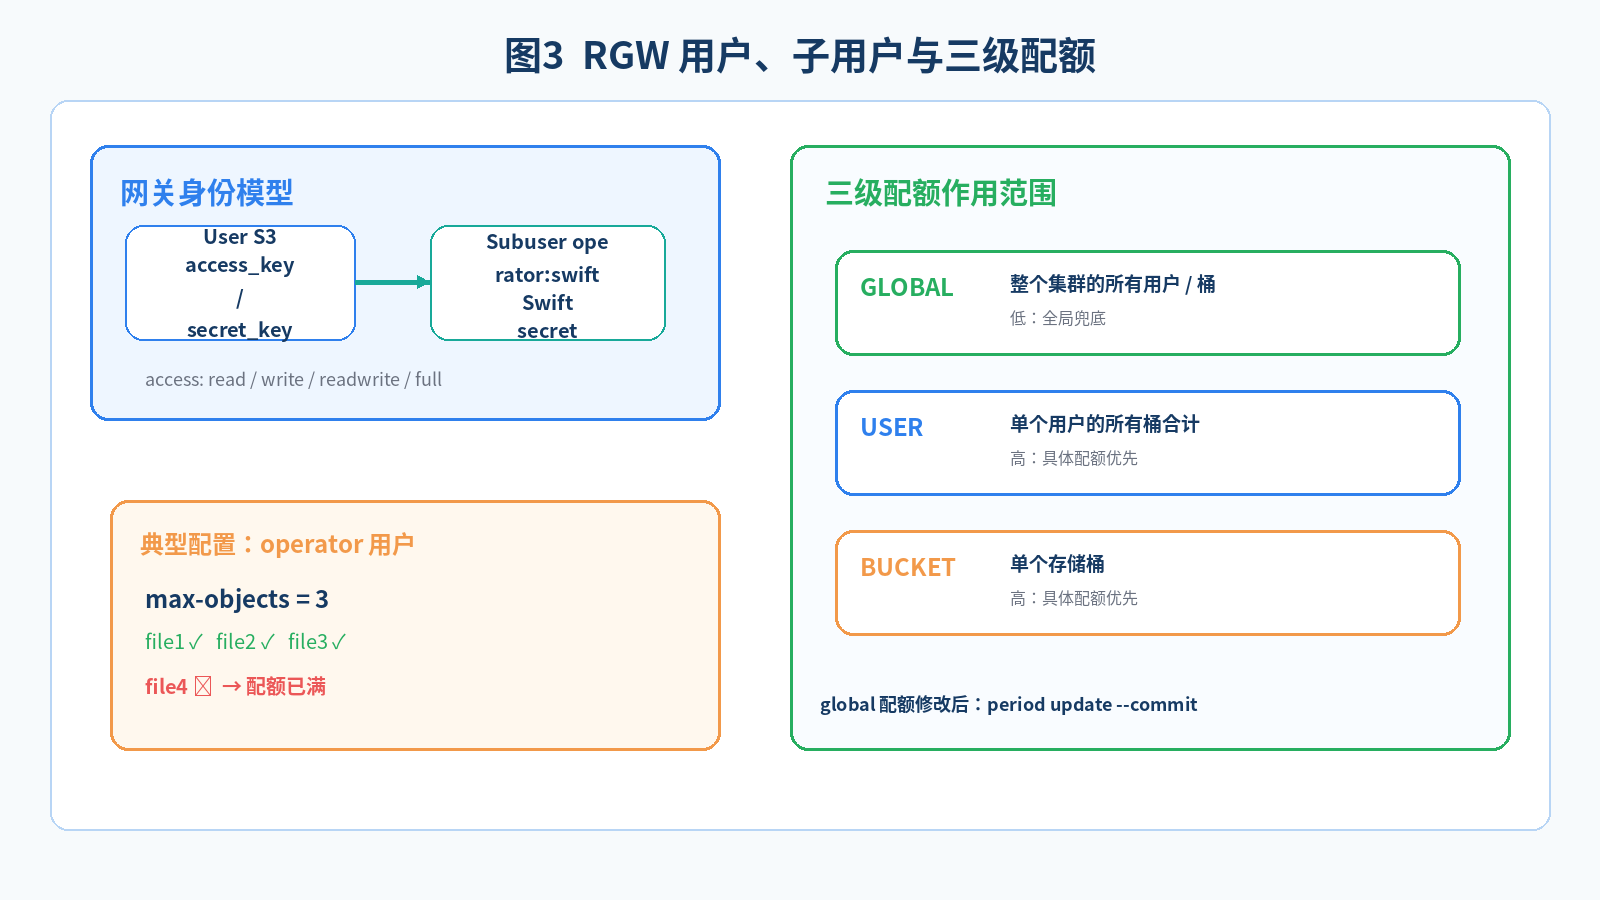
设置配额可限制用户或存储桶可消耗的存储量。 对象存储的配额有三个层次,通过 --quota-scope 选项区分:
| 作用域 | 参数 | 作用对象 | 优先级 |
|---|---|---|---|
| user 级别 | --quota-scope=user --uid=<user> |
单个用户(其所有桶合计) | 高 |
| bucket 级别 | --quota-scope=bucket --bucket=<bucket> |
单个存储桶 | 高 |
| global 级别 | `radosgw-admin global quota set --quota-scope user | bucket` | 集群中所有存储桶和所有用户 |
⚠️ 重要 :全局配额会影响集群中的所有存储桶和所有用户。如果做了具体的桶配额或用户配额,以具体配额优先。 所以 global 是"兜底默认值",不是"覆盖一切的总量控制"。
6.2 user 级别配额
bash
# 启用用户配额(示例:operator 用户配额为最多 3 个对象)
[root@ceph1 ~] radosgw-admin quota enable --quota-scope=user --uid=operator
[root@ceph1 ~] radosgw-admin quota set --quota-scope=user --uid=operator --max-objects=3

# 查看用户配额
[root@ceph1 ~] radosgw-admin user info --uid=operator
{
    "user_id": "operator",
    ...
    "bucket_quota": {
        "enabled": false,
        "check_on_raw": false,
        "max_size": -1,
        "max_size_kb": 0,
        "max_objects": -1
    },
    "user_quota": {
        "enabled": true,
        "check_on_raw": false,
        "max_size": -1,
        "max_size_kb": 0,
        "max_objects": 3
    },
    ...
}

# 查看空间使用情况
[root@ceph1 ~] radosgw-admin user stats --uid=operator
{
    "stats": {
        "size": 0,
        "size_actual": 0,
        "size_kb": 0,
        "size_kb_actual": 0,
        "num_objects": 0
    },
    "last_stats_sync": "0.000000",
    "last_stats_update": "2025-08-25T09:44:36.609841Z"
}
实测:配额确实拦住了第 4 个对象
bash
[root@client ~] aws --endpoint=http://ceph1.laogao.cloud:8080 s3 mb s3://webapp
make_bucket: webapp
[root@client ~] aws --endpoint=http://ceph1.laogao.cloud:8080 s3 ls s3://webapp
      #先看下webapp桶有多少文件,现在没有

# 传 3 个文件
[root@client ~] touch file1 file2 file3 file4
[root@client ~] aws --endpoint=http://ceph1.laogao.cloud:8080 s3 cp file1 s3://webapp
upload: ./file1 to s3://webapp/file1
[root@client ~] aws --endpoint=http://ceph1.laogao.cloud:8080 s3 cp file2 s3://webapp
upload: ./file2 to s3://webapp/file2
[root@client ~] aws --endpoint=http://ceph1.laogao.cloud:8080 s3 cp file3 s3://webapp
upload: ./file3 to s3://webapp/file3

[root@client ~] aws --endpoint=http://ceph1.laogao.cloud:8080 s3 ls s3://webapp
2026-06-02 09:44:58          0 file1
2026-06-02 09:45:05          0 file2
2026-06-02 09:45:10          0 file3

# 服务端统计:num_objects 已经达到最大 3 个
[root@ceph1 ~] radosgw-admin user stats --uid=operator
{
    "stats": {
        ...
        "num_objects": 3                      #已经达到最大3个
    },
    ...
}

# 第四个文件无法上传
[root@client ~] aws --endpoint=http://ceph1.laogao.cloud:8080 s3 cp file4 s3://webapp
upload failed: ./file4 to s3://webapp/file4 argument of type 'NoneType' is not iterable禁用用户配额(示例:禁用 operator 用户配额):
bash
[root@ceph1 ~] radosgw-admin quota set --quota-scope=user --uid=operator --max-objects=-1
[root@ceph1 ~] radosgw-admin quota disable --quota-scope=user --uid=operator
[root@ceph1 ~] radosgw-admin user info --uid=operator
{
    ...
    "user_quota": {
        "enabled": false,
        "check_on_raw": false,
        "max_size": -1,
        "max_size_kb": 0,
        "max_objects": -1
    },
bash
# 再次上传第四个文件测试 ------ 成功
[root@client ~] aws --endpoint=http://ceph1.laogao.cloud:8080 s3 cp file4 s3://webapp
upload: ./file4 to s3://webapp/file4
💡 提示 :禁用配额要"两步走" ------先把
max-objects置回-1,再quota disable。-1表示"不限制" ,这是贯穿 user / bucket / global 三级的约定值。只 disable 不置-1,配额值还留在配置里,下次误 enable 就会立刻生效。
6.3 bucket 级别配额
bash
[root@client ~] aws --endpoint=http://ceph1.laogao.cloud:8080 s3 mb s3://webapp
make_bucket: webapp

# 启用 bucket 配额(示例:webapp 存储桶被设置为最多 3 个对象)
[root@ceph1 ~] radosgw-admin quota enable --quota-scope=bucket --bucket=webapp
[root@ceph1 ~] radosgw-admin quota set --quota-scope=bucket --bucket=webapp --max-objects=3

# 查看 bucket 配额
[root@ceph1 ~] radosgw-admin bucket stats --bucket=webapp
{
    "bucket": "webapp",
    "num_shards": 11,
    "tenant": "",
    "zonegroup": "0fdaf584-33ee-4be7-978c-fb2771181aee",
    "placement_rule": "default-placement",
    "id": "76366a48-2ab8-4830-9cf7-f9b2fe432c5a.44325.2",
    "index_type": "Normal",
    "owner": "operator",
    ...
    "bucket_quota": {
        "enabled": true,
        "check_on_raw": false,
        "max_size": -1,
        "max_size_kb": 0,
        "max_objects": 3         #webapp 存储桶被设置为最多 3 个对象
    }
}

# 还原(参考 user 级别的测试方法)
[root@ceph1 ~] radosgw-admin quota set --quota-scope=bucket --bucket=webapp --max-objects=-1
[root@ceph1 ~] radosgw-admin quota disable --quota-scope=bucket --bucket=webapp
💡 提示 :
radosgw-admin bucket stats的输出很有信息量:num_shards: 11说明这个桶的索引被分成了 11 个分片(桶索引分片是 RGW 支撑高并发桶操作的关键机制 ),owner: operator告诉你桶的属主是谁,zonegroup是它所属的区域组 ID。排查"桶属主是谁、索引分几片、配额状态如何"都看这一条命令。
6.4 global 级别配额
bash
# 针对所有用户的配额
[root@ceph1 ~] radosgw-admin global quota set --quota-scope user --max-objects 2048
Global quota changes saved. Use 'period update' to apply them to the staging period, and 'period commit' to commit the new period.
{
    "user quota": {
        "enabled": false,
        "check_on_raw": false,
        "max_size": -1,
        "max_size_kb": 0,
        ...
⚠️ 重要 :全局配额修改后不会立即生效 ------命令自己就提示了:
Use 'period update' to apply them to the staging period, and 'period commit' to commit the new period.也就是说:
bash
# 让全局配额真正生效
[root@ceph1 ~] radosgw-admin period update --commit
要提交更改后才能实施全局配额 ------这也呼应了第 2 节讲的"期间/时期"模型:改的是配置,而配置要提交成一个新期间才算数。忘了这一步,表现就是"配了配额但完全不起作用"。
6.5 配额排障与最佳实践
| 现象 | 原因与处理 |
|---|---|
上传报 argument of type 'NoneType' is not iterable |
配额已满的典型表现(aws cli 对 RGW 返回的配额错误解析异常)。看 radosgw-admin user stats / bucket stats 的 num_objects 是否达到上限 |
| 配了 global 配额但不生效 | 忘了 radosgw-admin period update --commit |
| 配了具体配额却被 global 覆盖 | 顺序反了:具体配额优先,先确认 user/bucket 级是否已 enable |
| 想彻底取消某级配额 | 先把 max-objects / max-size 置回 -1,再 quota disable |
| 用户级别和桶级别的值不一致 | 二者是独立的配额维度:user 是"该用户全部桶的合计",bucket 是"单个桶" |
七、用 OpenStack Swift API 访问对象存储
7.1 两套用户模型的差异
用户还可以通过 OpenStack Swift API 访问 Ceph 存储集群中的对象。OpenStack Swift API 的用户模型与 Amazon S3 API 的不同:
| API | 模型 | 说明 |
|---|---|---|
| Amazon S3 API | 单层设计 | 一个用户帐户可能有多个访问密钥和机密,供该用户提供不同类型的访问 |
| OpenStack Swift API | 多层级设计 | 专为容纳租户和指定用户而构建 。Swift 租户拥有由服务使用的存储及其容器 ;Swift 用户分配给服务,配置不同的访问权限级别访问存储 |
为了容纳 OpenStack Swift API 的身份验证和授权模型,RADOS 网关使用子用户(subuser)。映射关系是:
text
Swift API 的 tenant:user 模型  →  映射到 RADOS 网关的 user:subuser 体系
Swift API 租户(tenant)       →  RADOS 网关用户(user)
Swift API 用户(user)         →  RADOS 网关子用户(subuser)
💡 提示 :这就是"为什么配了 S3 用户,Swift 却连不上"的答案 ------S3 用的是 user 自身的
access_key/secret_key,而 Swift 用的是"子用户 + swift 类型的密钥(swift_keys)" 。要访问 Swift API,需要先创建一个 Swift 用户,然后为该用户创建一个子用户,该子用户与 RADOS 网关用户和访问密钥相关联。
7.2 创建子用户
bash
# 前置:域/网关准备(realm + zonegroup + zone + 部署 rgw)
radosgw-admin realm create --rgw-realm=webapp --default
radosgw-admin zonegroup create --rgw-realm=webapp --rgw-zonegroup=video --master --default
radosgw-admin zone create --rgw-realm=webapp --rgw-zonegroup=video --rgw-zone=storage --master --default
ceph orch apply rgw webapp --placement="3 ceph1.laogao.cloud ceph2.laogao.cloud ceph3.laogao.cloud" --realm=webapp --zone=storage --port=8080

# 创建网关用户(Swift 的"租户")
radosgw-admin user create --uid="operator" --display-name="swift Operator" --email="operator@example.com" --access_key="12345" --secret="67890"

# 为该用户创建子用户 operator:swift
[root@ceph1 ~] radosgw-admin subuser create --uid=operator --subuser=operator:swift --access=full --secret=opswift
{
    "user_id": "operator",
    "display_name": "swift Operator",
    "email": "operator@example.com",
    "suspended": 0,
    "max_buckets": 1000,
    "subusers": [
        {
            "id": "operator:swift",
            "permissions": "full-control"
        }
    ],
    "keys": [
        {
            "user": "operator",
            "access_key": "12345",
            "secret_key": "67890"
        }
    ],
    "swift_keys": [
        {
            "user": "operator:swift",
            "secret_key": "opswift"
        }
    ],
    ...
}注意输出的结构差异:子用户信息在 subusers 数组里(permissions: full-control),S3 的密钥在 keys 里,Swift 的密钥单独放在 swift_keys 里。三处并存,互不干扰。
三个关键选项:
| 选项 | 作用 |
|---|---|
--access |
指定用户的权限(读取、写入、读写、完全) |
--uid |
指定现有的已关联 RADOS 网关用户 |
--subuser=username:swift |
指定现有的已关联 RADOS 网关用户的子用户 |
7.3 创建子用户密钥
bash
[root@ceph1 ~] radosgw-admin key create --uid=operator --subuser=operator:swift --key-type=swift --gen-secret--key-type 选项接受 swift 或 s3 两个值。密钥的具体指定方式:
| 需求 | 选项 |
|---|---|
| 手动指定访问密钥 | --access-key |
| 手动指定机密密钥 | --secret-key |
| 仅生成随机访问密钥 | --gen-accesskey |
| 仅生成随机机密 | --gen-secret |
7.4 修改与删除子用户
bash
# 修改子用户(访问级别、secret 等)
[root@ceph1 ~] radosgw-admin subuser modify --uid=operator --subuser=operator:swift --secret=opswift --access=full

# 删除子用户密钥
[root@ceph1 ~] radosgw-admin key rm --subuser=operator:swift

# 删除子用户
[root@ceph1 ~] radosgw-admin subuser rm --subuser=operator:swift
⚠️ 重要 :删除子用户有两个危险选项------
--purge-data可清除与子用户关联的所有数据 ,--purge-keys可清除所有子用户密钥 。不带这两个选项时只删子用户本身。清数据前一定要确认这个子用户底下有没有业务在跑。
7.5 完整准备一套 Swift 凭据
bash
# 创建用户 swift
[root@ceph1 ~] radosgw-admin user create --uid=swift --display-name=swift

# 创建子账号 swift_rgw
[root@ceph1 ~] radosgw-admin subuser create --uid=swift --subuser=swift:swift_rgw --access=full

# 创建子账号的 swift 类型 key
[root@ceph1 ~] radosgw-admin key create --subuser=swift:swift_rgw --key-type=swift --gen-secret
{
    "user_id": "swift",
    "display_name": "swift",
    "email": "",
    "suspended": 0,
    "max_buckets": 1000,
    "subusers": [
        {
            "id": "swift:swift_rgw",
            "permissions": "full-control"
        }
    ],
    "keys": [
        {
            "user": "swift",
            "access_key": "BXK4ZTZLO2A5W2380V8Y",
            "secret_key": "ygZS3CTL1x3ja4UJMlY4M6Zb8abOQFZ3A9FOgQcM"
        }
    ],
    "swift_keys": [
        {
            "user": "swift:swift_rgw",
            "secret_key": "9KPxNkJSvGP1i5LDs9QV4elDCoHTAjdsPJoszDWj"
        }
    ],
    ...
}
💡 提示 :配置完成后要记录下生成的 Key ------后续 Swift 客户端认证用的是
swift_keys里那一项 (本例是swift:swift_rgw对应的 secret),而不是keys里的 S3 密钥。这个"记错钥匙"是 Swift 接入失败的头号原因。
7.6 安装与配置 swift 客户端
bash
# 准备 aliyun 源 pip 仓库
[root@client ~] mkdir .pip
[root@client ~] cat > .pip/pip.conf << 'EOF'
[global]
index-url = http://mirrors.aliyun.com/pypi/simple/
[install]
trusted-host=mirrors.aliyun.com
EOF

# 安装软件包
[root@client ~] pip3 install python-swiftclient
[root@client ~] swift --version
python-swiftclient 4.7.0凭据的两种提供方式:
💡 提示 :Swift 客户端与 RADOS 网关通信时,RADOS 网关同时充当数据服务器和 Swift 身份验证守护进程(使用
/authURL 路径) 。RADOS 网关支持 Internal Swift(版本 1.0) 和 OpenStack Keystone(版本 2.0) 两种身份验证。
方式一:环境变量
| 认证版本 | 需要的环境变量 |
|---|---|
| Auth 版本 1.0 | ST_AUTH、ST_USER、ST_KEY |
| Auth 版本 2.0 | OS_AUTH_URL、OS_USERNAME、OS_PASSWORD、OS_TENANT_NAME、OS_TENANT_ID |
bash
[root@client ~] vim swift.rc
export ST_AUTH=http://ceph1.laogao.cloud:8080/auth/1.0
export ST_USER=swift:swift_rgw
export ST_KEY=9KPxNkJSvGP1i5LDs9QV4elDCoHTAjdsPJoszDWj           #用前面的值替代

[root@client ~] source swift.rc
[root@client ~] swift list
方式二:命令行选项
| 选项 | 指定的内容 |
|---|---|
-A |
Swift 认证 URL |
-U |
Swift 子用户 |
-K |
Swift 子用户对应的机密 |
bash
[root@client ~] swift -A http://ceph1.laogao.cloud:8080/auth/1.0 -U "swift:swift_rgw" -K 9KPxNkJSvGP1i5LDs9QV4elDCoHTAjdsPJoszDWj list💡 提示 :
swift.rc+source的写法在生产上更可取 ------凭据集中在一个受限权限的文件里,脚本里不用重复写密钥(也避免密钥出现在ps输出和 shell history 里)。注意这个文件本身要按密钥来保护。
7.7 swift 的子命令与关键选项
bash
[root@client ~] swift --help
Command-line interface to the OpenStack Swift API.
Positional arguments:
  <subcommand>
    delete               Delete a container or objects within a container.
    download             Download objects from containers.
    list                 Lists the containers for the account or the objects
                         for a container.
    post                 Updates meta information for the account, container,
                         or object; creates containers if not present.
    copy                 Copies object, optionally adds meta
    stat                 Displays information for the account, container,
                         or object.
    upload               Uploads files or directories to the given container.
    capabilities         List cluster capabilities.
    tempurl              Create a temporary URL.
    auth                 Display auth related environment variables.
    bash_completion      Outputs option and flag cli data ready for
                         bash_completion.
swift upload 是选项最多的子命令,几个必须知道的:
| 选项 | 作用 |
|---|---|
-S, --segment-size <size> |
把文件按不超过该大小(字节)分段上传 ,并创建一个 manifest 文件,下载时会像原文件一样把所有段拼起来 |
--segment-container <container> |
把分段上传到指定容器;不指定时会传到 <container>_segments,以免污染主容器的列表 |
-m, --meta <name:value> |
设置元数据项,可重复(例:-m Color:Blue -m Size:Large) |
-H, --header <header:value> |
添加自定义请求头,可重复(例:-H "content-type:text/plain") |
-c, --changed |
只上传自上次上传以来有变化的文件 |
--skip-identical |
跳过两端已完全相同的文件 |
--object-name <object-name> |
自定义对象名(配合 - 从标准输入读取时必须指定) |
--object-threads / --segment-threads |
上传对象 / 分段的线程数,默认均为 10 |
💡 提示 :
-S分段上传对应 S3 的 multipart upload ------对象存储里"大文件怎么传"的通用答案。注意--segment-container的默认行为 :段会进<container>_segments,所以你在主容器里swift list看到的是一个 manifest 对象,而实际数据分散在另一个容器里------排查"删了对象空间没释放"时就要想到这些残留的段。
八、Swift 客户端实战:容器、对象与配额验证
8.1 查看存储状态与认证信息
bash
# 存储状态:账号、容器数、对象数、字节数
[root@client ~] swift stat
                                   Account: v1
                                Containers: 0
                                   Objects: 0
                                     Bytes: 0
Objects in policy "default-placement-bytes": 0
  Bytes in policy "default-placement-bytes": 0
   Containers in policy "default-placement": 0
      Objects in policy "default-placement": 0
        Bytes in policy "default-placement": 0
                               X-Timestamp: 1756120916.52301
               X-Account-Bytes-Used-Actual: 0
                                 X-Trans-Id: tx000000bdae1b6eec631b5-0068ac4754-ad01-storage
                     X-Openstack-Request-Id: tx000000bdae1b6eec631b5-0068ac4754-ad01-storage
                              Accept-Ranges: bytes
                               Content-Type: text/plain; charset=utf-8
                                 Connection: Keep-Alive

# 认证信息(当前使用的 token 与存储 URL)
[root@client ~] swift auth
export OS_STORAGE_URL=http://ceph1.laogao.cloud:8080/swift/v1
export OS_AUTH_TOKEN=AUTH_rgwtk0f00000073776966743a73776966745f7267771c03132ca7ff9f23e498ad685aaedc2332323e8a316edd865b5d15be670fb35bf3a00a8c
💡 提示 :
swift auth会把当前认证的OS_STORAGE_URL和OS_AUTH_TOKEN打出来 ------排障时非常有用:它证明"认证这一步过了",问题一定在后面的请求上。另外注意容量统计里出现了policy "default-placement"/"default-placement-bytes"这两套策略,说明桶的放置策略(placement)是独立于 pool 概念的又一层。
8.2 创建容器(桶)
bash
[root@client ~] swift post --help
Usage: swift post [--read-acl <acl>] [--write-acl <acl>] [--sync-to <sync-to>]
                  [--sync-key <sync-key>] [--meta <name:value>]
                  [--header <header>]
                  [<container> [<object>]]
Updates meta information for the account, container, or object.
If the container is not found, it will be created automatically.
swift post 的关键选项:
| 选项 | 作用 |
|---|---|
-r, --read-acl <acl> |
容器的读 ACL (如 .r:*、.r:-.example.com、.r:www.example.com) |
-w, --write-acl <acl> |
容器的写 ACL |
-t, --sync-to <sync-to> |
容器的同步目标(用于多集群复制) |
-k, --sync-key <sync-key> |
容器的同步密钥(用于多集群复制) |
-m, --meta <name:value> |
设置元数据项,可重复 |
bash
# 创建容器(不存在会自动创建)
[root@client ~] swift post webapp
[root@client ~] swift list
webapp
💡 提示 :
swift post是"创建或更新容器/对象元信息"的合一命令 ------容器不存在时自动创建,这就是它被当作"建容器"命令用的原因。--sync-to/--sync-key这一对选项属于"容器级多集群复制",是 S3 侧没有的能力。
8.3 上传、查看与下载
bash
[root@client ~] echo Hello World > Welcome.html
[root@client ~] echo Test> test.html

# 上传文件
[root@client ~] swift upload webapp Welcome.html
Welcome.html

# 上传绝对路径的文件
[root@client ~] swift upload webapp /etc/hostname
etc/hostname

# 查看容器中对象清单
[root@client ~] swift list webapp
Welcome.html
etc/hostname
⚠️ 重要 :如果使用绝对路径来定义文件位置,对象名称将包含文件路径,包括斜杠字符
/。 上例中/etc/hostname上传后对象名变成了etc/hostname------看着像目录结构,实际只是对象键。想控制对象名就用--object-name选项 :例如swift upload --object-name hosts-1 dbapp /etc/hosts。这个"路径被吃进对象名"的行为,在按前缀统计、按前缀删除时会造成意外结果,务必留意。
bash
# 下载容器中所有对象
[root@client ~] swift download webapp
etc/hostname [auth 0.005s, headers 0.009s, total 0.010s, 0.004 MB/s]
Welcome.html [auth 0.005s, headers 0.010s, total 0.010s, 0.002 MB/s]

# 下载容器中单个对象
[root@client ~] swift download webapp Welcome.html
Welcome.html [auth 0.004s, headers 0.008s, total 0.009s, 0.003 MB/s]
8.4 删除对象与容器
bash
# 删除指定对象
[root@client ~] swift delete webapp etc/hostname
etc/hostname

# 删除容器(连同其中所有对象)
[root@client ~] swift delete webapp
Welcome.html
webapp
⚠️ 重要 :删除容器,将删除容器中所有对象和容器本身。 这一点与 S3 不同------S3 是"非空桶不能删",而 Swift 的
swift delete <container>会连带清空再删除 。这条命令在生产上是"一键误删一整桶"级别的危险操作,脚本里执行前务必确认容器名。
8.5 用 Swift 验证配额限制
针对用户进行配额限制:
bash
# 先创建一个容器并上传一个对象
[root@client ~] swift post dbapp
[root@client ~] swift upload --object-name hosts-1 dbapp /etc/hosts

# 对用户 swift 启用配额:对象数量不超过 3
[root@ceph1 ~] radosgw-admin quota enable --quota-scope=user --uid=swift
[root@ceph1 ~] radosgw-admin quota set --quota-scope=user --uid=swift --max-objects=3
[root@ceph1 ~] radosgw-admin user info --uid=swift
......
    "user_quota": {
        "enabled": true,
        "check_on_raw": false,
        "max_size": -1,
        "max_size_kb": 0,
        "max_objects": 3
    },
......

# 上传第 4 个对象时,客户端收到报错
[root@client ~] swift upload --object-name hosts-2 dbapp /etc/hosts
[root@client ~] swift upload --object-name hosts-3 dbapp /etc/hosts
[root@client ~] swift upload --object-name hosts-4 dbapp /etc/hosts
Object PUT failed: http://ceph1.laogao.cloud:8080/swift/v1/dbapp/hosts-4 413
Request Entity Too Large   b'QuotaExceeded' (txn: tx00000f89584465dec20ff-006603ab85-acdb-webapp)
Consider using the --segment-size option to chunk the object

# 将 --max-objects 设置为 -1,取消对象数量配额的限制
[root@ceph1 ~] radosgw-admin quota set --quota-scope=user --uid=swift --max-objects=-1
# 客户端重新上传,顺利通过
[root@client ~] swift upload --object-name hosts-4 dbapp /etc/hosts
💡 提示 :Swift 侧的配额超限报错比 S3 侧清晰得多------HTTP
413 Request Entity Too Large+ 响应体b'QuotaExceeded'。顺便说一句,客户端提示的Consider using the --segment-size option to chunk the object在这里是误导 :分段上传并不能绕过对象数量配额(它会把一个对象变成多个段,反而更容易撞配额)。这条提示只在"单文件超过大小限制"时才是对的。
思考与回答 :除了设置对象数量外,是否还有其他的配额限制方式?
回答:有,除了对象数量,还可以对最大上传的容量进行限制。
针对桶进行配额限制:
bash
# 启用对桶 dbapp 的配额限制,最大容量 10M
[root@ceph1 ~] radosgw-admin quota enable --quota-scope=bucket --bucket=dbapp
[root@ceph1 ~] radosgw-admin quota set --quota-scope=bucket --bucket=dbapp --max-size=10M

# 查看配额信息
[root@ceph1 ~] radosgw-admin bucket stats
......
 "bucket_quota": {
            "enabled": true,
            "check_on_raw": true,
            "max_size": 10485760,
            "max_size_kb": 10240,
            "max_objects": -1
        },
......

# 造一个 6M 的文件测试
[root@client ~] dd if=/dev/zero of=file bs=1M count=6

# 上传第一个成功,上传第二个时返回报错
[root@client ~] swift upload --object-name file-1 dbapp file
file-1
[root@client ~] swift upload --object-name file-2 dbapp file
Object PUT failed: http://ceph1.laogao.cloud:8080/swift/v1/dbapp/file-2 413
Request Entity Too Large   b'QuotaExceeded' (txn: tx000008b826fc312e77202-006603acbd-acdb-webapp)
Consider using the --segment-size option to chunk the object

# 将 --max-size 设置为 -1,取消容量配额限制
[root@ceph1 ~] radosgw-admin quota set --quota-scope=bucket --bucket=dbapp --max-size=-1
[root@client ~] swift upload --object-name file-2 dbapp file
因为这个 10M 的配额,第一个 6M 文件刚好通过(6M < 10M),第二个 6M 文件就撞上限(12M > 10M) ------这是验证配额是否生效最直观的算法:看"已用 + 本次"是否越过阈值。
九、多站点对象存储与区域故障转移
9.1 三种多站点架构
Ceph RADOS 网关支持多站点部署,实现在多个 Ceph 存储集群之间自动复制对象数据。常见的用例是在地理上分隔的集群之间进行主动/主动复制,以便于灾难恢复。
| 架构 | 结构 | 适用 |
|---|---|---|
| multi zone | 域(realm)中具有一个区域组和一个以上的区域 。每个区域由一个或多个 RADOS 网关以及一个独立的 Ceph 存储集群 关联。一个区域中存储的数据复制到该区域组中所有区域 | 区域遭遇灾难性故障时进行灾难恢复 |
| multi zonegroup | 域中有多个区域组,每个区域组具有一个或多个区域 | 管理一个地区中一个或多个区域内 RADOS 网关的地理位置 |
| multi realm | 同一硬件支持不同区域组和区域之间通用的多个对象命名空间 | 硬件复用、多租户隔离 |
最小的 RADOS 网关多站点部署需要满足:
- 两个 Ceph 存储集群,每个集群具有一个 RADOS 网关;
- 它们存在于同一域中,分配到相同的主区域组;
- 一个 RADOS 网关与该区域组中的主区域关联,另一个与该区域组中的独立次要区域关联。
9.2 元数据与数据的同步流程
💡 提示 :RADOS 网关在所有主要区域组和次要区域组集合之间同步元数据和数据操作。 两者的分工是:
- 元数据操作与存储桶相关 :创建、删除、启用和禁用版本控制,以及管理用户 。元主(meta master)位于主区域组中的主区域,负责管理元数据更新;
- 数据操作与对象相关。
多站点之间数据同步流程:
- 多站点初始配置后,RADOS 网关会在主区域和次要区域之间执行一次初始的完整同步,随后的更新是增量更新;
- 当 RADOS 网关将数据写入区域组中任何区域时,它会在其他区域组的所有区域之间同步这一数据。当 RADOS 网关同步数据时,所有活跃的网关会更新数据日志并通知其他网关;
- 当 RADOS 网关因为存储桶或用户操作而同步元数据时,主网关会更新元数据日志并通知其他 RADOS 网关。
⚠️ 重要 :"用户管理必须走主区域"再次出现------因为元数据更新由主区域组的主区域(元主)负责。多站点环境里在次要区域建用户、建桶、改版本控制配置,都可能出现"命令成功但别的站点看不到"的现象。
9.3 配置主集群
bash
# 1) 创建存储域(realm / zonegroup / zone)
[root@ceph1 ~] radosgw-admin realm create --rgw-realm=webapp --default
[root@ceph1 ~] radosgw-admin zonegroup create --rgw-realm=webapp --rgw-zonegroup=video --master --default
[root@ceph1 ~] radosgw-admin zone create --rgw-realm=webapp --rgw-zonegroup=video --rgw-zone=storage1 --master --default
[root@ceph1 ~] radosgw-admin period update --rgw-realm=webapp --commit

# 2) 创建 rgw 服务(3 个实例)
[root@ceph1 ~] ceph orch apply rgw webapp --placement="3 ceph1.laogao.cloud ceph2.laogao.cloud ceph3.laogao.cloud" --realm=webapp --zone=storage1 --port=8080

# 3) 创建用于同步数据的系统用户(注意 --system)
[root@ceph1 ~] radosgw-admin user create --uid=system-user --display-name=system-user --access-key=laogao@123 --secret=Huawei12#$ --system

# 4) 把系统用户绑定给 master zone(--endpoints 列出该区域所有网关地址)
[root@ceph1 ~] radosgw-admin zone modify --rgw-realm=webapp --rgw-zonegroup=video --rgw-zone=storage1 --endpoints 'http://ceph1.laogao.cloud:8080,http://ceph2.laogao.cloud:8080,http://ceph3.laogao.cloud:8080' --access-key=laogao@123 --secret=Huawei12#$ --master --default

# 5) 给每个 RGW 实例配置所属的 realm / zonegroup / zone
[root@ceph1 ~] ceph auth ls 2>/dev/null |grep 'rgw.*ceph'
client.rgw.webapp.ceph1.qqepfc
client.rgw.webapp.ceph2.iculct
client.rgw.webapp.ceph3.xbrkun

[root@ceph1 ~] ceph config set client.rgw.webapp.ceph1.qqepfc rgw_realm webapp
[root@ceph1 ~] ceph config set client.rgw.webapp.ceph1.qqepfc rgw_zonegroup video
[root@ceph1 ~] ceph config set client.rgw.webapp.ceph1.qqepfc rgw_zone storage1
(ceph2、ceph3 上的实例同样三步)

# 6) 提交配置并重启 RGW 服务
[root@ceph1 ~] radosgw-admin period update --commit
[root@ceph1 ~] ceph orch restart rgw.webapp
💡 提示 :
--system创建的是"系统用户" ------它专门用于多站点之间的内部同步,不要拿它当业务用户使用。而zone modify --endpoints里的地址列表就是该区域对外的网关入口清单 ,其他站点靠它找到你;这里写错地址 → 同步一直不通,是最常见的多站点配置故障。
9.4 配置备集群
bash
# 1) 从主集群拉取 realm 配置
[root@ceph4 ~] radosgw-admin realm pull --url=http://ceph1.laogao.cloud:8080 --access-key=laogao@123 --secret=Huawei12#$

# 查看是否获取到 realm 和 zonegroup 信息
[root@ceph4 ~] radosgw-admin realm list
[root@ceph4 ~] radosgw-admin zonegroup list

# 2) 拉取 period 信息
[root@ceph4 ~] radosgw-admin period pull --url=http://ceph1.laogao.cloud:8080 --access-key=laogao@123 --secret=Huawei12#$

# 检查是否获取到
[root@ceph4 ~] radosgw-admin period list
{
    "periods": [
        "df0d2416-7ee9-465c-a1e5-cebd19b7b468"
    ]
}

# 3) 创建非 master 的 zone(storage2)
[root@ceph4 ~] radosgw-admin zone create --rgw-zonegroup=video --rgw-zone=storage2 --endpoints "http://ceph4.laogao.cloud:8080, http://ceph5.laogao.cloud:8080, http://ceph6.laogao.cloud:8080" --access-key=laogao@123 --secret=Huawei12#$

# 4) 创建 RGW 服务
[root@ceph4 ~] ceph orch apply rgw webapp --placement="3 ceph4.laogao.cloud ceph5.laogao.cloud ceph6.laogao.cloud" --realm=webapp --zone=storage2 --port=8080

# 5) 设置各 RGW 实例的信息
[root@ceph4 ~] ceph auth ls 2>/dev/null|grep 'rgw.*ceph'
client.rgw.webapp.ceph4.quzfrg
client.rgw.webapp.ceph5.catzsj
client.rgw.webapp.ceph6.aszklt

[root@ceph4 ~] ceph config set client.rgw.webapp.ceph4.quzfrg rgw_realm webapp
[root@ceph4 ~] ceph config set client.rgw.webapp.ceph4.quzfrg rgw_zonegroup video
[root@ceph4 ~] ceph config set client.rgw.webapp.ceph4.quzfrg rgw_zone storage2
(ceph5、ceph6 同样三步)

# 6) 更新 realm 并重启 RGW 服务
[root@ceph4 ~] radosgw-admin period update --rgw-realm=webapp --commit
[root@ceph4 ~] ceph orch restart rgw.webapp
注意备集群侧的关键差异 :realm pull / period pull 是"从主集群拉配置",zone create 时不带 --master --default (因为它就是次要区域)。"主集群创建、备集群拉取" 是多站点配置的基本节奏。
9.5 验证同步状态
bash
# 查看同步状态
[root@ceph4 ~] radosgw-admin sync status
         realm f1ea35c6-c4b5-46b4-9e4b-62e2c6301217 (webapp)
     zonegroup c4f0f536-6651-43f0-b1f3-a1fbaf55775d (video)
          zone 9d1339a8-6570-4ad6-88de-172cf3899332 (storage2)
 metadata sync syncing
               full sync: 0/64 shards
               incremental sync: 64/64 shards
               metadata is caught up with master
     data sync source: 9366405a-6d9b-4897-97d0-9e139304fe64 (storage1)
                       syncing
                       full sync: 0/128 shards
                       incremental sync: 128/128 shards
                       data is caught up with source
radosgw-admin sync status 的输出要盯三行:
| 关键行 | 含义 |
|---|---|
metadata is caught up with master |
元数据已追平主区域 |
data is caught up with source |
数据已追平来源区域 |
data sync source: ... (storage1) |
数据来自哪个区域 |
对象同步测试:
bash
# 在主集群侧写入对象
[root@client ~] source swift.rc
[root@client ~] swift post dbapp
[root@client ~] swift upload --object-name hosts-from-primary dbapp /etc/hosts

# 在备集群侧查看对象(需要稍微等待几秒)
[root@client ~] source swift-slave.rc
[root@client ~] swift list dbapp
hosts-from-primary
💡 提示 :
swift.rc(主)和swift-slave.rc(备)是两套指向不同区域网关的凭据文件------这是验证"对象真的跨站点复制过来了"的最直接办法:在主站点写入,然后换一套指向备站点的凭据去列,能看到就说明复制链路通了。
9.6 区域故障转移
💡 重要 :在多站点部署中,主区域不可用时,次要区域可以继续为读取和写入请求服务。不过,因为主区域不可用,所以用户无法创建新的存储桶和用户。如果主区域没有立即恢复,则需要对其中一个次要区域升级,以替代主区域。
升级过程三步:
- 将主区域指定为次要区域;
- 更新主区域组端点;
- 提交更改。
bash
# 1) 把 storage2 提升为 master
[root@ceph4 ~] radosgw-admin zone modify --master --rgw-zone=storage2

# 2) 更新区域组端点(指向新主区域的网关入口)
[root@ceph4 ~] radosgw-admin zonegroup modify --rgw-zonegroup=video --endpoints=http://ceph4.laogao.cloud:8080

# 3) 提交更改
[root@ceph4 ~] radosgw-admin period update --commit

# 4) 验证:元数据同步已变为"当前区域就是 master"
[root@ceph4 ~] radosgw-admin sync status
         realm f1ea35c6-c4b5-46b4-9e4b-62e2c6301217 (webapp)
     zonegroup c4f0f536-6651-43f0-b1f3-a1fbaf55775d (video)
          zone 9d1339a8-6570-4ad6-88de-172cf3899332 (storage2)
 metadata sync no sync (zone is master)
     data sync source: 9366405a-6d9b-4897-97d0-9e139304fe64 (storage1)
                       syncing
                       full sync: 0/128 shards
                       incremental sync: 128/128 shards
                       data is caught up with source
注意 metadata sync 那一行从 syncing ... metadata is caught up with master 变成了 no sync (zone is master) ------这就是"我这个区域现在是主"的确证。故障转移的判定标准不是"谁响应用户请求",而是"谁是元主" :次要区域在故障期间能继续读写老数据,但不能创建新桶和新用户,直到完成这次升级。
9.7 radosgw-admin 子命令速查
多站点维护几乎全靠 radosgw-admin 的四个子命令族:
| 子命令族 | 常用操作 |
|---|---|
realm |
create / rm / get / get-default / list / list-periods / rename / set / default / pull |
zonegroup |
create / modify / get / set / delete / rm(把 zone 移出)/ rename / list / default / **`placement list |
zone |
create / modify / get / set / delete / rm |
period |
update --commit / pull / list / get |
💡 提示 :
zonegroup placement *系列用来管理放置目标(placement target) ------它决定"写入的数据落到哪套池"。多站点/多存储类场景下,placement 是把不同站点或不同介质(SSD/HDD)区分开的机制,比直接改 pool 更规整。
十、CephFS 与元数据服务器(MDS)
10.1 CephFS 是什么
Ceph 文件系统(CephFS)构建在 Ceph 存储之上,是一种兼容 POSIX 的文件系统。 与 RBD 和 RGW 类似,CephFS 也是作为 librados 的原生接口来实施。
它的高可用与扩展能力体现在三处:
- Ceph 支持在一个集群中运行多个活动 MDS,以提高元数据性能;
- 为保持高可用性,还可配置备用 MDS,以便在任何活动 MDS 出现故障时接管其任务;
- Ceph 支持在一个集群中部署多个活动的 CephFS 文件系统 ------部署多个 CephFS 文件系统需要运行多个 MDS 守护进程。
10.2 三种存储方式对比
Ceph 同时提供三种存储接口,把它们放在一起对比最容易建立整体认知:
| 存储方式 | 组织方式 | 访问方式 |
|---|---|---|
| 基于文件的存储 | 可以像传统文件系统一样整理用户数据,带有目录树层次结构 。数据保存在文件中,文件有一个名称并包含相关元数据,如修改时间戳、所有者和访问权限 | 挂载成目录,按路径访问 |
| 基于块的存储 | 提供像磁盘一样运作的存储卷,整理到大小相等的区块中 | 块存储卷要么通过文件系统进行格式化 ,要么像数据库一样可直接读写 |
| 基于对象的存储 | 支持将任意数据和元数据作为一个标有唯一标识符的单元 存储在扁平存储池中 | 用户使用 API 来存储和检索数据,不会作为块或在文件系统层次结构中访问数据 |
💡 提示 :一句话概括三者的分界------文件存储管"目录树"、块存储管"扇区"、对象存储管"ID" 。CephFS 的最大价值在于POSIX 兼容:老应用不改一行代码就能把数据放到分布式存储上,这是 RBD 和 RGW 都做不到的。
10.3 元数据服务器(MDS)
MDS 的职责有两条:
- 管理目录层次结构和文件元数据 (如所有者、时间戳和权限模式等),提供 CephFS 客户端访问 RADOS 对象所需的信息;
- 访问客户端缓存,并维护客户端缓存一致性。
MDS 的两种运行模式:
| 模式 | 职责 |
|---|---|
| 活动 MDS | 负责管理 CephFS 文件系统上的元数据 |
| 备用 MDS | 充当备份,并会在活动 MDS 无响应时切换到活动模式 |
⚠️ 重要 :CephFS 文件系统至少需要一个活跃的 MDS 服务,最好再部署一个备用 MDS 以确保可用性。 注意 MDS 承载的是元数据 ------它不存数据,但所有数据访问都要先问它"文件在哪" 。所以 MDS 挂掉的表现不是"数据丢了",而是客户端卡在元数据请求上 (
ceph fs status里能看到 rank 掉线)。
10.4 MDS 的关键配置选项
| 配置项 | 含义 |
|---|---|
| MDS 等级(rank) | 设置集群中活动 MDS 守护进程的最大数量 ,由 max_mds 定义。MDS 守护进程在启动时没有等级,MON 守护进程负责为它们分配 1 个等级,也就是集群中只有一个活动 MDS |
| 文件系统关联性 | 将用户的 CephFS 文件系统配置为首选某一个 MDS 。例如可配置为首选在速度更快的服务器上运行的 MDS。通过 mds_join_fs 选项配置 |
| MDS 缓存大小限制 | mds_cache_memory_limit 限制最大内存;mds_cache_size 定义最大索引节点数,以限制 MDS 缓存的大小 |
| 配额 | 配置 CephFS 文件系统以限制使用的字节数或文件数 。FUSE 和 Kernel 客户端都支持在挂载时检查配额 ,并负责在用户达到配额限值时停止写入数据 。使用 setfattr 命令的 ceph.quota.max_bytes 和 ceph.quota.max_files 选项设置限值 |
卷、子卷和子卷组这三个概念要分清:
| 概念 | 对应关系 |
|---|---|
| CephFS 卷(volume) | 对应一个 CephFS 文件系统 |
| CephFS 子卷(subvolume) | 对应 CephFS 文件系统的子目录 。创建子卷时,用户可指定更细致的权限管理,如子卷的 UID、GID、文件模式、大小和子卷组 |
| CephFS 子卷组(subvolume group) | 对应一组子卷 |
💡 提示 :
max_mds决定"能开几个活动 MDS" ,这就是 CephFS 元数据性能的水平扩展开关------单 MDS 的元数据性能有上限,元数据密集场景(大量小文件、频繁 ls/stat)靠加活动 MDS 来摊。另外注意mds_cache_memory_limit是 MDS 最容易出问题的地方:缓存配小了元数据性能差,配大了容易 OOM,大集群里这个值必须按内存规划给足。
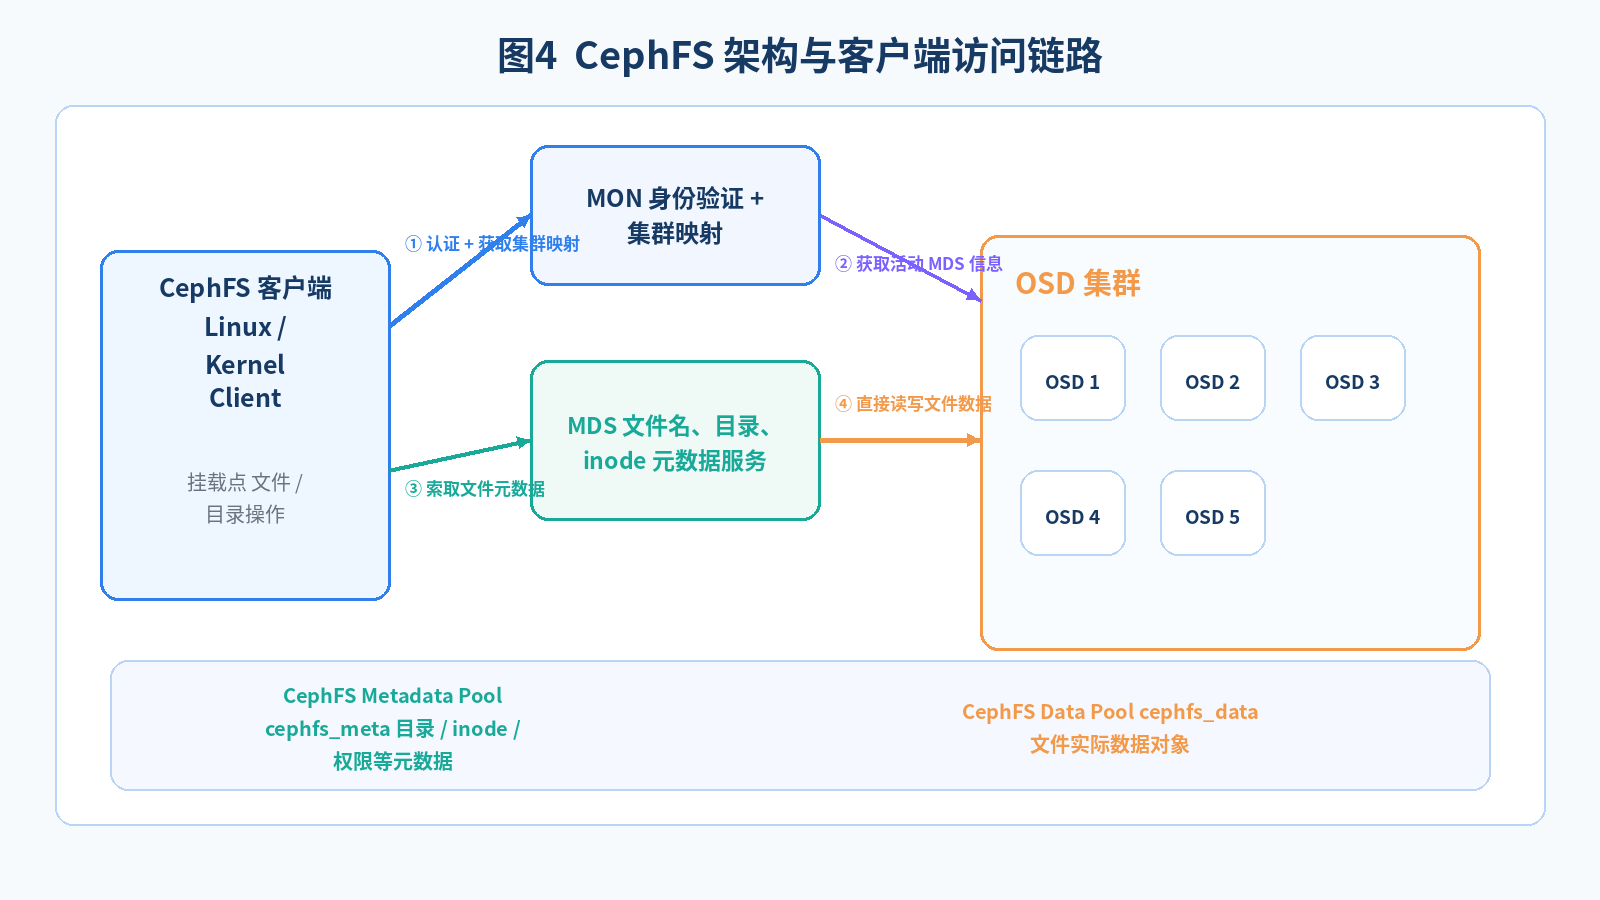
10.5 客户端访问 CephFS 的过程
text
┌──────────────────┐   ① 身份验证 + 取集群映射   ┌──────────────┐
│  CephFS 客户端    │ ─────────────────────────▶ │     MON      │
└──────────────────┘                            └──────────────┘
         │
         │ ② 从集群映射中获取活动 MDS 信息
         ▼
┌──────────────────┐   ③ 索取文件元数据          ┌──────────────────┐
│  活动 MDS         │ ◀────────────────────────  │  CephFS 客户端    │
└──────────────────┘                            └──────────────────┘
                                                          │
                                                          │ ④ 直接与 OSD 通信,
                                                          │    用元数据访问文件或目录
                                                          ▼
                                                ┌──────────────────┐
                                                │   OSD 集群        │
                                                └──────────────────┘
四步拆开看:
- CephFS 客户端首先会联系 MON 进行身份验证并检索集群映射;
- 完成上一步后,客户端从集群映射中获取到活动 MDS 的信息;
- 客户端向活动 MDS 索取文件元数据;
- 然后客户端直接与 OSD 通信,使用元数据来访问文件或目录。
💡 提示 :元数据走 MDS,数据走 OSD------两条路是分开的 。这就是为什么 CephFS 的性能瓶颈经常出现在 MDS 而不是 OSD 上:读一个大文件(元数据少)靠 OSD 吞吐,读一堆小文件(元数据多)全压在 MDS 上 。理解了这一点,"小文件多就加
max_mds"的运维结论就是顺理成章的。
十一、CephFS 的部署、挂载与访问控制
11.1 两种部署方式
| 方式 | 特点 |
|---|---|
| 手动部署 | 步骤多,可以控制每个步骤 ------ 适合需要精细控制池名/复本数/池数量的场景 |
| 卷部署 | 步骤少,简单方便,无法控制每个步骤 ------ 适合快速拉起文件系统 |
11.2 手动部署 CephFS
部署流程三步:1. 创建所需池 → 2. 创建 CephFS 文件系统 → 3. 部署 MDS 守护进程。
⚠️ 重要 :要创建 CephFS 文件系统,首先至少要创建两个池 :一个用于存储 CephFS 数据,另一个用于存储 CephFS 元数据 ,默认名称分别为
cephfs_data和cephfs_meta。而元数据池用于存储文件的位置信息,所以要为此池设置更高的复本级别 ------避免出现数据错误导致数据无法访问。CephFS 默认使用复制数据池,也支持使用纠删代码数据池。
bash
# 1) 创建数据池和元数据池
[root@ceph1 ~] ceph osd pool create cephfs.cephfs1.data.1
[root@ceph1 ~] ceph osd pool create cephfs.cephfs1.meta

# 元数据池单独提高复本级别
[root@ceph1 ~] ceph osd pool set cephfs.cephfs1.meta size 3

# 2) 创建文件系统(meta 池在前,data 池在后)
[root@ceph1 ~] ceph fs new cephfs1 cephfs.cephfs1.meta cephfs.cephfs1.data.1

# 3) 追加一个数据池(同一文件系统可以有多个 data 池)
[root@ceph1 ~] ceph osd pool create cephfs.cephfs1.data.2
[root@ceph1 ~] ceph fs add_data_pool cephfs1 cephfs.cephfs1.data.2

# 4) 部署 MDS 服务(3 个实例,一主两备)
[root@ceph1 ~] ceph orch apply mds cephfs1 --placement="3 ceph1.laogao.cloud ceph2.laogao.cloud ceph3.laogao.cloud"

# 查看文件系统清单
[root@ceph1 ~] ceph fs ls
name: cephfs1, metadata pool: cephfs.cephfs1.meta, data pools:
[cephfs.cephfs1.data.1 cephfs.cephfs1.data.2 ]
💡 提示 :
ceph fs new <fs-name> <metadata-pool> <data-pool>的参数顺序是"先元数据、后数据" ,写反了会直接报错。另外注意一个文件系统可以挂多个 data 池 (ceph fs add_data_pool),但只有一个 metadata 池------这正好对应"元数据集中、数据分散"的设计。
11.3 验证部署状态
bash
# 文件系统状态
[root@ceph1 ~] ceph fs status
cephfs1 - 0 clients
=======
RANK  STATE           MDS              ACTIVITY     DNS    INOS   DIRS   CAPS
 0    active  cephfs1.ceph1.hazpoq  Reqs:    0 /s    10     13     12      0
         POOL            TYPE     USED  AVAIL
 cephfs.cephfs1.meta   metadata  96.0k  56.1G
cephfs.cephfs1.data.1    data       0   56.1G
cephfs.cephfs1.data.2    data       0   56.1G
    STANDBY MDS
cephfs1.ceph3.kjpzae
cephfs1.ceph2.fdudvc
MDS version: ceph version 16.2.15 (618f440892089921c3e944a991122ddc44e60516) pacific (stable)

# 池空间使用状态
[root@ceph1 ~] ceph df
--- RAW STORAGE ---
CLASS     SIZE    AVAIL     USED  RAW USED  %RAW USED
hdd    180 GiB  177 GiB  2.6 GiB   2.6 GiB       1.42
TOTAL  180 GiB  177 GiB  2.6 GiB   2.6 GiB       1.42
--- POOLS ---
POOL                   ID  PGS   STORED  OBJECTS    USED  %USED  MAX AVAIL
device_health_metrics   1    1      0 B        0     0 B      0     56 GiB
cephfs.cephfs1.data.1   3   32      0 B        0     0 B      0     56 GiB
cephfs.cephfs1.meta     4   32  2.3 KiB       22  96 KiB      0     56 GiB
cephfs.cephfs1.data.2   5   32      0 B        0     0 B      0     56 GiB

# MDS 服务状态
[root@ceph1 ~] ceph mds stat
cephfs1:1 {0=cephfs1.ceph1.hazpoq=up:active} 2 up:standby

# MDS 守护进程
[root@ceph1 ~] ceph orch ls mds
NAME         PORTS  RUNNING  REFRESHED  AGE  PLACEMENT
mds.cephfs1             3/3  6m ago     6m   ceph1.laogao.cloud;ceph2.laogao.cloud;ceph3.laogao.cloud;count:3
这里有三条输出要会读:
| 输出 | 含义 |
|---|---|
1 {0=cephfs1.ceph1.hazpoq=up:active} 2 up:standby |
1 个 rank 处于 active,2 个备用------这就是"一主两备"的健康形态 |
.meta 池 OBJECTS 22 而 data 池全是 0 |
元数据是真实占用空间的,即使文件系统里没有数据,目录树本身也要存元数据 |
RANK 0 STATE active |
rank 就是 MDS 的"等级",活动 MDS 数量由 max_mds 决定 |
11.4 删除 CephFS
删除流程三步:1. 删除服务 → 2. 删除文件系统 → 3. 删除池。
bash
# 1) 删除 MDS 服务
[root@ceph1 ~] ceph orch rm mds.cephfs1
Removed service mds.cephfs1

# 2) 删除 CephFS:先标记为 down,再删除
[root@ceph1 ~] ceph fs set cephfs1 down true
cephfs1 marked down.
[root@ceph1 ~] ceph fs rm cephfs1 --yes-i-really-mean-it

# 3) 删除池(记得先打开总闸)
[root@ceph1 ~] ceph config set mon mon_allow_pool_delete true
[root@ceph1 ~] ceph osd pool rm cephfs.cephfs1.meta cephfs.cephfs1.meta --yes-i-really-really-mean-it
[root@ceph1 ~] ceph osd pool rm cephfs.cephfs1.data.1 cephfs.cephfs1.data.1 --yes-i-really-really-mean-it
[root@ceph1 ~] ceph osd pool rm cephfs.cephfs1.data.2 cephfs.cephfs1.data.2 --yes-i-really-really-mean-it
⚠️ 重要 :如果需要删除 CephFS,请先备份所有数据,因为删除 CephFS 文件系统会破坏该文件系统上存储的所有数据。 注意顺序:先
fs set ... down true才能fs rm------这是 Ceph 防误删的设计,和池的mon_allow_pool_delete是同一思路。
11.5 卷部署(更省事的方式)
bash
# 一条命令创建文件系统 + 元数据池 + 数据池 + MDS 服务
[root@ceph1 ~] ceph fs volume create cephfs2 --placement="3 ceph1.laogao.cloud ceph2.laogao.cloud ceph3.laogao.cloud"

# 查看文件系统清单
[root@ceph1 ~] ceph fs ls
name: cephfs2, metadata pool: cephfs.cephfs2.meta, data pools:
[cephfs.cephfs2.data ]

# 查看卷
[root@ceph1 ~] ceph fs volume ls
[
    {
        "name": "cephfs2"
    }
]

# 删除卷(连池一起删)
[root@ceph1 ~] ceph fs volume rm cephfs2 --yes-i-really-mean-it
metadata pool: cephfs.cephfs2.meta data pool: ['cephfs.cephfs2.data'] removed
[root@ceph1 ~] ceph fs ls
No filesystems enabled

# 用卷方式再建两个文件系统
[root@ceph1 ~] ceph fs volume create cephfs1 --placement="3 ceph1.laogao.cloud ceph2.laogao.cloud ceph3.laogao.cloud"
[root@ceph1 ~] ceph fs volume create cephfs2 --placement="3 ceph1.laogao.cloud ceph2.laogao.cloud ceph3.laogao.cloud"
💡 提示 :
ceph fs volume create一条命令就把池名(cephfs.<name>.meta/.data)、文件系统和 MDS 服务全建好了 ;ceph fs volume rm --yes-i-really-mean-it也能连池一起清理 ------比手动路线少踩很多坑。代价是池名、复本数、PG 数都按默认值来,需要定制(比如元数据池单独提复本到 3、给数据池换纠删码)时,还是得走手动路线。
11.6 两种挂载方式:Kernel 与 FUSE
| 挂载方式 | 要求 | 优缺点 |
|---|---|---|
| Kernel 挂载 | Linux 内核版本达到 4 或以上 ,从 RHEL 8 开始可用;之前的内核版本请改用 FUSE 客户端 | 不支持配额,但速度可能较快 |
| FUSE 挂载 | 需要额外安装 ceph-fuse |
支持配额和 ACL ;ACL 功能需要在挂载时明确指定该功能以启用 |
⚠️ 重要 :"Kernel 不支持配额、FUSE 支持配额和 ACL"是选型的关键分水岭。 需要给用户/目录做容量限额,就必须用 FUSE(或者用 Kernel 挂载但接受配额检查不生效)。这也是"我明明设了
ceph.quota.max_bytes但用户还能写"的常见根因------你用的是 Kernel 客户端。
11.7 授权挂载用户:ceph fs authorize
通过 ceph fs authorize 命令,可为 CephFS 文件系统中的不同用户和文件夹提供精细的访问控制。 CephFS 支持四种访问选项:
| 选项 | 含义 |
|---|---|
r |
对指定文件夹的读取 权限。如果未指定其他限制,则会向子文件夹授予读取权限 |
w |
对指定文件夹的写入权限。同样会向子文件夹授予写入权限 |
p |
除了 r 和 w 功能外,客户端还需要 p 选项才能使用布局或配额 |
s |
除了 r 和 w 功能外,客户端还需要 s 选项才能创建快照 |
bash
# 示例1:允许用户对 / 文件夹具备读取、写入、配额和快照权限,并保存用户凭据
[root@ceph1 ~] ceph fs authorize cephfs1 client.cephfs1-all-user / rwps > /etc/ceph/ceph.client.cephfs1-all-user.keyring

# 示例2:允许用户读取 / 文件夹,并提供对 /dir2 文件夹的读取、写入,并保存用户凭据
[root@ceph1 ~] ceph fs authorize cephfs1 client.cephfs1-restrict-user / r /dir2 rw > /etc/ceph/ceph.client.cephfs1-restrict-user.keyring
💡 提示 :
p和s是最容易被漏掉的两个权限 ------权限里只给rw的话,用户能读写文件但配额和快照都不可用 ,报错却不直观。要配额就加p,要快照就加s。注意命令的最后一个参数就是输出格式:直接重定向到/etc/ceph/ceph.client.<user>.keyring就完成"建用户 + 发密钥环"两步。
11.8 客户端挂载准备
要挂载基于 CephFS 的文件系统,客户端主机必须满足三个条件:
- 安装
ceph-common软件包 ;对于 FUSE 客户端,还要安装ceph-fuse软件包; - 复制 Ceph 配置文件到客户端;
- 将用户 keyring 复制到客户端主机上的
/etc/ceph文件夹。
bash
[root@client ~] dnf install -y ceph-common
[root@ceph1 ~] scp /etc/ceph/ceph.conf root@client:/etc/ceph/ceph.conf
[root@ceph1 ~] scp /etc/ceph/ceph.client.{cephfs1-all-user,cephfs1-restrict-user}.keyring root@client:/etc/ceph/

# 为了方便管理集群,我们还会把 admin 凭据复制到 client
[root@ceph1 ~] scp /etc/ceph/ceph.client.admin.keyring root@client:/etc/ceph/
⚠️ 注意 :把
ceph.client.admin.keyring拷到客户端只是为了实验方便 ,生产环境应该只分发该客户端真正需要的那一个受限用户的密钥环(上例中的cephfs1-restrict-user)。
11.9 用 Kernel 客户端挂载
text
mount.ceph [src] [mount-point] [-n] [-v] [-o ceph-options]
或者
mount -t ceph [src] [mount-point] [-n] [-v] [-o ceph-options]
💡 提示 :用户可以指定逗号分隔的多个 MON 来挂载设备 。标准端口(6789)为默认值,也可以在各个 MON 名称后面添加冒号和非标准端口号。建议指定多个 MON,以防文件系统挂载时有些 MON 处于脱机状态。
Kernel 客户端的可用选项:
| 选项 | 含义 |
|---|---|
fs=fs-name |
指定要挂载的 CephFS 文件系统名称。未提供值时,它会使用默认文件系统 |
name=name |
指定 Cephx 客户端 ID。默认为 guest |
secret=secret_value |
指定客户端的机密密钥的值 |
secretfile=secret_key_file |
指定包含此客户端机密密钥的文件的路径 |
rsize=bytes |
指定最大读取大小(字节) |
wsize=bytes |
指定最大写入大小(字节)。默认为不写入 |
示例1:使用不受限账户挂载,并实测 3 副本的空间开销
bash
[root@client ~] mount.ceph
usage: mount.ceph [src] [mount-point] [-n] [-v] [-o ceph-options]
options:
    -h: Print this help
    -n: Do not update /etc/mtab
    -v: Verbose
    ceph-options: refer to mount.ceph(8)

[root@client ~] mkdir /mnt/cephfs1
[root@client ~] mount.ceph ceph1.laogao.cloud:/ /mnt/cephfs1 -o name=cephfs1-all-user,fs=cephfs1
[root@client ~] df -h /mnt/cephfs1
Filesystem        Size  Used Avail Use% Mounted on
192.168.108.11:/   57G     0   57G   0% /mnt/cephfs1

# 写入数据
[root@client ~] mkdir /mnt/cephfs1/{dir1,dir2}
[root@client ~] echo Hello World > /mnt/cephfs1/dir1/welcome.txt
[root@client ~] dd if=/dev/zero of=/mnt/cephfs1/dir1/file-100M bs=1M count=100
[root@client ~] tree /mnt/cephfs1
/mnt/cephfs1
├── dir1
│   ├── file-100M
│   └── welcome.txt
└── dir2
2 directories, 2 files

# 3 副本池:创建 100M 文件,文件系统空间减少 100M
[root@client ~] df -h /mnt/cephfs1
Filesystem        Size  Used Avail Use% Mounted on
192.168.108.11:/ 57G 100M 56G 1% /mnt/cephfs1关键对比------从集群侧看同一份数据占了多少:
bash
# 3 副本池:创建 100M 文件,cephfs data 池实际占用 300M
[root@client ~] ceph fs status             # ceph df 也可以看
cephfs1 - 1 clients
=======
RANK  STATE           MDS              ACTIVITY     DNS    INOS   DIRS   CAPS
 0    active  cephfs1.ceph1.hpwqgm  Reqs:    0 /s    14     17     14      5
        POOL           TYPE     USED  AVAIL
cephfs.cephfs1.meta  metadata   192k  55.9G
cephfs.cephfs1.data    data     300M  55.9G
💡 提示 :同一个 100M 文件,
df看是 100M,集群侧 data 池看是 300M ------ 这不是 bug,而是客户端看到的是文件系统语义的容量,集群侧看到的是 3 副本的原始占用 。做容量规划时必须按集群侧算 (3 副本就是 3 倍),否则会严重误判。顺带注意元数据池从 96.0k 涨到 192k ------新增目录/文件本身也会消耗元数据空间。
示例2:使用受限账户挂载,验证权限边界
bash
# 卸载后用受限账户重新挂载
[root@client ~] umount /mnt/cephfs1
[root@client ~] mount.ceph ceph1.laogao.cloud:/ /mnt/cephfs1 -o name=cephfs1-restrict-user,fs=cephfs1

# 验证权限:dir1 只读 → 被拒
[root@client ~] touch /mnt/cephfs1/dir1/cephfs1-restrict-user-file1
touch: cannot touch '/mnt/cephfs1/dir1/cephfs1-restrict-user-file1': Permission denied

# dir2 可读写 → 成功
[root@client ~] touch /mnt/cephfs1/dir2/cephfs1-restrict-user-file1
[root@client ~] tree /mnt/cephfs1/
/mnt/cephfs1/
├── dir1
│   ├── file-100M
│   └── welcome.txt
└── dir2
    └── cephfs1-restrict-user-file1
2 directories, 3 files
💡 提示 :这条验证非常值得亲手做一遍------同一个文件系统、同一个挂载点,只换
name=参数,权限行为就完全不同 。这就是ceph fs authorize <fs> <client> / r /dir2 rw里"路径 + 权限"组合在起作用。生产上给不同团队发不同的 keyring,就能实现目录级隔离,而不用拆多个文件系统。
11.10 挂载特定子目录与永久挂载
挂载子目录 (通过 Kernel 客户端,从 root 中挂载 /dir2):
bash
[root@client ~] mount -t ceph ceph1.laogao.cloud:/dir2 /mnt/cephfs1 -o name=cephfs1-restrict-user,fs=cephfs1
[root@client ~] touch /mnt/cephfs1/cephfs1-restrict-user-file2
[root@client ~] tree /mnt/cephfs1/
/mnt/cephfs1/
├── cephfs1-restrict-user-file1
└── cephfs1-restrict-user-file2
0 directories, 2 files

# 卸载
[root@client ~] umount /mnt/cephfs1注意挂载点里的内容变了:/dir2 现在成了挂载点的根 ,原来在 dir2 里的两个文件直接出现在挂载点下。这在"把某个团队的目录单独挂给他们"的场景里非常实用------用户看到的根就是自己的目录,不需要在深层路径里找。
永久挂载 (Kernel 客户端,写 /etc/fstab):
text
ceph1.laogao.cloud:/dir2 /mnt/cephfs1 ceph name=cephfs1-restrict-user,fs=cephfs1,_netdev 0 0⚠️ 重要 :
_netdev挂载选项不能省 ------它告诉系统"这是网络设备,等网络就绪后再挂载",否则可能因为开机时网络尚未就绪而挂载失败;name=与fs=也要和挂载时保持一致。
11.11 用 FUSE 客户端挂载
非 root 用户使用 FUSE 客户端时,需在 /etc/fuse.conf 配置文件中添加 user_allow_other。安装与使用:
bash
# 卸载之前挂载的
[root@client ~] umount /mnt/cephfs1

# 安装 FUSE 客户端
[root@client ~] dnf install -y ceph-fuse

[root@client ~] ceph-fuse --help
usage: ceph-fuse [-n client.username] [-m mon-ip-addr:mon-port] <mount point> [OPTIONS]
  --client_mountpoint/-r <sub_directory>
                    use sub_directory as the mounted root, rather than the full Ceph tree.
ceph-fuse 的常用选项:
| 选项 | 作用 |
|---|---|
-r, --client_mountpoint <sub_directory> |
把子目录作为挂载的根,而不是整个 Ceph 树 |
-o clone_fd |
为每个线程使用独立的 fuse 设备 fd(可能提升性能) |
-o max_idle_threads |
允许的最大空闲工作线程数(默认 10) |
-o allow_other |
允许所有用户访问 |
-o allow_root |
允许 root 访问 |
-o auto_unmount |
进程终止时自动卸载 |
--conf/-c FILE |
读取指定的配置文件 |
--id ID |
设置名称中的 ID 部分 |
--name/-n TYPE.ID |
设置名称 |
挂载示例:
bash
# 使用 FUSE 客户端挂载 CephFS(指定受限用户)
[root@client ~] ceph-fuse -n client.cephfs1-restrict-user /mnt/cephfs1
ceph-fuse[14462]: starting ceph client
ceph-fuse[14462]: starting fuse

[root@client ~] tree /mnt/cephfs1
/mnt/cephfs1
├── dir1
│   ├── file-100M
│   └── welcome.txt
└── dir2
    ├── cephfs1-restrict-user-file1
    └── cephfs1-restrict-user-file2
2 directories, 4 files

# 卸载
[root@client ~] umount /mnt/cephfs1
💡 提示 :
ceph-fuse默认挂载整个文件系统的 root(对应 Kernel 挂载的ceph1.laogao.cloud:/) ,要挂子目录就用-r /dir2。FUSE 与 Kernel 客户端可以同时挂在不同的挂载点上 ,排查"这个内核版本支不支持"最快的方式就是先试 FUSE------能用 FUSE 就说明集群侧和权限都没问题,问题在客户端内核。
十二、CephFS 快照与跨集群镜像同步
12.1 快照藏在 .snap 里
CephFS 默认会启用快照功能,这些快照存储在名为 .snap 的隐藏目录中。 这一点与 RBD 快照完全不同------RBD 快照是"对镜像的只读副本",而 CephFS 快照是"在目录树里多出来的一棵隐藏子树"。
启停快照功能:
bash
# 停用特定 CephFS 文件系统的快照功能
[root@ceph1 ~] ceph fs set cephfs1 allow_new_snaps false
disabled new snapshots

# 启用
[root@ceph1 ~] ceph fs set cephfs1 allow_new_snaps true
enabled new snapshots
12.2 创建快照:在 .snap 下建一个目录
💡 提示 :若要创建快照,就在
.snap目录中创建一个子目录,快照名称就是新子目录的名称。此快照包含 CephFS 文件系统中所有当前文件的副本。
bash
# 普通用户是没有创建快照权限的 ------ 会直接失败
[root@client ~] mkdir /mnt/cephfs1/.snap/snap
mkdir: cannot create directory '/mnt/cephfs1/.snap/snap': Permission denied为什么被拒?看权限就明白了:
bash
[root@client ~] ceph auth get client.cephfs1-restrict-user
[client.cephfs1-restrict-user]
        key = AQAWEK1owPSzMhAACJqg9ZF8FBv28UdwTdEu4Q==
        caps mds = "allow r fsname=cephfs1, allow rw fsname=cephfs1 path=/dir2"
        caps mon = "allow r fsname=cephfs1"
        caps osd = "allow rw tag cephfs data=cephfs1"
exported keyring for client.cephfs1-restrict-user
注意 caps mds 里只有 allow r 和 allow rw ------没有 s,所以不能创建快照 。这正是第 11.7 节讲的"s 选项才能创建快照"的实证。
授权客户端 s 权限后再试:
bash
[root@client ~] ceph auth caps client.cephfs1-restrict-user \
mds "allow r fsname=cephfs1, allow rws fsname=cephfs1 path=/dir2" \
mon "allow r fsname=cephfs1" \
osd "allow rw tag cephfs data=cephfs1"

# 重新挂载(权限变更后要重挂)
[root@client ~] umount /mnt/cephfs1
[root@client ~] mount.ceph ceph1.laogao.cloud:/dir2 /mnt/cephfs1 -o name=cephfs1-restrict-user

# 创建快照成功
[root@client ~] mkdir /mnt/cephfs1/.snap/snap
[root@client ~] ls /mnt/cephfs1/.snap/snap/
cephfs1-restrict-user-file1  cephfs1-restrict-user-file2
⚠️ 重要 :权限变更后必须重新挂载才生效 ------
ceph auth caps改的是服务端的 caps,但已建立的客户端会话还持有旧的授权信息 。所以"我明明加了s权限却还是不能建快照"的根因,多半是没重新挂载。注意rws(多了s)与挂载点路径/dir2是一致的。
12.3 从快照恢复文件与删除快照
💡 提示 :要恢复文件,可将其从快照目录复制到另一常规目录中。若要从
.snap目录树中完整恢复快照,可将普通条目替换为所选快照中的副本。
bash
# 恢复单个文件
[root@client ~] mkdir /restore
[root@client ~] cp /mnt/cephfs1/.snap/snap/cephfs1-restrict-user-file1 /restore/

# 整棵快照树恢复
[root@client ~] rsync -a /mnt/cephfs1/.snap/snap/ /restore/

# 删除快照:在 .snap 中删除对应目录即可
[root@client ~] rmdir /mnt/cephfs1/.snap/snap/
💡 提示 :即使快照目录不为空,
rmdir命令也会成功,无需使用递归rm------ 这是 CephFS 快照很特别的一点:"删除一个非空目录"在普通文件系统里是不可能的,但对快照目录是合法且安全的 ,因为它删的只是快照这个引用。反过来说,这也意味着rmdir一个快照目录的破坏力远小于rm -rf------别把两者搞混。
12.4 CephFS Mirror:文件系统级跨集群复制
CephFS Mirror 是 CephFS 的一个关键功能,用于在两个或多个 Ceph 集群之间实现文件系统的异步复制(镜像),主要用于灾难恢复和数据备份。 该功能从 Ceph Pacific(v16.2.0)版本开始支持。
主要特点:
| 特点 | 说明 |
|---|---|
| 异步复制 | 数据会定期从源集群复制到目标集群 |
| 基于快照 | 依赖 CephFS 的快照功能,通过快照捕获文件系统的变化并复制到目标集群 |
| 多集群支持 | 支持将数据从一个 CephFS 集群复制到多个目标集群 |
| 增量复制 | 仅复制文件系统中发生变化的部分,减少带宽和存储开销 |
实施前提:
- 源集群和目标集群都必须运行 Ceph Pacific(v16.2.0)或更高版本;
- 需要在源集群和目标集群上配置 CephFS 文件系统;
- 需要在源集群和目标集群之间建立可靠的网络连接。
⚠️ 重要 :CephFS Mirror 是"基于快照的异步复制" ------这一点决定了它的 RPO:能恢复到的是"最近一个已完成同步的快照",不是"最近一秒写入的数据"。做容灾方案时要按这个语义定 SLA。
12.5 同步原理
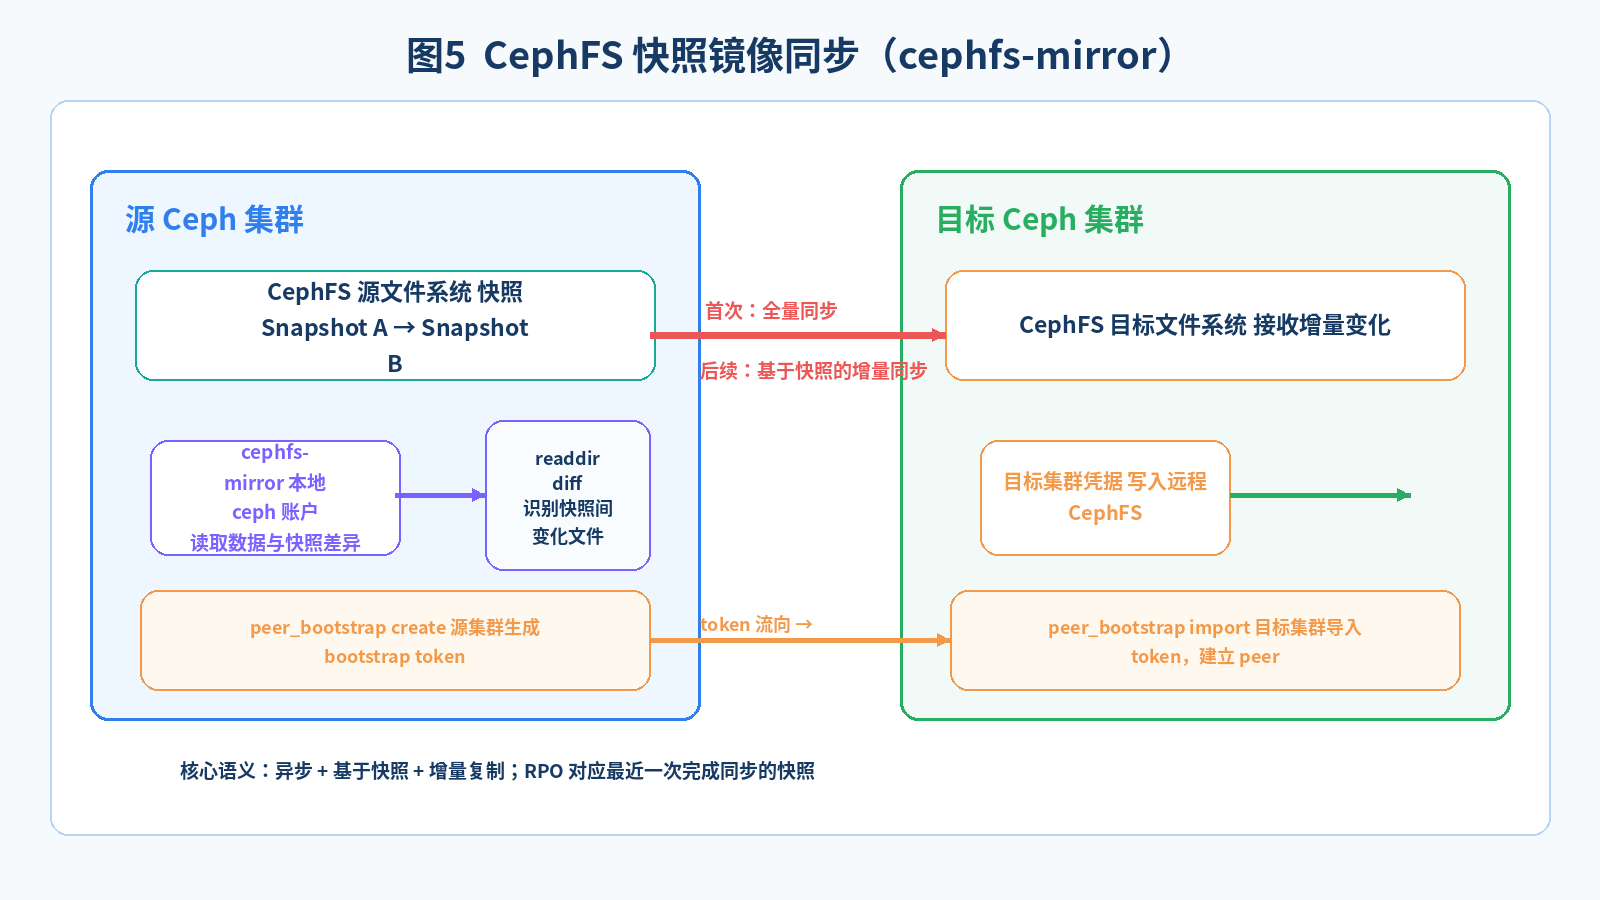
💡 提示 :源集群守护进程
ceph-mirror使用自己的 ceph 账户,读取自己集群中的 cephfs 数据,然后使用目标集群的账户凭据将自己集群中 cephfs 变更数据写入目标集群。
CephFS 镜像功能基于快照实现:
- 第一次快照同步,需要将数据从源集群批量传输到远程集群;
- 然后,镜像守护进程识别本地快照之间修改的文件,并将这些修改的文件同步到远程集群;
- 对于目录中给定的快照,
cephfs-mirror守护进程将依赖readdir diff来识别目录树中的更改 。差异应用于远程文件系统中的目录,从而仅同步两个快照之间已更改的文件。
💡 提示 :
readdir diff是"增量"的技术核心 ------它不扫内容,而是靠目录项的差异 快速找出变化。这意味着海量小文件的场景下,目录规模的膨胀会直接影响镜像效率 ,规划时要把.snap的快照数量和目录层级一起考虑进去。
12.6 配置 CephFS Mirror 的九个步骤
| 步骤 | 操作 |
|---|---|
| 1 | 在源集群上部署 CephFS 镜像守护进程 (会创建 cephfs-mirror Ceph 用户) |
| 2 | 在目标集群上创建 Ceph 用户 |
| 3 | 在源集群上启用 mirroring 模块 |
| 4 | 在源集群特定文件系统上启用 mirroring 功能 |
| 5 | 在目标集群上启用 mirroring 模块 |
| 6 | 在目标集群节点上创建对等引导(peer bootstrap) |
| 7 | 在源集群上导入目标集群创建的引导令牌 |
| 8 | 在源集群上指定需要快照镜像的目录 |
| 9 | 客户端挂载验证 |
逐步实操:
bash
# 环境准备:源集群(ceph1)和目标集群(ceph4)各创建一个 CephFS
[root@ceph1 ~] ceph fs volume create cephfs --placement="1 ceph1.laogao.cloud"
[root@ceph4 ~] ceph fs volume create cephfs --placement="1 ceph4.laogao.cloud"

# 1) 在源集群上部署 CephFS 镜像守护进程
[root@ceph1 ~] ceph orch apply cephfs-mirror ceph1.laogao.cloud
Scheduled cephfs-mirror update...
[root@ceph1 ~] ceph orch ls cephfs-mirror
NAME           RUNNING  REFRESHED  AGE  PLACEMENT
cephfs-mirror      1/1  11s ago    18s  ceph1.laogao.cloud

# 部署会创建一个 cephfs-mirror Ceph 用户
[root@ceph1 ~] ceph auth ls | grep cephfs-mirror
installed auth entries:
client.cephfs-mirror.ceph1.yuxcon
        caps: [mon] profile cephfs-mirror
[root@ceph1 ~] ceph auth get client.cephfs-mirror.ceph1.yuxcon
[client.cephfs-mirror.ceph1.yuxcon]
        key = AQChjK1oOu2WNRAAX7ZFmilo3IMq+/X+K1TWrA==
        caps mds = "allow r"
        caps mgr = "allow r"
        caps mon = "profile cephfs-mirror"
        caps osd = "allow rw tag cephfs metadata=*, allow r tag cephfs data=*"
exported keyring for client.cephfs-mirror.ceph1.yuxcon

# 2) 在目标集群上创建 Ceph 用户(注意权限 rwps)
[root@ceph4 ~] ceph fs authorize cephfs client.cephfs-mirror / rwps
[client.cephfs-mirror]
        key = AQDpjq1ohezRExAA/x2+xHvjgFQm4SJOllbShw==
[root@ceph4 ~] ceph auth get client.cephfs-mirror
[client.cephfs-mirror]
        key = AQDpjq1ohezRExAA/x2+xHvjgFQm4SJOllbShw==
        caps mds = "allow rwps fsname=cephfs"
        caps mon = "allow r fsname=cephfs"
        caps osd = "allow rw tag cephfs data=cephfs"
exported keyring for client.cephfs-mirror

# 3~5) 两边都启用 mirroring 模块;源集群再对文件系统启用镜像
[root@ceph1 ~] ceph mgr module enable mirroring
[root@ceph1 ~] ceph fs snapshot mirror enable cephfs
[root@ceph4 ~] ceph mgr module enable mirroring

# 6) 目标集群创建对等引导(生成 token)
[root@ceph4 ~] ceph fs snapshot mirror peer_bootstrap create cephfs client.cephfs-mirror backup
{"token": "eyJmc2...c3lzdGVtIjogImNlcGhmcyIsICJ1c2VyIjogImNsaWVudC5jZXBoZnMtbWlycm9yIiwgInNpdGVfbmFtZSI6ICJiYWNrdXAiLCAia2V5IjogIkFRRHBqcTFvaGV6UkV4QUEveDIreEh2amdGUW00U0pPbGxiU2h3PT0iLCAibW9uX2hvc3QiOiAiW3YyOjE5Mi4xNjguMTA4LjE0OjMzMDAvMCx2MToxOTIuMTY4LjEwOC4xNDo2Nzg5LzBdIFt2MjoxOTIuMTY4LjEwOC4xNTozMzAwLzAsdjE6MTkyLjE2OC4xMDguMTU6Njc4OS8wXSBbdjI6MTkyLjE2OC4xMDguMTY6MzMwMC8wLHYxOjE5Mi4xNjguMTA4LjE2OjY3ODkvMF0ifQ=="}

# 7) 源集群导入该 token
[root@ceph1 ~] ceph fs snapshot mirror peer_bootstrap import cephfs eyJmc2...3lzdGVtIjog...0ifQ==
{}

# 查看文件系统对端清单
[root@ceph1 ~] ceph fs snapshot mirror peer_list cephfs
{"89e201c4-b3f8-48d4-a647-66e5f4d0948b": {"client_name": "client.cephfs-mirror", "site_name": "backup", "fs_name": "cephfs", "mon_host": "[v2:192.168.108.14:3300/0,v1:192.168.108.14:6789/0] [v2:192.168.108.15:3300/0,v1:192.168.108.15:6789/0] [v2:192.168.108.16:3300/0,v1:192.168.108.16:6789/0]"}}

# 8) 指定需要快照镜像的目录
[root@ceph1 ~] ceph fs snapshot mirror add cephfs /webapp
{}
peer_bootstrap create 的三个参数含义:
| 参数 | 含义 |
|---|---|
fs_name |
目标 cephfs 文件系统名称 |
client_entity |
目标集群的 Ceph 账户,用来同步远端的 CephFS |
site_name |
用户自定义的目标集群名称 (本例 backup) |
而导入侧的语法是 ceph fs snapshot mirror peer_bootstrap import <source_fs_name> <token>,其中 source_fs_name 是源 cephfs 文件系统名称,token 是目标集群创建的 token 字符串。
💡 提示 :注意"谁生成 token、谁导入 token"的方向 :目标集群(backup)生成、源集群导入 。这一点很容易记反------记住"是被同步的一方给出凭据,同步的一方拿着它去写 "就顺了。另外 token 里编码了目标集群的
mon_host列表和client.cephfs-mirror的密钥,所以它本身就是敏感凭据,不能公开。
12.7 挂载验证同步结果
bash
# 源集群:写入数据
[root@ceph1 ~] mkdir /mnt/cephfs1
[root@ceph1 ~] mount.ceph ceph1.laogao.cloud:/ /mnt/cephfs1 -o name=admin
[root@ceph1 ~] mkdir /mnt/cephfs1/webapp
[root@ceph1 ~] echo hello world > /mnt/cephfs1/webapp/index.html

# 目标集群:查看是否同步过来
[root@ceph4 ~] mkdir /mnt/cephfs1
[root@ceph4 ~] mount.ceph ceph4.laogao.cloud:/ /mnt/cephfs1 -o name=admin
[root@ceph4 ~] ls /mnt/cephfs1/
webapp
目标集群里出现了 webapp 目录 ------ 这就是 CephFS 快照镜像链路打通的最终证据:源集群创建一个目录并写入文件,目标集群无需任何客户端配置就能看到它。
十三、验证测试、排障指南与最佳实践
13.1 环境与前置条件
本篇涉及两套 Ceph 集群(对象存储多站点与 CephFS 镜像都需要):
| 主机名 | IP 地址 | 角色 |
|---|---|---|
| client.laogao.cloud | 192.168.108.10 | 客户端(S3 / Swift / CephFS 挂载) |
| ceph1 / ceph2 / ceph3 | 192.168.108.11 / .12 / .13 | prod 集群:MON / MGR / OSD / RGW / MDS |
| ceph4 / ceph5 / ceph6 | 192.168.108.14 / .15 / .16 | backup 集群:MON / MGR / OSD / RGW / MDS |
| 项目 | 配置 |
|---|---|
| RGW 服务 | rgw.webapp,realm=webapp,zone=storage1/storage2,端口 8080 |
| 网关用户 | operator(access=12345 / secret=67890)、子用户 operator:swift、swift:swift_rgw |
| S3 客户端 | awscli(~/.aws,--profile 支持多凭据) |
| Swift 客户端 | python-swiftclient 4.7.0(swift.rc / swift-slave.rc) |
| CephFS | cephfs1、cephfs2,MDS 3 实例(一主两备) |
| 集群 fsid(prod) | 2faf683a-7cbf-11f0-b5ba-000c29e0ad0e |
13.2 验证测试
测试1:网关是否就绪
bash
[root@ceph1 ~] curl http://ceph1.laogao.cloud:8080
<?xml version="1.0" encoding="UTF-8"?><ListAllMyBucketsResult xmlns="http://s3.amazonaws.com/doc/2006-03-01/"><Owner><ID>anonymous</ID><DisplayName></DisplayName></Owner><Buckets></Buckets></ListAllMyBucketsResult>判定标准:返回 ListAllMyBucketsResult 的 XML 即通过。三个网关节点都验证一遍,确认多实例都被正确部署。
测试2:S3 端到端 + ACL 边界
bash
[root@client ~] aws --endpoint=http://ceph1.laogao.cloud:8080 s3 mb s3://webapp
make_bucket: webapp
[root@client ~] echo Hello World > Welcome-pub.html
[root@client ~] aws --endpoint=http://ceph1.laogao.cloud:8080 s3 cp Welcome-pub.html s3://webapp/ --acl=public-read-write
upload: ./Welcome-pub.html to s3://webapp/Welcome-pub.html
[root@client ~] aws s3 ls s3://webapp --endpoint=http://ceph1.laogao.cloud:8080
[root@client ~] wget http://ceph1.laogao.cloud:8080/webapp/Welcome-pub.html # 应成功判定标准:带 public-read-write 的对象可匿名下载;未带 ACL 的对象必须返回 403 Forbidden。两者都成立才算权限模型正确。
测试3:Swift 端到端
bash
[root@client ~] source swift.rc
[root@client ~] swift stat                     # 看账号/容器/对象计数
[root@client ~] swift auth                     # 看 OS_STORAGE_URL / OS_AUTH_TOKEN
[root@client ~] swift post webapp              # 建容器
[root@client ~] swift upload webapp Welcome.html
[root@client ~] swift list webapp
Welcome.html
[root@client ~] swift download webapp Welcome.html
[root@client ~] swift delete webapp Welcome.html判定标准:swift stat / swift auth 能正常输出,说明认证链路(子用户 + swift 密钥)是对的------这是 Swift 接入最容易卡住的一步。
测试4:三级配额的生效与解除
bash
# user 级:限 3 个对象
[root@ceph1 ~] radosgw-admin quota enable --quota-scope=user --uid=swift
[root@ceph1 ~] radosgw-admin quota set --quota-scope=user --uid=swift --max-objects=3
[root@client ~] swift upload --object-name hosts-4 dbapp /etc/hosts
Object PUT failed: ... 413 Request Entity Too Large   b'QuotaExceeded' ...
# 解除
[root@ceph1 ~] radosgw-admin quota set --quota-scope=user --uid=swift --max-objects=-1
[root@client ~] swift upload --object-name hosts-4 dbapp /etc/hosts   # 应成功

# bucket 级:限 10M
[root@ceph1 ~] radosgw-admin quota enable --quota-scope=bucket --bucket=dbapp
[root@ceph1 ~] radosgw-admin quota set --quota-scope=bucket --bucket=dbapp --max-size=10M
[root@client ~] dd if=/dev/zero of=file bs=1M count=6
[root@client ~] swift upload --object-name file-1 dbapp file          # 6M < 10M 通过
[root@client ~] swift upload --object-name file-2 dbapp file # 12M > 10M 被拒判定标准:报错必须是 413 Request Entity Too Large + b'QuotaExceeded' ;把 max-* 置 -1 后应立即恢复可写。
测试5:多站点同步
bash
[root@ceph4 ~] radosgw-admin sync status
  metadata sync syncing
                incremental sync: 64/64 shards
                metadata is caught up with master
      data sync source: 9366405a-... (storage1)
                      incremental sync: 128/128 shards
data is caught up with source判定标准:metadata is caught up with master 与 data is caught up with source 两行同时出现。再做一次跨站点实测:
bash
[root@client ~] source swift.rc            # 主站点凭据
[root@client ~] swift upload --object-name hosts-from-primary dbapp /etc/hosts
[root@client ~] source swift-slave.rc      # 备站点凭据
[root@client ~] swift list dbapp
hosts-from-primary
测试6:CephFS 挂载、权限与快照
bash
# 不受限账户挂载并写数据
[root@client ~] mount.ceph ceph1.laogao.cloud:/ /mnt/cephfs1 -o name=cephfs1-all-user,fs=cephfs1
[root@client ~] dd if=/dev/zero of=/mnt/cephfs1/dir1/file-100M bs=1M count=100
[root@client ~] df -h /mnt/cephfs1          # 客户端看:100M
[root@ceph1 ~] ceph fs status               # 集群侧看:data 池 300M(3 副本)

# 受限账户的权限边界
[root@client ~] umount /mnt/cephfs1
[root@client ~] mount.ceph ceph1.laogao.cloud:/ /mnt/cephfs1 -o name=cephfs1-restrict-user,fs=cephfs1
[root@client ~] touch /mnt/cephfs1/dir1/x   # 应 Permission denied
[root@client ~] touch /mnt/cephfs1/dir2/x   # 应成功

# 快照需要 s 权限
[root@client ~] mkdir /mnt/cephfs1/.snap/snap   # 无 s → Permission denied
# 加 s 权限并重挂后成功
[root@client ~] mkdir /mnt/cephfs1/.snap/snap
[root@client ~] ls /mnt/cephfs1/.snap/snap/判定标准:客户端 100M 对应集群侧 300M 是 3 副本的必然结果;dir1 被拒、dir2 成功 证明路径级权限生效;加 s 后能建 .snap/snap 证明快照权限生效。
测试7:CephFS 快照镜像
bash
[root@ceph1 ~] ceph fs snapshot mirror add cephfs /webapp
[root@ceph1 ~] mkdir -p /mnt/cephfs1/webapp && echo hello world > /mnt/cephfs1/webapp/index.html
[root@ceph4 ~] ls /mnt/cephfs1/
webapp判定标准:目标集群出现源集群新建的目录即链路打通。
13.3 排障指南
对象存储侧
| 故障现象 | 排查方向 |
|---|---|
S3 客户端报 SignatureDoesNotMatch / 认证失败 |
网关用户与 cephx 用户是两套体系:查 radosgw-admin user info --uid=<user> 的 access_key/secret_key,不要翻 ceph auth list |
| 生成的密钥客户端用不了 | 自动生成的密钥可能含 JSON 转义字符 \ → 重新生成或显式用 --access-key/--secret-key 指定 |
| Swift 连不上、只有 S3 能用 | Swift 用的是子用户 + swift_keys :确认 radosgw-admin subuser create ... --subuser=<uid>:<name>,且客户端 -U/ST_USER 填的是 uid:subuser 格式 |
swift list 里对象名带路径 |
上传用了绝对路径,路径被吃进对象名 (如 etc/hostname);用 --object-name 指定对象名 |
上传报 413 QuotaExceeded |
撞了 user 或 bucket 配额:radosgw-admin user stats / bucket stats 看 num_objects、max_size;置 -1 解除 |
| 配了 global 配额不生效 | 忘了 radosgw-admin period update --commit;重启 RGW 实例也可实施配额 |
删桶报 argument of type 'NoneType' is not iterable |
桶非空(或配额已满):先 aws s3 rm s3://<bucket> --recursive 清空再 rb |
| 对象 403 无法匿名下载 | 对象是私有的:上传时加 --acl=public-read-write,或用预签名 URL;不要把整桶设 public |
| 多站点不复制数据 | ① 元数据更新必须在主区域组的主区域 做;② radosgw-admin sync status 看 caught up;③ 检查 zone modify --endpoints 里的网关地址是否可达 |
| 主区域故障后无法建桶/建用户 | 正常现象 :次要区域只能继续读写老数据,创建新桶/用户必须做区域升级 (zone modify --master → zonegroup modify --endpoints → period update --commit) |
| 网关改动后不生效 | 域/区域/配额类变更几乎都要 period update --commit ,之后可能还需 ceph orch restart rgw.webapp |
| 删了网关服务数据还在 | 属预期:ceph orch rm rgw.webapp 只删进程不删池数据;要清数据得删池 |
| 备份的服务 YAML 无法 apply | ceph orch ls --format yaml -o 导出含 status/events:用 sed '/^status/,$d' 裁掉后再 apply |
CephFS 侧
| 故障现象 | 排查方向 |
|---|---|
| 挂载失败、提示找不到 MON | 用 -o mon_addr 指定多个 MON (逗号分隔,可带非标准端口);确认 keyring 已在 /etc/ceph |
挂载后 Permission denied |
用 ceph auth get <client> 看 caps mds 的路径与权限(r/rw/rwp/rws);权限变更后必须重新挂载 |
df 显示的空间和集群侧对不上 |
客户端看的是文件系统语义(3 副本 → 1/3),集群 ceph df 看的是原始占用;容量规划按集群侧算 |
设了 ceph.quota.max_bytes 但配额不生效 |
Kernel 客户端不支持配额 ,改用 FUSE(ceph-fuse);FUSE 的 ACL 还需挂载时显式启用 |
不能创建快照(.snap/snap Permission denied) |
客户端权限缺 s:ceph auth caps <client> mds "allow rws fsname=<fs> path=<dir>" ...,然后重挂 |
ceph fs rm 报错 |
必须先 ceph fs set <fs> down true 才能 fs rm <fs> --yes-i-really-mean-it |
| 删不掉 CephFS 的池 | mon_allow_pool_delete 默认 false,需先打开总闸 |
| MDS 只有 standby、没有 active | ceph fs status / ceph mds stat 看 rank 状态;检查 max_mds 与 MDS 守护进程是否就绪(ceph orch ls mds) |
| MDS 内存吃满 / 小文件性能差 | 元数据全压在 MDS:调 mds_cache_memory_limit;必要时提高 max_mds 开多个活动 MDS |
| CephFS Mirror 不生效 | 两边都需 ≥ Pacific v16.2.0;ceph mgr module enable mirroring 两边都要做;源侧还要 ceph fs snapshot mirror enable <fs> 和 snapshot mirror add <fs> <path>;注意 token 是目标集群生成、源集群导入 |
| 镜像同步慢 / 目录巨大 | 基于快照 + readdir diff:控制快照数量与目录层级,避免海量小文件集中在一个目录 |
13.4 最佳实践
- 网关用户的密钥显式指定 :避免自动生成密钥里的
\转义字符;一个用户多把钥匙,下线应用时只吊销对应的那把(radosgw-admin key rm --access-key)。 - S3 与 Swift 的凭据分开管理 :S3 用
keys,Swift 用swift_keys(子用户),别混用;把凭据写进受限权限的*.rc文件而不是散落在命令里。 - 配额从小到大逐层设 :先 user、再 bucket,最后才考虑 global;改了 global 一定补
period update --commit。取消配额要"先置-1再 disable"。 - 对象对外发布用 ACL 或预签名 URL,不要整桶公开 :
--acl=public-read-write只给必要对象。 - 删桶一律"先清空再删" :
aws s3 rm s3://<bucket> --recursive之后aws s3 rb;Swift 侧注意swift delete <container>会连带清空,脚本里加二次确认。 - 多站点:元数据操作只在主区域做 ;
zone modify --endpoints的地址清单要写全、写对;故障转移按"升级主区域三步"执行,别指望次要区域能建新桶/新用户。 - 网关服务用服务规格文件管理 :
count控制实例数、端口自动 +1;导出备份后记得sed '/^status/,$d'才能复用。 - CephFS 元数据池单独提复本:元数据是"索引",丢了比数据丢了更麻烦;数据池可用纠删码省容量。
- 需要配额就用 FUSE :Kernel 客户端不支持配额;给用户授权时按需带上
p(配额/布局)和s(快照)。 - 给 CephFS 客户端只发它需要的 keyring :用
ceph fs authorize <fs> <client> <path> <perms>做目录级隔离,比拆多个文件系统更划算。 - 容量规划按集群侧计算副本放大:客户端看到 100M,3 副本池实际占用 300M。
- CephFS Mirror 的 RPO 按"最近完成同步的快照"算:它是异步 + 基于快照的,别当同步复制用。
- 快照删除用
rmdir而不是rm -rf:.snap下删目录是安全的引用删除;rm -rf的破坏力完全不同。
写在最后
本文是 Ceph 系列(第 3--8 章共三篇)的收官篇。到这里,Ceph 的三套存储接口已经全部打通:块存储(RBD)给虚拟机和数据库,对象存储(RGW)给海量非结构化数据,文件存储(CephFS)给需要 POSIX 目录树的业务------三者共用同一套 RADOS 后端,这正是 Ceph "统一存储"的完整含义。
| 章节 | 核心内容 | 应用场景 / 解决的问题 |
|---|---|---|
| 一、对象存储与 RGW | 对象三要素(Key/Metadata/Data)、桶的扁平命名空间、S3/Swift 双接口、七个 .rgw.* 池 |
理解对象存储的边界与网关的定位 |
| 二、realm/zonegroup/zone/period | 四层坐标系、区域组内复制、元主与配置提交规则 | 多站点架构选型与"改了不生效"的根因 |
| 三、RGW 部署与生命周期 | realm/zonegroup/zone 创建、period update --commit、ceph orch apply rgw、服务规格文件与 count 端口规则、配置备份恢复、删除 |
部署、扩缩容、备份、下线 |
| 四、网关用户与密钥 | radosgw-admin user/subuser/key 全套、--system 用户、suspend 开关、--purge-data |
网关侧的身份与凭据管理 |
| 五、Amazon S3 API | awscli 与多 profile、mb/cp/ls/rm/rb、ACL 与 403 的对照、对象大小限制 |
用 S3 生态的客户端直接对接 Ceph |
| 六、三级配额 | --quota-scope=user/bucket/global、-1 解除、period update --commit |
按用户/桶/全局限制对象数与容量 |
| 七、OpenStack Swift API | 租户→user、用户→subuser 的映射、ceph-fuse 之外的 Swift 客户端与 swift_keys |
对接 OpenStack 与 Swift 生态 |
| 八、Swift 客户端实战 | stat/auth/post/upload/list/download/delete、--object-name、-S 分段、配额实测(413 QuotaExceeded) |
容器与对象的日常操作与验证 |
| 九、多站点与故障转移 | multi zone/zonegroup/realm、realm pull/period pull、sync status、区域升级三步 |
跨站点容灾与主区域故障恢复 |
| 十、CephFS 与 MDS | POSIX 兼容、三种存储方式对比、MDS 职责与 max_mds、卷/子卷、配额 | 文件存储的架构与元数据认知 |
| 十一、CephFS 部署与挂载 | 手动/卷两种部署、ceph fs new/add_data_pool、Kernel 与 FUSE 挂载、ceph fs authorize 的 r/w/p/s、子目录挂载、fstab 永久挂载 |
从创建文件系统到客户端可用 |
| 十二、快照与快照镜像 | .snap 隐藏目录、快照创建与恢复、cephfs-mirror 九步配置、peer_bootstrap token 流向 |
文件级数据保护与跨集群容灾 |
| 十三、验证与排障 | 7 组验证测试、26 类故障排查方向、13 条最佳实践 | 出事能定位、上线有规范 |
核心价值:
✅ 一套后端,三种接口 :同一个 RADOS 集群同时支撑块、对象、文件,业务按需选择,不用为每种场景各维护一套存储。
✅ 无缝替代公有云 :S3 与 Swift 双协议兼容,为亚马逊 S3 或 OpenStack Swift 写的应用可以几乎原样迁移到私有化部署上。
✅ 多层级容灾 :池的复本/纠删码管硬件级可靠,RBD Mirrors 管块设备跨站点同步,RGW 多站点管对象主动-主动复制,CephFS Mirror 管文件系统快照级复制。
✅ 精细的资源与权限治理 :网关侧的 user/bucket/global 三级配额 + cephx 与 ceph fs authorize 的路径级权限,让"多团队共用一个集群"变成可管理的工程问题。
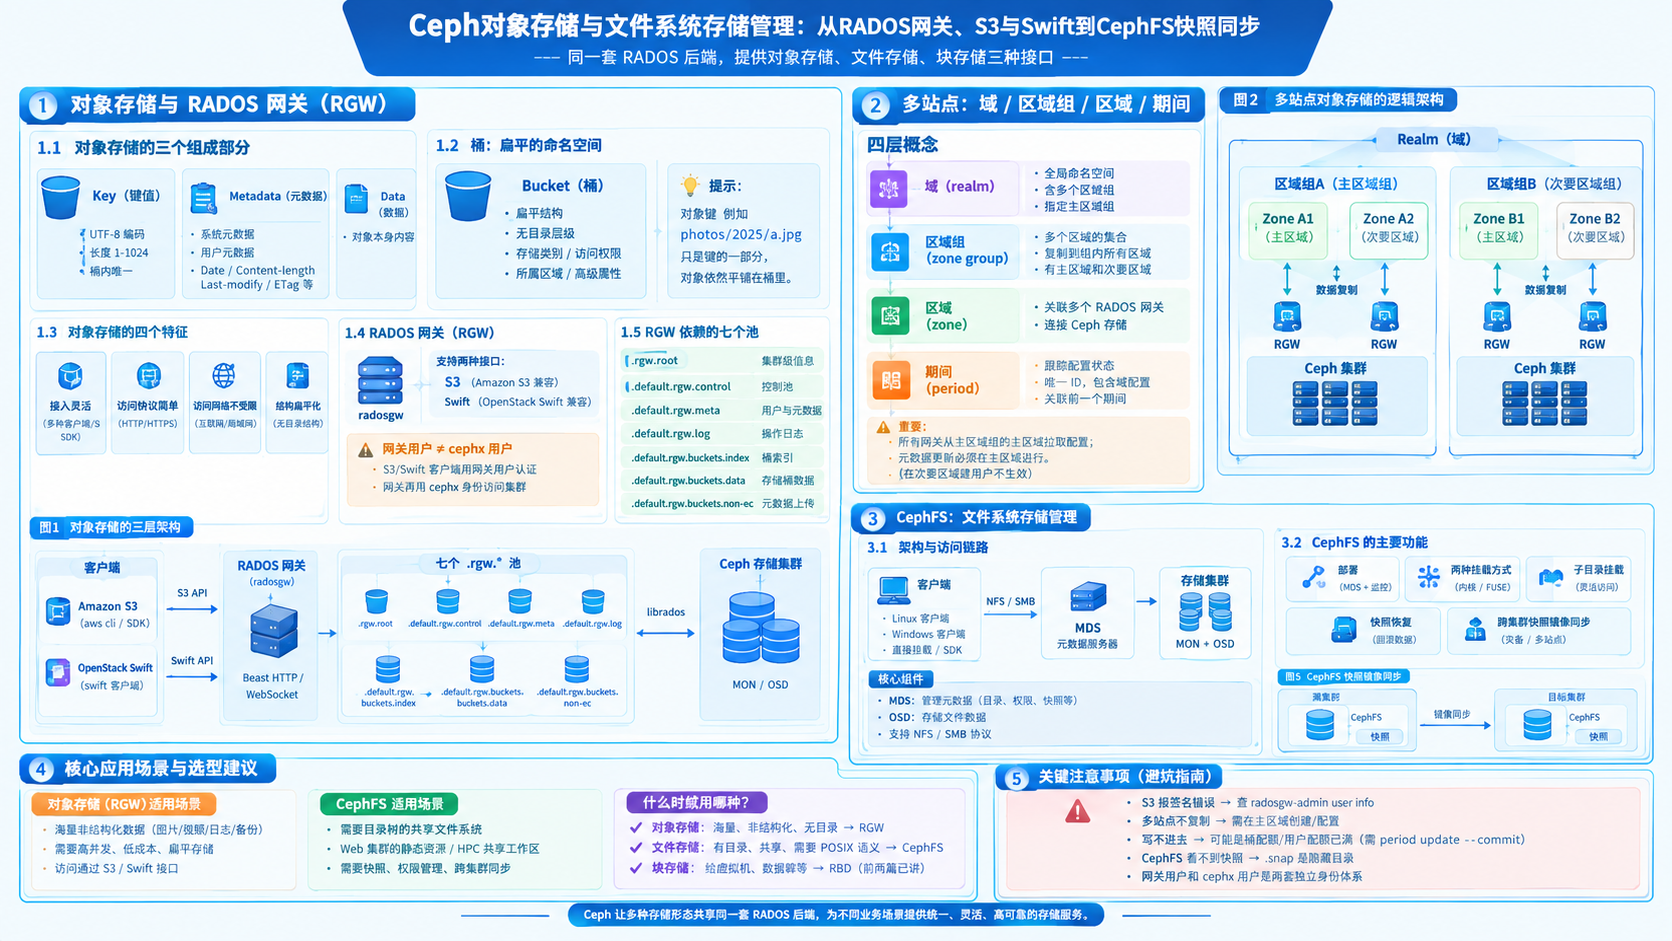
📌 核心命令速查
bash
# ------ 对象存储:域与网关 ------
radosgw-admin realm create --rgw-realm=<realm> --default
radosgw-admin zonegroup create --rgw-realm=<realm> --rgw-zonegroup=<zg> --master --default
radosgw-admin zone create --rgw-realm=<realm> --rgw-zonegroup=<zg> --rgw-zone=<zone> --master --default
radosgw-admin period update --commit                  # 提交配置(最容易忘的一步)
ceph orch apply rgw <realm> --placement="3 h1 h2 h3" --realm=<realm> --zone=<zone> --port=8080
ceph orch ls rgw | ceph orch ps --daemon-type rgw
ceph orch ls rgw --format yaml -o rgw_service.yaml    # 备份
sed '/^status/,$d' rgw_service.yaml                   # 裁成可 apply 的形式
ceph orch apply -i rgw_service.yaml
ceph orch rm rgw.webapp                               # 删服务(不删池数据)
radosgw-admin zone delete / zonegroup delete / realm delete

# ------ 对象存储:用户、密钥、配额 ------
radosgw-admin user create --uid=<uid> --display-name="<name>" --access-key=<ak> --secret-key=<sk>
radosgw-admin user list | user info --uid=<uid> | user stats --uid=<uid>
radosgw-admin key create --uid=<uid> --gen-access-key        # 加一把新钥匙
radosgw-admin key create --uid=<uid> --access-key=<ak> --gen-secret
radosgw-admin key rm --uid=<uid> --access-key=<ak>
radosgw-admin user suspend | user enable --uid=<uid>         # suspended 1/0
radosgw-admin user modify --uid=<uid> --display-name=<n> --access=full
radosgw-admin user rm --uid=<uid> --purge-data
radosgw-admin subuser create --uid=<uid> --subuser=<uid>:<sub> --access=full --secret=<sk>
radosgw-admin key create --subuser=<uid>:<sub> --key-type=swift --gen-secret
radosgw-admin subuser modify | subuser rm | key rm --subuser=<uid>:<sub>
radosgw-admin quota enable|set|disable --quota-scope=user --uid=<uid> --max-objects=3
radosgw-admin quota enable|set|disable --quota-scope=bucket --bucket=<b> --max-size=10M
radosgw-admin global quota set|enable|get --quota-scope=user --max-objects=2048
radosgw-admin period update --commit                  # global 配额必须提交才生效
radosgw-admin bucket stats --bucket=<b> | buckets list | user stats --uid=<uid>
radosgw-admin usage show --uid=<uid> --start-date=<t> --end-date=<t>

# ------ Amazon S3 API(客户端)------
aws configure ; aws configure --profile=ceph
aws --endpoint=http://ceph1.laogao.cloud:8080 s3 mb s3://<bucket>
aws --endpoint=http://ceph1.laogao.cloud:8080 s3 ls
aws --endpoint=http://ceph1.laogao.cloud:8080 s3 cp <file> s3://<bucket>/ --acl=public-read-write
aws s3 cp s3://<bucket>/<obj> /tmp --endpoint=http://ceph1.laogao.cloud:8080
aws s3 cp s3://<bucket> /tmp --recursive --endpoint=http://ceph1.laogao.cloud:8080
aws s3 rm s3://<bucket>/<obj> --endpoint=http://ceph1.laogao.cloud:8080
aws s3 rm s3://<bucket> --recursive --endpoint=http://ceph1.laogao.cloud:8080   # 清空
aws s3 rb s3://<bucket> --endpoint=http://ceph1.laogao.cloud:8080               # 删桶

# ------ OpenStack Swift API(客户端)------
pip3 install python-swiftclient
# swift.rc: ST_AUTH=http://ceph1.laogao.cloud:8080/auth/1.0 ; ST_USER=<uid>:<sub> ; ST_KEY=<sk>
source swift.rc
swift stat | swift auth | swift post <container> | swift list [<container>]
swift upload <container> <file> [--object-name <name>] [-S <segment-size>]
swift download <container> [<object>] | swift delete <container> [<object>]
swift -A <auth_url> -U "<uid>:<sub>" -K <sk> list

# ------ 多站点 ------
radosgw-admin user create --uid=system-user --display-name=system-user --access-key=<ak> --secret=<sk> --system
radosgw-admin zone modify --rgw-zone=<zone> --endpoints 'http://h1:8080,http://h2:8080' --access-key=<ak> --secret=<sk> --master --default
ceph config set client.rgw.<svc>.<host>.<id> rgw_realm <realm>
ceph config set client.rgw.<svc>.<host>.<id> rgw_zonegroup <zg>
ceph config set client.rgw.<svc>.<host>.<id> rgw_zone <zone>
ceph orch restart rgw.webapp
radosgw-admin realm pull --url=http://<primary>:8080 --access-key=<ak> --secret=<sk>
radosgw-admin period pull --url=http://<primary>:8080 --access-key=<ak> --secret=<sk>
radosgw-admin zone create --rgw-zonegroup=<zg> --rgw-zone=<zone2> --endpoints "http://..." --access-key=<ak> --secret=<sk>
radosgw-admin sync status                            # caught up with master / source
radosgw-admin zone modify --master --rgw-zone=<zone2>          # 故障转移①
radosgw-admin zonegroup modify --rgw-zonegroup=<zg> --endpoints=http://<new-primary>:8080  # ②
radosgw-admin period update --commit                           # ③

# ------ CephFS:部署与删除 ------
ceph osd pool create <fs>.<name>.data.1 ; ceph osd pool create <fs>.<name>.meta
ceph osd pool set <fs>.<name>.meta size 3
ceph fs new <fs> <metadata-pool> <data-pool>          # 先元数据、后数据
ceph fs add_data_pool <fs> <another-data-pool>
ceph orch apply mds <fs> --placement="3 h1 h2 h3"
ceph fs ls | ceph fs status | ceph mds stat | ceph orch ls mds | ceph df
ceph fs volume create <fs> --placement="3 h1 h2 h3"   # 卷部署(一条命令)
ceph fs volume ls | ceph fs volume rm <fs> --yes-i-really-mean-it
ceph orch rm mds.<fs> ; ceph fs set <fs> down true ; ceph fs rm <fs> --yes-i-really-mean-it
ceph config set mon mon_allow_pool_delete true ; ceph osd pool rm <pool> <pool> --yes-i-really-really-mean-it

# ------ CephFS:授权与挂载 ------
ceph fs authorize <fs> client.<user> / rwps > /etc/ceph/ceph.client.<user>.keyring
ceph auth get client.<user> ; ceph auth caps client.<user> mds "allow rws fsname=<fs> path=<dir>" ...
dnf install -y ceph-common            # FUSE 还要 ceph-fuse
mount.ceph <mon>:/ /mnt/<dir> -o name=<user>,fs=<fs>
mount -t ceph <mon>:/<subdir> /mnt/<dir> -o name=<user>,fs=<fs>          # 挂子目录
ceph-fuse -n client.<user> /mnt/<dir>
ceph-fuse -n client.<user> -r /dir2 --client_fs <fs> /mnt/<dir>
# /etc/fstab: <mon>:/dir2 /mnt/dir ceph name=<user>,fs=<fs>,_netdev 0 0
# /etc/fstab: <mon> /mnt/dir fuse.ceph ceph.id=<user>,_netdev 0 0

# ------ CephFS:快照与镜像 ------
ceph fs set <fs> allow_new_snaps true|false
mkdir /mnt/<dir>/.snap/<snap>          # 建快照(需 s 权限)
ls /mnt/<dir>/.snap/<snap>/            # 看快照内容
cp /mnt/<dir>/.snap/<snap>/<file> /restore/      ; rsync -a /mnt/<dir>/.snap/<snap>/ /restore/
rmdir /mnt/<dir>/.snap/<snap>/         # 删快照(非空也能删)
ceph orch apply cephfs-mirror <host> ; ceph orch ls cephfs-mirror
ceph fs authorize <fs> client.cephfs-mirror / rwps
ceph mgr module enable mirroring                      # 两边都要
ceph fs snapshot mirror enable <fs>                   # 源集群
ceph fs snapshot mirror peer_bootstrap create <fs> client.cephfs-mirror backup   # 目标集群生成 token
ceph fs snapshot mirror peer_bootstrap import <fs> <token>                      # 源集群导入
ceph fs snapshot mirror peer_list <fs>
ceph fs snapshot mirror add <fs> /webapp              # 指定镜像目录
📝 本文首发于个人技术博客,欢迎交流讨论。如有错误,恳请指正。
系列回顾 :三篇走完 Ceph 从架构到运维的完整链路------第一篇讲 RADOS 架构与 cephadm 集群部署 ,第二篇讲 集群配置与池管理 ,第三篇讲 认证授权与块存储 ,本篇收尾于 对象存储与文件系统存储。从"把集群搭起来"到"让业务真正用起来",这条路走完,你手里就有了一套可以支撑块、对象、文件三种工作负载的分布式存储底座。