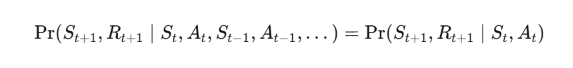1、智能体与环境交互的基本要素
状态 (state, s∈S)
智能体在环境中所处的情形,是对当前环境的描述。
状态空间 (state space, S)
所有可能状态的集合。
动作 (action, a)
在某状态下智能体可以执行的操作。
动作空间 (action space, A(s))
状态ss 下可采取的动作集合。注意:不同状态对应的动作空间可以不同。
状态转移 (state transition)
在当前状态 s 执行动作 a 后,环境转移到下一状态 s′ 的过程。
常用转移概率描述:
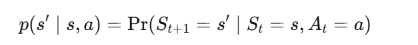
禁止区域 (forbidden area)
环境中某些特殊状态,表现为:
无法进入(转移概率恒为 0);或
进入即受严惩(极大的负奖励),用来表示危险或约束。
奖励 (reward, r)
智能体执行一个动作后,环境反馈的标量评价信号。一般 正值表示鼓励,负值表示惩罚 。
奖励也是随机的,其概率为:
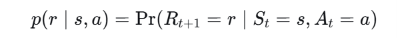
示例:p(r=1∣s1,a1)=1 表示在状态 s1 采取动作 a1 后,得到奖励 1 概率为100%。
2. 策略
策略 (policy, π)
决定了智能体在每个状态下如何选择动作。是状态到动作概率分布的映射。
随机策略:π(a∣s) 表示在状态 s 下选择动作 a 的概率,满足
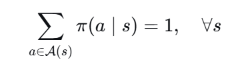
确定性策略可视为特殊情形,某个动作为 1,其余为 0。
3. 轨迹、回报与折扣回报
轨迹 (trajectory)
智能体与环境交互产生的状态、动作、奖励序列,例如:
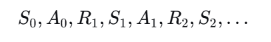
回报 (return, Gt)
从时刻 t 开始,之后获得的所有奖励的总和。
对于有限步任务,简单求和即可: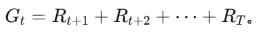
折扣回报 (discounted return)
为平衡近期与远期奖励,引入折扣因子 γ∈[0,1):
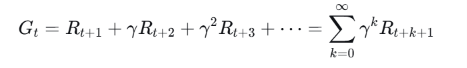
γ 越接近 1,越重视长期奖励;γ 越小,越看重眼前。
注意:即时奖励 Rt+1不被折扣(即系数为 1),后续奖励才依次乘以 γ,γ²,...。
回合与持续性任务
回合(episode) :交互序列自然终止的轨迹(如游戏结束)。这类问题称为 回合式任务(episodic tasks)。
持续性任务(continuing tasks):没有终止时刻,交互无限进行(如机器人持续运行)。此时折扣回报必不可少,否则回报可能发散。
4. 马尔可夫决策过程(MDP)
马尔可夫决策过程是强化学习问题的数学框架,核心元素包括:
状态集合 S
动作集合(可依赖状态)A(s)
奖励分布 p(r∣s,a) 或奖励函数 R(s,a)
状态转移概率 p(s′∣s,a)
折扣因子 γ
策略 π(a∣s)
马尔可夫性质 (Markov property):
下一状态与奖励的概率分布只依赖于当前状态和当前动作,与更早的历史无关: