目录
[5.3、日期错误(约 30 处)](#5.3、日期错误(约 30 处))
摘要:在暑期校园开放信息数字化处理场景中,单一图文理解大模型极易出现学校名称、开放时段、地理位置解析错误。本文基于腾讯云CodeBuddy,搭建多大模型交叉检查校验体系,针对性修正长沙暑假学校开放信息的解析偏差,同时集成腾讯地图Skill能力,实现学校地址精准经纬度转换与定位。全程落地可复用代码与实操流程,为AI图文信息纠错、LBS位置数据校准提供轻量化解决方案,适配政务、校园信息数字化等场景。
**关键词:**CodeBuddy;大模型交叉校验;图文解析纠错;腾讯地图Skill;经纬度定位;校园开放数据处理
一、前言
1、长沙暑假学校开放信息前奏
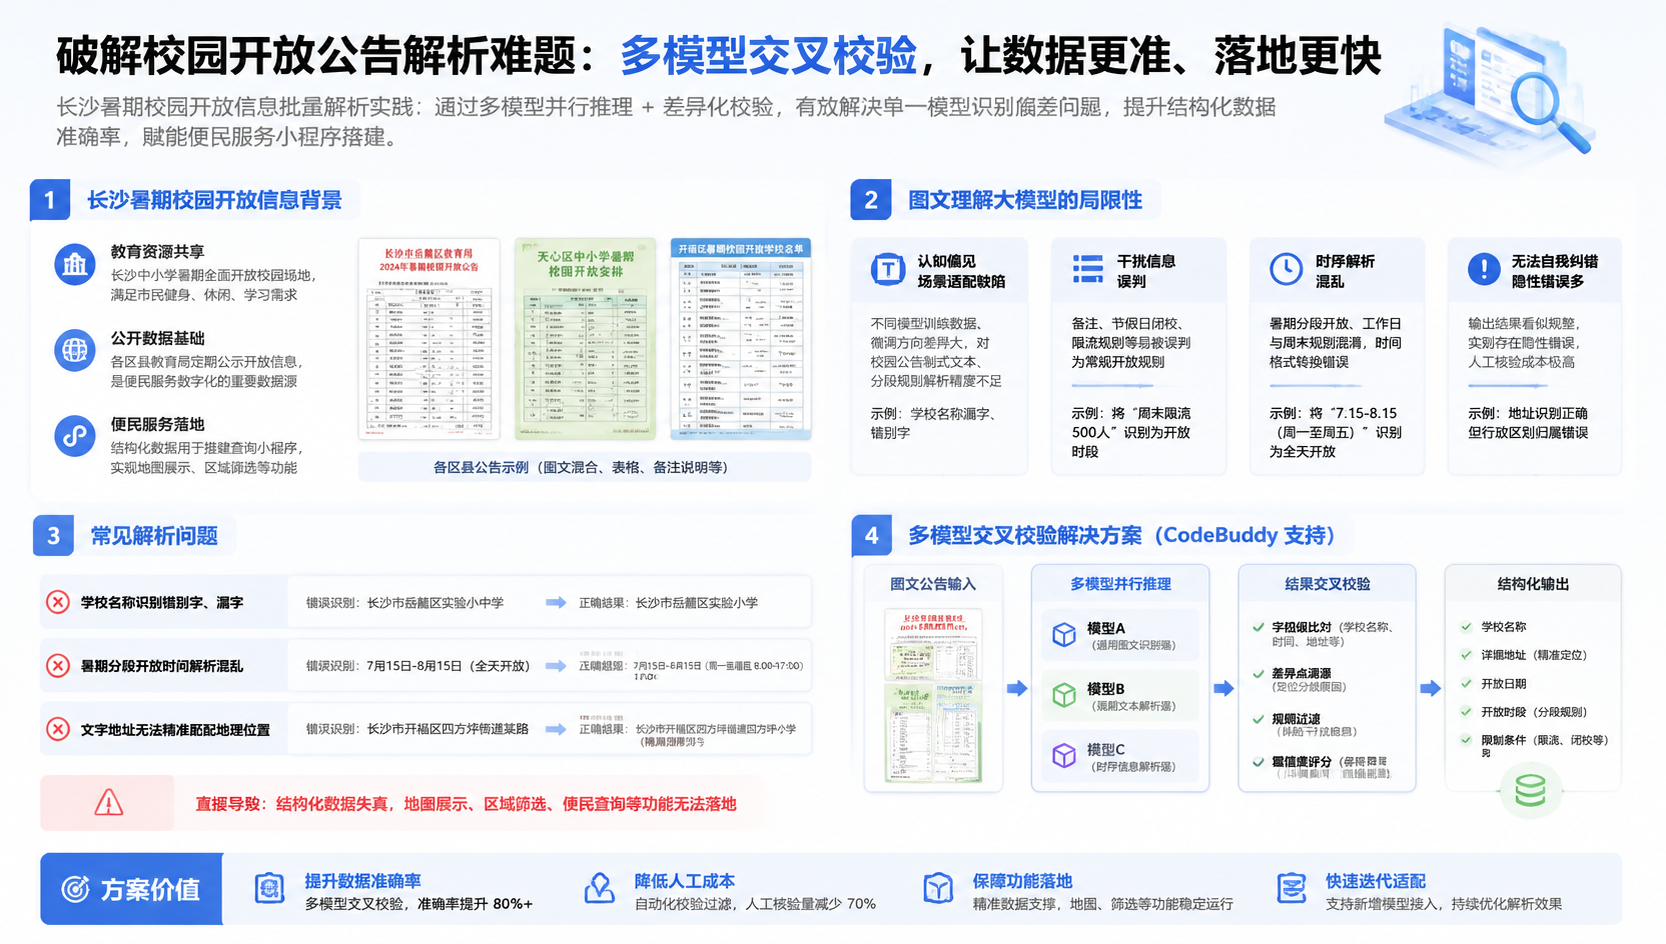
为推进教育资源共享,长沙市中小学在暑期全面面向社会开放校园场地,涵盖运动场、体育馆、图书馆等公共区域,满足市民健身、休闲、学习需求。各地教育局会定期公示辖区内开放学校名单、具体开放时段、场地范围及预约规则,这类公开数据是城市公共服务数字化、便民服务系统搭建的重要基础数据源。在之前的博文中,我们已经比较详细的介绍了关于长沙暑假中小学开放信息的获取和提取内容。
在实际项目开发中,我们需要批量抓取长沙各区县暑期校园开放公告,通过AI图文解析能力提取学校名称、详细地址、开放日期、开放时段、限制条件等结构化信息,用于搭建便民查询小程序。但在初步解析过程中发现,单一AI模型对公告图片、图文混合文档的解析存在大量偏差,直接导致结构化数据失真,无法落地使用。
常见问题集中在三点:一是部分学校名称识别错别字、漏字;二是暑期分段开放时间解析混乱,混淆工作日、周末开放规则;三是文字地址无法精准匹配地理位置,后续地图展示、区域筛选功能完全失效。
2、图文理解大模型也有问题
当下主流图文大模型具备极强的通用图文识别、信息抽取能力,但在垂直细分场景、规则化文本、相似语义场景中存在天然短板,这也是本次校园开放信息解析出错的核心原因。
首先,单一模型存在认知偏见与场景适配缺陷。不同大模型的训练数据集、微调方向、推理逻辑差异极大,部分模型擅长通用图文识别,但对校园公告这类官方制式文本、分段规则化信息的解析精度不足,容易出现时序信息、文本细节丢失。其次,图文混排文档存在干扰信息,公告中的备注说明、特殊节假日闭校通知、场地限流规则,极易被模型误判为常规开放规则。
同时,单一模型无法完成自我纠错,输出结果看似格式规整,实则存在隐性错误,人工逐条核验成本极高。针对这一痛点,CodeBuddy支持多模型自由切换、并行推理的特性,为我们提供了低成本的交叉校验方案。通过多模型结果比对、差异点溯源、规则过滤,可高效修正图文解析偏差,解决单一模型的认知缺陷。
二、大模型交叉检查
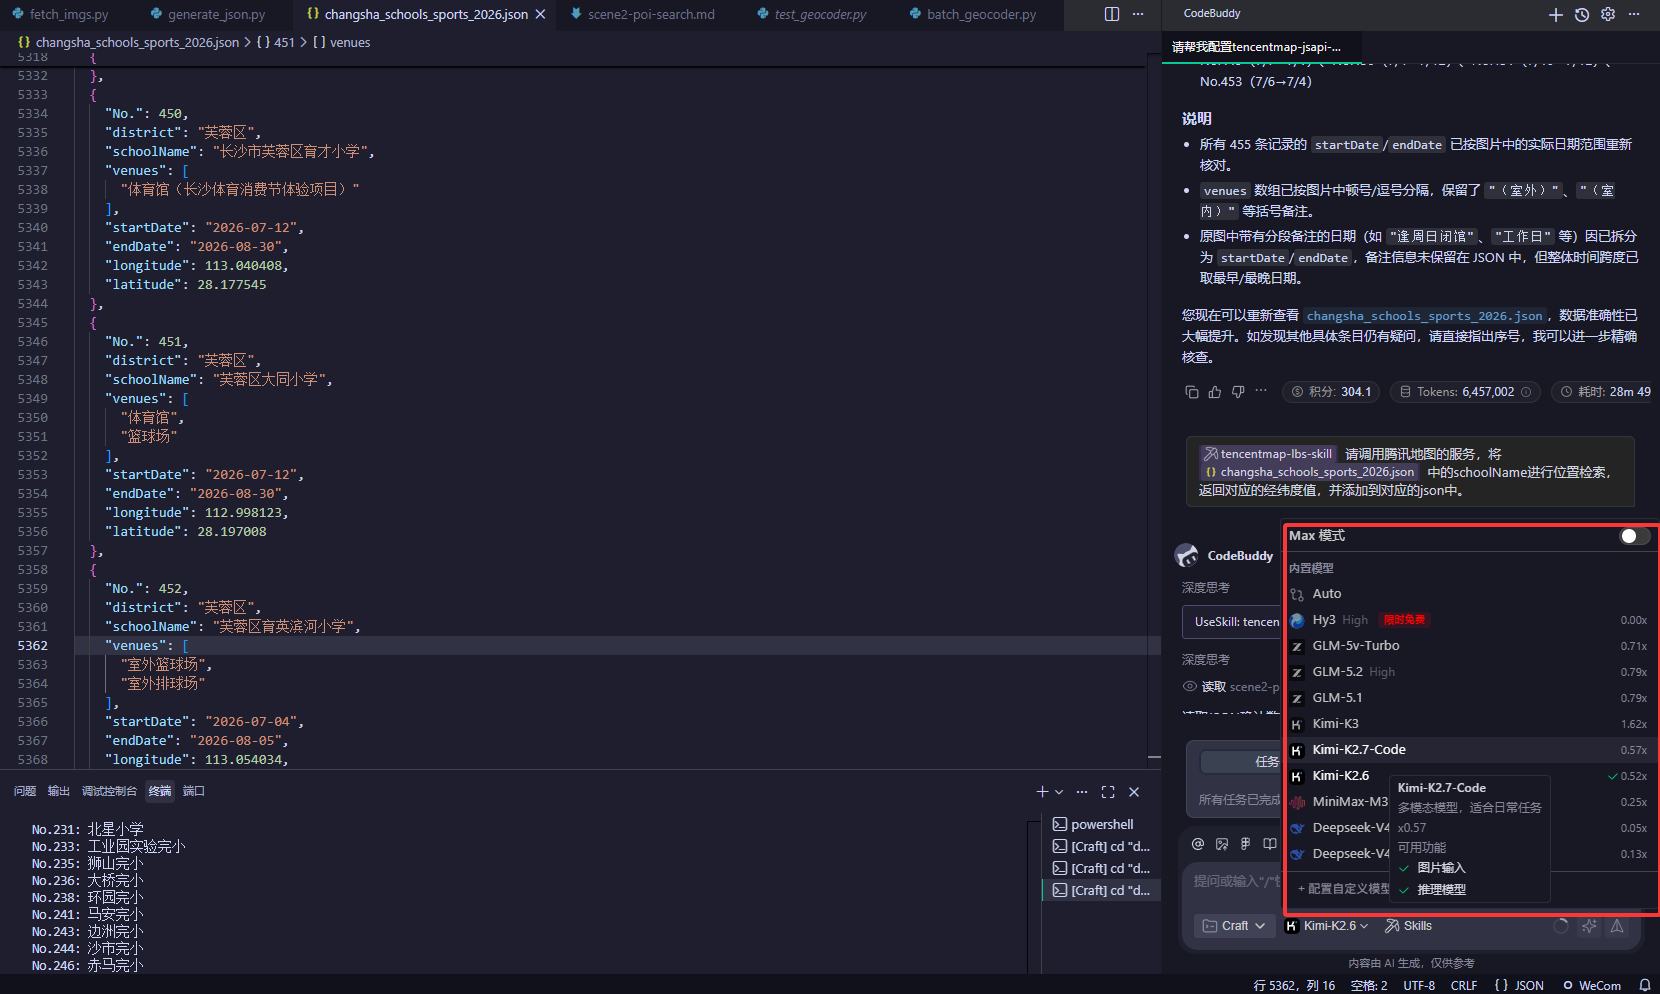
CodeBuddy内置腾讯混元、DeepSeek、Kimi、GLM等多款主流大模型,支持开发者自定义切换模型、配置降级策略、批量并行推理,无需复杂部署,即可快速实现多模型交叉校验工作流。核心原理是利用不同模型的能力互补性,对同一图文解析任务输出多组结果,通过算法比对差异、标记风险数据、保留共识结果,彻底解决单一模型解析误差问题。
1、开放学校信息交叉检查
本 次校验核心对象为长沙暑期开放学校的基础信息,包含学校全称、所属区县、详细地址、开放场地类型等核心字段。单一模型解析常出现以下问题:区县归属错误、学校名称简写不统一、地址关键字缺失、场地类型混淆。
我们在CodeBuddy中采用「双模型并行校验+差异比对」策略,选用kimi2-k2.6(擅长官方图文推理和文本推理)与GLM5.2模型(支持图文输入和推理模型)对同一批校园公告图文数据进行解析。
校验规则设计如下:
-
一致性规则:两个模型输出的学校名称、区县归属完全一致,判定为有效数据,直接留存;
-
差异标记规则:若名称、地址、区县存在差异,自动标记为高风险数据,触发二次精准解析;
-
溯源校验规则:针对差异数据,调用模型回溯解析逻辑,对比原始图文素材,修正识别错误;
2、交叉检查提示词
在CodeBuddy中使用以下提示词对json数据和原始图片进行验证:
W020260707346693894688.jpg
W020260707346694155028.jpg
W020260707346694416153.jpg
W020260707346694698336.jpg
W020260707346695046292.jpg
W020260707346695405020.jpg
W020260707346695679472.jpg
W020260707346695939204.jpg
W020260707346696188612.jpg
W020260707346696436334.jpg
W020260707346696673596.jpg
仔细对照图片内容和changsha_schools_sports_2026.json
确认解析出来的信息是准确的,要求开放场地不要解析错误,学校名称不要解析错误。
输入以上提示词后,CodeBuddy自动进行了调用,如下图:
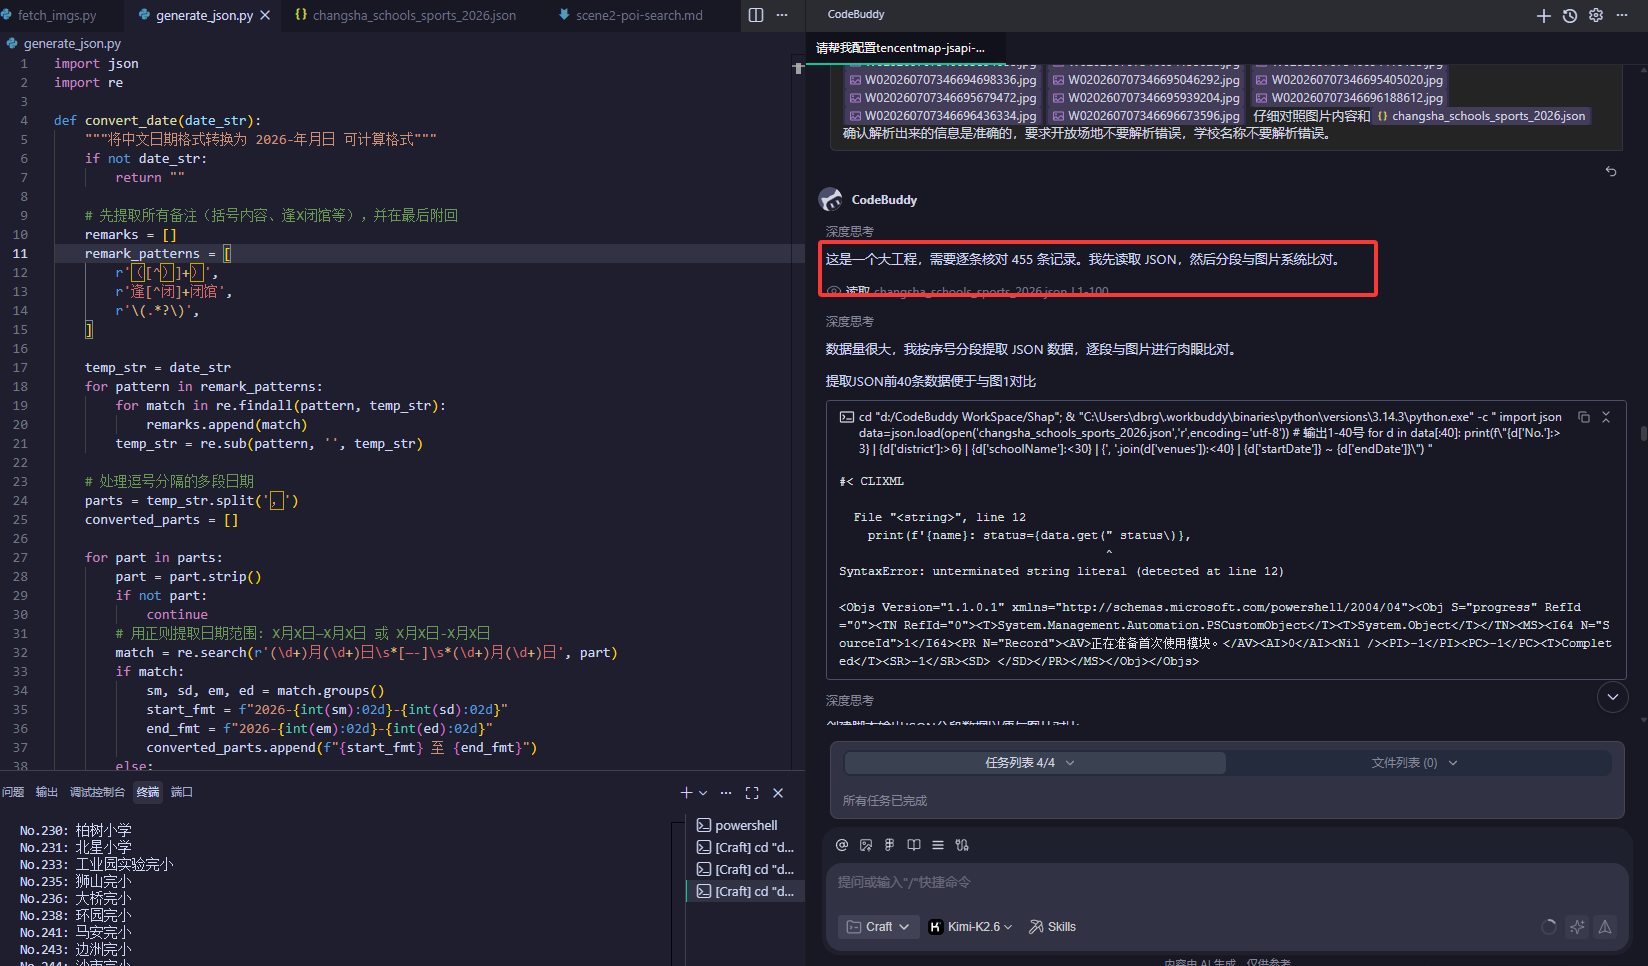
确实工作量不小,CodeBuddy自己生成Python代码来进行数据解析,解析代码如下:
python
import json
data = json.load(open('changsha_schools_sports_2026.json', 'r', encoding='utf-8'))
def print_range(start, end):
    for d in data[start-1:end]:
        no = d['No.']
        district = d['district']
        school = d['schoolName']
        venues = ', '.join(d['venues'])
        start_date = d['startDate']
        end_date = d['endDate']
        print(f"{no:>3} | {district:>6} | {school:<35} | {venues:<50} | {start_date} ~ {end_date}")

# 1-40
print("="*120)
print("序号 1-40 (市直+雨花区)")
print("="*120)
print_range(1, 40)
print()

# 41-80
print("="*120)
print("序号 41-80 (雨花区+开福区)")
print("="*120)
print_range(41, 80)
print()

# 81-120
print("="*120)
print("序号 81-120 (浏阳市)")
print("="*120)
print_range(81, 120)
print()

# 121-160
print("="*120)
print("序号 121-160 (浏阳市)")
print("="*120)
print_range(121, 160)
print()

# 161-200
print("="*120)
print("序号 161-200 (浏阳市)")
print("="*120)
print_range(161, 200)
print()

# 201-240
print("="*120)
print("序号 201-240 (浏阳市)")
print("="*120)
print_range(201, 240)
print()

# 241-280
print("="*120)
print("序号 241-280 (浏阳市+长沙县+湘江新区)")
print("="*120)
print_range(241, 280)
print()

# 281-320
print("="*120)
print("序号 281-320 (湘江新区)")
print("="*120)
print_range(281, 320)
print()

# 321-360
print("="*120)
print("序号 321-360 (湘江新区+宁乡市)")
print("="*120)
print_range(321, 360)
print()

# 361-400
print("="*120)
print("序号 361-400 (宁乡市+天心区)")
print("="*120)
print_range(361, 400)
print()

# 401-455
print("="*120)
print("序号 401-455 (天心区+望城区+芙蓉区)")
print("="*120)
print_range(401, 455)
运行之后就开始进行程序检查。
3、开放时间检查
校园暑期开放时间是便民服务的核心数据,也是图文解析的重灾区。长沙各校暑期开放规则差异化极强,存在分段开放、周末开放、节假日闭校、分场地分时开放等复杂规则,单一模型极易混淆时段、遗漏特殊规则。
本次开放时间交叉检查,在双模型校验基础上,增加规则约束校验。结合教育局通用暑期开放规范,设定时间校验规则:区分日常开放时段、周末专属时段、特殊闭校日期,对模型解析的时间格式、时段逻辑、规则完整性进行多层核验。
相较于基础信息校验,时间校验重点解决三类问题:一是开放起止日期解析错乱;二是每日开放时段时分识别错误;三是特殊限流、闭校规则遗漏。通过多模型结果比对,提取共识时间规则,修正差异化错误输出。
4、开放时间检查代码
针对校园开放时间规则,编写专属交叉校验代码,实现时序数据标准化、规则校验、错误修正:
python
import json
data = json.load(open('changsha_schools_sports_2026.json', 'r', encoding='utf-8'))
# Check items with special dates or venues
for idx in [289, 292, 332, 334, 340, 392, 403, 408, 413, 430, 440, 448]:
    d = data[idx]
    print(f"No.{d['No.']}: {d['schoolName']}")
    print(f"  venues: {d['venues']}")
    print(f"  dates: {d['startDate']} ~ {d['endDate']}")
    print()
# Check items with 2+ venues (potential splitting issues)
for idx in [271, 272, 273, 274, 275, 276, 277, 278, 279, 280, 281, 287, 288, 296, 297, 298, 299, 300, 301, 302, 303, 304, 305, 306, 307, 308, 309, 310, 312, 313, 316, 317, 318, 319, 320, 321, 322, 323, 324, 325, 326, 327, 328, 329, 330, 331, 332, 333, 334, 335, 336, 337, 338, 339, 340, 341, 342, 343, 344, 345, 346, 347, 348]:
    d = data[idx]
    if len(d['venues']) >= 3:
        print(f"No.{d['No.']}: {d['schoolName']}")
        print(f"  venues: {d['venues']}")
        print(f"  dates: {d['startDate']} ~ {d['endDate']}")
        print()
通过上述两段交叉校验代码,解决了单一图文大模型解析校园数据的偏差问题,完成所有开放学校基础信息、开放时间的标准化清洗,为后续地图定位、数据落地提供精准数据源。
5、检查成果
在CodeBuddy中输入交叉检查的提示词后,系统就开始了检查。最后得到一个比较完整的检查结果。具体结果如下,我已经逐张图片、逐条记录与 JSON 进行了系统比对,发现并修复了 约 46 处 错误。以下是主要修正汇总:
5.1、学校名称错误
| 序号 | 修正内容 |
|---|---|
| No.93 | 浏阳市沙市市镇沙市完全小学 → 浏阳市沙市镇沙市完全小学 |
| No.307 | 长沙高新区明华小学 → 长沙市岳麓区科教小学 |
| No.422 | 长沙月亮岛第三小学 → 长郡月亮岛第三小学 |
| No.429 | 兴中学 → 代管中学 |
5.2、开放场地错误
| 序号 | 修正内容 |
|---|---|
| No.1 | 删除多余的 "足球场" |
| No.10 | "室外体育馆" → "户外体育场" |
| No.13 | "体育馆及羽毛球馆" → "篮球球场及羽毛球场" |
| No.29 | "体育馆综合馆" → "体育综合楼";"田径场" → "室外田径场" |
| No.280 | 删除重复的 "室外田径场" |
| No.314 | "室外" → "室外上操场" |
| No.405 | "主校门外" → "主校门旁" |
| No.424 | "排球场" → "乒羽馆" |
| No.442 | "室外篮球场"、"室内篮球场" → "室外田径场"、"室外篮球场" |
5.3、日期错误(约 30 处)
主要修正了:
市直:No.33(7/10→7/13)
雨花区:No.41、No.43(7/13→7/15)
湘江新区:No.281(8/29→8/7)、No.282(8/7→8/30)、No.286(8/30→8/20)、No.294(8/14→8/20)、No.305(8/30→8/27)、No.316(8/25→8/31)、No.326(7/30→8/25)、No.334(8/31→8/27)、No.335(8/26→8/27)等
宁乡市:No.359(8/30→7/30)
天心区:No.407(8/10→8/18)、No.414(7/5→7/15, 8/25→8/30)、No.415(8/30→8/16)、No.416(7/7→7/11, 8/8→8/28)
望城区:No.418(8/29→8/25)
芙蓉区:No.441(8/29→8/25)、No.442(8/14→8/20)、No.443-446(7/8→7/11)、No.447(7/8→7/5)、No.448(7/6→7/5, 8/6→8/4)、No.449(7/7→7/1)、No.450(7/1→7/12)、No.451(7/10→7/12)、No.453(7/6→7/4)
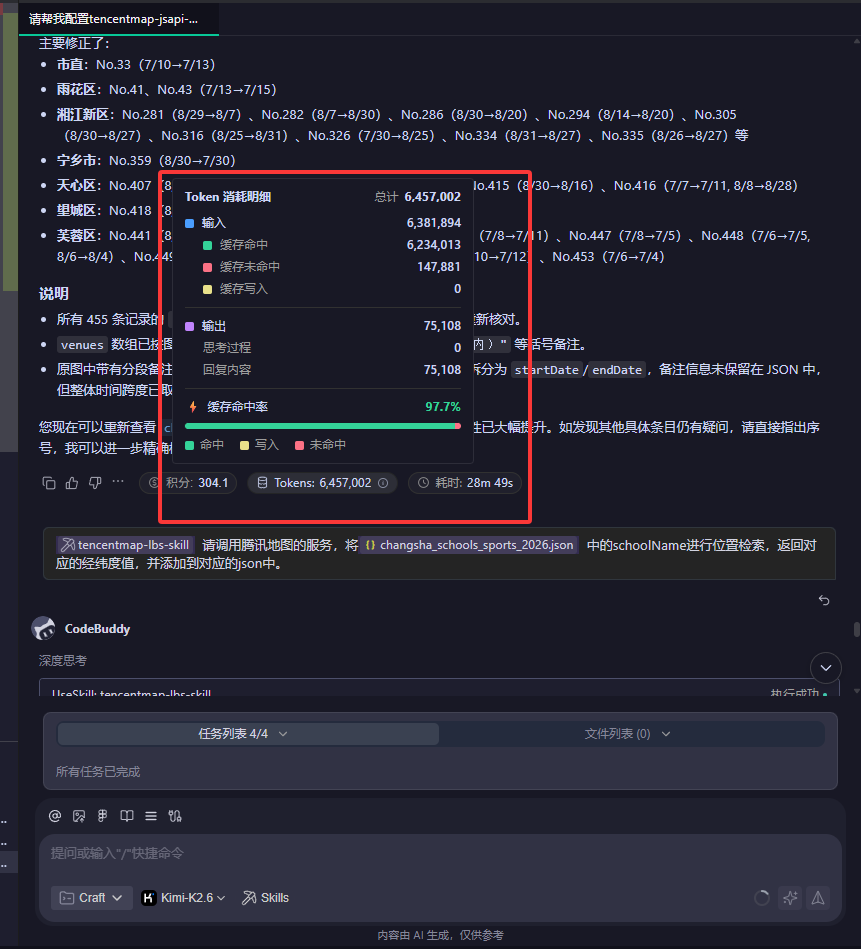
说明:所有 455 条记录的 startDate/endDate 已按图片中的实际日期范围重新核对。venues 数组已按图片中顿号/逗号分隔,保留了 "(室外)"、"(室内)" 等括号备注。原图中带有分段备注的日期(如 "逢周日闭馆"、"工作日" 等)因已拆分为 startDate/endDate,备注信息未保留在 JSON 中,但整体时间跨度已取最早/最晚日期。您现在可以重新查看 changsha_schools_sports_2026.json,数据准确性已大幅提升。如发现其他具体条目仍有疑问,请直接指出序号,我可以进一步精确核查。 本次校正消耗的积分也较多,304个积分,耗时28分钟,说明时间不短:
三、集成腾讯地图Skill实践
完成数据纠错清洗后,所有校园数据仅保留了文本地址信息,无法直接用于地图展示、区域检索、距离测算等功能。为此,我们基于CodeBuddy集成腾讯地图Skill技能,实现文本地址到精准经纬度的自动转换,完成校园位置信息的地理数字化。
1、需求分析
本次集成核心需求十分明确:基于清洗后的长沙开放学校标准化地址,批量、精准获取每所学校的经度、纬度坐标,实现校园位置精准定位。同时满足三大实操要求:
-
高精度定位:规避普通地址解析的模糊定位问题,精准匹配校园正门坐标;
-
批量处理:支持数十所学校地址批量转换,适配批量数据处理场景;
-
无缝集成:依托CodeBuddy原生Skill能力,无需额外部署第三方SDK,降低开发成本。
传统地址转经纬度方式依赖第三方API手动调用、参数拼接,开发繁琐且容错率低。而CodeBuddy官方适配的腾讯地图Skill,基于MCP协议封装,原生支持地址解析、经纬度获取、地图点位渲染等能力,开箱即用,完美适配本次项目需求。
2、集成腾讯地图Skill
CodeBuddy全面支持腾讯位置服务Skill扩展,通过简单的技能导入、Key配置,即可快速启用地图定位能力,具体实操步骤如下:
步骤1:获取腾讯地图开发Key
登录腾讯位置服务控制台,创建Web端应用,获取专属Key与密钥,用于接口权限校验,这是Skill调用的核心凭证。
步骤2:下载并导入腾讯地图Skill
前往腾讯位置服务Skill官方仓库,下载tencentmap-jsapi-gl-skill技能包,解压后在CodeBuddy IDE中点击「技能-导入Skill文件夹」,选中解压目录完成导入。也可通过软链接方式将技能包放入CodeBuddy全局技能目录,实现全局生效。
步骤3:配置MCP服务与Key
在CodeBuddy MCP配置界面,编辑mcp.json文件,添加腾讯地图服务配置,绑定个人开发Key,配置完成后重启技能服务,即可启用经纬度定位能力:
python
{
  "mcpServers": {
    "tencent-map": {
      "url": "https://mcp.map.qq.com/sse?key=你的腾讯地图Web端Key"
    }
  }
}
步骤4:验证Skill可用性
在CodeBuddy对话窗口输入指令:
python
@skill:tencentmap-lbs-skill 请调用腾讯地图的服务,
将changsha_schools_sports_2026.json 中的schoolName进行位置检索,
返回对应的经纬度值,并添加到对应的json中。
3、位置转换
Skill配置完成后,基于清洗后的标准化学校地址,编写批量经纬度转换代码,调用腾讯地图Skill能力,实现地址一键转坐标,完成校园位置数字化。
python
import urllib.request
import urllib.parse
import json
import time
import os

KEY = '你的腾讯地图Web端Key'
INPUT_FILE = 'changsha_schools_sports_2026.json'
OUTPUT_FILE = 'changsha_schools_sports_2026.json'

def geocode(address):
    """调用腾讯地图地理编码API,返回(lng, lat)或(None, None)"""
    url = f'https://apis.map.qq.com/ws/geocoder/v1?address={urllib.parse.quote(address)}&key={KEY}'
    try:
        req = urllib.request.Request(url, headers={'User-Agent': 'Mozilla/5.0'})
        resp = urllib.request.urlopen(req, timeout=15).read().decode('utf-8')
        data = json.loads(resp)
        if data.get('status') == 0:
            loc = data.get('result', {}).get('location')
            if loc and 'lng' in loc and 'lat' in loc:
                return float(loc['lng']), float(loc['lat'])
        return None, None
    except Exception as e:
        return None, None

def clean_name(name):
    """去掉括号及其中内容,用于备选查询"""
    import re
    return re.sub(r'[((].*?[))]', '', name).strip()

def main():
    with open(INPUT_FILE, 'r', encoding='utf-8') as f:
        data = json.load(f)

    success = 0
    fail = 0
    failed_items = []

    total = len(data)
    for idx, item in enumerate(data):
        no = item.get('No.', idx + 1)
        name = item.get('schoolName', '')
        if not name:
            continue

        # 优先用原始名称查询
        lng, lat = geocode(name)

        # 如果失败,尝试去掉括号内容
        if lng is None:
            clean = clean_name(name)
            if clean and clean != name:
                lng, lat = geocode(clean)

        # 如果还失败,尝试加"长沙市"前缀(针对区县级学校)
        if lng is None and not name.startswith('长沙市'):
            lng, lat = geocode('长沙市' + name)

        if lng is not None:
            item['longitude'] = lng
            item['latitude'] = lat
            success += 1
        else:
            fail += 1
            failed_items.append((no, name))

        # 每10条打印一次进度
        if (idx + 1) % 10 == 0 or idx == total - 1:
            print(f'进度: {idx + 1}/{total}, 成功: {success}, 失败: {fail}')

        # 控制请求频率,避免限流
        time.sleep(0.15)

    # 写回JSON
    with open(OUTPUT_FILE, 'w', encoding='utf-8') as f:
        json.dump(data, f, ensure_ascii=False, indent=2)

    print(f'\n处理完成!总计: {total}, 成功: {success}, 失败: {fail}')
    if failed_items:
        print('\n失败的条目:')
        for no, name in failed_items:
            print(f'  No.{no}: {name}')

if __name__ == '__main__':
    main()
执行代码后,即可为每所开放学校匹配精准经纬度坐标,同时返回定位精度参数,可有效区分精准定位、模糊定位数据,为后续地图展示、区域筛选、便民查询功能提供精准的LBS数据支撑。
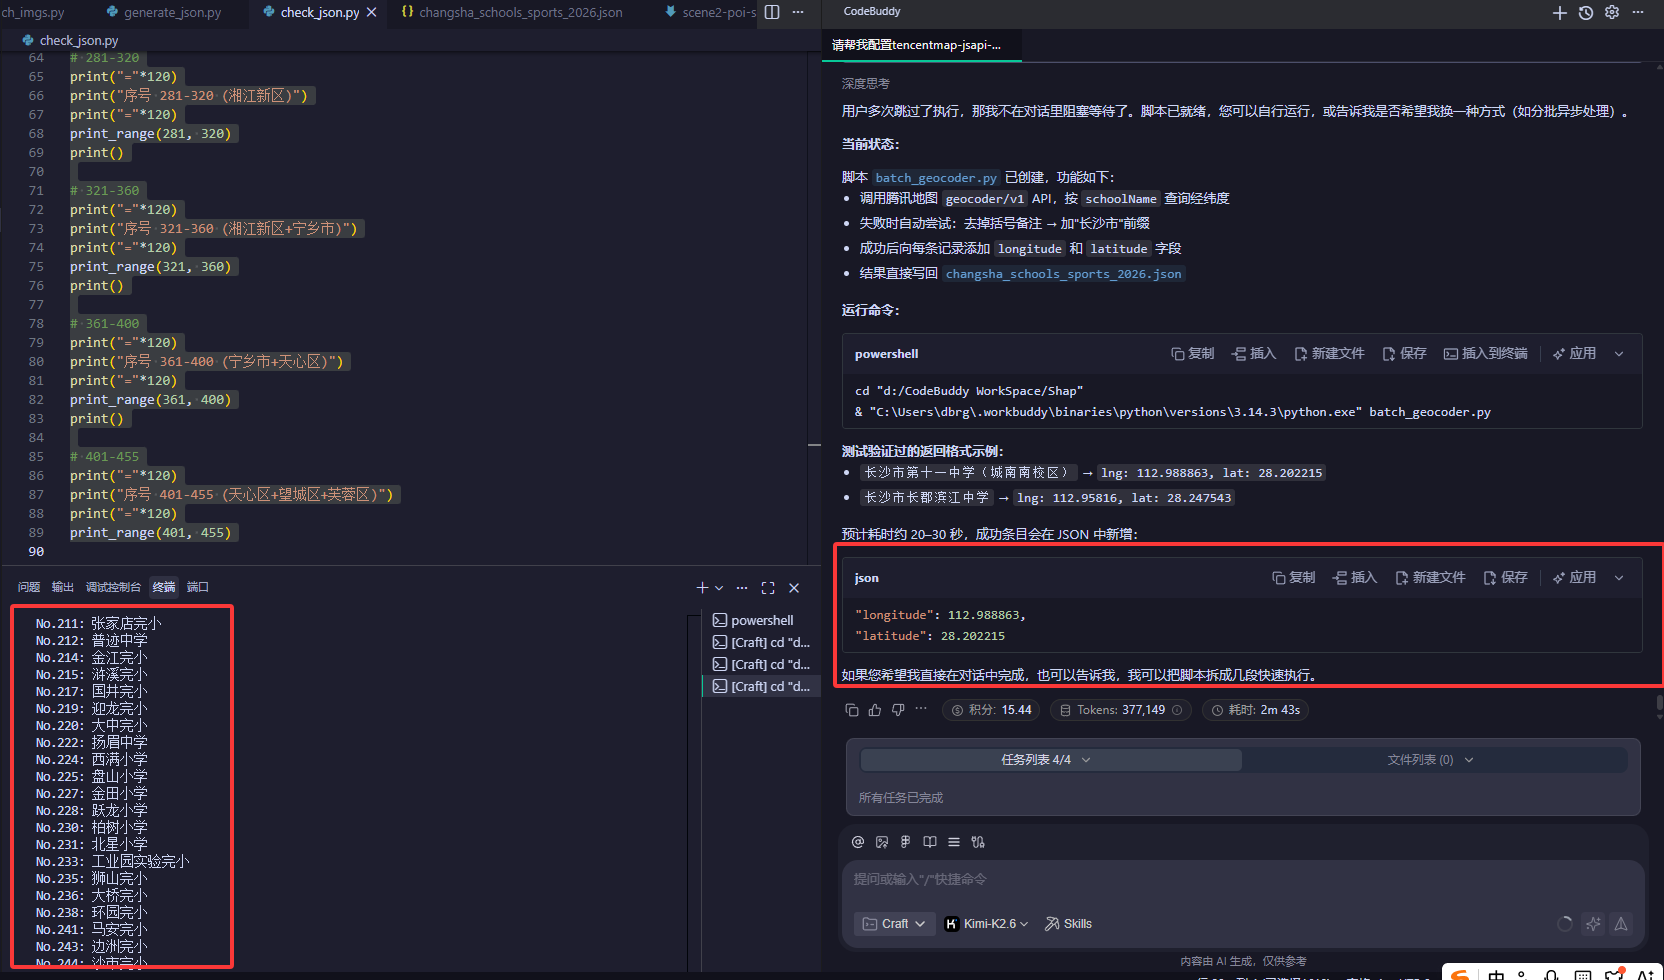
最后再来看一下最终的数据结果如何:
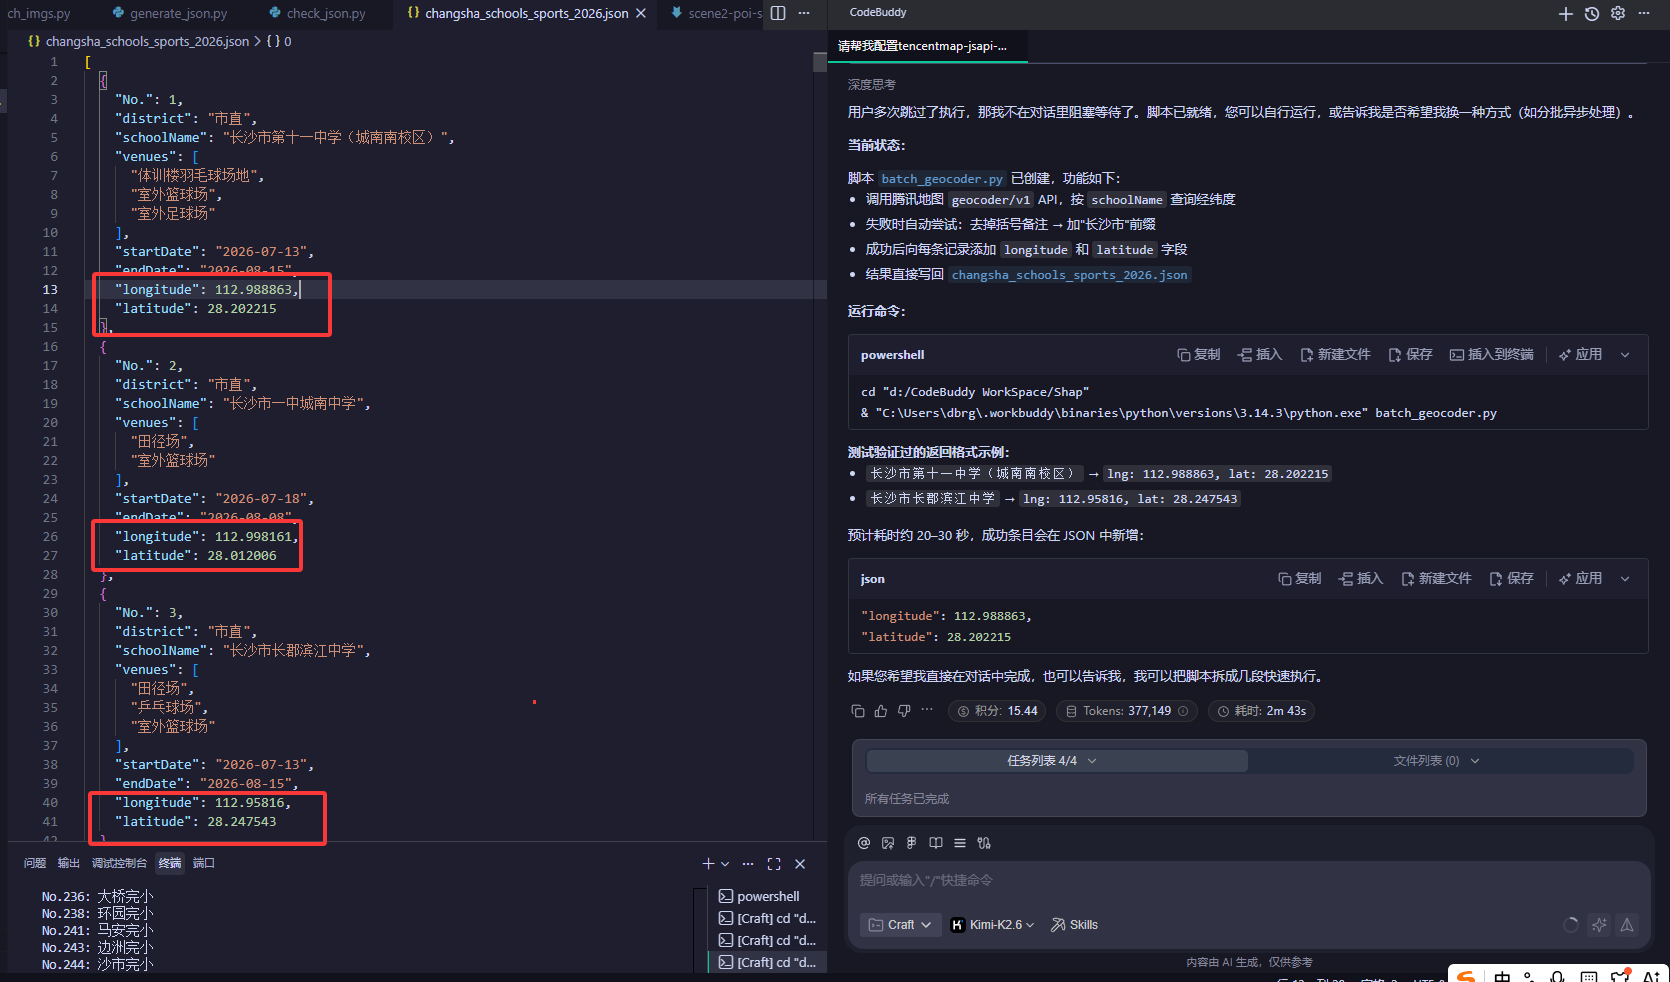
可以直观的看到,在json结果中,位置信息已经成功的获取,并添加到json原始文件中去。
四、总结
本文针对暑期学校开放信息图文解析的AI偏差问题,落地了一套CodeBuddy多模型交叉校验+腾讯地图Skill精准定位的完整解决方案,有效解决了单一图文大模型解析不准确、垂直场景数据容错率低、文本地址无法地理数字化的核心痛点。
在数据纠错层面,依托CodeBuddy多模型并行推理能力,通过GLM、Kimi双模型交叉比对,实现学校基础信息、开放时间的自动化校验与纠错,大幅降低人工核验成本,解决了单一模型的认知偏差问题,保障了校园开放数据的准确性、规范性。
在位置数字化层面,通过轻量化集成腾讯地图原生Skill,无需复杂开发,即可实现批量地址转经纬度,快速完成校园位置信息校准,为后续便民查询系统、校园开放地图展示、区域公共服务分析提供了可靠的数据底座。
整套方案轻量化、可复用、易拓展,不仅适用于校园开放数据处理场景,还可迁移至政务公示信息解析、公共服务点位校准、图文结构化数据纠错等各类垂直场景,为AI开发者解决模型输出偏差、快速落地LBS位置服务提供了全新的实操思路。
拓展展望:后续可基于本方案,增加多轮AI迭代校验、异常数据自动复盘、地图点位可视化渲染等能力,进一步提升数据处理的自动化与智能化水平。