为什么 InnoDB 使用 B+ 树作为索引,而不是 B 树、红黑树或 Hash?
InnoDB 使用 B+ 树,主要是因为数据库索引需要持久化到磁盘中,而磁盘随机 I/O 的成本很高,所以索引结构需要尽可能降低树的高度和磁盘页访问次数。
B+ 树是一种多叉平衡树,一个磁盘页可以存储大量索引键和子节点指针,因此分支数量多,树通常只有 3~4 层,查询时需要访问的磁盘页较少。
B 树的非叶子节点也存储数据,在固定磁盘页大小下,每个节点能容纳的索引键更少,导致分叉数更少 ,因此相同数据量下树高通常会高于 B+ 树。B+ 树非叶子节点只存索引键和子节点指针,扇出更大,可以减少磁盘 I/O。同时,所有记录都位于叶子节点,叶子节点按索引值有序排列并通过链表连接,非常适合范围查询、排序和顺序扫描。
红黑树属于二叉树,节点分支少,数据量较大时树高较高,如果用于磁盘索引,会产生更多磁盘页访问。
Hash 索引虽然适合等值查询,但数据是无序的,不支持高效的范围查询、排序和联合索引的最左前缀匹配。
跳表更适合内存场景,例如 Redis。它会产生较多指针跳转和随机内存访问,但 Redis 数据主要存储在内存中,因此不存在普通磁盘索引所关注的大量随机磁盘 I/O 问题。如果跳表用于磁盘索引,分散的节点访问反而可能导致较多随机 I/O。
因此,综合磁盘 I/O、树高、范围查询和排序等需求,InnoDB 选择 B+ 树作为主要索引结构。
什么是聚簇索引、二级索引、回表和覆盖索引?
假设表是:
sql
CREATE TABLE user (
    id INT PRIMARY KEY,
    name VARCHAR(20),
    age INT,
    INDEX idx_age(age)
);
聚簇索引的叶子节点存什么?
主键索引 id 是聚簇索引,它的叶子节点存放的是:id + name + age
二级索引的叶子节点存什么?
idx_age(age) 是二级索引,它的叶子节点存放的是:age + 主键 id
聚簇索引是什么?
聚簇索引就是叶子节点直接存放完整一行数据的索引。在 InnoDB 中,主键索引通常就是聚簇索引,所以通过主键查询时,找到索引就能直接拿到完整数据。
二级索引是什么?
二级索引就是除聚簇索引之外的普通索引。它的叶子节点不存完整数据,只存"索引字段和主键值"。
回表是什么?
使用二级索引查询时,先通过二级索引找到主键,再根据主键去聚簇索引中查询完整数据,这个再次查询的过程就叫回表。
覆盖索引是什么?
如果查询需要的字段在二级索引中已经全部存在,就可以直接返回结果,不需要再去聚簇索引中查询,这就叫覆盖索引。
例如:CREATE INDEX idx_age_name ON user(age, name);
SELECT name FROM user WHERE age = 20; 不需要回表,是覆盖索引
什么是联合索引的最左前缀原则?为什么 (A,B,C) 索引下,WHERE B=? AND A=? AND C=? 仍然可以走索引,而 A=? OR B=? 可能不行?
联合索引
(A,B,C)是先按 A 排序,A 相同时按 B 排序,A、B 都相同时再按 C 排序,所以索引使用一般要从最左列 A 开始。最左前缀原则与 WHERE 条件的书写顺序无关,因此
B=? AND A=? AND C=?中同时存在 A、B、C,优化器可以按照索引顺序使用完整联合索引。而
A=? OR B=?中,AND中可以先确定 A,再查 B;OR中满足 B 的数据不一定满足 A,所以 B 这一支缺少最左列 A,可能无法使用(A,B,C)联合索引。
| 查询条件 | 索引使用情况 |
|---|---|
A = ? |
可以使用 A |
A = ? AND B = ? |
可以使用 A、B |
A = ? AND B = ? AND C = ? |
可以使用 A、B、C |
B = ? AND A = ? |
可以使用 A、B,条件顺序无影响 |
B = ? |
通常不能有效使用联合索引定位 |
A = ? AND C = ? |
A 可用于定位,C 通常不能连续用于定位 |
A > ? AND B = ? |
A 用于范围定位,B 通常不能继续缩小索引扫描范围 |
A = ? OR B = ? |
可能无法使用该联合索引,或使用索引合并 |
哪些情况可能导致索引无法高效使用?
重点包括:前置模糊查询、对索引列使用函数或计算、隐式类型转换、联合索引缺少最左列、范围查询影响后续索引列。
联合索引不满足最左前缀原则;
对索引列使用函数或计算;
索引字段发生隐式类型转换;
关联字段的字符集或排序规则不同,导致隐式转换;
.
LIKE查询以%开头;
OR的混用;使用
!=、NOT IN、NOT LIKE等否定条件;查询返回的数据量过大或回表次数过多,优化器认为全表扫描成本更低。
不满足最左前缀原则
联合索引:
sql
INDEX idx_abc(A, B, C)
sql
WHERE B = 2;缺少最左列 A,通常不能高效使用联合索引。
联合索引中间断开
sql
WHERE A = 1 AND C = 3;可以使用 A,但跳过了 B,C 通常不能继续用于索引定位。
对索引列使用函数或计算
sql
WHERE YEAR(create_time) = 2026;
WHERE age + 1 = 20;
可以改成:
sql
WHERE create_time >= '2026-01-01'
  AND create_time < '2027-01-01';

WHERE age = 19;
发生隐式类型转换
phone 是 VARCHAR:
sql
WHERE phone = 13800138000;应写成:
sql
WHERE phone = '13800138000';否则可能对索引列进行类型转换。
LIKE 以 % 开头
sql
WHERE name LIKE '%张%';通常不能高效使用普通 B+ 树索引。
sql
WHERE name LIKE '张%';通常可以使用索引。
OR 中一边没有可用索引
联合索引是 (A,B,C):
sql
WHERE A = 1 OR B = 2;A=1 可以走索引,OR 中满足 B 的数据不一定满足 A,所以 B 这一支缺少最左列 A,可能无法使用 (A,B,C) 联合索引,所以整体可能全表扫描。
使用否定条件
sql
WHERE age != 20;
WHERE id NOT IN (1, 2, 3);
WHERE name NOT LIKE '张%';
查询结果太多或回表太多
sql
SELECT *
FROM user
WHERE gender = 1;
如果全表大部分数据都是 gender=1,走索引需要大量回表,MySQL 可能直接全表扫描。
如何使用 EXPLAIN 判断 SQL 是否走索引?
重点掌握:type、possible_keys、key、key_len、rows、Extra,以及 Using index 和 Using index condition 的区别。
使用
EXPLAIN查看 SQL 执行计划,主要看这几个字段:
possible_keys:可能使用的索引;为NULL表示没有合适的索引。
key:实际使用的索引;key不为NULL,说明走了索引。
type:查询方式,常见性能由好到差为:const > eq_ref > ref > range > index > ALL
其中
ALL是全表扫描,index是全索引扫描。
rows:预计扫描的行数,通常越少越好。Extra:额外信息,Using index表示覆盖索引;Using filesort表示额外排序;Using temporary表示使用临时表。一句话记忆:看
key判断有没有走索引,看type、rows和Extra判断索引走得好不好。
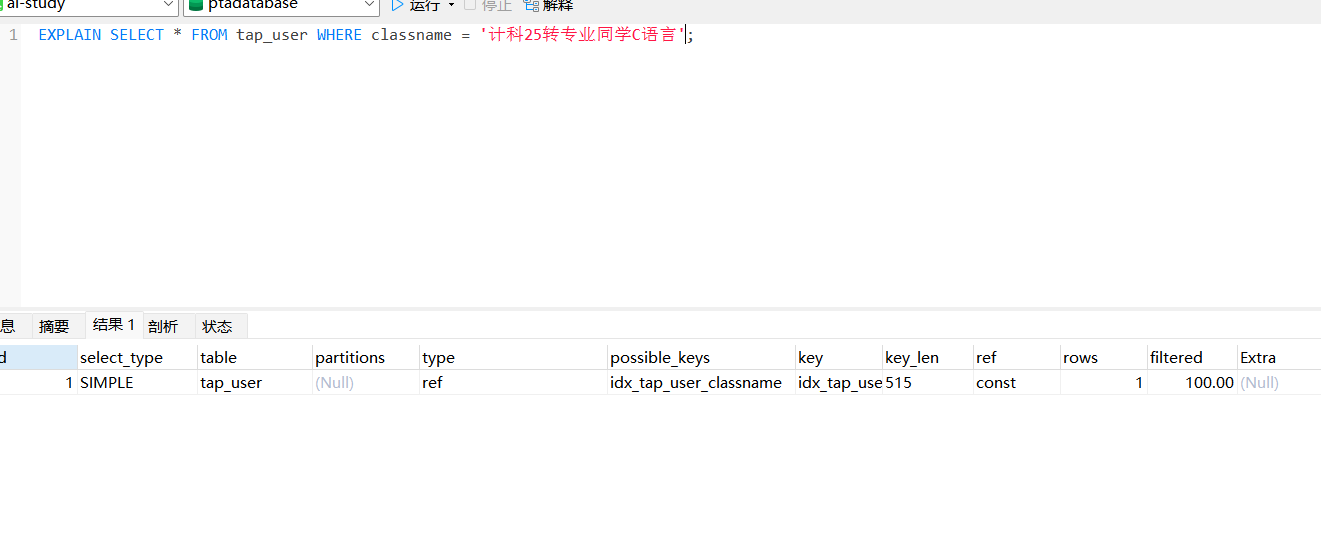
重点看这些字段:
possible_keys = idx_tap_user_classname
表示优化器认为classname上的索引可以使用。key = idx_tap_user_classname
表示最终确实选择了这个索引。判断是否走索引,主要看key是否为NULL。type = ref
表示通过普通非唯一索引进行等值查询,属于比较好的访问方式。ref = const
表示拿一个固定值:计科25转专业同学C语言去索引中查找。rows = 1
优化器预计只需要扫描一条记录,说明这个条件的区分度较好。filtered = 100%
表示扫描到的记录预计全部符合条件,不需要再过滤大量数据。Extra = NULL
没有出现Using filesort、Using temporary等额外操作。