AI 视频识别接入架构与优化:无人机视频流的智能分析
无人机装上摄像头只是「眼睛」,加上 AI 才是「大脑」。但 AI 模型不能直接看 H265 码流,它需要的是一张张图片帧。从视频流到 AI 识别结果,中间有架构选型、性能优化、延迟平衡等一系列问题。本文记录完整的 AI 视频识别接入方案。
一、AI 为什么不能直接「看」视频流
AI 模型(如 YOLO、ResNet)的输入是图像矩阵------RGB 或 YUV 格式的像素数据。而视频流是压缩后的编码数据(H264/H265),本质是一串二进制码流,AI 无法直接处理。
所以必须在视频流和 AI 模型之间加一个解码环节。这个解码放在哪里、怎么放,就是架构设计的核心问题。
二、三种 AI 接入方案对比
方案一:流前接入(旁路解码)
在视频流推送到 ZLMediaKit 之前,先分一路给 AI 服务:
| 维度 | 评价 |
|---|---|
| 延迟 | 最低(没有经过流媒体服务器中转) |
| 实现复杂度 | 高(需要推流端支持分流) |
| 流管理 | 差(AI 和流媒体是两套独立链路) |
| 适用场景 | 无人机本地端侧 AI(机载 AI 芯片) |
典型场景:大疆 M300 搭载 Jetson Nano,视频在机载芯片上直接解码 + AI 识别,只把识别结果回传到地面,不传视频流。延迟最低,但需要无人机有足够算力。
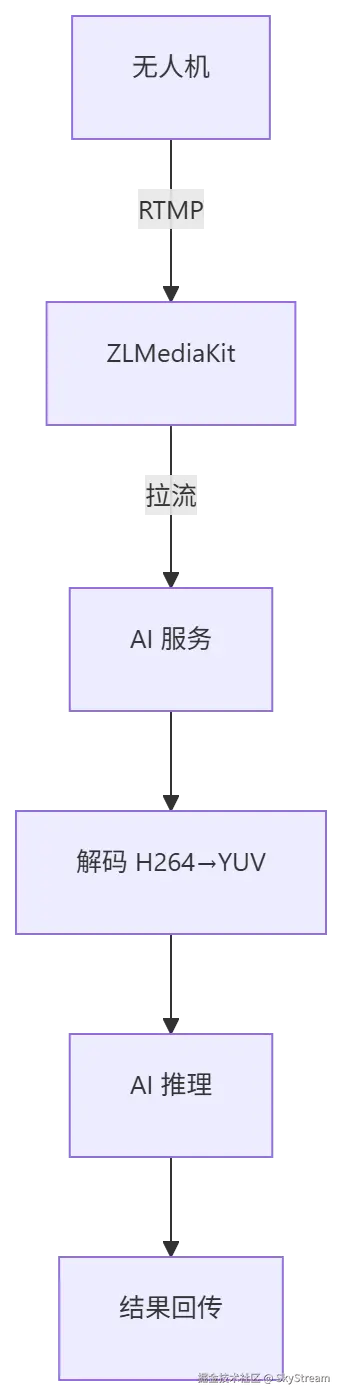
方案二:流后接入(服务端解码)
视频流先到 ZLMediaKit,AI 服务从 ZLMediaKit 拉流解码:
| 维度 | 评价 |
|---|---|
| 延迟 | 中(多一次拉流 + 解码) |
| 实现复杂度 | 低(AI 服务只需对接 ZLMediaKit 拉流地址) |
| 流管理 | 好(所有流统一在 ZLMediaKit 管理) |
| 适用场景 | 服务端集中 AI 分析(推荐) |
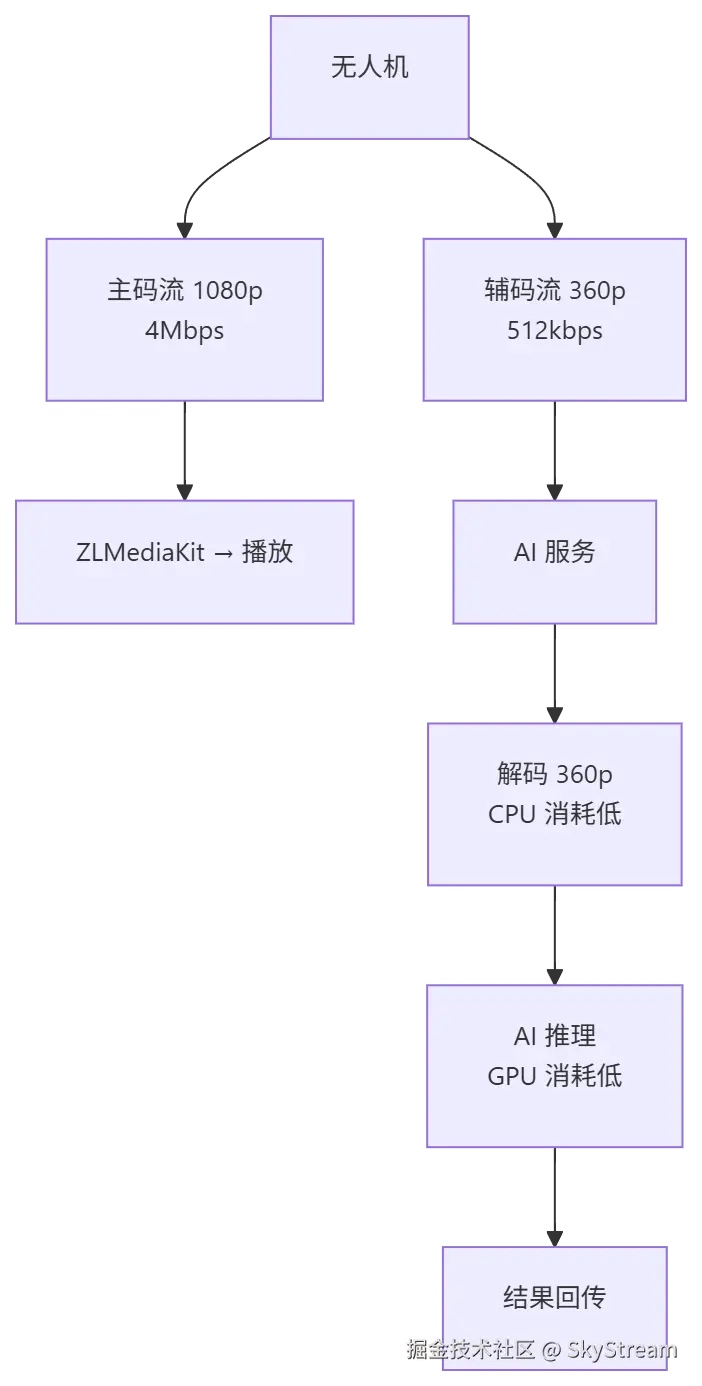
方案三:小流接入(推荐)
大流用于高清播放,小流用于 AI 分析:
| 维度 | 评价 |
|---|---|
| 延迟 | 中(同方案二) |
| GPU 消耗 | 低(360p 解码 + 推理远省于 1080p) |
| 网络消耗 | 低(512kbps vs 4Mbps) |
| 识别精度 | 够用(目标检测 360p 足够) |
| 适用场景 | 多路无人机并发 AI 分析(强烈推荐) |
为什么 360p 够用?
以 YOLOv8 为例,默认输入尺寸 640x640。360p(640x360)缩放到 640x640 后,目标检测精度几乎无损。只有需要识别远处小目标(如电力线巡检中的绝缘子缺陷)才需要 1080p。
三种方案汇总对比
| 维度 | 方案一:流前接入 | 方案二:流后接入 | 方案三:小流接入 |
|---|---|---|---|
| 延迟 | 最低 | 中 | 中 |
| GPU 消耗 | 取决于分辨率 | 高(1080p) | 低(360p) |
| 实现复杂度 | 高 | 低 | 低 |
| 多路并发 | 受限于机载算力 | 受限于服务器 GPU | 最优 |
| 推荐度 | 特殊场景 | 一般 | ⭐ 强烈推荐 |
三、AI 服务架构设计
3.1 整体架构
3.2 技术选型
| 模块 | 选型 | 说明 |
|---|---|---|
| 流拉取 | FFmpeg / OpenCV | 从 ZLMediaKit 拉 HTTP-FLV 或 RTSP |
| 视频解码 | NVDEC(GPU)/ FFmpeg(CPU) | GPU 解码性能高 10 倍 |
| AI 推理 | TensorRT | 比 PyTorch 推理快 3-5 倍 |
| AI 模型 | YOLOv8 / YOLOv5 | 目标检测主流选择 |
| 结果回传 | Kafka + WebSocket | Kafka 做异步解耦,WebSocket 做实时推送 |
| 部署 | Docker + GPU | 容器化部署,GPU 直通 |
四、解码实战:从视频流到图像帧
4.1 FFmpeg 拉流解码(CPU 版)
python
import subprocess
import numpy as np

def decode_stream(stream_url):
    """
    从 ZLMediaKit 拉流并解码为图像帧
    """
    # FFmpeg 命令:拉流 → 解码 → 输出原始 YUV 帧
    cmd = [
        'ffmpeg',
        '-i', stream_url,              # 输入流地址
        '-f', 'rawvideo',              # 输出格式:原始视频
        '-pix_fmt', 'bgr24',           # 像素格式:BGR(OpenCV 兼容)
        '-s', '640x360',               # 分辨率
        '-r', '15',                    # 帧率(AI 不需要 30fps,15fps 够用)
        '-'                            # 输出到 stdout
    ]

    pipe = subprocess.Popen(cmd, stdout=subprocess.PIPE, bufsize=10**8)

    frame_size = 640 * 360 * 3  # BGR24 = 3 bytes per pixel

    while True:
        raw_frame = pipe.stdout.read(frame_size)
        if len(raw_frame) != frame_size:
            break

        # 转换为 numpy 数组
        frame = np.frombuffer(raw_frame, dtype=np.uint8).reshape((360, 640, 3))

        yield frame

    pipe.terminate()

# 使用
for frame in decode_stream('http://server:8080/uav/uav_001_sub.live.flv'):
    # frame 就是解码后的图像帧,可以直接送入 AI 模型
    results = model(frame)
4.2 GPU 硬件解码(NVDEC)
多路并发时,CPU 解码扛不住,必须用 GPU:
python
def decode_stream_gpu(stream_url):
    """
    使用 NVDEC 硬件解码
    """
    cmd = [
        'ffmpeg',
        '-hwaccel', 'cuda',           # 启用 CUDA 硬件加速
        '-hwaccel_output_format', 'cuda',
        '-i', stream_url,
        '-f', 'rawvideo',
        '-pix_fmt', 'bgr24',
        '-s', '640x360',
        '-r', '15',
        '-c:v', 'h264_cuvid',         # 使用 CUVID 硬件解码器
        '-'
    ]
    # 后续逻辑同上
4.3 性能对比
| 方案 | 单路 CPU/GPU 占用 | 10 路并发 | 说明 |
|---|---|---|---|
| CPU 解码 1080p | 40% CPU | 不可行 | 单路就吃掉近半核 |
| CPU 解码 360p | 8% CPU | 80% CPU | 勉强可行 |
| NVDEC 解码 1080p | 2% GPU | 20% GPU | 轻松 |
| NVDEC 解码 360p | 0.5% GPU | 5% GPU | 极轻量 |
结论:小流 + NVDEC 硬件解码,是多路并发的最优组合。
五、AI 推理实战:YOLO + TensorRT
5.1 为什么用 TensorRT
| 推理方式 | 1080p 单帧延迟 | 说明 |
|---|---|---|
| PyTorch(FP32) | 45-60ms | 开发调试用 |
| ONNX Runtime(FP32) | 30-40ms | 比 PyTorch 快 |
| TensorRT(FP16) | 8-12ms | 生产环境推荐 |
| TensorRT(INT8) | 4-6ms | 精度略降,速度最快 |
TensorRT 针对具体 GPU 做了内核级优化,推理速度比原生 PyTorch 快 5-8 倍。
5.2 模型转换流程
css
graph LR
    A[YOLOv8 PyTorch<br/>.pt] -->|导出| B[ONNX<br/>.onnx]
    B -->|TensorRT 编译| C[TensorRT Engine<br/>.engine]
    C --> D[推理部署]
ini
from ultralytics import YOLO

# 1. 导出 ONNX
model = YOLO('yolov8s.pt')
model.export(format='onnx', imgsz=640, simplify=True)

# 2. 转换为 TensorRT Engine(命令行)
# trtexec --onnx=yolov8s.onnx --saveEngine=yolov8s.engine --fp16
5.3 推理代码
python
import tensorrt as trt
import pycuda.driver as cuda
import numpy as np

class TRTInference:
    def __init__(self, engine_path):
        self.runtime = trt.Runtime(trt.Logger())
        with open(engine_path, 'rb') as f:
            self.engine = self.runtime.deserialize_cuda_engine(f.read())
        self.context = self.engine.create_execution_context()

        # 分配 GPU 内存
        self.d_input = cuda.mem_alloc(1 * 3 * 640 * 640 * 4)  # FP32
        self.d_output = cuda.mem_alloc(1 * 84 * 8400 * 4)
        self.stream = cuda.Stream()

    def infer(self, input_image):
        # 预处理:resize + normalize + NCHW
        input_data = self.preprocess(input_image)

        # 拷贝到 GPU
        cuda.memcpy_htod_async(self.d_input, input_data, self.stream)

        # 推理
        self.context.execute_async_v2(
            bindings=[int(self.d_input), int(self.d_output)],
            stream_handle=self.stream.handle
        )

        # 拷贝回 CPU
        output = np.empty(1 * 84 * 8400, dtype=np.float32)
        cuda.memcpy_dtoh_async(output, self.d_output, self.stream)
        self.stream.synchronize()

        # 后处理:NMS
        return self.postprocess(output)

# 使用
trt_model = TRTInference('yolov8s.engine')

for frame in decode_stream_gpu('http://server:8080/uav/uav_001_sub.live.flv'):
    results = trt_model.infer(frame)
    # results: [{class: 'person', confidence: 0.92, bbox: [x,y,w,h]}, ...]
六、延迟优化策略
6.1 完整链路延迟拆解
less
graph LR
    A[设备编码<br/>~50ms] --> B[网络传输<br/>~100ms]
    B --> C[ZLMediaKit 接收<br/>~10ms]
    C --> D[AI 拉流<br/>~50ms]
    D --> E[解码<br/>~20ms]
    E --> F[AI 推理<br/>~10ms]
    F --> G[结果回传<br/>~30ms]

    style A fill:#ff9999
    style B fill:#ff9999
    style E fill:#99ccff
style F fill:#99ccff| 环节 | 延迟 | 可优化空间 |
|---|---|---|
| 设备编码 | 50ms | 低(硬件决定) |
| 网络传输 | 100-300ms | 中(取决于网络质量) |
| ZLMediaKit 接收 | 10ms | 低 |
| AI 拉流 | 30-50ms | 中(用本地拉流降低) |
| 解码 | 10-20ms | 低(已用 GPU) |
| AI 推理 | 8-12ms | 低(已用 TensorRT) |
| 结果回传 | 20-50ms | 中(用 WebSocket) |
| 总计 | 230-500ms |
6.2 关键优化点
优化一:降低 AI 分析帧率
AI 不需要 30fps 全量分析。对于目标检测,5-10fps 完全够用:
ini
frame_count = 0
for frame in decode_stream_gpu(stream_url):
    frame_count += 1
    if frame_count % 3 != 0:  # 每3帧分析1次,约10fps
        continue
    results = trt_model.infer(frame)
帧率从 30fps 降到 10fps,GPU 占用降低 66%,延迟不变(因为单帧推理速度没变,但排队少了)。
优化二:AI 服务与 ZLMediaKit 同机部署
拉流延迟从 50ms 降到 5ms(本地 loopback):
跨机拉流:30-50ms
同机拉流:3-5ms
但要注意 GPU 资源争抢,ZLMediaKit 的转码和 AI 推理共享同一张 GPU 时需要做好资源隔离。
优化三:异步管道
解码和推理并行,不要串行等待:
ini
import threading
from queue import Queue

frame_queue = Queue(maxsize=3)  # 最多缓存3帧

# 线程1:持续解码
def decode_thread():
    for frame in decode_stream_gpu(stream_url):
        if not frame_queue.full():
            frame_queue.put(frame)

# 线程2:持续推理
def infer_thread():
    while True:
        frame = frame_queue.get()
        results = trt_model.infer(frame)
        send_result(results)

threading.Thread(target=decode_thread, daemon=True).start()
threading.Thread(target=infer_thread, daemon=True).start()
6.3 优化效果对比
| 优化措施 | 端到端延迟 | GPU 占用 |
|---|---|---|
| 优化前(30fps + 跨机 + 串行) | 500-800ms | 45% |
| 降帧率(10fps) | 500-800ms | 18% |
| 同机部署 | 450-700ms | 18% |
| 异步管道 | 300-400ms | 18% |
| 全部优化 | 300-400ms | 18% |
七、多路并发 AI 分析
7.1 GPU 资源规划
| GPU 型号 | 显存 | NVDEC 数量 | 可并发路数(360p + YOLOv8s) | 参考价格 |
|---|---|---|---|---|
| RTX 3060 | 12GB | 2 | 8-10 路 | ¥2500 |
| RTX 4060 | 8GB | 1 | 6-8 路 | ¥2800 |
| RTX 4090 | 24GB | 3 | 20-25 路 | ¥16000 |
| A10 | 24GB | 4 | 25-30 路 | ¥30000+ |
注意:NVDEC 数量比显存更关键。一张 RTX 4060 虽然只有 8GB 显存,但 NVDEC 限制为 1 路,多路解码会排队。RTX 3060 有 2 个 NVDEC,反而更适合多路场景。
7.2 多路调度策略
python
class MultiStreamScheduler:
    def __init__(self, max_concurrent=8):
        self.max_concurrent = max_concurrent
        self.active_streams = {}  # stream_id -> inference_thread

    def add_stream(self, stream_id, stream_url):
        if len(self.active_streams) >= self.max_concurrent:
            # 超过并发上限,排队等待
            return False, "GPU 资源已满,请稍后重试"

        thread = InferenceThread(stream_id, stream_url)
        thread.start()
        self.active_streams[stream_id] = thread
        return True, "已启动 AI 分析"

    def remove_stream(self, stream_id):
        if stream_id in self.active_streams:
            self.active_streams[stream_id].stop()
            del self.active_streams[stream_id]
7.3 结果回传与业务联动
AI 识别结果需要实时推送到前端,同时持久化到数据库:
css
# 识别结果处理
def handle_result(stream_id, detections):
    # 1. WebSocket 实时推送到前端
    websocket_manager.broadcast(stream_id, {
        "type": "ai_detection",
        "stream_id": stream_id,
        "detections": detections,
        "timestamp": time.time()
    })

    # 2. 重要事件写入数据库(如检测到人、车)
    important_events = [d for d in detections if d['confidence'] > 0.8]
    if important_events:
        db.save_event(stream_id, important_events)

    # 3. 触发告警(如禁区入侵)
    if has_intrusion(detections):
        alert_service.send_alert(stream_id, "检测到禁区入侵")
八、总结
| 决策点 | 推荐方案 | 核心理由 |
|---|---|---|
| AI 接入方式 | 小流接入 | 省 GPU、省网络、精度够用 |
| 解码方式 | NVDEC 硬件解码 | 比 CPU 快 10 倍 |
| 推理引擎 | TensorRT FP16 | 比 PyTorch 快 5-8 倍 |
| 分析帧率 | 10fps | 目标检测不需要 30fps |
| 部署方式 | 与 ZLMediaKit 同机 | 降低拉流延迟 |
| 多路并发 | 按 NVDEC 数量规划 | NVDEC 比 GPU 更关键 |
核心原则:用最小的算力做最多的事。小流降低解码开销,降帧率降低推理开销,TensorRT 加速单帧推理,异步管道消除等待。每个环节省一点,整体就能多扛几路。
上一篇 :无人机系列-篇二-ZLMediaKit多路流管理与分发
系列完结:三篇文章覆盖了无人机视频云平台从采集编码、流管理分发到 AI 智能分析的完整技术链路。如果这个系列对你有帮助,欢迎点赞收藏,后续会分享更多无人机 + AI 的实战经验。
有问题评论区交流 🚀