背景:为什么 Agent 时代需要智能路由
随着大模型(LLM)、RAG、多智能体(Multi-Agent)技术的发展,越来越多企业开始尝试将传统业务系统进行 AI 化改造。
目前企业落地 Agent 的主要方向有两类:
- 现有系统智能化
- 给客服系统增加智能问答能力
- 给数据平台增加自然语言查询能力
- 给 BI 系统增加 AI 分析能力
- 给研发平台增加 AI 运维助手
- 使用 Agent 重构业务流程
- 一个超级 Agent 拆解任务
- 多个领域 Agent 协同完成复杂任务
- Agent 自动调用工具完成业务闭环
例如,一个企业数据中台 AI Agent:
帮我查询昨天北京地区 GMV,并生成日报
背后可能涉及:
用户
 |
 |
数据分析Agent
 |
 +---- 指标Agent
 |
 +---- SQL生成Agent
 |
 +---- 数据查询Agent
 |
 +---- 报表Agent
 |
 +---- 总结Agent
问题来了:
**用户请求进入系统后,如何知道应该交给哪个 Agent?**这就是 Agent 智能路由(Agent Router)解决的问题。
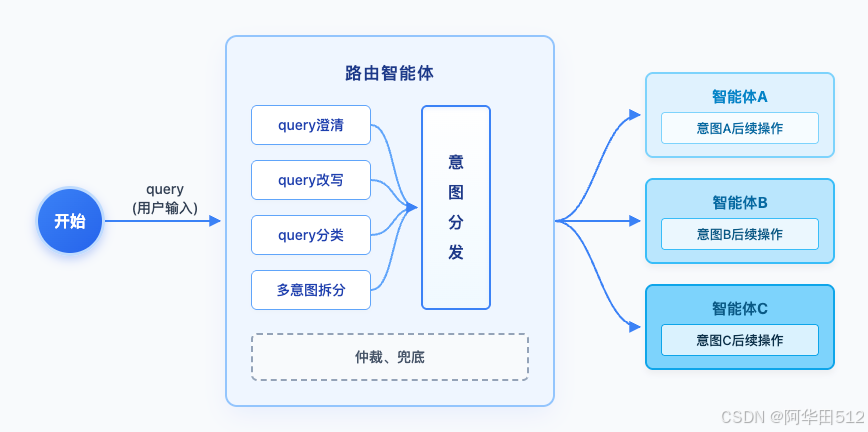
二.路由的常见实现模式
前面讲到,路由之所以能做出合理的分发决策是因为能理解用户输入的内容,最常见的输入内容是自然语言的文本表达,如"我要退货"。因此根据意图分析理解的手段可以把路由实现模式分为以下四种模式:
基于规则的路由:
在机器学习流行以前,这是主要的一种实现方式,也是早期NLP的常见做法。大致实现过程是:预先枚举定义出一系列的说法规则并编译成对应引擎的格式,比如正则表达式、前缀树、开源或自研的规则引擎。然后在运行时对用户输入进行匹配,按照阈值计算是否满足。最简单的匹配是关键词匹配、正则匹配。复杂一点利用前缀树或规则引擎进行匹配。
这种模式的好处是比较容易组织代码完成规则的预先定义,运行时的响应速度快,比下面三种模式的响应时间都快且结果可预知。不好的点是泛化性不足,遇到用户灵活表达时一定会捉襟见肘,显得不那么智能。
基于小模型的路由:
这里说的小模型是相对大语言模型的百亿千亿参数而言。换句话说小模型的参数也可以达到亿级别。小模型也是采用机器学习方式训练出来的模型。路由任务属于判别和分类这类模式。既然是机器学习,模型训练一样需要经过收集数据样本、数据标注、在基模上监督微调。
小模型在泛化性方面比规则模式高很多,在响应时间方面比大模型快很多。因此是实际项目落地的首选。毕竟分类这个任务不需要用到大模型的生成能力。
基于大模型LLM的路由:
我们都知道大模型能做很多事情,自然包括分类任务。用大模型来做分类可以直接写提示词prompt,也可以继续做SFT微调。写提示词要考验分类种类的边界设计、典型样例的选取,同时要写清楚需要让大模型输出哪种格式的结果。往往以某种约定的标识符或指令呈现,比如json格式。
举例:用户输入的内容可能是"xx商品双11有哪些优惠"、"我看要下订单xx的物流进度"、"我要退货",可以用提示词调用大模型对用户输入进行分类,根据下游的模块情况给出候选分类:商品信息、订单、物流、售后、其他。
大模型模式的好处是不用预先做工作,用提示词就可以完成冷启动,验证业务流程。根据业务要求的效果指标再看是否需要微调。当然微调需要大模型训练环境,大概率需要算法策略人员参与。另外不好的地方就是响应时间长达几秒。遇到bad case不好修复,修改提示词往往会按下葫芦起了瓢。
基于嵌入Embedding的路由:
嵌入模式本质就是根据输入内容进行向量化检索。把用户请求内容进行向量化,查询向量库,得到语义最相似的结果,根据结果分发到对应模块。这个模式在传统基于关键词检索的基础上加入了语义理解,也就是说能对用户输入的内容给予语义层面的分析。
嵌入的前提是要用RAG技术先建立向量库,需提前准备样本,每个样本包括用户输入及对应分类。算是RAG技术诸多应用场景的一个。对比前面大小模型的模式,嵌入用到的技术组件都比较成熟了,不太需要专门的算法策略人员,靠软件工程人员也能完成落地。
| | | | | |
|-------|-----|------|-------|------------|--------------------|
| 模式 | 准确度 | 响应时间 | 落地复杂度 | bad case修复 | 注意事项 |
| 规则路由 | 低 | 毫秒级 | 容易 | 容易 | 适合输入简单,准确度要求低的场景 |
| 小模型路由 | 高 | 秒级以下 | 中等 | 中等 | 需要算法工程师参与,依赖数据样本质量 |
| 大模型路由 | 高 | 几秒级 | 容易 | 难 | 依赖基础大模型效果 |
| 嵌入路由 | 中 | 秒级以下 | 中等 | 中等 | 依赖向量计算服务、依赖数据样本质量 |