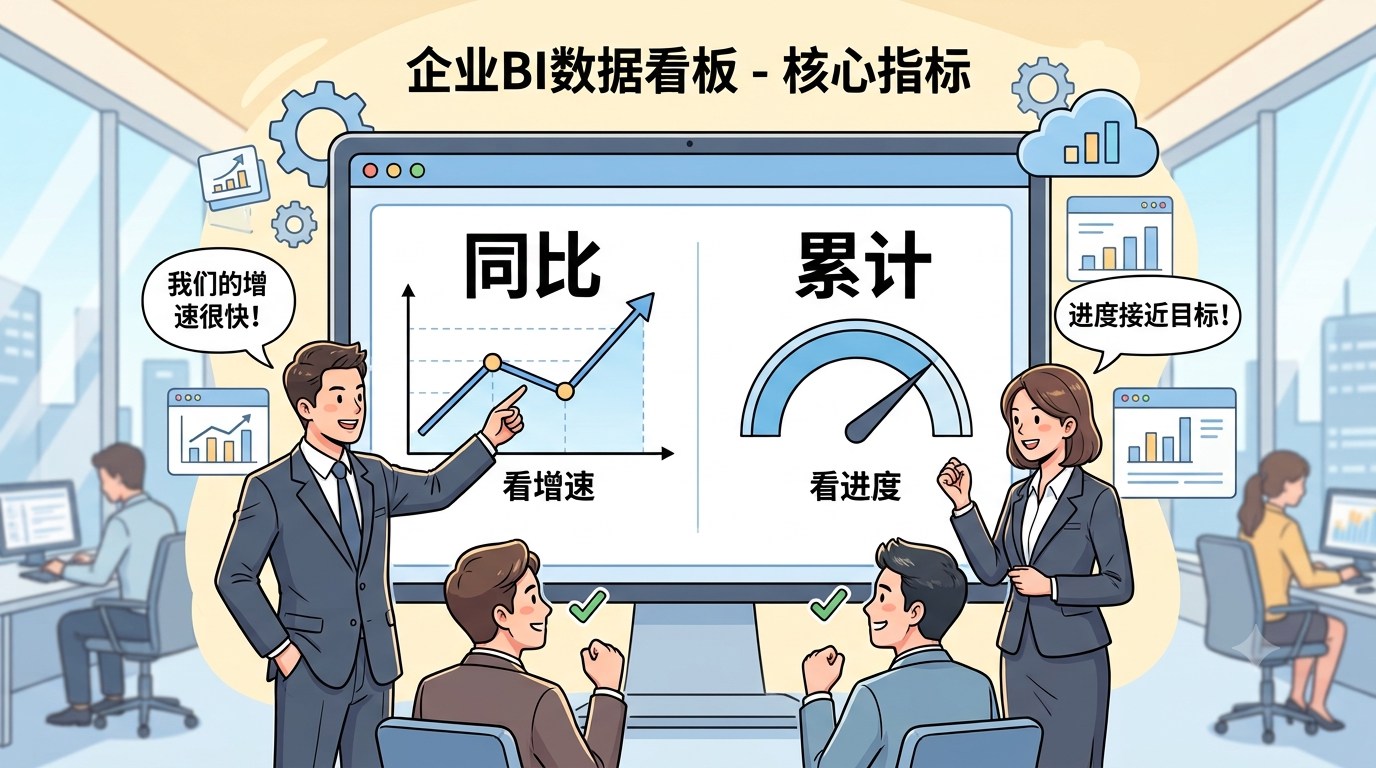
在做企业BI数据看板时,管理层最关心的核心指标莫过于同比和累计。一个看增速,一个看进度。
在实际开发中,数仓团队经常会遇到两种让人头疼的问题:
**计算同比时:**某条业务线因为市场调整,今年二季度停产没数。在同比报表上,它不仅没显示同比下降100%,反而直接从列表里隐身了,导致大盘的整体增长率被虚高。
**计算累计时:**某个大区因为放假,连续几天没有产生交易流水。按理说,之前的历史累计额应当保持不变,但只要在看板上筛选这几天,该大区的年累计销售额就会归零或直接变空白,数据连贯性出现问题。
这种现象并不是前端报表软件出了Bug,而是ETL开发人员在写脚本时,落入了一个隐形陷阱------交易流水数据的不连续导致维度丢失。
1. 数据不连续的逻辑漏洞
传统的数仓开发,最习惯直接拿订单明细等事实表进行关联或开窗计算。但业务流水的特点是离散的------没有交易,业务流水事实表里就不会产生任何记录。这种无事留白的特性,会导致两个严重的指标失真:
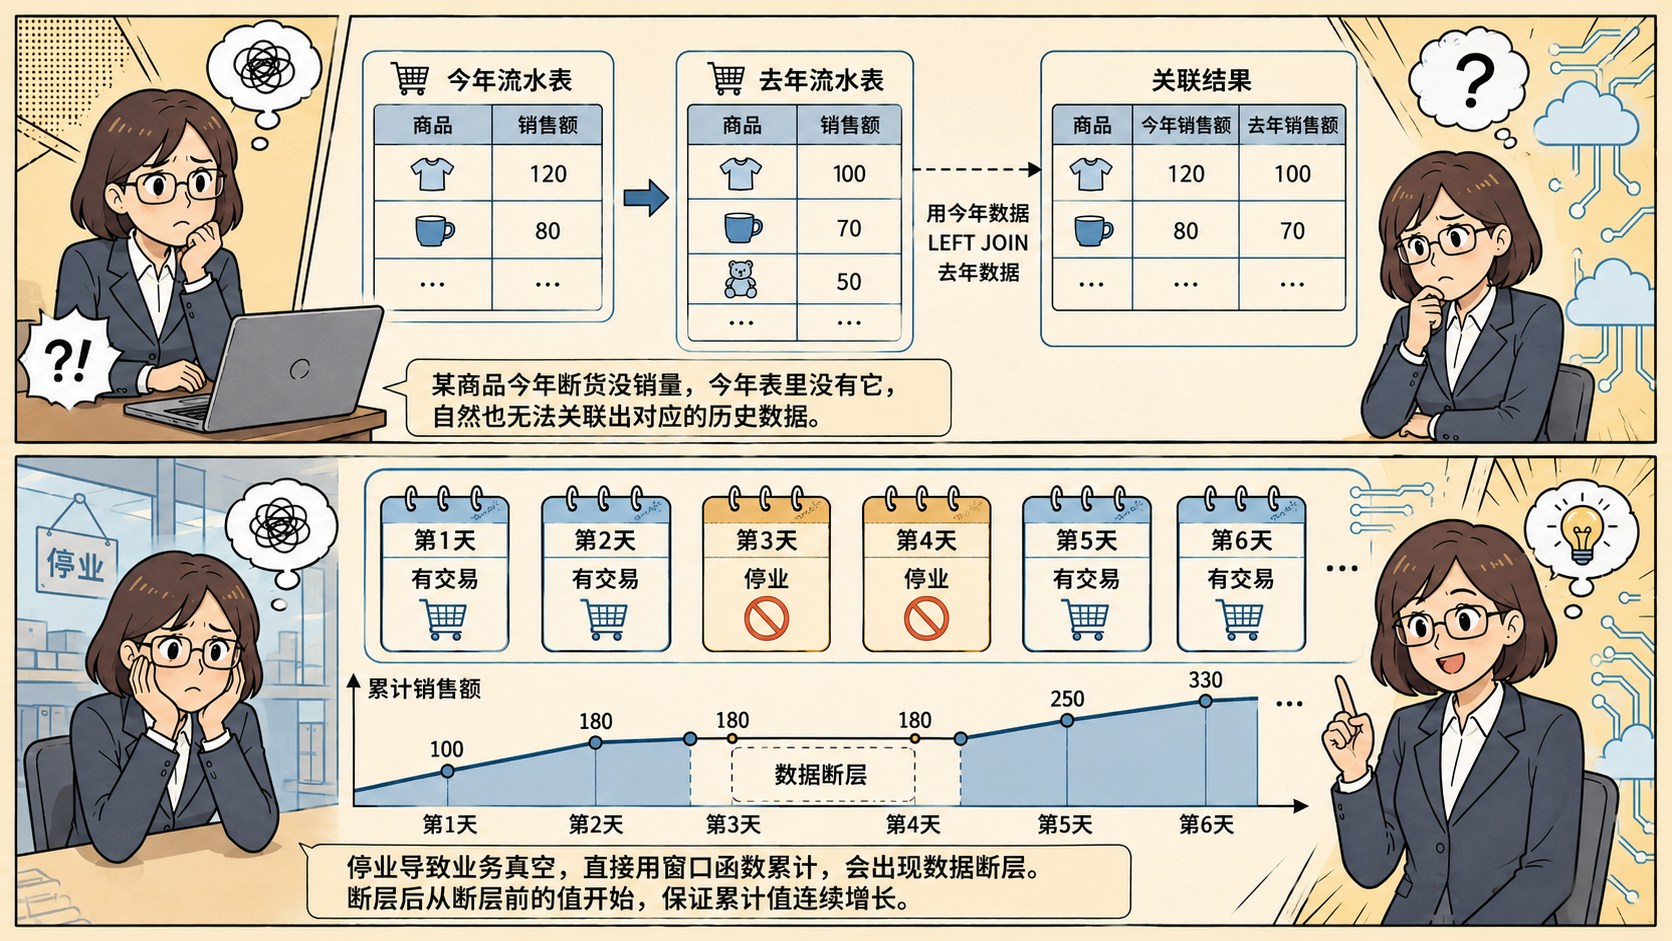
- **去年数跟着今年一起丢:**算同比时,开发习惯用今年数据去LEFT JOIN去年数据。如果某个商品今年断货没销量,今年流水表里就没有它,自然也无法关联出对应的历史数据。最后的结果是,去年的正常数据跟着今年的零值一同在看板上消失了。
- **累计计算无法向后传递:**累计指标需要时间轴绝对连续。如果直接在交易流水表上用SUM()OVER()窗口函数计算累计,一旦某几天因为停业出现业务真空,时序的连续性就被斩断了。计算引擎在空缺日期找不到基准,历史累计的成果就无法向后传递。
2. 维表驱动与矩阵对齐
要解决这个问题,数仓的建模思路必须从看流水转变为:在算指标前,先在底层构筑一套绝对连续的时间网格。
- **全量维度左连接:**放弃以多变的事实表为主导,转而以标准的日期维表、组织维表或商品维表为核心。在ETL处理时,先通过这些基础维表进行交叉关联,强行生成包含所有时间+业务实体的完整网格,确保每一个分析对象在每天都有一个确定的"坑位"。
- **显式转化空值逻辑:**有了连续的网格当主表,再去LEFT JOIN实际的交易流水。对于没发生业务而产生的NULL空值,统一用IFNULL(sales,0)兜底填上0。让系统明确知道没业务代表的是0,而不是在逻辑上直接消失。
3. 生产环境的算力优化
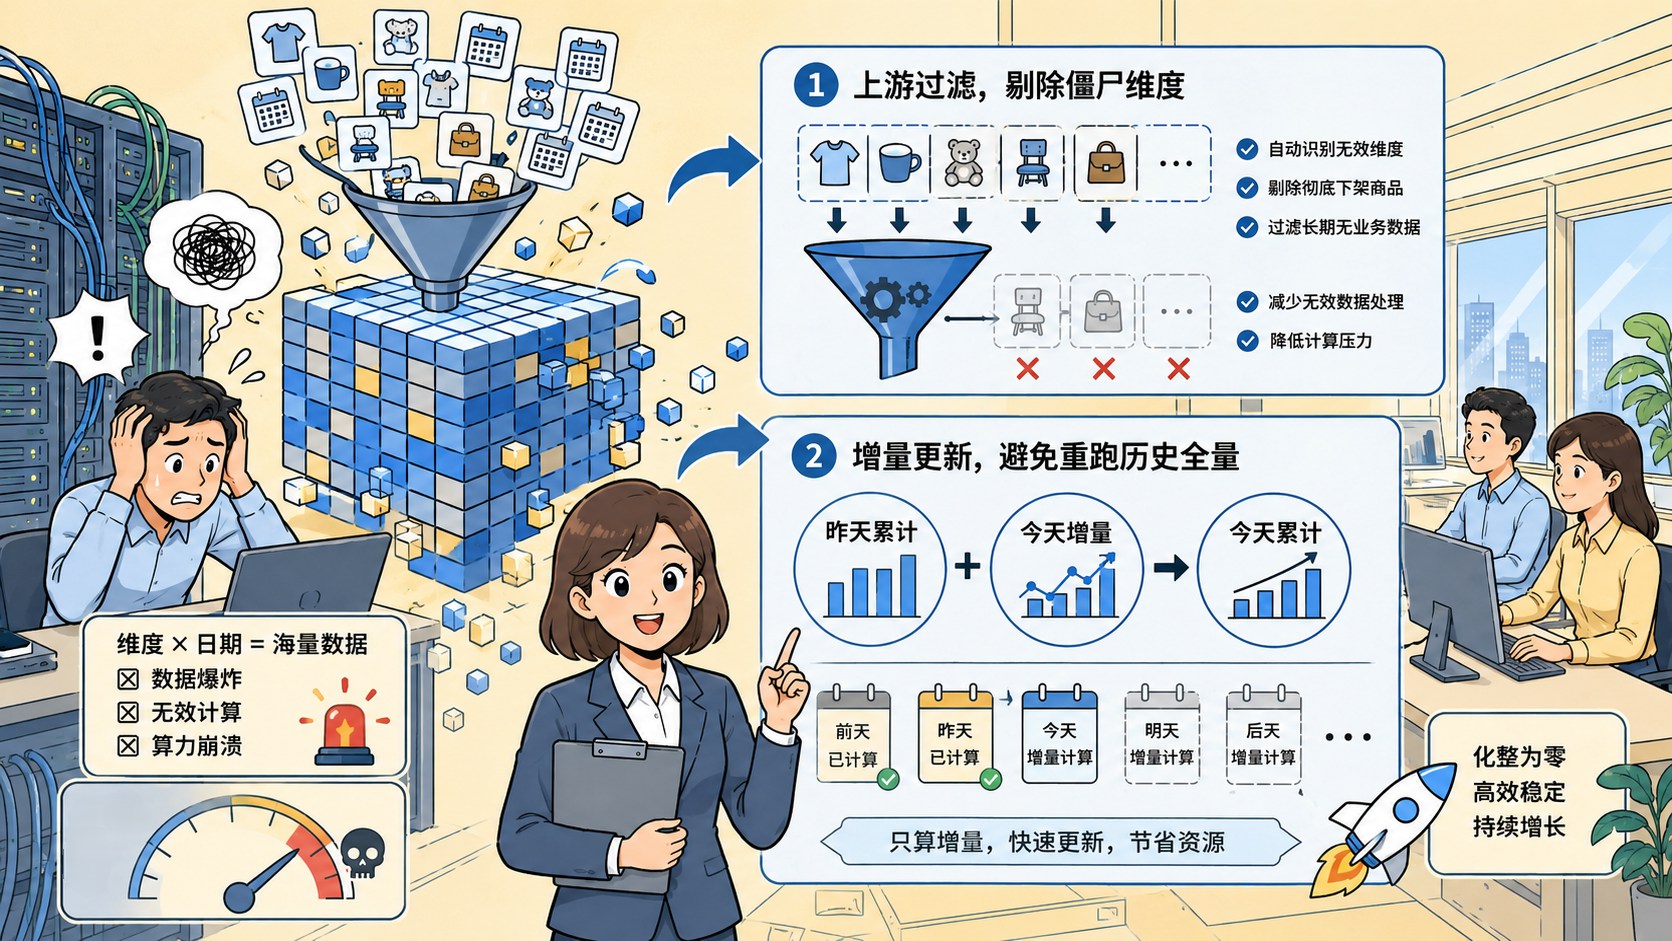
如果把所有维度和日期都做全量关联,面对海量数据,很容易引发数据爆炸、导致服务器算力崩溃。在实际生产中,我们可以通过两个办法把计算压力化整为零:
- **裁剪非活跃维度:**在脚本上游加过滤,自动剔除那些已经彻底下架、或长期完全无业务迹象的"僵尸"维度,从源头上精简网格的体积,避免无效的性能消耗。
- **增量累加迭代机制:**算累计指标时,避免每天重跑历史全量。采用今天累计=昨天累计+今天增量的更新机制。每天只需对当天新增的流水进行对齐合并,就能把跑批时间控制在较短时间内。
结语
一个合格的数据看板,不仅要能记录企业高歌猛进时的繁荣,更要能客观反映业务停滞和下滑时的真实状况。这就要求数据开发人员在写底层ETL逻辑时,必须具备防御思维,提前堵死由业务数据不连续带来的逻辑漏洞,以此捍卫企业数字化决策的生命线。
德昂信息十七年来专注于数据管理领域。为企业提供高效、透明、智能的数据解决方案,帮助企业实现数据可信、分析透明以及决策智能。