AI 并行编码的 Worktree 生命周期:创建、隔离与安全回收
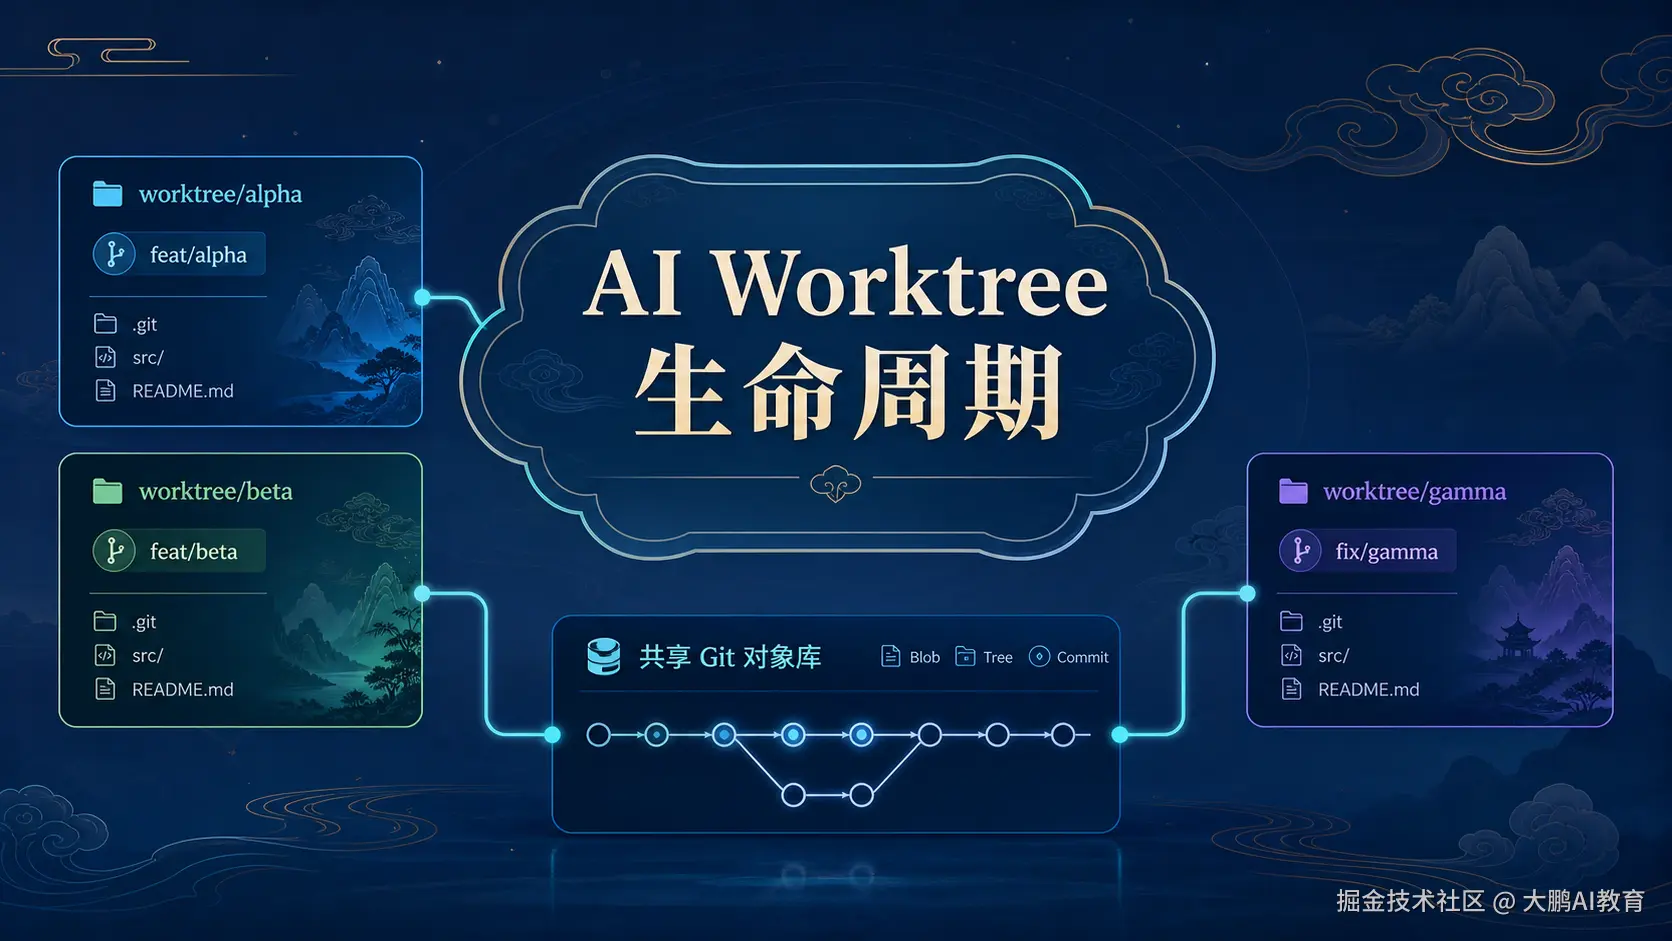
并行编码有一个看似简单的选择:让多个 AI Agent 共用一个工作目录,还是为每个任务创建 Git Worktree?前者启动快,但任何格式化、依赖更新和临时文件都可能互相干扰;后者隔离清晰,却引入了创建、分支绑定和清理成本。
真正需要做的工程决策不是"是否使用 Worktree",而是是否愿意管理它的完整生命周期。只会创建、不保护成果也不回收现场,系统很快就会从代码冲突变成磁盘和分支混乱。
工程场景与决策冲突
Worktree 适合能独立提交、独立测试的任务。例如后端、测试和文档各由一个 Agent 处理。每个任务拥有独立目录和分支,底层仍共享 Git 对象库,避免完整克隆的重复成本。
决策冲突出现在任务退出时:
- 只要
git status不干净就保留,会积累缓存和临时文件; - 一律
git worktree remove --force,可能删除未推送提交; - 只删目录不管 Git 元数据,会留下失效 Worktree 记录。
因此,清理门禁应围绕"是否存在未推送提交"设计,而不是只看工作区是否干净。
方案拆解与关键权衡
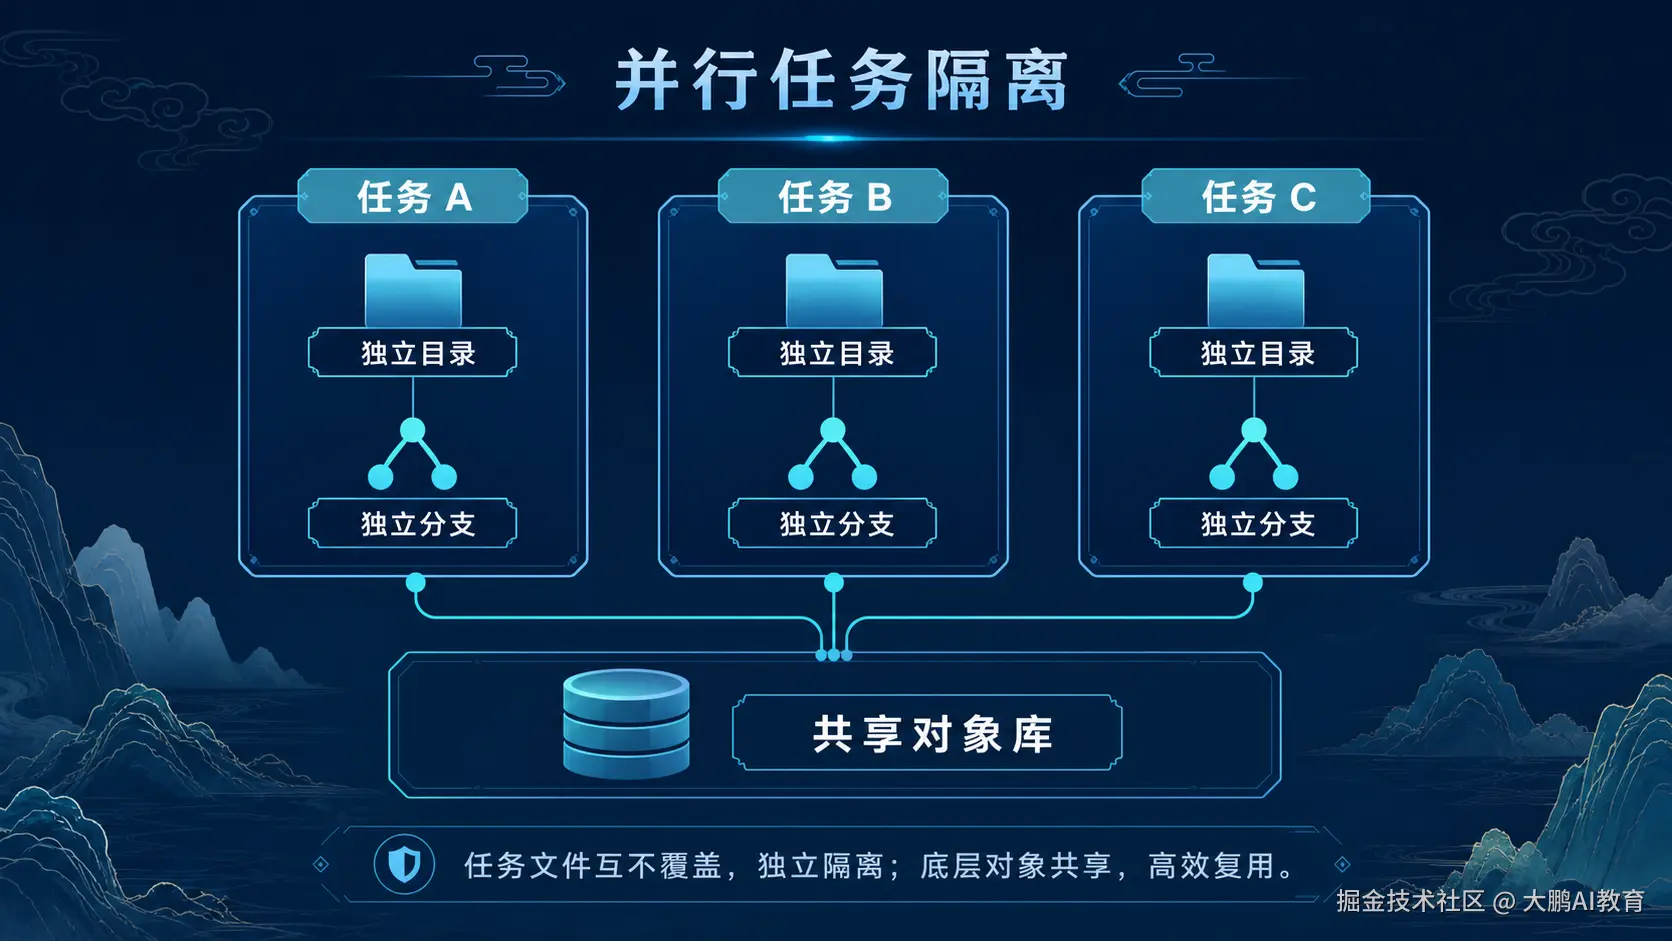
目录隔离与分支隔离缺一不可
独立目录防止文件覆盖,独立分支让成果能按提交回收。任务身份至少包含仓库根目录、工作树路径和分支名,所有工具调用显式使用工作树作为 cwd。
提交是自动化流程的交付边界
如果系统约定"真实工作必须提交",那么未跟踪测试产物可以回收,未推送提交必须保留。这条规则简单且可测试。若团队需要保护未提交修改,就必须把清理策略调整为更保守的人工确认。
自动回收要允许停下来
优秀的清理函数不是永远返回成功。发现未推送提交时,它应该拒绝删除,并输出工作树路径、分支和人工恢复命令。
实现链路与最小示例
创建阶段从明确基线建立独立分支:
python
subprocess.run(
    ["git", "worktree", "add", "-b", branch, path, base_ref],
    cwd=repo_root,
    check=True,
    timeout=30,
)
创建后不要只相信退出码,还应回读:
text
目录真实存在
当前分支等于预期分支
rev-parse --is-inside-work-tree 为 true
退出阶段先做成果判定:
python
if has_unpushed_commits(worktree_path):
    return {"cleaned": False, "reason": "unpushed_commits"}

git(repo_root, "worktree", "unlock", worktree_path)
git(repo_root, "worktree", "remove", worktree_path, "--force")
git(repo_root, "branch", "-D", branch)
return {"cleaned": True}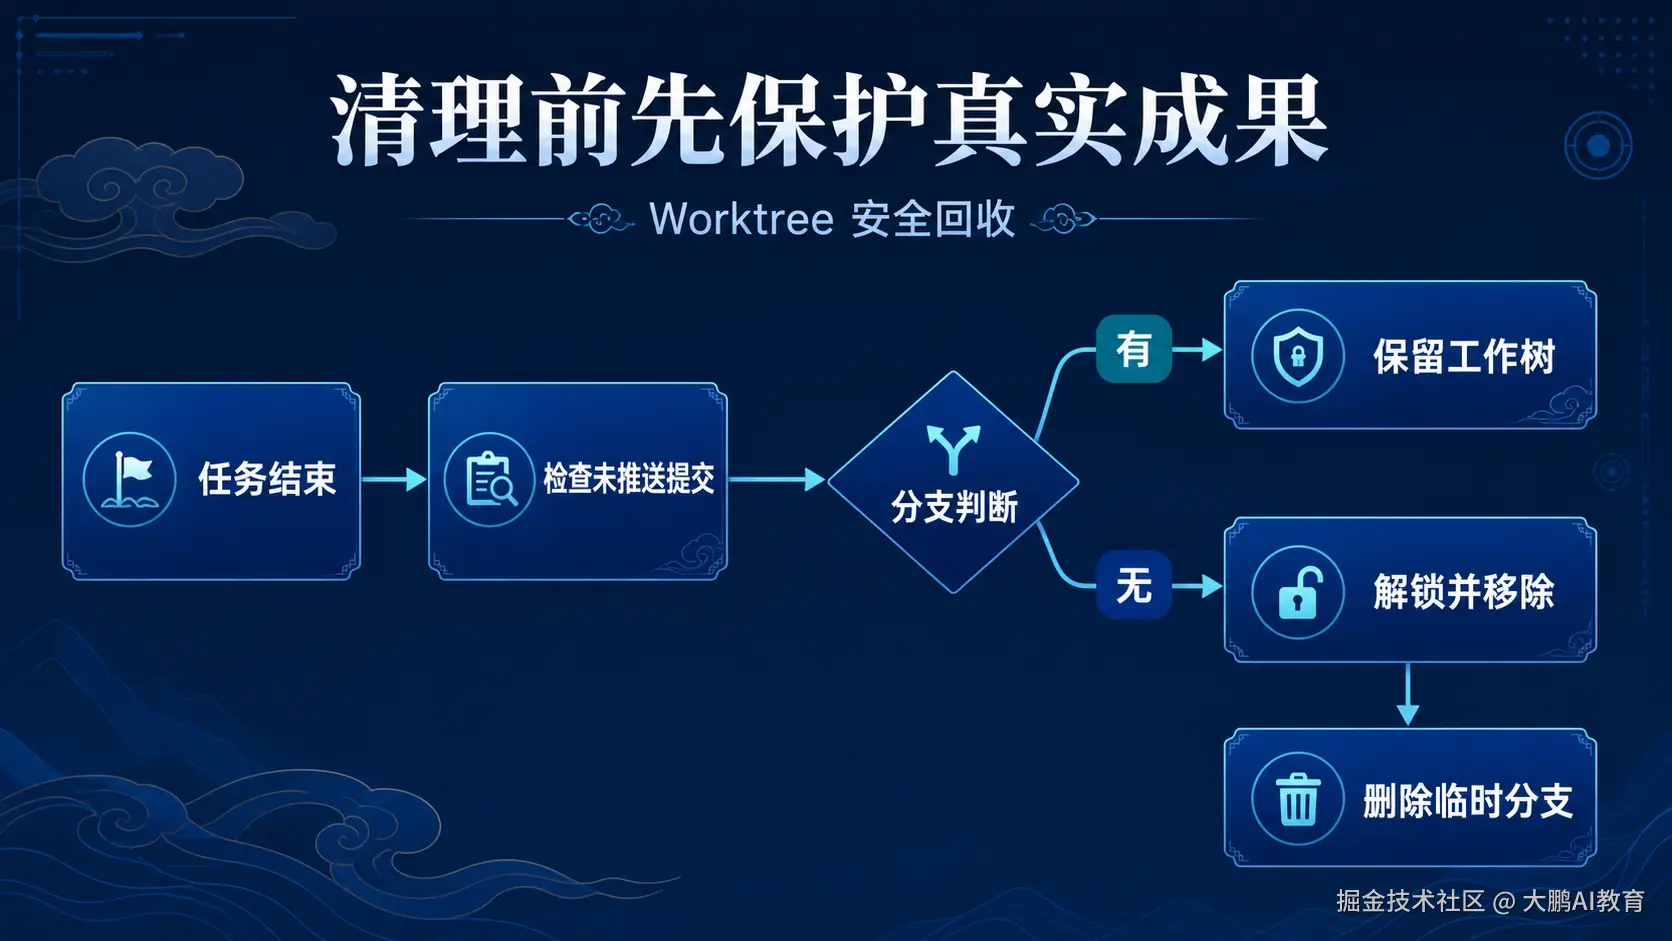
最小回归测试应覆盖:两个工作树路径不同、分支不同、文件互不可见;干净工作树可删除;存在未推送提交时工作树仍然存在。
证据、限制与自动化边界
真实项目的实现显示,清理函数在删除前检查未推送提交;对应测试创建一个只存在本地的新提交,并断言清理返回拒绝且目录仍保留。这比"代码看起来会保护"更可靠,因为边界被自动测试锁定。
仍需注意几个限制:
- Worktree 共享对象库,但构建缓存和依赖目录不会自动共享;
- 同一分支不能被多个 Worktree 同时检出;
- 没有远程引用时,"未推送"的定义必须由项目明确;
- 强制清理前必须校验路径位于受控
.worktrees目录内; - AI 生成的路径、分支名和 Git 参数不能未经校验直接执行。
知识依据来自 RuyiBookCourse 的子智能体并行执行章节,其中明确使用 Worktree 为并行任务提供文件系统隔离,并通过提交合并结果。
可复用检查清单
- 一个任务是否对应一个独立目录和分支?
- 基线提交是否明确记录?
- 命令是否固定在任务工作树执行?
- 任务结果是否通过提交回收?
- 清理前是否检查未推送提交?
- 发现真实成果时是否停止删除?
- 自动删除是否校验受控路径?
- 测试是否覆盖隔离、回收和保留三条路径?
收束
Worktree 不是并行编码的魔法开关,它更像一个需要状态机管理的运行资源。把"创建成功"扩展为"成果可回收、失败可恢复、现场可安全清理",多个 AI Agent 才能真正长期并行。你在实践中更倾向保守保留,还是提交即交付、其余自动回收?
发布前门禁
- 减少重复背景
- 突出工程选择而非概念堆砌
- 不给未经验证的数据结论
- 本轮无已认领实验,不自行补写实验结论