摘要
DeepSpeed 是微软开源的分布式训练优化库,核心是 ZeRO 显存切分技术,最近两年在大模型岗位的招聘要求里出现得越来越频繁------但网上大多数介绍停留在"ZeRO 三个 stage 分别切什么",很少讲清楚它在一条完整生产链路里具体怎么落地。这篇文章接着上一篇 K8s+Ray+PyTorch+vLLM 的思路,换一条编排路径:用 K8s + Kubeflow Trainer 的 MPI-based 调度承载 DeepSpeed ZeRO 分布式微调,微调产出的分片权重合并后交给 vLLM 部署成推理服务,四个阶段每一步命令都能真实跑通。
背景与问题
DeepSpeed 解决的是"模型装不进显存"这个具体问题。 传统数据并行训练里,每张 GPU 都要完整保存一份模型参数、梯度和优化器状态(尤其是 Adam 这类优化器,状态占用往往是参数本身的好几倍),模型一大就装不下。ZeRO(Zero Redundancy Optimizer)的做法是把这三类状态按 GPU 数量切分而不是每张卡都存全量:stage 1 切优化器状态,stage 2 在此基础上再切梯度,stage 3 连模型参数本身也切分。这套方案支撑过 MT-530B、BLOOM 这类超大模型的训练,也是它至今仍是大模型训练岗位常见技能要求的原因。
围绕它有两个容易搞混的点:
第一个误区:DeepSpeed 本身不负责"在哪几台机器上启动训练"这件事。 和 Ray 不一样,DeepSpeed 是训练时的显存/通信优化库,不是应用层调度器------它默认假设你已经有一组能互相 SSH、装好 OpenMPI 的机器,然后用 deepspeed/mpirun 命令去启动多进程训练。放到 K8s 上,这一步"怎么把 Pod 组织成一组能跑 MPI 的节点"需要靠外部编排层来做,Kubeflow Trainer 提供的 deepspeed-distributed 运行时就是干这个的:自动生成 hostfile、自动配置节点间 OpenSSH、自动跑 mpirun,把"裸 DeepSpeed 需要手工搭的 MPI 环境"这部分做成了声明式的 K8s 资源。
第二个误区:DeepSpeed 现在还能不能用来做推理服务。 DeepSpeed-Inference 和它上层的 DeepSpeed-MII/DeepSpeed-FastGen 确实存在,官方基准也给出过比同期系统吞吐更高的数字。但 vLLM 用 PagedAttention + continuous batching 加上原生 OpenAI 兼容 API,已经成为推理服务化的事实标准,生态集成(量化方案、多模态、Agent 工具调用)也更完整------PyTorch Foundation 同时把 vLLM 和 DeepSpeed 收作托管项目,恰好说明二者是互补关系:DeepSpeed 把价值留在训练侧的显存优化,推理服务化交给 vLLM 更合适。这也是这篇文章的核心结构:训练用 DeepSpeed,上线用 vLLM,中间靠一次权重合并衔接。
核心思路与优势
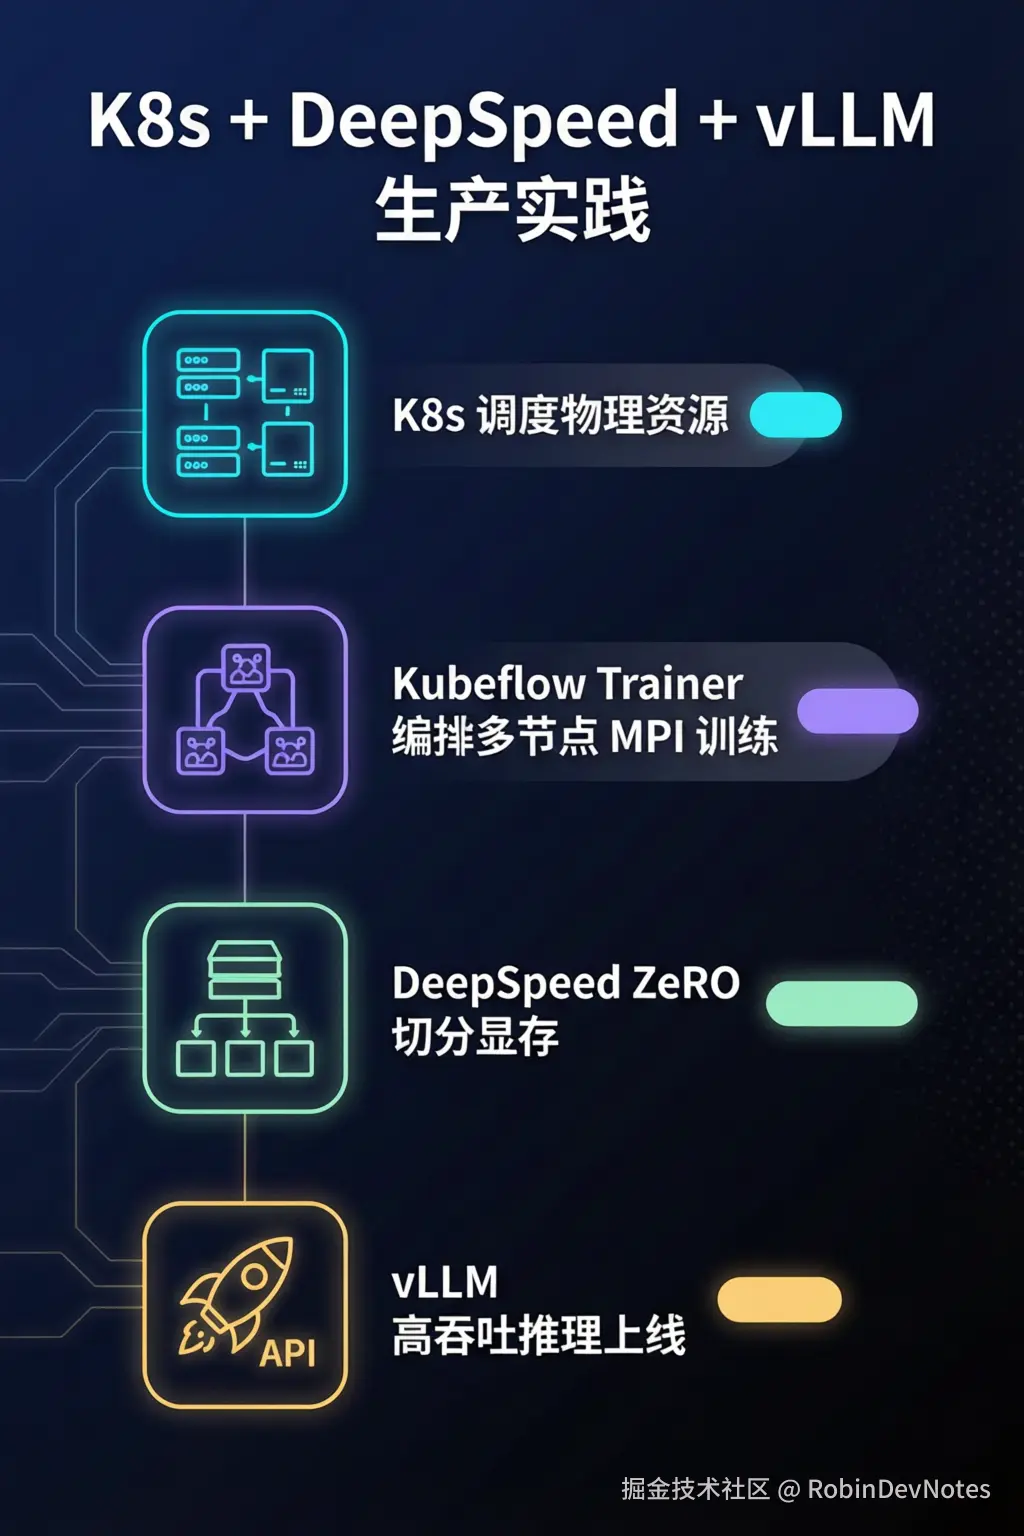
四层职责定位
| 层级 | 组件 | 具体职责 |
|---|---|---|
| 物理资源调度 | Kubernetes | 把 Pod 调度到具体节点,管理 GPU 配额、网络、存储卷 |
| 训练任务编排 | Kubeflow Trainer(TrainJob CRD + deepspeed-distributed 运行时) |
生成 MPI hostfile、配置节点间 SSH、用 mpirun 在每个节点拉起训练进程 |
| 分布式训练优化 | DeepSpeed | ZeRO 显存切分(stage 1/2/3)、CPU/NVMe offload、混合精度、通信优化 |
| 推理引擎 | vLLM | PagedAttention + continuous batching 做高吞吐推理,提供 OpenAI 兼容 API |
对比上一篇 Ray 那套组合会发现一个关键区别:Ray 是"应用层调度器",负责把 Actor/Task 动态分配到资源上,训练和推理可以在同一个调度域里灵活切换(这正是 RLHF 场景需要的);而 DeepSpeed 走的是更传统的 MPI 范式------一次训练任务启动前,参与的节点数和角色就已经通过 hostfile 固定下来,训练和推理是两个独立的生命周期,中间要靠一次显式的权重合并来交接。两条路径没有优劣之分,只是编排哲学不同:RLHF 这种训练推理反复切换的场景更适合 Ray 的动态调度,单纯"把模型训练到收敛再上线"这种线性流程,DeepSpeed + Kubeflow Trainer 的 MPI 范式反而更简单可控。
安装配置
安装 Kubeflow Trainer(提供 TrainJob CRD 和 deepspeed-distributed 运行时):
bash
kubectl apply --server-side -k "https://github.com/kubeflow/trainer.git/manifests/overlays/manager?ref=v2.2.0"
kubectl get pods -n kubeflow-system
# 确认 kubeflow-trainer-controller-manager 和依赖的 jobset-controller-manager 都处于 Running
安装 Python SDK(本地用于提交训练任务):
bash
pip install -U kubeflow确认 DeepSpeed 运行时已注册:
bash
kubectl get clustertrainingruntimes | grep deepspeed
# 应看到 deepspeed-distributed
deepspeed-distributed 这个 ClusterTrainingRuntime 里预装了 DeepSpeed 0.17.4 及配套依赖,训练容器不需要自己再装一遍------这也呼应背景部分提到的"容器需预装 DeepSpeed 和 CUDA 编译器,避免运行时 JIT 编译拖慢启动"这条实践经验。
面向人群
- 招聘要求里看到 DeepSpeed 技术栈、想补一个能讲清楚的完整实践项目的工程师
- 正在搭建大模型微调基础设施的平台工程师,需要一条比手工 SSH+mpirun 更工程化的多节点训练路径
- 想理解 DeepSpeed 和 Ray/FSDP 等方案边界、判断该选哪套编排范式的技术决策者
实践步骤:从分布式微调到推理上线
环境安装已在上文的"安装配置"完成,以下四个阶段接着覆盖训练配置→提交微调任务→权重合并→推理上线,命令和 API 用法对照 Kubeflow Trainer、DeepSpeed、vLLM 官方文档核实。受限于篇幅,微调阶段用 7B 级别模型做可验证的最小示例 而非千卡预训练规模,但架构和命令是生产可直接复用的,把 num_nodes/resources_per_node 调大就是生产配置。
阶段一:DeepSpeed 训练配置(ds_config)
ZeRO stage 3 + offload 是显存最紧张场景(单卡装不下完整模型)的典型配置,把优化器状态和参数都 offload 到 CPU 内存:
json
{
  "train_micro_batch_size_per_gpu": 4,
  "gradient_accumulation_steps": 4,
  "bf16": { "enabled": true },
  "zero_optimization": {
    "stage": 3,
    "offload_optimizer": { "device": "cpu", "pin_memory": true },
    "offload_param": { "device": "cpu", "pin_memory": true },
    "overlap_comm": true,
    "contiguous_gradients": true,
    "stage3_prefetch_bucket_size": 5e8,
    "stage3_param_persistence_threshold": 1e6
  },
  "optimizer": {
    "type": "AdamW",
    "params": { "lr": 2e-5, "betas": [0.9, 0.999], "eps": 1e-8, "weight_decay": 0.01 }
  },
  "gradient_clipping": 1.0
}
如果多机之间是高速互联(NVLink/InfiniBand),显存也够用,可以把 offload_optimizer/offload_param 去掉,只留 ZeRO stage 2------offload 换来的是显存空间,代价是 CPU-GPU 拷贝带来的额外延迟,不是默认最优选项。
阶段二:提交多节点微调任务(Kubeflow Trainer SDK)
python
from kubeflow.trainer import TrainerClient, CustomTrainer

def fine_tune_with_deepspeed():
    import json
    import deepspeed
    from transformers import AutoModelForCausalLM, AutoTokenizer
    from torch.utils.data import DataLoader

    with open("/workspace/ds_config.json") as f:
        ds_config = json.load(f)

    model = AutoModelForCausalLM.from_pretrained("Qwen/Qwen2.5-7B")
    tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen2.5-7B")

    # deepspeed.initialize 会读取 deepspeed-distributed 运行时
    # 自动注入的 WORLD_SIZE/RANK/LOCAL_RANK,无需手动设置
    model_engine, optimizer, _, _ = deepspeed.initialize(
        model=model, model_parameters=model.parameters(), config=ds_config
    )

    train_loader = DataLoader(load_sft_dataset(tokenizer), batch_size=ds_config["train_micro_batch_size_per_gpu"])
    for step, batch in enumerate(train_loader):
        outputs = model_engine(**batch)
        model_engine.backward(outputs.loss)
        model_engine.step()
        if step % 100 == 0 and model_engine.global_rank == 0:
            model_engine.save_checkpoint("/mnt/shared/checkpoints", tag=f"step-{step}")

job_id = TrainerClient().train(
    runtime="deepspeed-distributed",
    trainer=CustomTrainer(
        func=fine_tune_with_deepspeed,
        packages_to_install=["transformers", "datasets"],
        num_nodes=2,
        resources_per_node={"gpu": 4},
    ),
)
job = TrainerClient().get_job(name=job_id)
for step in job.steps:
    print(f"Step: {step.name}, Status: {step.status}")
num_nodes=2, resources_per_node={"gpu": 4} 就是"用几台机器、每台几张卡"这个决策的完整代码化,deepspeed-distributed 运行时会据此生成 hostfile 并跑 mpirun -np 8 ...。save_checkpoint 只在 global_rank == 0 触发是常见写法,避免 8 个进程同时写同一个共享卷;checkpoint 路径必须是各节点共享存储(如 NFS/PVC),这一点前面"安装配置"里已经提到,offload 场景尤其容易漏掉。
阶段三:合并 ZeRO 分片权重
ZeRO stage 2/3 训练产出的 checkpoint 是按 GPU 切分的分片,不能直接被 HuggingFace from_pretrained 或 vLLM 加载,需要先合并成标准 fp32 state_dict:
python
from deepspeed.utils.zero_to_fp32 import get_fp32_state_dict_from_zero_checkpoint
from transformers import AutoModelForCausalLM, AutoTokenizer

checkpoint_dir = "/mnt/shared/checkpoints/step-900"
state_dict = get_fp32_state_dict_from_zero_checkpoint(checkpoint_dir)

model = AutoModelForCausalLM.from_pretrained("Qwen/Qwen2.5-7B")
model.load_state_dict(state_dict)
model.save_pretrained("/mnt/shared/merged-model", safe_serialization=True)

tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen2.5-7B")
tokenizer.save_pretrained("/mnt/shared/merged-model")
也可以不写代码,直接用 DeepSpeed 在每个 checkpoint 目录下自动生成的脚本:python /mnt/shared/checkpoints/step-900/zero_to_fp32.py /mnt/shared/checkpoints/step-900 /mnt/shared/merged-model/pytorch_model.bin。这一步需要的内存大约是最终 fp32 模型体积的 2 倍,7B 模型建议在有 32GB+ 内存的节点上跑。
这段代码在哪里运行: 不建议在阶段二的训练 Pod 里顺手做(训练结束 Pod 可能已经被 TrainJob 回收,而且训练节点的内存预算是按训练算的,不一定留得出 2 倍模型体积的余量),也不是在本地笔记本上跑(本地拿不到集群里的共享存储卷)。最简单的方式是在同一个 K8s 集群里另起一个一次性 Job,挂载和训练 Pod 相同的共享 PVC,只申请 CPU 和内存、不占 GPU:
yaml
apiVersion: batch/v1
kind: Job
metadata:
  name: deepspeed-checkpoint-merge
spec:
  template:
    spec:
      restartPolicy: Never
      containers:
        - name: merge
          image: <和训练用的同一个镜像,已装好 deepspeed/transformers>
          command: ["python", "/scripts/merge_checkpoint.py"]
          resources:
            requests: { cpu: "4", memory: "32Gi" }
            limits: { cpu: "8", memory: "48Gi" }
          volumeMounts:
            - { name: shared, mountPath: /mnt/shared }
      volumes:
        - name: shared
          persistentVolumeClaim: { claimName: shared-checkpoint-pvc }
merge_checkpoint.py 就是前面那段 get_fp32_state_dict_from_zero_checkpoint 脚本存成文件。Job 跑完自动退出,不需要常驻,kubectl logs job/deepspeed-checkpoint-merge 能看到合并进度和是否成功。合并完的 /mnt/shared/merged-model 就是一个标准 HuggingFace 格式目录------训练和推理两条流程线在这里正式交接。
阶段四:用 vLLM 部署到 K8s
模型数据怎么从阶段三到阶段四:不需要额外拷贝,前提是共享 PVC 支持 ReadWriteMany。 阶段三合并出来的 /mnt/shared/merged-model 本来就在共享 PVC(shared-checkpoint-pvc)上,vLLM 的 Deployment 只需要把同一个 PVC 挂载进来(推荐用 readOnly: true,服务进程不该有写权限),指向同一个子路径即可,不用再起一个"拷贝到新 PVC"的中间步骤。但这依赖一个前提:这个 PVC 的 StorageClass 必须支持 ReadWriteMany(多个 Pod 同时挂载读),也就是背后是 NFS/CephFS/EFS/Azure Files 这类共享文件系统,而不是云厂商默认的块存储(那种通常是 ReadWriteOnce,只能被一个节点上的一个 Pod 挂载)。如果你的集群只有 ReadWriteOnce 的 PVC 可用,就必须显式加一步拷贝------用一个一次性 Job(和阶段三的合并 Job 结构一样)把 /mnt/shared/merged-model 同步到对象存储(如 S3/OSS)或者一个新的 ReadWriteOnce PVC,再让 vLLM Pod 挂载这个新卷;这一步在 ReadWriteMany 可用时是完全可以省略的。
yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: vllm-qwen-server
spec:
  replicas: 2
  selector:
    matchLabels: { app: vllm-qwen }
  template:
    metadata:
      labels: { app: vllm-qwen }
    spec:
      containers:
        - name: vllm
          image: vllm/vllm-openai:v0.27.1   # 锁定具体版本号,不要用 latest;发版很快,部署前建议去 https://github.com/vllm-project/vllm/releases 确认是否有更新的稳定版
          args:
            - --model=/models/merged-model
            - --served-model-name=qwen2.5-7b-sft
            - --tensor-parallel-size=1
            - --gpu-memory-utilization=0.9
            - --max-model-len=8192
          resources:
            limits: { nvidia.com/gpu: 1 }
          readinessProbe:
            httpGet: { path: /health, port: 8000 }
            initialDelaySeconds: 30
            periodSeconds: 10
          volumeMounts:
            - { name: model-storage, mountPath: /models, readOnly: true }
      volumes:
        - name: model-storage
          persistentVolumeClaim: { claimName: shared-checkpoint-pvc }   # 阶段三合并权重用的同一个 PVC,挂到 /models 后 merged-model 就落在 /models/merged-model
---
apiVersion: v1
kind: Service
metadata:
  name: vllm-qwen-svc
spec:
  selector: { app: vllm-qwen }
  ports:
    - { port: 8000, targetPort: 8000 }
readinessProbe 打的是 vLLM OpenAI 兼容 server 自带的 /health 端点,模型没加载完之前 Service 不会把流量导过去。--gpu-memory-utilization 和 --max-model-len 这两个参数直接决定 KV cache 能容纳多少并发请求,是从"能跑起来"到"能扛住生产流量"最容易漏调的两个旋钮。部署后验证:
bash
kubectl port-forward svc/vllm-qwen-svc 8000:8000
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "qwen2.5-7b-sft", "messages": [{"role": "user", "content": "你好"}]}'
到这里,一条从 DeepSpeed 分布式微调到 vLLM 上线的链路就闭环了:ds_config.json 定义显存策略 → Kubeflow Trainer 的 deepspeed-distributed 运行时负责多节点调度 → 训练产出的分片权重合并成标准格式 → vLLM 接管推理服务化,全程没有手工 SSH 到机器上敲 mpirun,也没有在训练和推理之间手工搬运权重文件之外的额外胶水代码。
小结
DeepSpeed 在这条链路里的定位很明确:解决训练时"模型装不进显存"的问题,不负责调度、也不负责推理服务化。K8s 管物理资源,Kubeflow Trainer 的 MPI-based 运行时管多节点训练编排,DeepSpeed 管显存和通信优化,vLLM 管推理吞吐------四层各司其职,靠一次权重合并衔接训练和推理两个阶段。和上一篇 Ray 那套动态调度的组合比,这条路径更适合"训练到收敛再上线"这种线性生产流程;如果场景本身需要训练推理反复切换(比如 RLHF),前一篇的 Ray + verl 组合会是更合适的选择。