摘要:Hive on Spark 让传统 Hive 数仓跑在 Spark 引擎上。本文从 RSC 远程作业提交机制、HQL 编译 6 步、MR/Tez/Spark 三引擎对比、完整配置清单四个维度,配合 2 张架构图,彻底解析 Hive on Spark 原理。
关键词:Hive on Spark, RSC, Remote SparkContext, SparkClient, hive.execution.engine
一、开篇
传统 Hive 默认使用 MapReduce,每个 Stage 写 HDFS。Hive on Spark 将 Spark 作为执行引擎:RDD 内存迭代 + Catalyst 优化。
css
引擎演变: MR(1x) → Tez(10~100x) → Spark(100x+)
切换: set hive.execution.engine=spark;
二、架构全景 --- RSC 核心机制
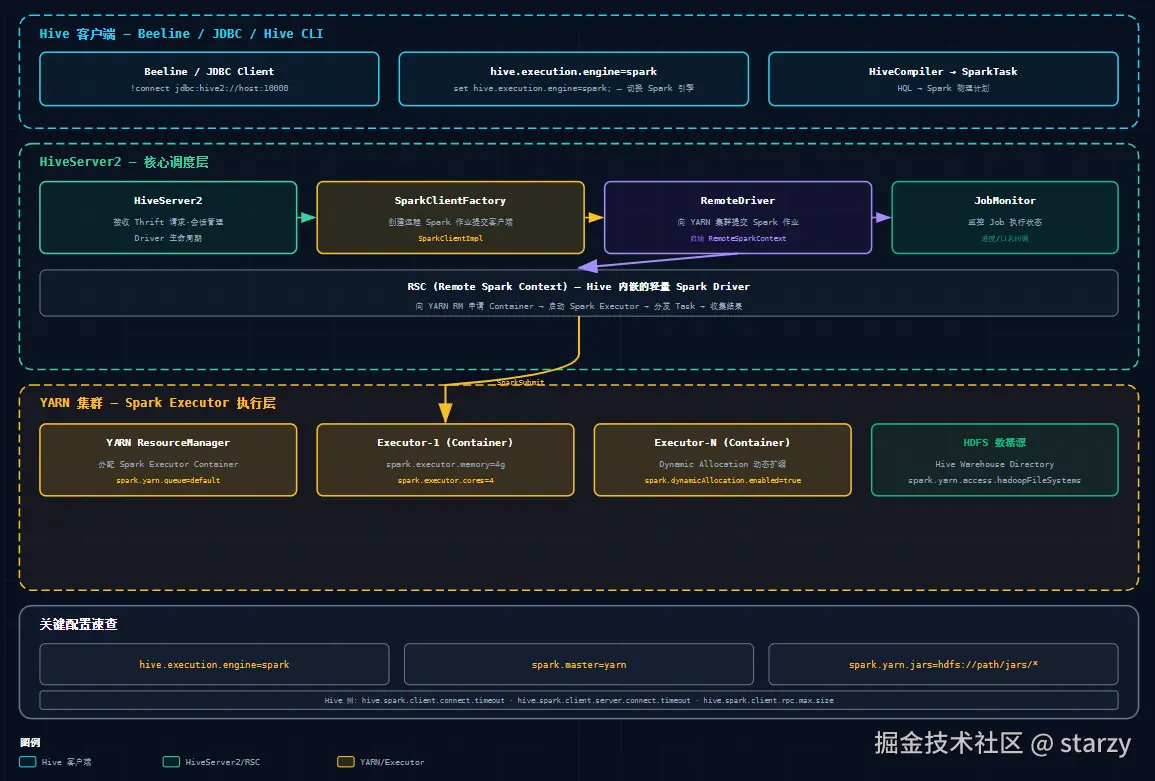
scss
RSC (Remote Spark Context) = Hive 内嵌的轻量 Spark Driver
  ① HiveServer2 接收 HQL → ② SparkClient 创建
  ③ RemoteDriver 向 YARN 提交 → ④ 启动 RSC
  ⑤ YARN 分配 Executor → ⑥ JobMonitor 监控
三、HQL 编译 & 引擎对比
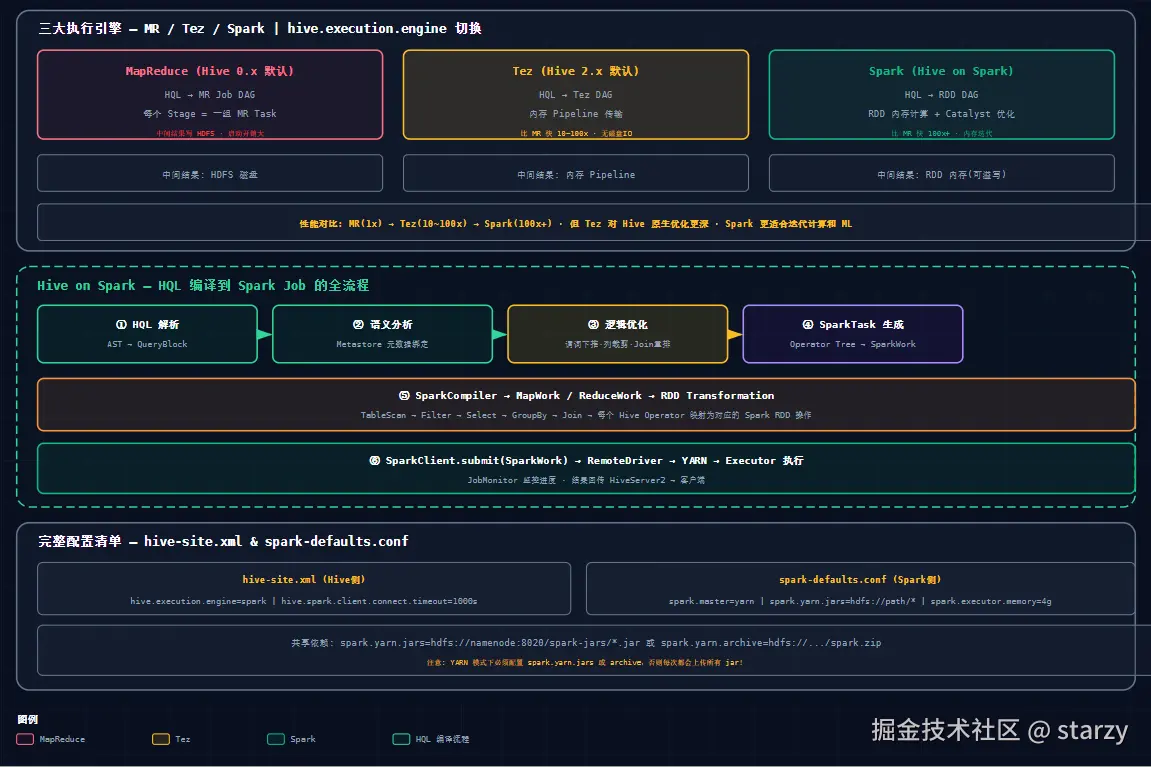
HQL 编译 6 步
scss
① 解析(AST) → ② 语义分析(Metastore) → ③ 逻辑优化
④ SparkTask(Operator Tree→SparkWork) → ⑤ SparkCompiler(RDD Transform)
⑥ SparkClient.submit → Executor 执行
引擎对比
| MR | Tez | Spark | |
|---|---|---|---|
| 速度 | 1x | 10~100x | 100x+ |
| 中间结果 | HDFS磁盘 | 内存Pipeline | RDD内存 |
| 适用 | 已淘汰 | 纯SQL | 迭代/ML |
四、配置清单
xml
<!-- hive-site.xml -->
hive.execution.engine=spark
spark.master=yarn
spark.yarn.jars=hdfs://namenode/spark-jars/*  <!-- 必配! -->
properties
# spark-defaults.conf
spark.executor.memory=4g
spark.dynamicAllocation.enabled=true
spark.shuffle.service.enabled=true
五、总结
- RSC:Hive 内嵌 Driver,通过 SparkClient 向 YARN 提交作业。
- 引擎选择:Tez 纯 SQL 更快,Spark 迭代/ML 更优。
- 配置关键:spark.yarn.jars 必配 + Dynamic Allocation。
作者 :starzy
博客 :blog.starzy.cn
GitHub :starzy1990.github.io
专注 AI Agent · LangGraph · RAG · 大数据架构 · 数据工程实践