摘要:做实时计算,最先要搞明白的是数据怎么进来的。这篇讲清 Spark Streaming 的 Receiver 接收链路------数据从 Kafka/Socket 进来,经 BlockGenerator 切成 Block 落进 BlockManager,再按 batch 打包成 RDD;顺带说清楚 batchInterval 和 blockInterval 这两个最容易混的参数,以及 WAL、反压和 Receiver/Direct 两种模式的取舍。
关键词:Spark Streaming, Receiver, BlockGenerator, blockInterval, WAL, 反压, Direct 模式
一、数据是怎么"流"进来的
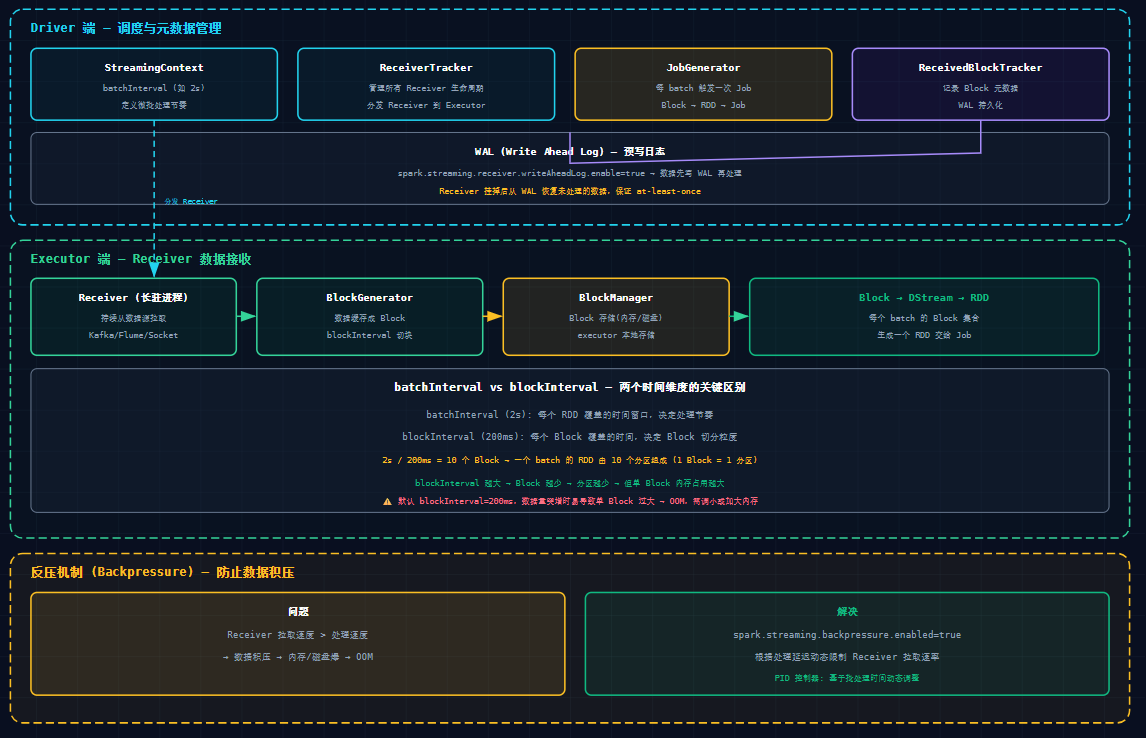
Spark Streaming 用的是微批处理------把实时流切成一个个小批次(batch),每个批次当成一个 RDD 来处理。所以"接收数据"的本质,就是把持续到达的数据,按时间窗口切块、攒批,再交给后面的计算。
一条数据的完整旅程是这样的:
数据源(Kafka/Socket) → Receiver → BlockGenerator → Block → BlockManager → WAL
                                                              ↓
                                            每个 batch 的 Block 集合 → RDD → Job
两个关键角色:
- Receiver:跑在 Executor 上的长驻进程,负责从数据源持续拉取数据。它自己不吃数据,只管搬。
- ReceiverTracker:跑在 Driver 端,管理所有 Receiver 的启停和元数据,记录"哪些 Block 属于哪个 batch"。
二、batchInterval 和 blockInterval,别搞混
这是理解 Spark Streaming 接收机制最重要的一对参数,名字像,作用完全不同。
scala
val ssc = new StreamingContext(conf, Seconds(2))   // batchInterval = 2s

// blockInterval 通过配置项设置,默认 200ms
conf.set("spark.streaming.blockInterval", "200ms")- batchInterval(批间隔):每个 RDD 覆盖的时间窗口,决定处理节奏。设 2 秒,就是每 2 秒生成一个 RDD。
- blockInterval(块间隔):Receiver 把数据切成 Block 的粒度。默认 200ms。
两者的关系决定了并行度:一个 Block 对应 RDD 的一个分区 。batchInterval 2 秒、blockInterval 200ms,那么一个 batch 里有 2000 / 200 = 10 个 Block,也就是这个 RDD 有 10 个分区,最多 10 个并发任务。
这里有个容易踩的坑 :如果单个 Receiver 的吞吐很高(比如单 topic 单分区每秒几万条),默认 200ms 的 blockInterval 会让每个 Block 塞进大量数据,Block 撑爆内存直接 OOM。这时要么调大 spark.streaming.blockInterval 让 Block 更多更小,要么干脆加 Receiver 数量把吞吐分散开。
三、WAL:数据不丢的代价
Receiver 收到数据后,默认是存在内存里的。一旦 Executor 挂了,这些还没处理的数据就没了。
要保证不丢,得开 WAL(Write Ahead Log,预写日志):
scala
conf.set("spark.streaming.receiver.writeAheadLog.enable", "true")开了之后,数据会先写进 WAL(落盘),再进 BlockGenerator。Receiver 挂了重启,可以从 WAL 把没处理完的数据读回来。
代价也很直接:每次写盘都有 IO 开销,吞吐会掉一截。所以 WAL 不是免费的,是"数据不丢"和"性能"之间的取舍。这也是后面 Direct 模式要解决的点。
四、反压:接收太快处理不过来怎么办
生产里很常见:数据高峰时,Receiver 拉取速度远超下游处理速度,Block 越积越多,最后 OOM。
反压(Backpressure)就是解决这个的:
scala
conf.set("spark.streaming.backpressure.enabled", "true")原理是 Spark 用一个 PID 控制器,根据上一批的实际处理时长,动态算出下一批应该拉多少数据。处理慢了,就少拉一点,让上下游回到平衡。
注意反压只对 Receiver 模式有效,且开启后拉取速率是动态调整的,测试时要注意它可能掩盖掉处理逻辑本身的性能问题。
五、Receiver 模式 vs Direct 模式
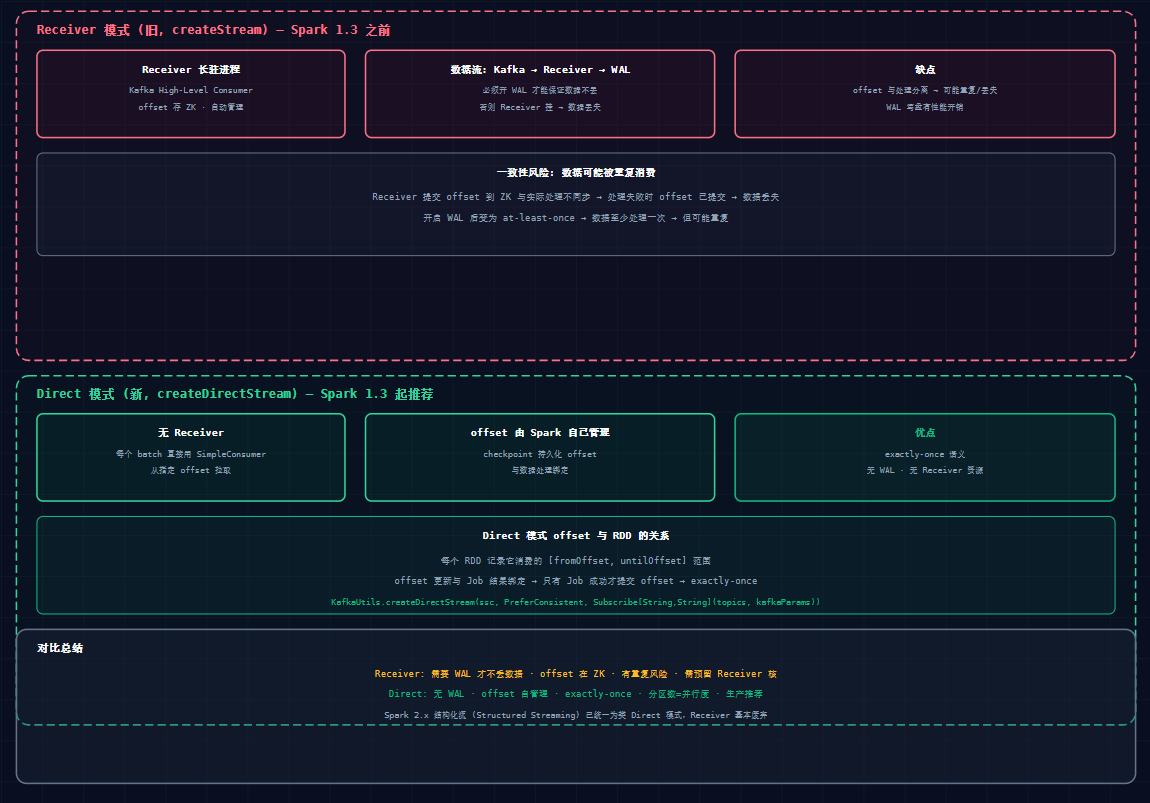
这是 Kafka 集成的两条路线,也是理解 Spark Streaming 演进的关键。
Receiver 模式(旧):
scala
val kafkaStream = KafkaUtils.createStream(
  ssc, zkQuorum, group, topicMap)   // 长驻 Receiver,offset 存 ZK
Receiver 用 Kafka 的 High-Level Consumer 拉数据,offset 交给 ZooKeeper 管理。问题在于:offset 的提交和实际处理是分离的------处理失败了但 offset 已经提交,数据就丢了;开了 WAL 变成 at-least-once,又可能重复消费。而且每个 Receiver 要占一个核,资源开销也大。
Direct 模式(新,推荐):
scala
val kafkaStream = KafkaUtils.createDirectStream[String, String](
  ssc, PreferConsistent, Subscribe[String, String](topics, kafkaParams))
Direct 模式没有 Receiver,每个 batch 直接拿着 Kafka 分区的 offset 范围去拉数据,offset 由 Spark 自己管理、存进 checkpoint,而且 offset 的更新和 Job 的成功与否绑定------Job 没成功就不提交 offset,天然得到 exactly-once。
一句话判断:新项目无脑用 Direct 模式。Receiver 模式基本只剩历史兼容意义,到 Spark 2.x 的结构化流(Structured Streaming)里,底层已经统一成类 Direct 的拉取方式了。
六、总结
- 接收数据的核心链路是 Receiver → BlockGenerator → Block → BlockManager,一个 Block 就是一个分区。
- batchInterval 决定处理节奏,blockInterval 决定分区粒度,后者默认 200ms,高吞吐场景要留意 Block 过大导致的 OOM。
- WAL 是"数据不丢"和"性能"的取舍,Direct 模式用 offset 自管理绕开了这个两难。
- 反压靠 PID 控制器动态限速,是应对数据高峰的保命配置。
作者 :大数据技术实践者
博客 :blog.starzy.cn
GitHub :starzy1990.github.io
专注 AI Agent · LangGraph · RAG · 大数据架构 · 数据工程实践