集群里 RustFS 跑了三节点,某天业务反馈写入变慢,你上去想看吞吐和在线节点数,却发现 :9000/metrics 抓不到任何 Prometheus 数据。不是没监控能力,是 RustFS 的指标走的是另一条路:OpenTelemetry,不是 Prometheus 拉。
把指标接进 Prometheus + Grafana 不难,只是中间多一个 Collector。下面是一套能复制的链路。
1. RustFS 怎么吐指标:OTLP 推送
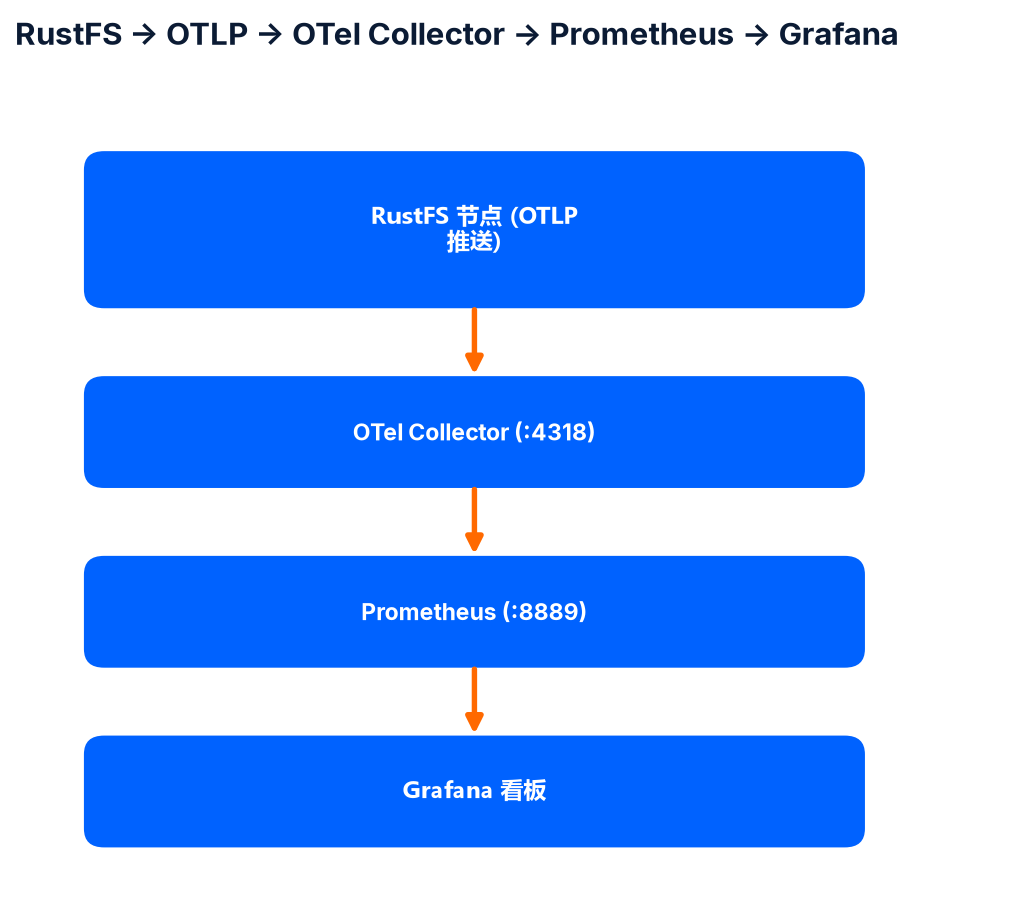
RustFS 通过 OTLP(OpenTelemetry Protocol)把 traces / metrics / logs 推给 Collector,本身不在 9000/9001 上提供 Prometheus 文本格式的 /metrics 端点。所以标准做法是一台 OpenTelemetry Collector 收 OTLP,再转成 Prometheus 格式:
先把 RustFS 指到 Collector(用 OTLP HTTP,端口 4318;gRPC 是 4317):
bash
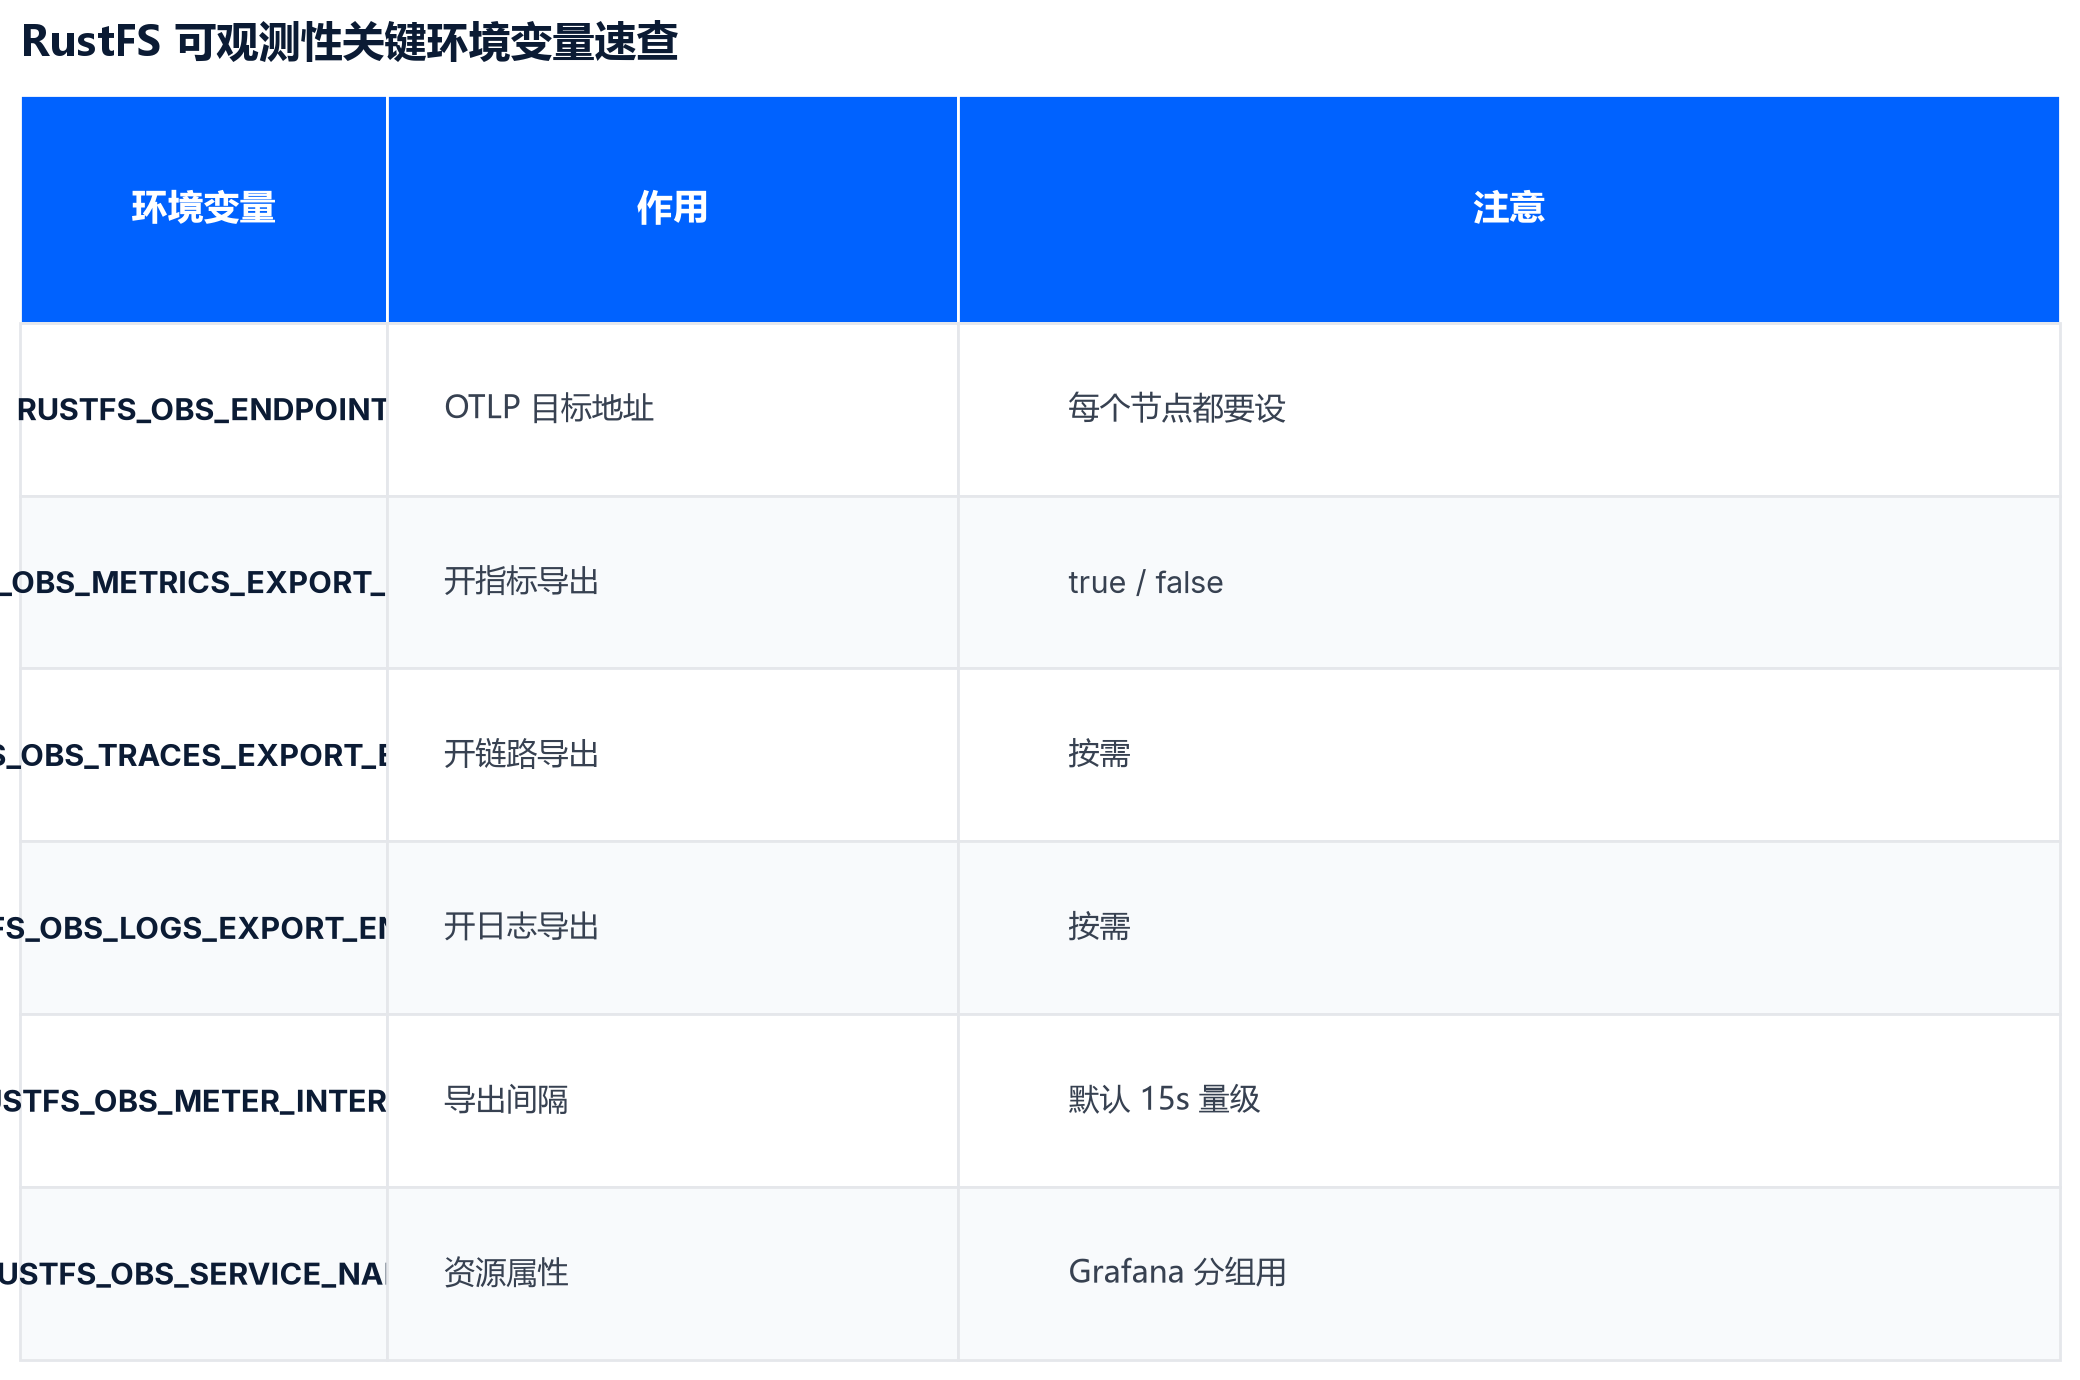
export RUSTFS_OBS_ENDPOINT=http://otel-collector:4318
export RUSTFS_OBS_METRICS_EXPORT_ENABLED=true
export RUSTFS_OBS_TRACES_EXPORT_ENABLED=true
export RUSTFS_OBS_LOGS_EXPORT_ENABLED=true
export RUSTFS_OBS_METER_INTERVAL=15s
export RUSTFS_OBS_SERVICE_NAME=rustfs-prod
export RUSTFS_OBS_ENVIRONMENT=production
每个节点都要设 RUSTFS_OBS_ENDPOINT,漏一个节点,Prometheus 里就少那台的指标。
2. Collector:收 OTLP,转 Prometheus
官方参考栈(docker-compose 的 observability profile)里的 Collector 配置,接收 4317/4318、用 prometheus exporter 在 8889 重新暴露:
yaml
receivers:
  otlp:
    protocols:
      grpc: { endpoint: 0.0.0.0:4317 }
      http: { endpoint: 0.0.0.0:4318 }
exporters:
  prometheus:
    endpoint: "0.0.0.0:8889"
service:
  pipelines:
    metrics: { receivers: [otlp], exporters: [prometheus] }
Prometheus 抓的是 Collector 的 8889,不是 RustFS:
yaml
scrape_configs:
  - job_name: "rustfs-app-metrics"
    static_configs:
      - targets: ["otel-collector:8889"]
  - job_name: "otel-collector"
    static_configs:
      - targets: ["otel-collector:8888"]
指标名以 rustfs_* 开头(如 rustfs_start_total、各 bucket/节点用量),Grafana 直接建面板或导官方看板。
3. 没数据?先查这三段
指标没出来,按链路顺序查,别瞎重启:
- RUSTFS_OBS_ENDPOINT 每个节点都设了吗? 漏设的节点不出指标。
- Collector 从节点可达吗? 节点到
otel-collector:4318的网络不通,OTLP 推不出去。 - Prometheus 抓的是 8889 吗? 抓错端口(比如去抓 RustFS 的 9000)永远为空。
这三段通了,Grafana 里就能看到集群在线节点数、各 bucket 用量、S3 请求量和流量。
4. 边界:多一个组件,但换来统一栈
和"存储自带 /metrics"的方案比,RustFS 这套要多维护一个 OTel Collector。但好处是指标、链路、日志走同一条 OTLP 管道,Grafana/Loki/Tempo 一套贯通,和未来接 Pyroscope 做持续性能分析也顺。官方 observability profile 已经把 otel-collector、Prometheus、Grafana、Loki、Tempo/Jaeger 打包成参考栈,照着起就行,不用从零拼。
5. 总结与下一步
- RustFS 不提供 Prometheus /metrics 拉端点,指标走 OTLP 推送,需 OTel Collector 转 Prometheus(8889)。
- 关键变量:
RUSTFS_OBS_ENDPOINT(每个节点都设)、RUSTFS_OBS_METRICS_EXPORT_ENABLED、导出间隔与资源属性。 - 排障顺序:端点设全 → Collector 可达 → Prometheus 抓 8889。
- 边界:多一个 Collector 组件,但指标/链路/日志统一在 OTLP 栈里。
下一步:按官方 observability profile 起 Collector + Prometheus + Grafana,设 RUSTFS_OBS_ENDPOINT 指向 Collector,进 Grafana 看 rustfs_* 指标是否进来,再补告警规则。
以下是深入学习 RustFS 的推荐资源:RustFS
官方文档: RustFS 官方文档- 提供架构、安装指南和 API 参考。
GitHub 仓库: GitHub 仓库 - 获取源代码、提交问题或贡献代码。
社区支持: GitHub Discussions- 与开发者交流经验和解决方案。
意见反馈:GitHub Issues