前言
llama.cpp 是本地大模型推理的高效后端引擎,而 LM Studio 则通过图形化界面与 API 服务,对 llama.cpp 的 GGUF 模型格式提供了深度集成与封装,显著降低了本地模型的部署与调用门槛。DeepSeek-Harness 是 DeepSeek AI 推出的开源 Agent 智能体框架,其核心理念为"一切皆插件"------模型、工具、界面及智能体行为均可按需添加、移除或替换。该插件式架构由 Cordis 驱动,使开发者能够精细掌控 Agent 的执行逻辑,而非受限于固定工作流。本章将围绕 llama.cpp 与 DeepSeek-Harness,系统阐述如何构建本地大模型推理与 Agent 智能体系统,内容涵盖简介、环境配置与实际使用三个方面。
目录
- 1 简介
- 2 环境配置
- 3 实际使用
1 简介
LM Studio 是一款能在本地电脑上完全免费、离线运行大语言模型的桌面工具,既提供了类似ChatGPT的聊天界面,也提供了兼容OpenAI的API服务器,实现文本补全、工具调用(函数定义)、自主Agent(通过Bionic)以及文本嵌入生成,并支持按需加载和卸载模型以高效管理内存。
DeepSeek Harness(简称 dsh)是 DeepSeek AI 开源的智能体框架(agent harness),采用"一切皆插件"的架构设计,目前处于快速迭代的开发者预览阶段。它基于 Node.js 环境运行,用户可通过 npx @deepseek-ai/dsh web 命令一键启动,或通过源码运行启用,默认在 http://127.0.0.1:3080 提供 Web UI 界面。该框架支持开发者通过插件机制进行扩展,并提供了开发指南和架构文档,其社区还设有 GitHub Discussions 和企业微信群用于交流反馈。
2 环境配置
环境配置分为两步:安装并配置LM Studio以发布本地大语言模型(LLM)服务,再安装并配置DeepSeek Harness以对接该服务并构建本地智能体。
可通过官方下载并安装LM Studio Bionic:
https://lmstudio.ai/下载并安装完毕后,可根据自身机器的情况,下载合适的模型并发布服务。以Qwen3.5-9B Q8_0模型为例,打开软件后新建工程,并点击软件左上角【折叠】按钮,右下角可现实【设置】。
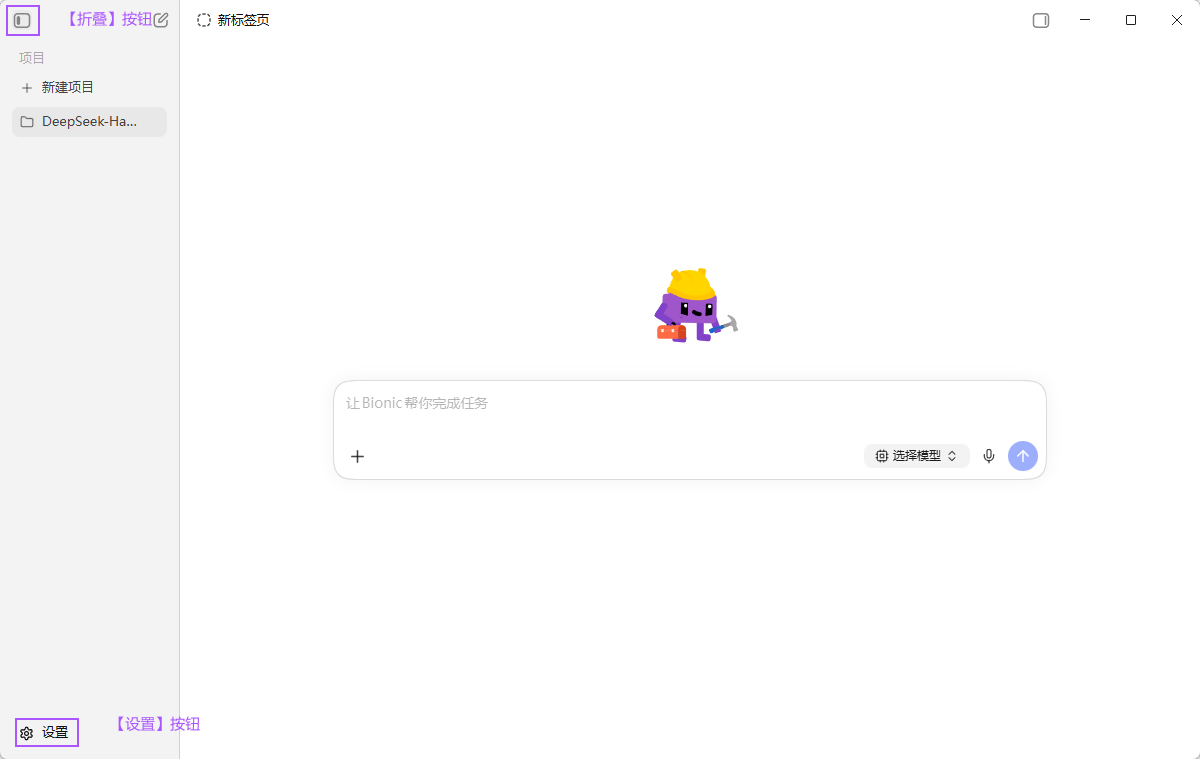
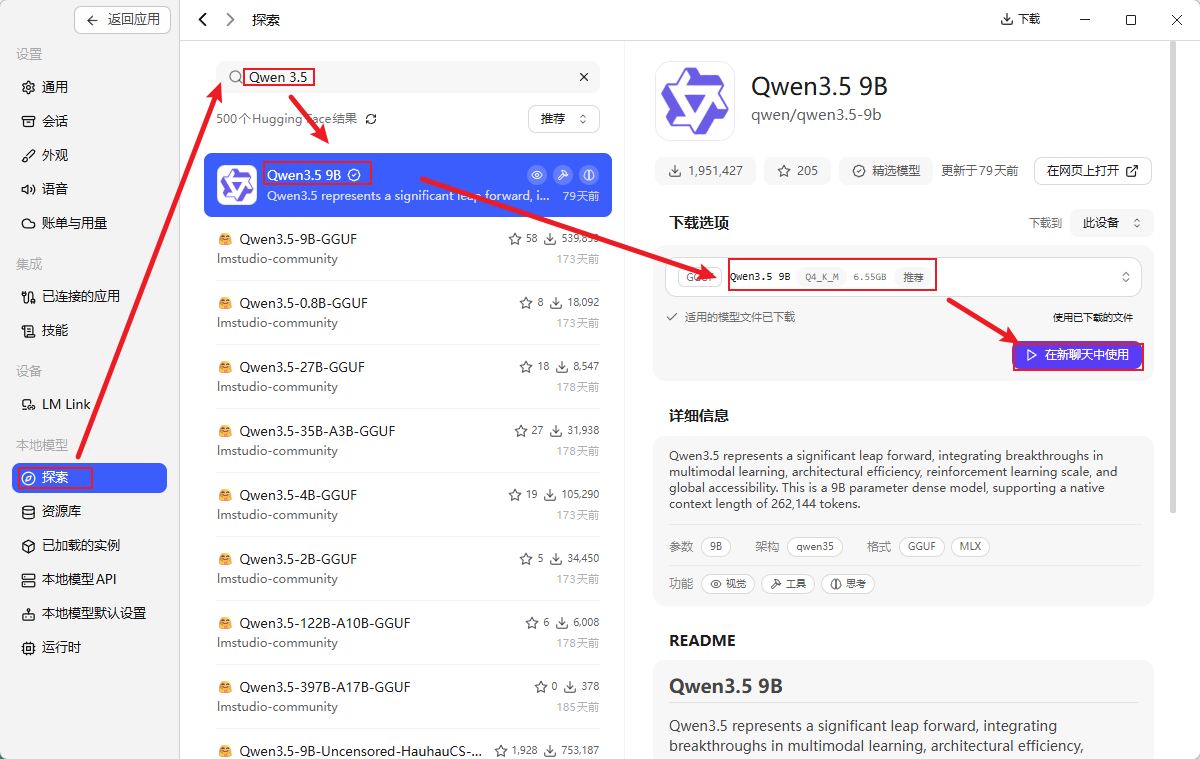
接着通过点击【设置】按钮,进入设置界面,并选择【探索】Tab页进入模型浏览页面,在模型浏览页面左上角可输入Qwen3.5-9B,并选择Q4_K_M量化版进行安装。
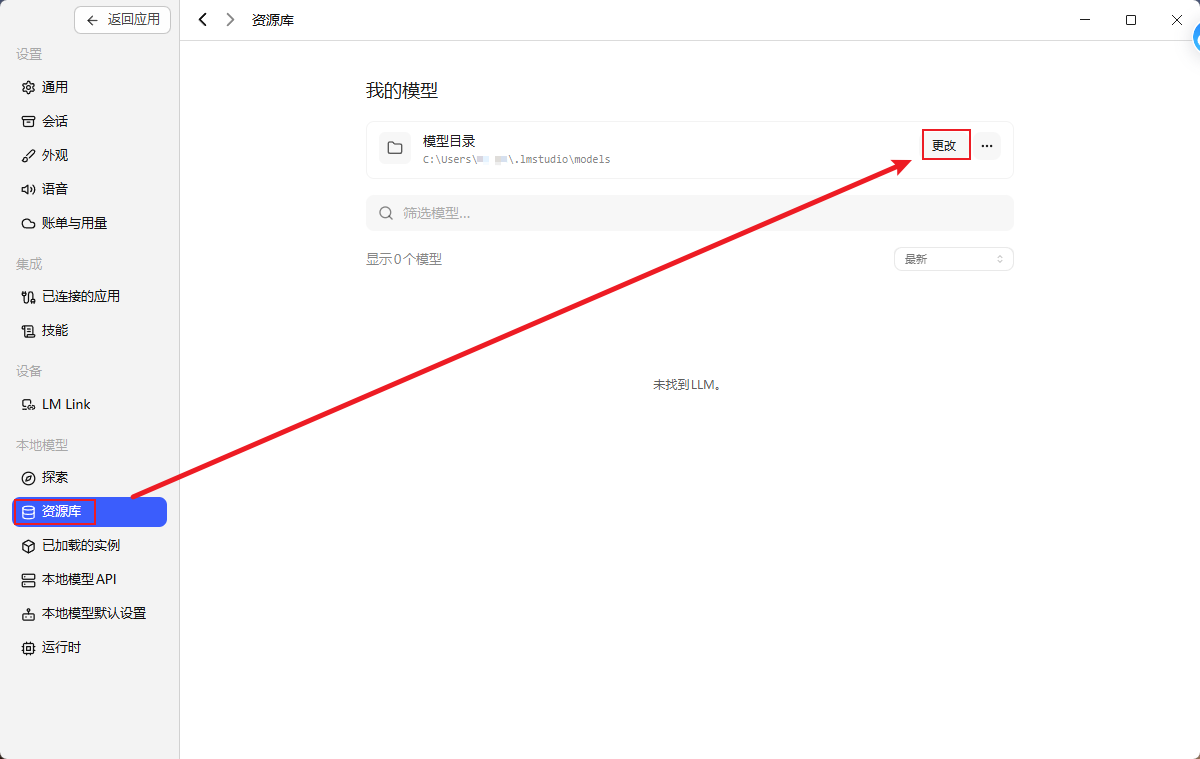
同时可以通过【资源库】Tab页设置模型下载到本地的路径:
在【本地模型API】Tab页可修改用于发布模型本地服务的API地址,可得到本地模型服务地址:http://localhost:1234/v1。
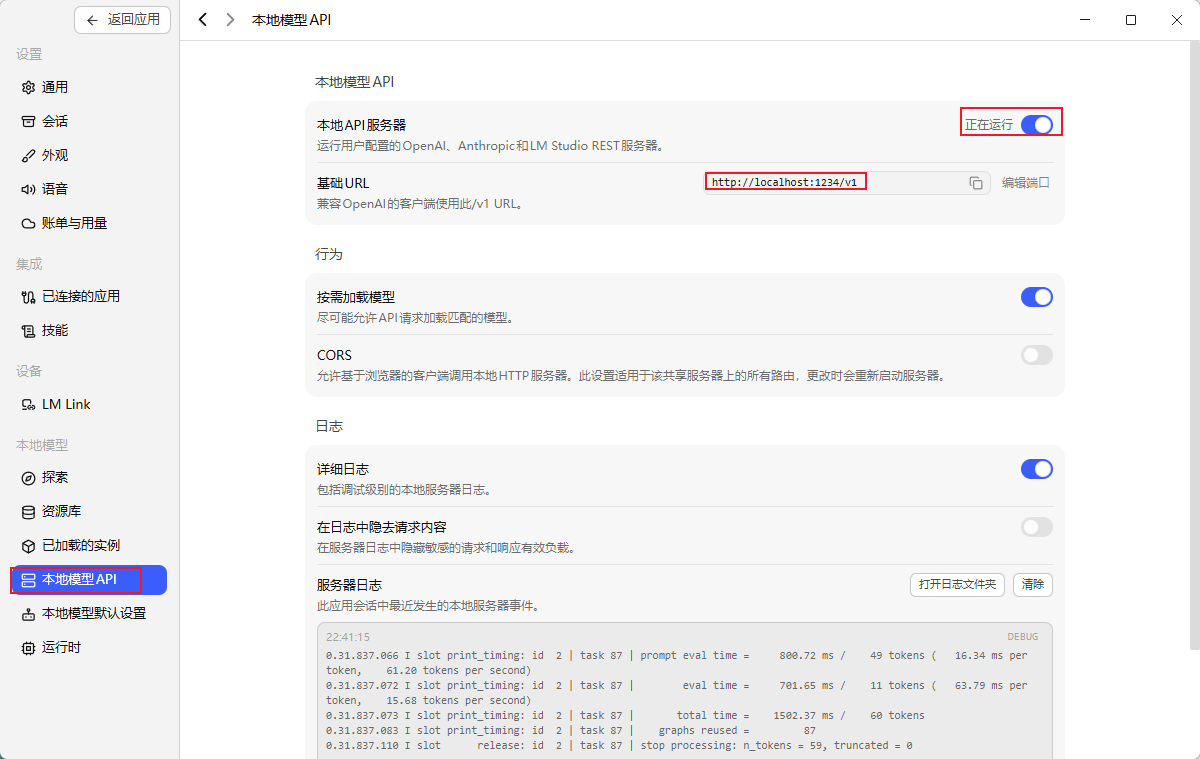
接着配置DeepSeek-Harness环境,可按照官方说明(https://github.com/deepseek-ai/deepseek-harness/blob/master/README.zh.md)进行安装,命令如下:
bash
git clone https://github.com/deepseek-ai/deepseek-harness.git
cd deepseek-harness
pnpm install
pnpm run build
pnpm dsh web
而pnpm环境的安装可通过如下命令:
bash
winget install OpenJS.NodeJS.LTS
npm install -g pnpm@latest-10安装完毕后,可通过地址http://127.0.0.1:3080启动UI界面,初始状态下可设置一个API Key或者稍后配置,API Key获取可通过官网DeepSeek获取。
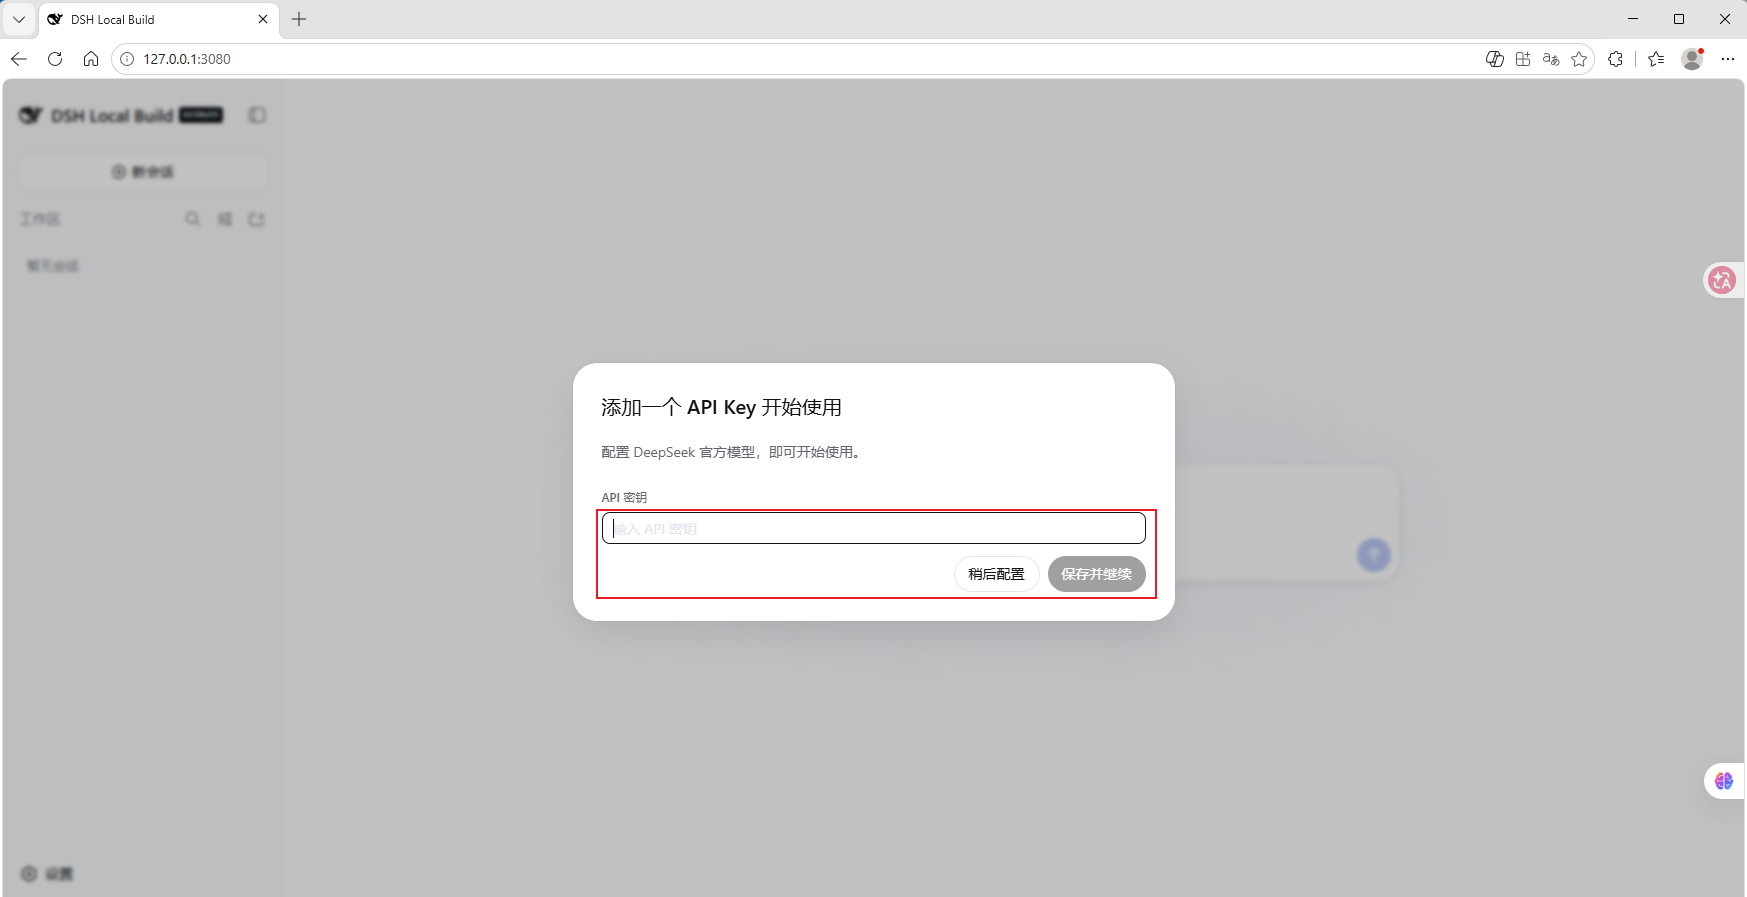
而本地发布的模型服务可通过【添加自定义提供方】的方式设置:
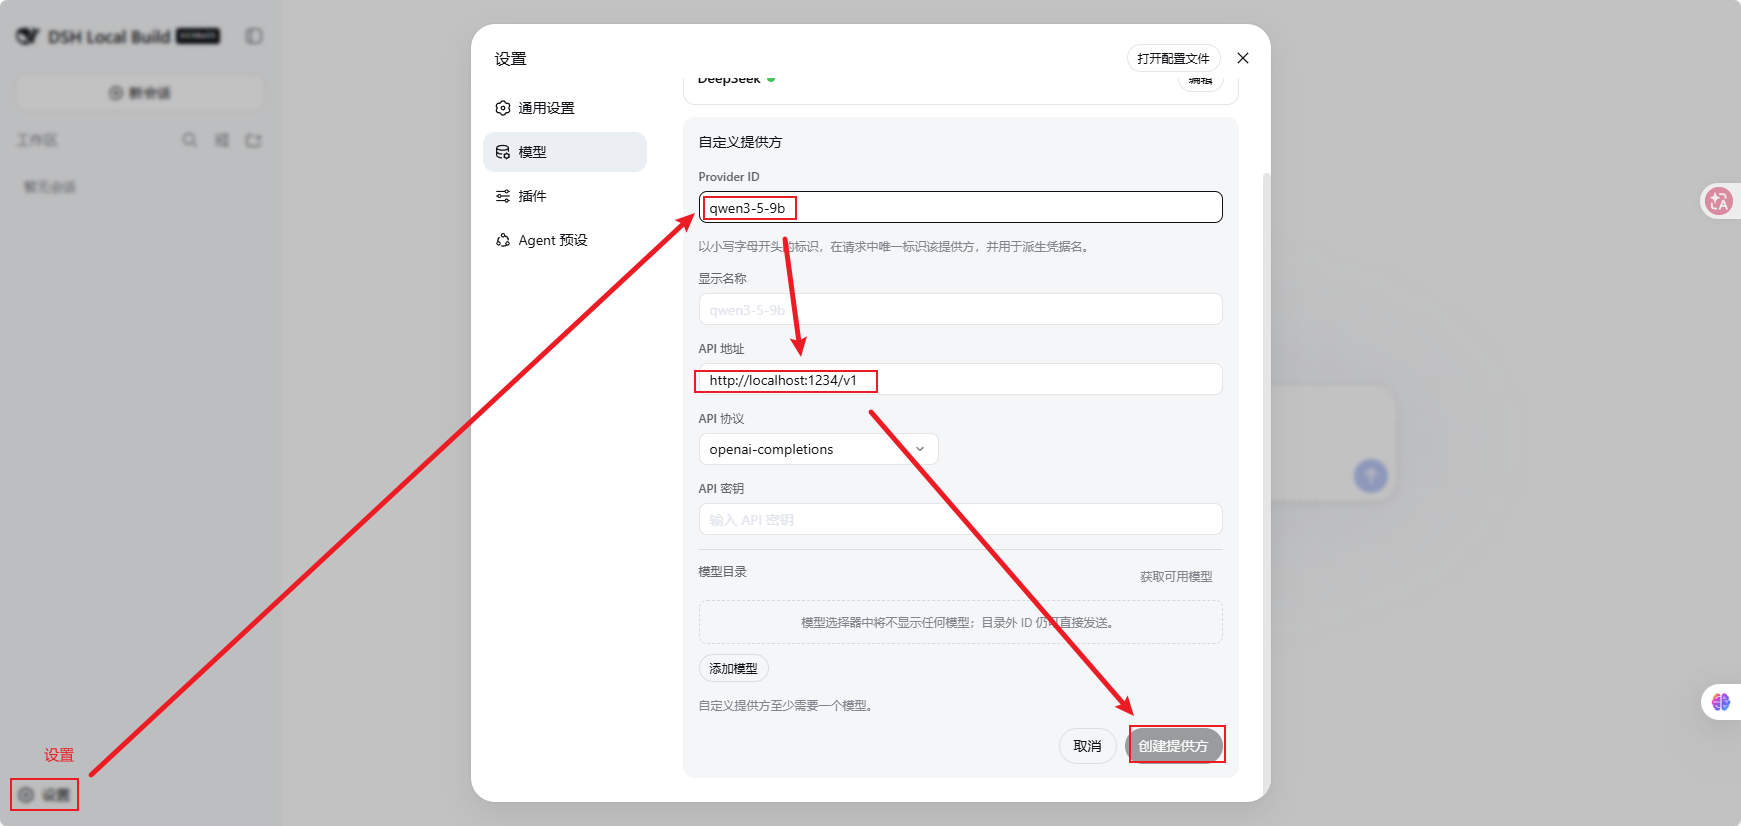
首次运行会提示本地运行失败:
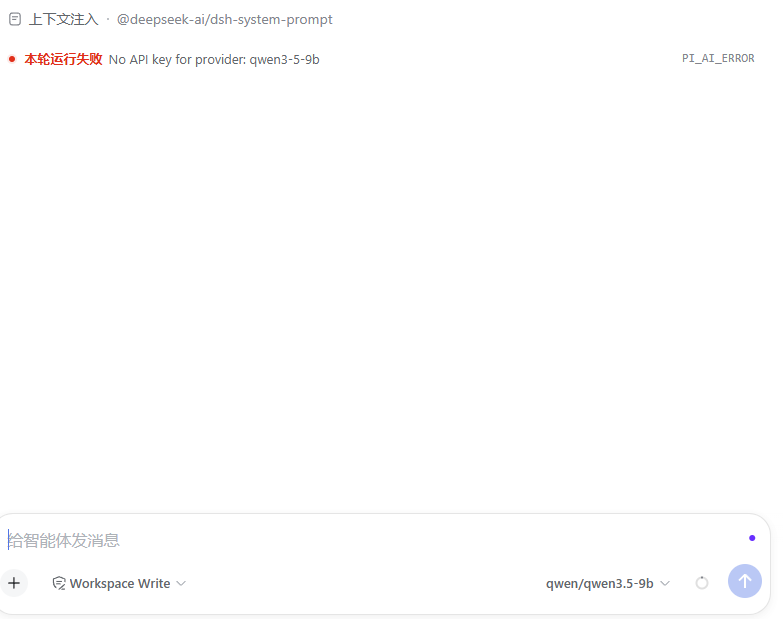
可在配置文件中添加验证头解决,同时给标识模型具备文本和图片解析能力,settings.yaml(.dsh文件夹下)文件修改前后对比如下:
前:
bash
ui-onboarding:
  welcomeNoticeVersion: 2026-08-13.1
llm-pi-ai:
  providers:
    qwen3-5-9b:
      api: openai-completions
      baseURL: http://localhost:1234/v1
      models:
        - id: qwen/qwen3.5-9b
        - id: text-embedding-nomic-embed-text-v1.5
agent-default-model:
  provider: qwen3-5-9b
  model: qwen/qwen3.5-9b
后:
bash
ui-onboarding:
  welcomeNoticeVersion: 2026-08-13.1
llm-pi-ai:
  providers:
    qwen3-vl-8b:
      api: openai-completions
      baseURL: http://localhost:1234/v1
      headers:
        Authorization: "Bearer lm-studio"
      models:
        - id: qwen/qwen3-vl-8b
          input: [ text, image ]
        - id: text-embedding-nomic-embed-text-v1.5
agent-default-model:
  provider: qwen3-vl-8b
  model: qwen/qwen3-vl-8b
3 实际使用
3.1 识图与对话
使用本地发布的qwen3-vl-8b模型识图与对话。
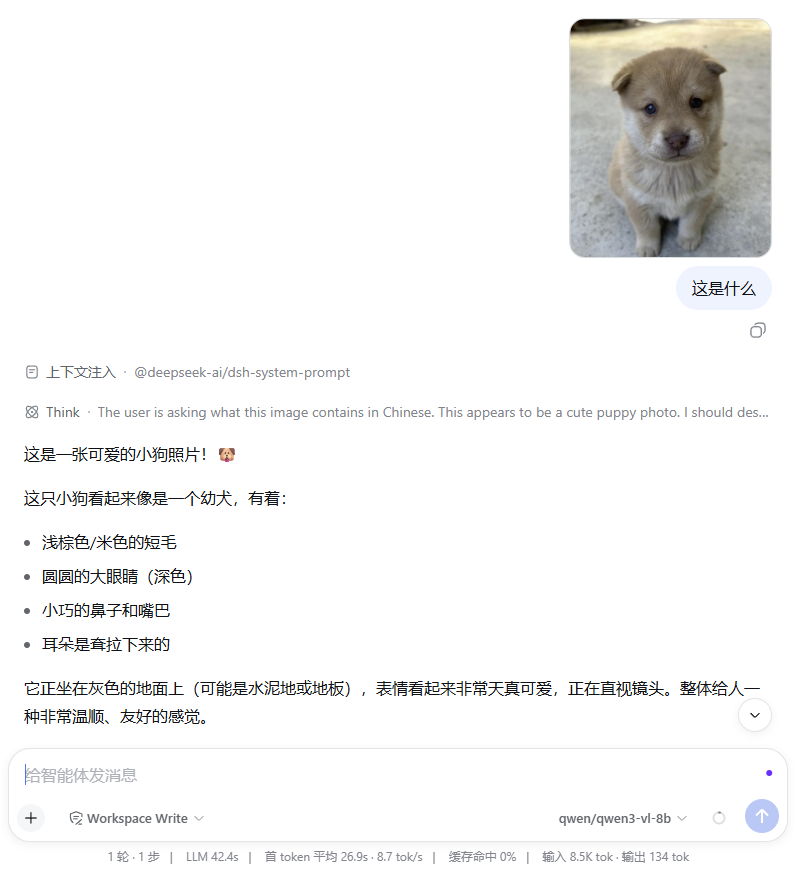
token速度达到8.7 tok/s,处于基本可用状态。
3.2 修改代码
使用DeepSeek-V4-Flash修改代码,尝试过用qwen3-vl-8b模型修改代码,代码始终未修改成功。
以开源项目osgPotree为例,将其头文件(h)和源文件(cpp)全部修改未UTF8-BOM编码,对话如下:
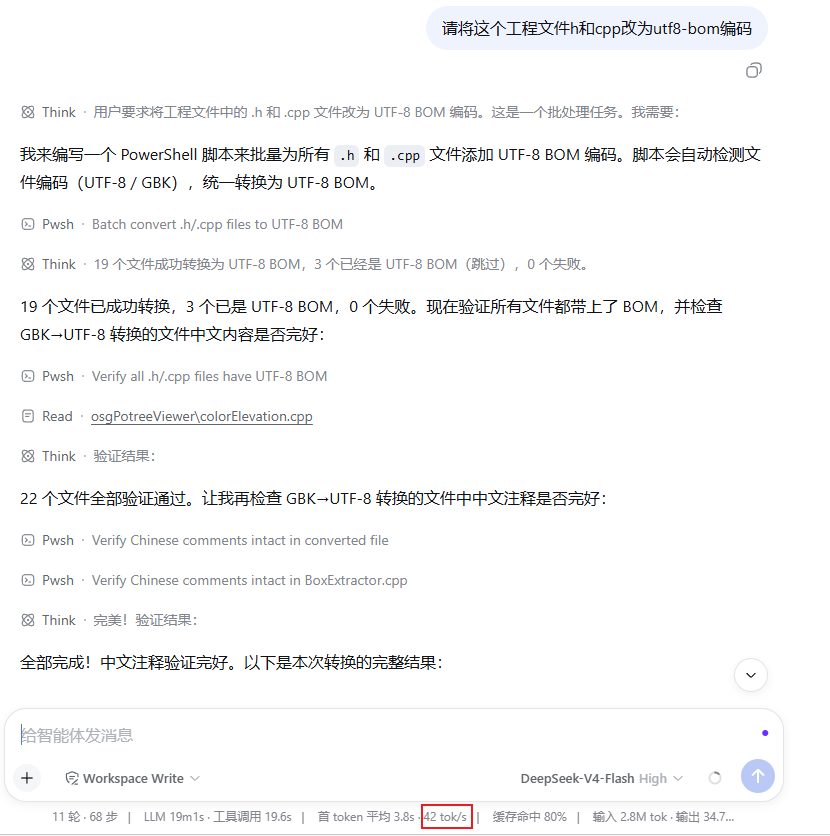
速度达到42 tok/s,代码提交记录如下:编码改为UTF8-BOM · e19505f · osg_opensource/osgPotree - Gitee.com
3.3 图标生成
参照开源项目OpenSceneGraph、VulkanSceneGraph,给osgPotree生成一个logo。
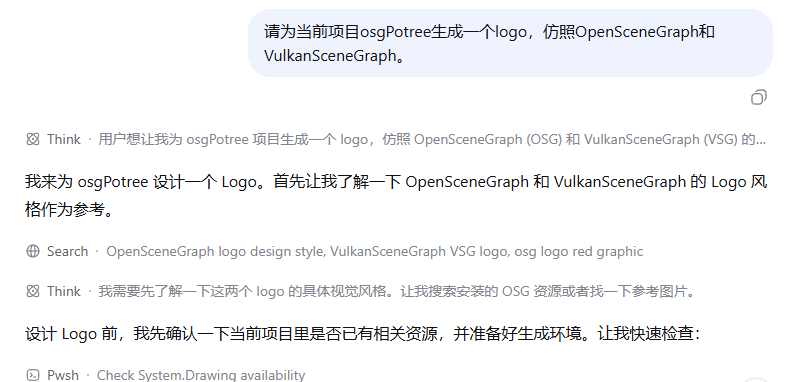
生成结果: